Para ampliar
Esta página recoge, unidad por unidad, lo que no cabe en las sesiones: los apartados que van más allá de lo que se hace en clase (no se explican ni los necesita ninguna hoja de práctica obligatoria, aunque alguno lo usa un paso de «Si te sobra tiempo», y son lo que aparece en el día a día de una empresa) y los enlaces para seguir por cuenta propia. Cada unidad enlaza desde su sitio el apartado de aquí que amplía lo que explica. Las unidades quedan así con lo que se da en cada sesión, y esto está aquí para ir más lejos y para situar lo que suene durante la formación en empresa. La única excepción es la UT7, cuya sección incluye además el programa y las evidencias de sus 12 horas en la empresa, porque esa parte no se da en el centro.
UT1 · Virtualización e hipervisores
Material que va más allá de lo que se hace en clase en la UT1: el clúster de Proxmox con migración en vivo, que no se monta en el laboratorio, el interior de KVM y QEMU, las copias con Proxmox Backup Server, los modos de bond, la fusión de páginas iguales entre VM y los enlaces de referencia de la unidad.
Clúster y migración en vivo
No se monta en el laboratorio (haría falta un segundo nodo con la misma red y, para que tenga sentido, almacenamiento compartido), pero es lo primero que aparece en una empresa y explica varias decisiones de diseño de esta unidad.
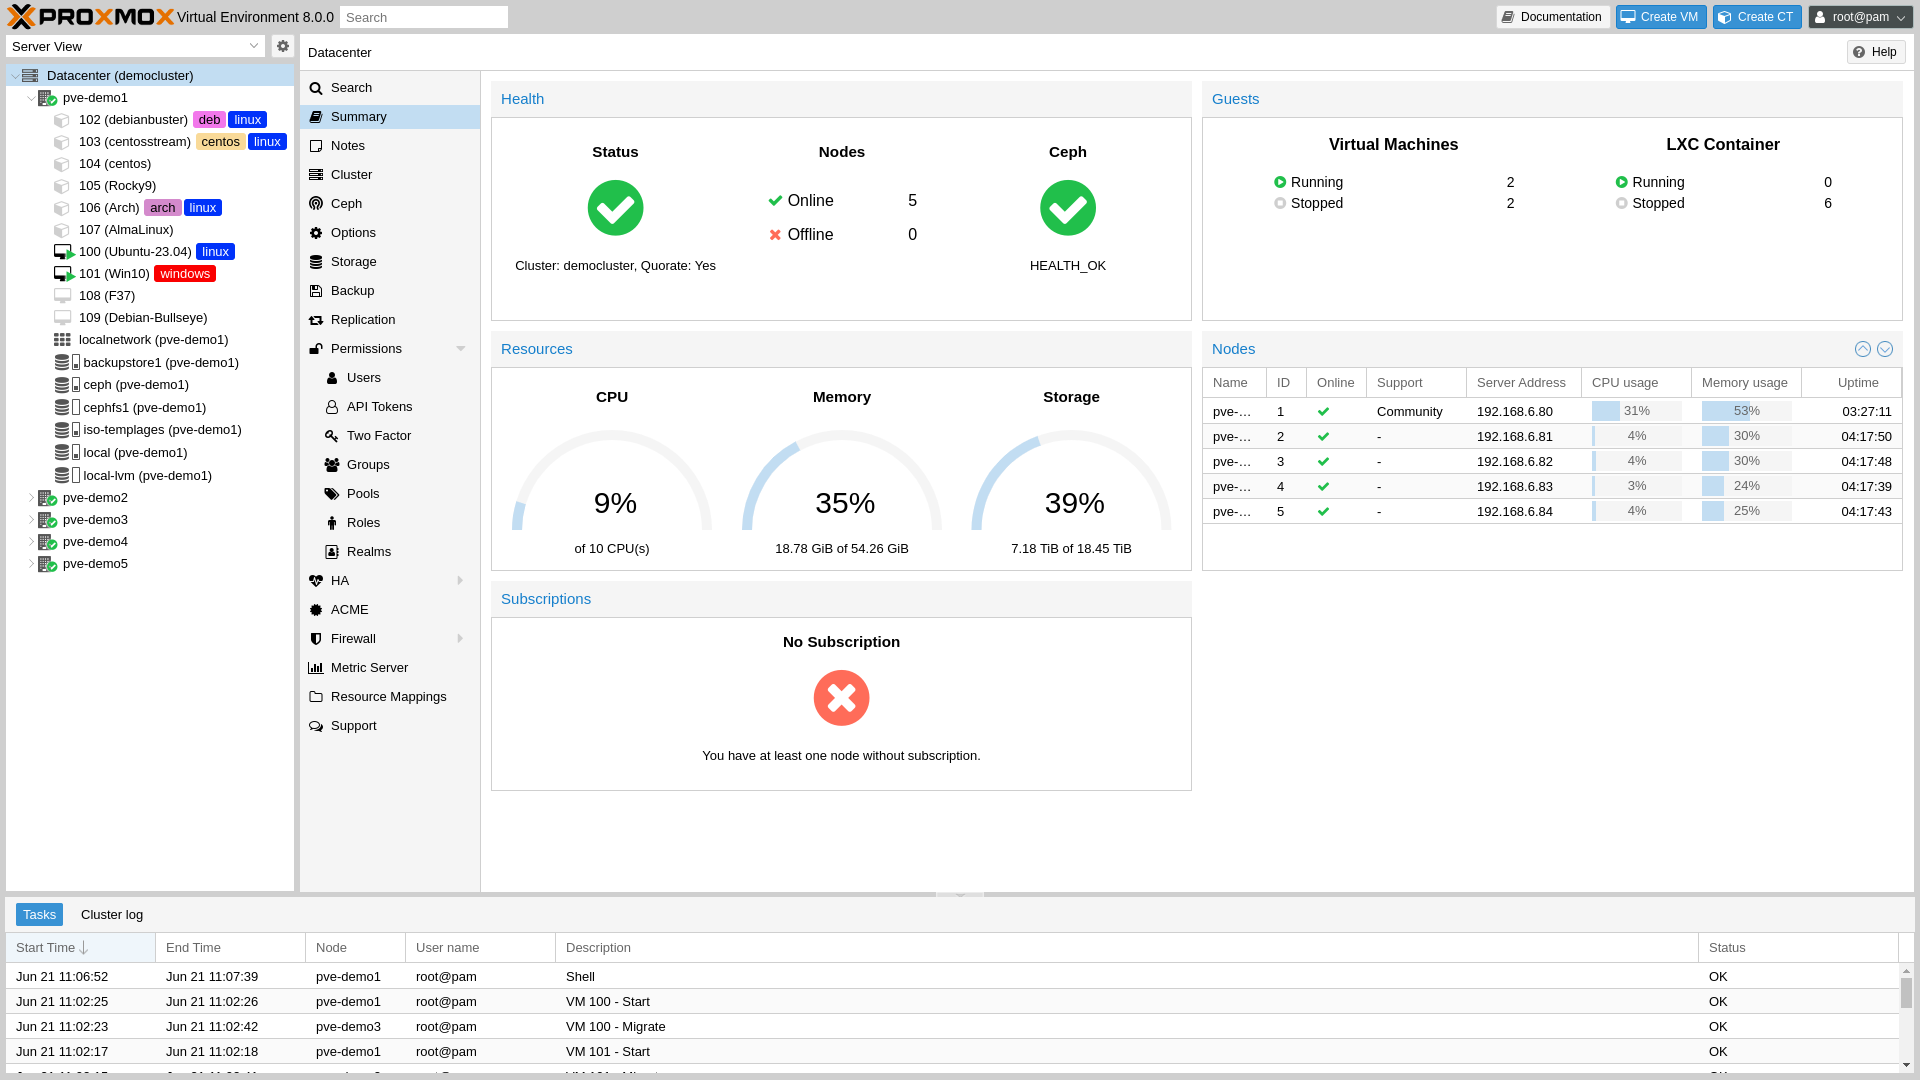
Varios nodos Proxmox se unen en un clúster (pvecm create, pvecm add) que comparte /etc/pve a través de corosync, un protocolo de mensajería con quórum: para que el clúster tome decisiones necesita mayoría de nodos (por eso los clústeres son de tres o cinco, no de dos; con dos, si cae uno el otro se queda sin quórum y no deja ni arrancar VM). Desde una sola consola web se administran todos los nodos.
La migración en vivo (qm migrate 101 pve2 --online) mueve una VM encendida de un nodo a otro sin que los usuarios lo noten: QEMU copia la RAM al destino mientras la VM sigue trabajando, va recopiando las páginas que se ensucian, y cuando queda poco por copiar pausa la VM unas decenas de milisegundos, transfiere el resto y el estado de la CPU, y la reanuda en el destino. Con almacenamiento compartido (NFS, Ceph, iSCSI) el disco no se mueve; con almacenamiento local Proxmox también puede copiarlo (--with-local-disks), pero tardará lo que tarde el disco. Aquí es donde el tipo de CPU importa: si la VM es host y los dos nodos tienen CPU distintas, la migración se rechaza o el invitado se rompe al llegar. Y sobre el clúster se monta la alta disponibilidad (HA): si un nodo muere, sus VM marcadas como HA se arrancan automáticamente en otro, cosa que también exige almacenamiento compartido y, en Proxmox, fencing por watchdog para asegurarse de que el nodo caído no siga escribiendo.
Toda la configuración del clúster vive en /etc/pve, que no es un directorio normal sino un sistema de ficheros en memoria (pmxcfs) replicado entre nodos y respaldado por una base de datos SQLite; por eso /etc/pve/qemu-server/101.conf aparece en todos los nodos de un clúster aunque la VM solo exista en uno.
Además de los puertos de uso diario (8006 para la web y la API, 22 para SSH y 5900 a 5999 para las consolas VNC), un Proxmox usa 3128 (proxy SPICE, un protocolo de consola remota), 5405 a 5412 UDP (corosync, la mensajería del clúster; solo en clúster) y 60000 a 60050 (migraciones).
Dentro de KVM y QEMU
Detalle de Cómo funciona KVM/QEMU por debajo, en la sesión 4. Nada de esto cambia una decisión de configuración, pero explica de dónde sale el coste de cada salida de la VM.
El modo invitado de la CPU. Se dice a menudo que el hipervisor corre en "ring -1": la CPU tiene un modo adicional (VMX root en Intel) en el que corre el kernel del host con KVM, y un modo invitado (VMX non-root) en el que corre la VM con sus propios anillos 0 a 3. El kernel del invitado cree que está en ring 0 y ejecuta instrucciones privilegiadas con normalidad; cuando hace algo que el hipervisor necesita controlar (tocar una tabla de páginas, acceder a un puerto de E/S, ejecutar cpuid, recibir una interrupción) la CPU sale del modo invitado, KVM atiende la petición y vuelve a entrar.
La memoria. La traducción de las direcciones del invitado a direcciones físicas se hace con tablas de páginas anidadas (EPT en Intel, NPT o RVI en AMD): la unidad de gestión de memoria de la CPU resuelve los dos niveles en hardware, sin intervención del hipervisor. Sin ellas, cada vez que el invitado tocara sus tablas de páginas habría una salida más.
La conversación entre QEMU y el kernel. QEMU abre /dev/kvm, crea la VM y sus vCPU mediante ioctl() (la llamada con la que un proceso da órdenes a un driver del kernel) y lanza un hilo por vCPU que se pasa la vida dentro de una llamada KVM_RUN. Mientras la VM ejecuta código corriente, ese hilo está bloqueado dentro del kernel y el proceso QEMU no consume nada. Cuando se produce una salida que KVM no resuelve solo, la llamada retorna, QEMU emula el dispositivo que corresponda y vuelve a entrar.
Hasta dónde llega la emulación. QEMU imita una tarjeta Intel e1000 con tal fidelidad que el driver original de Windows XP la reconoce y funciona sin instalar nada. Es un buen ejemplo de lo que se gana y de lo que se paga: compatibilidad con sistemas que nunca oyeron hablar de virtio, a cambio de que cada acceso del driver a un registro de esa tarjeta ficticia sea una salida de la VM y una vuelta a espacio de usuario.
Proxmox Backup Server
Detalle de Backups con vzdump y Proxmox Backup Server, en la sesión 4. En el laboratorio del curso no se monta.
El problema de vzdump a ficheros es que cada backup es completo: 20 VM de 20 GB con backup diario y retención de 14 días son 5,6 TB. Proxmox Backup Server (PBS) es un producto aparte, también libre, que resuelve eso: parte los discos en trozos de 4 MB, guarda cada trozo una sola vez (deduplicación entre backups y entre VM), aprovecha el mapa de bloques modificados que QEMU mantiene desde el último backup (dirty bitmap) para leer solo lo cambiado, y añade verificación de integridad, cifrado en el cliente, retención con reglas (keep-daily, keep-weekly...) y sincronización a un segundo PBS remoto.
flowchart LR
    VM["<b>VM 110</b>"]:::pieza
    VZ["<b>vzdump</b><br><small>modo snapshot</small>"]:::act
    FIC["<b>Fichero .vma.zst</b><br><small>copia completa, cada vez entera</small>"]:::dato
    COSTE["<b>20 VM × 20 GB × 14 días</b><br><small>≈ 5,6 TB</small>"]:::riesgo
    PBS["<b>Proxmox Backup Server</b><br><small>trozos de 4 MB</small>"]:::act
    DEDUP["<b>Cada trozo se guarda una vez</b><br><small>y solo se lee lo cambiado desde el último backup</small>"]:::ok
    VM --> VZ --> FIC --> COSTE
    VM --> PBS --> DEDUP
    classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
    classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
    classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
    classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
    classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
    classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5px
Los dos caminos hacen copias válidas. El de abajo es el que permite retención larga sin quedarse sin disco.
Bond: modos y configuración
Detalle de Modalidades de red, en la sesión 5. La VM de Proxmox del laboratorio tiene una sola tarjeta, así que en el curso no se monta un bond.
Varias tarjetas físicas agrupadas para redundancia o ancho de banda. Modos que se ven en producción: active-backup (no requiere nada en el switch; una tarjeta activa y otra en espera), 802.3ad o LACP (requiere configurar el agregado en el switch; reparte tráfico y suma ancho de banda entre conexiones distintas, nunca dentro de una misma) y balance-xor. El bond se crea como interfaz bond0 y es bond0, no las tarjetas, lo que se pone como puerto del bridge.
auto bond0
iface bond0 inet manual
    bond-slaves eno1 eno2
    bond-miimon 100
    bond-mode 802.3ad
    bond-xmit-hash-policy layer3+4

auto vmbr0
iface vmbr0 inet static
    address 192.168.1.50/24
    gateway 192.168.1.1
    bridge-ports bond0
    bridge-stp off
    bridge-fd 0
Fusión de páginas iguales
Detalle de Capacidades y limitaciones, en la sesión 5. En el laboratorio no se toca.
El kernel del host puede buscar páginas de memoria idénticas entre VM (mismo sistema operativo, mismas bibliotecas) y dejar una sola copia compartida; en Linux se llama KSM (fusión de páginas iguales del kernel). Ahorra memoria, pero consume CPU en el host y puede filtrar información entre VM por canales laterales, así que en entornos con clientes distintos sobre el mismo host se desactiva.
Enlaces
- Proxmox VE Administration Guide: la referencia completa; los capítulos de Qemu/KVM Virtual Machines, Network Configuration y Storage cubren toda esta unidad con más detalle.
- Wiki de Proxmox: Cloud-Init Support: cómo integra Proxmox el datasource NoCloud, opciones de
qm sety ejemplos de snippets concicustom. - Wiki de Proxmox: Package Repositories: los repositorios enterprise, no-subscription y test, y el formato en cada versión.
- Wiki de Proxmox: Nested Virtualization: activar la anidada en el host exterior y requisitos de la VM.
- Documentación de cloud-init: referencia de módulos, el datasource NoCloud, las etapas de arranque y la guía de depuración.
- Imágenes cloud de Debian: variantes
generic,genericcloudynocloudy qué incluye cada una. - Documentación de KVM en el kernel: la API de
/dev/kvmque usa QEMU; para entender qué es un VM exit de verdad. - Documentación de QEMU: dispositivos emulados, formato qcow2 y
qemu-img. - Especificación virtio (OASIS): cómo funcionan las virtqueues; con leer la introducción se entiende por qué virtio gana a la emulación.
- Proxmox Backup Server: documentación: deduplicación, backups incrementales y retención, para cuando el laboratorio se convierta en algo que hay que proteger.
- man 1 fio y stress-ng: los parámetros de las herramientas de medida que se usan en la práctica.
UT2 · Nubes privadas virtuales (VPC)
Apartados y enlaces que van más allá de lo que se hace en clase en la unidad de nubes privadas virtuales, UT2: las zonas de disponibilidad y la comparación completa entre VLAN y VXLAN.
Zonas de disponibilidad
En nube, una región (eu-west-1, westeurope) tiene dos o tres zonas de disponibilidad: centros de datos físicamente separados, con alimentación y red independientes, unidos por fibra de baja latencia. La VPC abarca toda la región, pero cada subred vive en una zona concreta. Una aplicación que quiera sobrevivir a la caída de un edificio tiene que tener instancias en al menos dos subredes de zonas distintas, y un balanceador delante que reparta. Los proveedores lo cobran: el tráfico entre zonas se factura y los servicios gestionados "multi-AZ" cuestan más.
En el aula la zona de disponibilidad es el nodo Proxmox: si un nodo se apaga, caen sus VM y no las del otro. Quien tenga acceso a dos nodos en clúster lo simula con una zona VXLAN (para que la VNet exista en ambos) y una VM de cada capa en cada nodo. Quien tenga un solo nodo lo simula lógicamente: dos subredes por capa (front-a en 10.10.1.0/24, front-b en 10.10.11.0/24), una VM de la aplicación en cada una, y demuestra que apagar web01 en front-a no tira el servicio porque web02 en front-b sigue respondiendo. No es lo mismo (comparten el hardware), pero el diseño de red y el despliegue de la aplicación son exactamente los que se harían en nube, y eso es lo que se evalúa.
VLAN frente a VXLAN
Comparación completa de los dos tipos de zona que se usan fuera del laboratorio; en la sesión 8, VLAN 802.1Q frente a VXLAN se queda con la consecuencia práctica, la MTU.
Una VLAN añade 4 bytes a la trama Ethernet con un identificador de 12 bits: 4094 redes posibles. Es un estándar de capa 2 que entienden todos los switches gestionables, es barato de procesar y se depura con tcpdump -e viendo el tag. Su limitación es que la VLAN tiene que existir en cada switch por el que pasa el tráfico, así que depende de que el equipo de redes la configure, y no cruza un router (por definición de capa 2).
VXLAN (RFC 7348) mete la trama Ethernet completa dentro de un paquete UDP/IP con un identificador de 24 bits (16 millones de redes). Como es IP, atraviesa routers y no necesita que el switch sepa nada: solo que los nodos Proxmox se alcancen entre sí por el puerto 4789. El precio son 50 bytes de cabecera extra, lo que obliga a bajar la MTU (el tamaño máximo de paquete que admite una interfaz) de las VM a 1450 si la red física va a 1500, o subir la física a 1550 o más, que es lo correcto si se puede.
flowchart TB
    subgraph V1["VLAN 802.1Q · capa 2"]
        direction LR
        T1["<b>Trama Ethernet</b>"]:::dato
        TAG["<b>+ 4 bytes de tag</b><br><small>12 bits · 4094 redes</small>"]:::pieza
        SW["<b>Cada switch del camino</b><br><small>tiene que conocer la VLAN · no cruza un router</small>"]:::infra
        T1 --> TAG --> SW
    end
    subgraph V2["VXLAN · capa 2 dentro de capa 3"]
        direction LR
        T2["<b>Trama Ethernet entera</b>"]:::dato
        ENC["<b>dentro de UDP/IP</b><br><small>24 bits · 16 millones de redes · puerto 4789</small>"]:::pieza
        IP["<b>Atraviesa routers</b><br><small>al switch no hay que decirle nada</small>"]:::ok
        MTU["<b>50 bytes de cabecera</b><br><small>MTU de la VM a 1450</small>"]:::riesgo
        T2 --> ENC --> IP
        ENC --> MTU
    end
    V1 ~~~ V2
    classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
    classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
    classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
    classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
    classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
    classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5px
La VLAN es más barata de procesar pero depende del equipo de redes. VXLAN no depende de nadie y se paga en cabecera.
Enlaces
- Proxmox VE Administration Guide, capítulo SDN: la referencia de zonas, VNets, subnets, IPAM y DHCP integrado; conviene leer la parte de "Simple zone" y "DHCP" antes de la sesión 8.
- Proxmox VE API Viewer: todas las rutas de la API con sus parámetros; es lo que
pvesh usagemuestra, pero navegable. - Proxmox wiki: Proxmox VE API: autenticación con tickets y con tokens, y ejemplos con curl.
- RFC 1918, Address Allocation for Private Internets: cuatro páginas; explica por qué existen los rangos privados y qué obligaciones tiene quien los usa.
- RFC 4632, CIDR: la especificación del direccionamiento sin clases, por si interesa entender de dónde sale la notación /n.
- RFC 7348, VXLAN: el formato de encapsulación y el porqué de los 50 bytes de cabecera.
- Página de manual de dnsmasq: larga pero es la fuente; los apartados que interesan son
dhcp-range,dhcp-host,expand-hostsylocal. - nftables wiki: Performing Network Address Translation: masquerade, SNAT y DNAT con ejemplos que se usan tal cual en la UT3.
- cloud-init, Network configuration: cómo cloud-init traduce el
--ipconfig0de Proxmox a la configuración de red de la VM. - tcpdump(8) en man7.org y pcap-filter(7): la sintaxis de los filtros (
port,host,net,and,not).
UT3 · Seguridad por capas: DMZ externa, DMZ interna y zona interna
Apartados que en clase solo se mencionan y la lista de enlaces de la UT3, la unidad del cortafuegos por zonas, el proxy inverso y la separación de clientes: las dos capas de inspección que hay por encima del cortafuegos, qué ataque frena cada zona, el interior de la tabla de estados, el cortafuegos entero escrito en nftables y Caddy como proxy alternativo a nginx.
IDS/IPS y WAF, dos capas más
El cortafuegos decide por puertos y direcciones. No sabe si lo que entra por el 443 es una petición legítima o un intento de explotación. Para eso hay dos capas adicionales que en el módulo solo se mencionan: OPNsense integra Suricata como IDS/IPS (Services → Intrusion Detection), que inspecciona el contenido de los paquetes contra reglas de firmas (ET Open, gratuitas) y puede alertar o bloquear. En la interfaz WAN de un laboratorio con tráfico cifrado ve poco; tiene más sentido en la DMZ externa, después del proxy, donde el tráfico ya va en claro. Y en el propio proxy inverso se puede añadir un WAF (Web Application Firewall) como ModSecurity o su reimplementación en Go, Coraza, con el conjunto de reglas OWASP CRS (Core Rule Set, la lista de patrones de ataque que mantiene la fundación OWASP), que bloquea patrones de inyección SQL, XSS (inyección de scripts en páginas web) y similares antes de que lleguen a la aplicación. Ambos generan falsos positivos; conviene no ponerlos en modo bloqueo el primer día.
Qué frena cada capa
Ampliación de Defensa en profundidad y zonas, en la sesión 14.
Para que el modelo no se quede en una tabla bonita, conviene saber qué ataque concreto para cada zona. Un escaneo de puertos desde Internet contra la IP pública solo ve el 443 del proxy; los puertos 28080 de la aplicación y 5432 de PostgreSQL ni siquiera aparecen como cerrados, aparecen como filtrados, que es distinto y se explica con nmap en las pruebas de seguridad de la sesión 18. Si un atacante explota una vulnerabilidad del proxy y consigue ejecutar código en él, se encuentra en la DMZ externa: puede llegar al 28080 de app01 porque es lo que el proxy necesita, pero no puede abrir una sesión a la base de datos, ni hacer SSH a nada, ni salir a Internet a descargarse herramientas si la regla de salida de la DMZ externa está cerrada. Si además compromete la aplicación (inyección SQL, deserialización, dependencia vulnerable), llega a la base de datos, pero con el usuario de aplicación, que no puede hacer COPY ... TO PROGRAM (una orden de PostgreSQL que ejecuta programas en el servidor) ni leer otras bases. Para llegar a la zona de gestión no hay ningún camino permitido desde ninguna zona de servicio, así que tendría que atacar el propio cortafuegos. Cada uno de esos saltos deja intentos denegados en el log, que es justo lo que un sistema de detección busca.
La tabla de estados por dentro
Ampliación de Cortafuegos con estado, en la sesión 14.
La tabla de estados tiene tamaño finito. En Debian sysctl net.netfilter.nf_conntrack_max suele valer 65536 o más según la RAM; en OPNsense el límite está en Firewall → Settings → Advanced (Firewall Maximum States). Un ataque de inundación de SYN busca precisamente llenarla; cuando se llena, el cortafuegos descarta conexiones nuevas legítimas y en el log aparece nf_conntrack: table full, dropping packet. Los tiempos de expiración también se configuran: una conexión TCP establecida sin tráfico vive por defecto 5 días en conntrack de Linux, y por eso una sesión SSH aguanta horas abierta sin que el cortafuegos la olvide.
nftables: el fichero de reglas completo
El curso monta el cortafuegos con OPNsense; esto es la alternativa entera con un router Debian, para quien la prefiera o quiera entender el motor que hay debajo del firewall de Proxmox y de Docker. La unidad la presenta y dice cuándo se elige en Alternativa: nftables en una VM Linux, y el "Antes de empezar" de la A3.1 enlaza aquí.
Tablas, cadenas, hooks y prioridades
Un ruleset de nftables se organiza en tablas, que son contenedores con una familia de direcciones: ip (IPv4), ip6, inet (las dos a la vez, la más habitual), arp, bridge y netdev. Dentro de una tabla hay cadenas, y las cadenas contienen reglas. Hay dos tipos de cadena: las base, que se enganchan a un hook del kernel y por las que pasa el tráfico automáticamente, y las regulares, a las que solo se llega con jump o goto desde otra cadena.
Los hooks son los puntos del recorrido de un paquete por la pila de red donde netfilter puede intervenir:
flowchart TB
    IN["<b>Paquete entra</b>"]:::dato
    PRE["<b>prerouting</b>"]:::pieza
    DEC{"<b>¿Para esta máquina?</b>"}:::act
    INP["<b>input</b>"]:::pieza
    PROC["<b>Proceso local</b>"]:::dato
    FWD["<b>forward</b>"]:::pieza
    OUT["<b>output</b>"]:::pieza
    POST["<b>postrouting</b>"]:::pieza
    SAL["<b>Paquete sale</b>"]:::dato
    IN --> PRE --> DEC
    DEC -->|sí| INP --> PROC --> OUT --> POST
    DEC -->|no| FWD --> POST
    POST --> SAL
    classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
    classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
    classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
    classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
    classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
    classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5px
Saber por qué hook pasa un paquete es lo que decide en qué cadena va la regla. El tráfico que atraviesa la máquina nunca toca input.
Para un router entre zonas casi todo ocurre en forward: el tráfico que va de una zona a otra no es para el cortafuegos, así que nunca pasa por input ni output. input protege a la propia máquina (quién puede hacerle SSH o abrir su web) y prerouting/postrouting son donde se hace el NAT (DNAT en prerouting, antes de decidir la ruta; SNAT en postrouting, después).
La prioridad ordena las cadenas base que comparten hook: se evalúan de menor a mayor número. Hay nombres predefinidos: raw (-300), mangle (-150), dstnat (-100), filter (0), security (50), srcnat (100). Lo importante es que el DNAT (-100) va antes que el filtro (0) en prerouting, y por eso en la cadena forward se filtra con la dirección de destino ya traducida, igual que en pf. La política de una cadena base (policy drop o policy accept) es lo que ocurre si ninguna regla coincide; en forward e input se pone en drop.
El fichero completo y persistente
Este es el fichero /etc/nftables.conf para el laboratorio, con nombres de interfaz ya renombrados con systemd-networkd o udev (los dos mecanismos de Debian para dar nombre fijo a una interfaz) para que se llamen como las zonas (si no, se usan ens18, ens19… o mejor, se definen variables). Tiene tres partes: las variables con redes y servidores, la tabla fw con las cadenas input (quién llega al propio router) y forward (qué cruza entre zonas), y la tabla nat. Conviene fijarse en que las dos cadenas de filtro empiezan igual, con established,related e invalid, y terminan con un log seguido de drop; entre medias solo están los saltos permitidos, uno por línea:
#!/usr/sbin/nft -f
flush ruleset

define net_dmzext = 10.10.1.0/24
define net_dmzint = 10.10.2.0/24
define net_int    = 10.10.3.0/24
define net_mgmt   = 10.10.0.0/24
define srv_web    = 10.10.1.10
define srv_app    = 10.10.2.10
define srv_db     = 10.10.3.10

table inet fw {

    chain input {
        type filter hook input priority filter; policy drop;
        ct state established,related accept
        ct state invalid drop
        iifname "lo" accept
        icmp type { echo-request, destination-unreachable, time-exceeded } accept
        iifname "mgmt" ip saddr $net_mgmt tcp dport { 22, 443 } accept
        log prefix "FW-INPUT-DROP " drop
    }

    chain forward {
        type filter hook forward priority filter; policy drop;
        ct state established,related accept
        ct state invalid drop

        # Publicación: Internet -> proxy (destino ya traducido por el DNAT)
        iifname "wan" oifname "dmzext" ip daddr $srv_web tcp dport { 80, 443 } accept

        # Capas: proxy -> app -> db
        iifname "dmzext" oifname "dmzint" ip saddr $srv_web ip daddr $srv_app tcp dport 28080 accept
        iifname "dmzint" oifname "int"    ip saddr $srv_app ip daddr $srv_db  tcp dport 5432 accept

        # Gestión llega a todo por SSH
        iifname "mgmt" ip saddr $net_mgmt tcp dport 22 accept

        # Diagnóstico: ping desde gestión
        iifname "mgmt" icmp type echo-request accept

        log prefix "FW-FWD-DROP " drop
    }

    chain output {
        type filter hook output priority filter; policy accept;
    }
}

table ip nat {
    chain prerouting {
        type nat hook prerouting priority dstnat; policy accept;
        iifname "wan" tcp dport { 80, 443 } dnat to $srv_web
    }
    chain postrouting {
        type nat hook postrouting priority srcnat; policy accept;
        oifname "wan" ip saddr $net_dmzext masquerade
    }
}
El masquerade solo cubre la DMZ externa: la DMZ interna y la zona interna no tienen salida a Internet. Si app01 necesita instalar paquetes, se abre una regla temporal y fechada hacia 80/443, igual que la fila temporal de la matriz de OPNsense del curso, y se quita en cuanto termina la instalación.
Para probarlo sin cargarlo, nft -c -f /etc/nftables.conf valida la sintaxis. Se carga con nft -f /etc/nftables.conf y se persiste activando el servicio: systemctl enable --now nftables, que en Debian lee exactamente ese fichero en cada arranque. Antes de todo hay que activar el reenvío en el kernel, net.ipv4.ip_forward=1 en /etc/sysctl.d/99-router.conf, porque sin eso el router descarta todo lo que no es para él aunque nftables lo permita. nft list ruleset muestra lo cargado, y nft list ruleset -a añade los handles de cada regla para poder borrar una concreta. Los logs salen por el kernel, journalctl -k -f | grep FW-, o a un fichero propio si se configura rsyslog (el servicio de logs de Debian) con un filtro por prefijo.
Orden de las reglas y bloqueo remoto
Si el router Debian se administra por SSH desde MGMT y se carga un ruleset con policy drop en input
sin la regla que permite ese SSH, se pierde el acceso en el acto (la sesión en curso sobrevive gracias a
established, pero la siguiente no entra). Conviene dejar preparado un at now + 5 min (una orden
programada que se ejecuta pasado ese tiempo) que restaure el fichero anterior, o trabajar desde la
consola de Proxmox.
Caddy: el mismo proxy en cuatro líneas
Ampliación de El proxy inverso, en la sesión 16.
Las alternativas habituales en empresas son Traefik y Caddy. Traefik descubre los backends solo: se conecta al socket de Docker o a la API de Kubernetes y crea las rutas a partir de etiquetas de los contenedores, y no compensa editar nginx a mano cada vez que un pipeline despliega contenedores. Caddy destaca porque obtiene y renueva certificados de Let's Encrypt automáticamente sin configurar nada, y su fichero de configuración para lo mismo que el nginx de la unidad son cuatro líneas:
Para aprender, nginx es el mejor de los tres porque obliga a entender cada cabecera; para producción con contenedores, Traefik; y para un servicio pequeño sin pensar en certificados, Caddy.
Enlaces
- Documentación de OPNsense: Firewall: reglas, orden de evaluación, quick, flotantes y grupos, con capturas de cada campo.
- Documentación de OPNsense: Aliases: tipos de alias, incluidas las tablas URL y los aliases GeoIP.
- Documentación de OPNsense: NAT: port forward, outbound, one-to-one y NPT, con el detalle de la regla de filtro asociada.
- Documentación de OPNsense: Intrusion Prevention System: Suricata integrado, conjuntos de reglas y modo IPS.
- Wiki de nftables: la referencia del proyecto; lo primero que conviene leer es "Quick reference" y "Netfilter hooks".
- nft(8) en man7.org: sintaxis completa, familias, tipos de cadena y expresiones de conntrack.
- Nmap Reference Guide: Port Scanning Basics: la definición exacta de open, closed, filtered y los estados combinados.
- nginx: módulo ngx_http_proxy_module: todas las directivas proxy_*, incluidas las de cabeceras y buffers.
- Documentación de Traefik: descubrimiento de servicios por etiquetas Docker; se cita como alternativa a nginx en la UT3 y la UT6.
- Let's Encrypt: cómo funciona: retos HTTP-01 y DNS-01, límites de emisión y clientes ACME.
- step-ca de Smallstep: CA interna con ACME para automatizar certificados en zonas que no ven Internet.
- Proxmox VE: Network Configuration: bridges VLAN aware, tags por VM y trunks.
UT4 · Nube pública: consola, CLI y SDK
Material que va más allá de lo que se hace en la empresa en la unidad UT4: el modelo de responsabilidad compartida, que explica qué deja de ser responsabilidad propia al pasar de Proxmox a la nube, el nivel gratuito de las cuentas nuevas, la cadena de credenciales completa de los tres proveedores, los perfiles que asumen un rol y los enlaces de ampliación.
El modelo de responsabilidad compartida
Los tres grandes lo llaman modelo de responsabilidad compartida y lo resumen igual: el proveedor es responsable de la seguridad de la nube (centros de datos, hardware, hipervisor, red física, los servicios gestionados por dentro) y el cliente es responsable de la seguridad en la nube (sistema operativo de sus VM, parches, configuración de red, cortafuegos, identidades, cifrado de sus datos, y sobre todo qué expone a Internet).
En Proxmox todo quedaba del lado del administrador: si el hipervisor se quedaba sin parchear, el problema era suyo. En la nube el hipervisor deja de serlo, pero el grupo de seguridad con 0.0.0.0/0 al puerto 22 sigue siéndolo, y también lo es la clave de acceso que alguien subió a un repositorio público. La línea se desplaza según el servicio: en una VM (EC2, Azure VM, Compute Engine) se administra el sistema operativo; en un contenedor gestionado sin servidor (Fargate, Container Apps, Cloud Run) solo se administra la imagen y su configuración; en una base de datos gestionada ni siquiera se ve el sistema operativo. Cuanto más gestionado, menos responsabilidad operativa y menos control.
El nivel gratuito de las cuentas nuevas
Lo que sigue amplía Free tier, presupuestos y alertas y vale para una cuenta personal recién abierta, no para la cuenta de pago de la empresa, que es la que se usa durante la formación y en la que todo cuesta desde el primer minuto. Azure da un crédito inicial durante el primer mes y un año de ciertos servicios en cantidades limitadas. Google Cloud da un crédito durante 90 días y un nivel "siempre gratis" (una e2-micro en regiones de Estados Unidos, 5 GB de Cloud Storage). AWS cambió en 2025 a un modelo de créditos para cuentas nuevas que caducan a los seis meses, más un conjunto de servicios siempre gratis (1 millón de invocaciones de Lambda al mes, 25 GB de DynamoDB). Las condiciones cambian de un año para otro, así que la única fuente fiable es la página de precios del proveedor el día en que se abre la cuenta.
La cadena de credenciales, escalón a escalón
En la unidad, La cadena de credenciales por defecto basta con saber que en el portátil la cadena se resuelve con la sesión de la CLI. Cada SDK tiene su propia lista completa, y el orden importa cuando el mismo script se ejecuta en sitios distintos.
En AWS, boto3 prueba en este orden: parámetros escritos en el código, variables de entorno, ~/.aws/credentials y ~/.aws/config (incluidos SSO y role_arn), credenciales de contenedor (las que inyecta ECS) y, por último, el servicio de metadatos de la instancia, en la dirección 169.254.169.254.
En Azure, DefaultAzureCredential prueba variables de entorno (las de un service principal), workload identity (la identidad de un pod de Kubernetes), managed identity (la identidad de la propia VM o del servicio) y, después, las credenciales de las herramientas de desarrollo: az login, Azure Developer CLI y PowerShell.
En Google Cloud, las Application Default Credentials miran GOOGLE_APPLICATION_CREDENTIALS (la ruta a un fichero JSON), luego ~/.config/gcloud/application_default_credentials.json y luego el servidor de metadatos.
Conocer el orden es lo que permite escribir un script sin ninguna credencial dentro que funcione igual en el portátil, en una VM de la nube y en un pipeline, y es también lo que explica que una variable de entorno olvidada mande sobre el perfil que se creía estar usando.
Asumir un rol desde otro perfil
Amplía Perfiles y ficheros de configuración: además de los perfiles empresa-dev y empresa-pre que se crean con SSO en la A4.4, ~/.aws/config admite un tercer tipo de perfil.
[profile empresa-admin]
role_arn = arn:aws:iam::123456789012:role/Admin
source_profile = empresa-dev
El tercer perfil muestra otro mecanismo: role_arn con source_profile hace que la CLI asuma un rol automáticamente usando las credenciales de otro perfil. Es la forma habitual de saltar entre cuentas.
Enlaces
- https://aws.amazon.com/compliance/shared-responsibility-model/: el modelo de responsabilidad compartida explicado por AWS, con el diagrama que todo el mundo copia.
- https://docs.aws.amazon.com/cli/latest/userguide/cli-configure-files.html: formato de
~/.aws/configy~/.aws/credentials, perfiles,sso-sessionyrole_arn. - https://docs.aws.amazon.com/cli/latest/userguide/cli-usage-output-format.html: formatos de salida y
--querycon JMESPath, con ejemplos que vale la pena copiar. - https://jmespath.org/tutorial.html: el tutorial oficial de JMESPath, que sirve igual para
aws --queryyaz --query. - https://docs.aws.amazon.com/IAM/latest/UserGuide/reference_policies_elements.html: referencia de los elementos de una política IAM (Effect, Action, Resource, Condition).
- https://boto3.amazonaws.com/v1/documentation/api/latest/guide/credentials.html: la cadena de credenciales de boto3, en el orden exacto en que se evalúa.
- https://learn.microsoft.com/cli/azure/azure-cli-configuration:
az config, ficheros de~/.azurey variables de entorno de la Azure CLI. - https://learn.microsoft.com/azure/role-based-access-control/overview: cómo funcionan las asignaciones de rol, los ámbitos y la herencia en Azure RBAC.
- https://learn.microsoft.com/python/api/overview/azure/identity-readme:
DefaultAzureCredentialy el orden en que prueba cada fuente. - https://cloud.google.com/sdk/gcloud/reference/config/configurations: referencia de las configurations de
gcloud. - https://cloud.google.com/docs/authentication/application-default-credentials: cómo buscan credenciales las librerías de Google (ADC) y por qué hay dos logins.
- https://github.com/gitleaks/gitleaks: instalación y uso de gitleaks, incluido el hook de pre-commit.
UT5 · Infraestructura como código
Cómo se llegó a la bifurcación de Terraform, detalles del estado, del inventario, de las pruebas y de los secretos que la unidad solo menciona, y enlaces de referencia de la UT5: documentación de OpenTofu, del provider de Proxmox, de Ansible y de los escáneres. Todo lo que se explica en clase y lo que necesitan las hojas de práctica sigue en la unidad; aquí solo está lo que va más allá.
Del cambio de licencia de Terraform a OpenTofu
Terraform nació en 2014 con licencia MPL 2.0, libre. En agosto de 2023 HashiCorp cambió la licencia de todos sus productos a la Business Source License 1.1, que prohíbe usar el código para ofrecer un producto que compita con HashiCorp. Para un usuario final no cambiaba nada, pero para las empresas que habían construido productos sobre Terraform (Spacelift, env0, Scalr, Gruntwork y otras) era un problema serio. En semanas publicaron el manifiesto OpenTF, bifurcaron la última versión con licencia MPL y en septiembre de 2023 el proyecto entró en la Linux Foundation con el nombre OpenTofu.
La 1.6 salió en enero de 2024 y desde entonces OpenTofu evoluciona por su cuenta: cifrado del estado, evaluación temprana de variables en backend y en el source de los módulos, for_each en providers y la opción -exclude en plan y apply. En 2025 IBM completó la compra de HashiCorp, lo que no cambió la licencia de Terraform. Para lo que se hace en clase la consecuencia sigue siendo la misma: el lenguaje, los providers y los ficheros son los mismos en las dos herramientas.
El estado cifrado y otros backends
Ampliación de Backend remoto: s3 contra MinIO, en la sesión 24.
use_lockfile = true implementa el bloqueo con un fichero .tflock junto al estado mediante escrituras condicionales de S3, sin necesidad de DynamoDB (la tabla de AWS que Terraform usaba para el bloqueo). Gitea ofrece además un backend http con bloqueo en su registro de paquetes: es la salida cuando no hay almacén S3 a mano, pero el laboratorio del curso usa el backend s3 contra MinIO, que es el que se encuentra en producción.
OpenTofu añade algo que Terraform no tiene: cifrado del estado en cliente, con un bloque encryption dentro de terraform {} y una clave derivada de una passphrase o de un servicio de gestión de claves. Con eso, lo que llega a MinIO ya va cifrado. Documentado en https://opentofu.org/docs/language/state/encryption/.
Importar con el bloque import
Ampliación de Manipular el estado, en la sesión 24.
Además de la orden tofu import, existe el bloque import { to = ..., id = ... } con la opción -generate-config-out=, que escribe el HCL automáticamente.
Inventario en YAML
Ampliación de Inventario, en la sesión 25.
El mismo inventario en YAML, que es el que ansible-lint (el revisor de estilo de Ansible, que se usa en la A5.5) prefiere:
all:
  vars:
    ansible_user: ops
  children:
    web: { hosts: { web01: { ansible_host: 10.20.1.10 } } }
    app: { hosts: { app01: { ansible_host: 10.20.2.10 } } }
    db:  { hosts: { db01:  { ansible_host: 10.20.3.10 } } }
ansible-inventory -i inventory.yml --graph dibuja los grupos y sirve para comprobar que la agrupación es la correcta.
tofu test y Molecule
Ampliación de Pruebas del despliegue, en la sesión 26.
tofu test ejecuta ficheros tests/*.tftest.hcl con bloques run que hacen un plan o un apply del módulo con variables de prueba y comprueban asserts:
mock_provider "proxmox" {}   # un provider simulado: la prueba no habla con Proxmox

run "memoria_minima" {
  command = plan
  variables { name = "t", vmid = 150, cores = 1, memory = 2048, disk = 20, bridge = "prefront", ip = "10.20.1.200/24" }
  assert {
    condition     = proxmox_virtual_environment_vm.this.memory[0].dedicated == 2048
    error_message = "La memoria no se ha propagado al recurso"
  }
}
Con command = plan no crea nada y sirve para probar módulos en CI sin Proxmox. Molecule hace lo mismo para roles de Ansible: levanta un contenedor o una VM, aplica el rol dos veces y ejecuta verificaciones. En la práctica evaluable no se piden.
sops, age y Vault en la práctica
Ampliación de Gestión de secretos, en la sesión 28.
- sops con age (age es un cifrador de ficheros con par de claves, como SSH; sops es el editor que lo aplica campo a campo): cifra ficheros YAML o JSON campo a campo, de modo que las claves siguen legibles y solo los valores van cifrados. El fichero cifrado se sube a Git y se descifra con la clave privada de cada persona autorizada.
age-keygen -o ~/.config/sops/age/keys.txt, un.sops.yamlen el repositorio con las claves públicas del equipo,sops -e secrets.yaml > secrets.enc.yamlysops -dpara leer. Terraform lo lee con el providercarlpett/sops(data "sops_file"), Ansible con la coleccióncommunity.sops. Es la opción habitual en equipos pequeños: el secreto viaja versionado con el código y no hace falta ningún servidor, a cambio de mantener a mano las claves públicas del equipo. - HashiCorp Vault (u OpenBao, su bifurcación libre por la misma razón que OpenTofu): un servidor de secretos con autenticación, políticas, rotación y auditoría. Terraform los lee con el provider
vaulty Ansible concommunity.hashi_vault. Es lo habitual en empresas grandes; montarlo bien es un proyecto en sí.
Enlaces
- https://opentofu.org/docs/language/ : referencia del lenguaje HCL (bloques, tipos, funciones, expresiones). Es la que hay que tener abierta mientras se escribe.
- https://opentofu.org/docs/cli/commands/state/ : todos los subcomandos de
tofu state, con los avisos sobre cuándo no usarlos. - https://opentofu.org/manifesto/ : el manifiesto OpenTF, para entender por qué existe el fork y qué se comprometieron a mantener.
- https://registry.opentofu.org/providers/bpg/proxmox/latest/docs : documentación del provider bpg/proxmox, recurso por recurso y por versión. La única fuente fiable para la sintaxis del bloque VM.
- https://pve.proxmox.com/wiki/User_Management : usuarios, roles, tokens y ACL de Proxmox; lo necesario para dar al token
terraform@pve!tofulos permisos justos. - https://docs.ansible.com/ansible/latest/playbook_guide/index.html : guía de playbooks, incluidas variables, precedencia, handlers y roles.
- https://docs.ansible.com/ansible/latest/collections/community/docker/docker_compose_v2_module.html : parámetros del módulo que despliega el compose del servicio.
- https://ansible.readthedocs.io/projects/lint/ : reglas de ansible-lint y perfiles; explica cada regla y cómo suprimirla.
- https://www.checkov.io/ y https://trivy.dev/ : documentación de los dos escáneres, con el catálogo de reglas y la sintaxis de supresión.
- https://github.com/gitleaks/gitleaks y https://github.com/getsops/sops : detección de secretos y cifrado de ficheros con age; los README son suficientes para empezar.
- https://cloudinit.readthedocs.io/ : lo que hace cloud-init en el primer arranque, para entender qué configura el bloque
initializationy qué hacer cuando no aplica.
UT6 · Orquestador de integración continua
Apartados que van más allá de lo que se hace en clase y enlaces para ampliar de la UT6: el mismo pipeline traducido a GitLab CI, las equivalencias de sintaxis entre los cuatro orquestadores, la variante en la que Jenkins sirve HTTPS por su cuenta, la operación de Jenkins en una empresa y la directiva matrix.
El mismo pipeline en GitLab CI
Para comprobar que lo aprendido se traslada, este es el equivalente del Jenkinsfile en .gitlab-ci.yml. Las diferencias de modelo: no hay agent, hay tags que eligen runner e image que elige contenedor; no hay parameters, hay variables que se rellenan al lanzar a mano o que se fijan con rules; el when es rules; el stash no hace falta porque cada job clona el repositorio; y los informes JUnit se publican con artifacts:reports.
# .gitlab-ci.yml
stages: [test, package, deploy]

variables:
  REGISTRY: registry.lab:5000
  IMAGE: $CI_REGISTRY_IMAGE       # o $REGISTRY/app si el registry no es el de GitLab
  DEPLOY_ENV:
    value: "pre"
    options: ["pre"]
    description: "Entorno de despliegue"

default:
  tags: [docker]                  # runner con ejecutor docker
  interruptible: true

test:
  stage: test
  image: python:3.12
  script:
    - pip install -r requirements.txt
    - pytest --junitxml=report.xml
  artifacts:
    when: always
    reports:
      junit: report.xml

package:
  stage: package
  image: docker:27
  services: [docker:27-dind]
  rules:
    - if: $CI_COMMIT_BRANCH == "main"
  script:
    - echo "$REGISTRY_PASSWORD" | docker login -u "$REGISTRY_USER" --password-stdin $REGISTRY
    - docker build -t $REGISTRY/app:$CI_COMMIT_SHORT_SHA -t $REGISTRY/app:latest api
    - docker push --all-tags $REGISTRY/app

deploy:
  stage: deploy
  tags: [deploy]                  # runner con ejecutor shell en la máquina de despliegue
  rules:
    - if: $CI_COMMIT_BRANCH == "main"
      when: manual                # equivale a RUN_DEPLOY: alguien pulsa
  environment:
    name: $DEPLOY_ENV
  resource_group: $DEPLOY_ENV     # equivale a disableConcurrentBuilds por entorno
  timeout: 30m
  script:
    - docker save $REGISTRY/app:$CI_COMMIT_SHORT_SHA | ssh ops@10.20.2.10 sudo docker load
    - ansible-playbook -i ansible/inventory.ini ansible/site.yml
    - SOLO_PRUEBAS=1 ./test.sh $DEPLOY_ENV
REGISTRY_USER, REGISTRY_PASSWORD y la clave SSH de despliegue no van en el fichero: se crean en Settings → CI/CD → Variables marcadas como Masked (se ocultan en el log) y Protected (solo se inyectan en ramas y etiquetas protegidas, así una rama de un desarrollador no puede leer la clave que entra en pre). Es el equivalente de las credenciales por carpeta de Jenkins. El after_script con limpieza y la notificación por fallo se hacen con integraciones del proyecto (Settings → Integrations) en vez de con un post.
Equivalencias entre los cuatro orquestadores
Detalle de sintaxis y de funcionamiento interno de los cuatro orquestadores que se comparan en Elegir el orquestador. No hace falta para elegir uno, pero sirve para reconocer un repositorio ajeno o para traducir un pipeline de una herramienta a otra.
| Jenkins | GitLab CI | GitHub Actions | Gitea Actions | |
|---|---|---|---|---|
| Definición | Jenkinsfile (Groovy declarativo o scripted) |
.gitlab-ci.yml |
Workflows YAML en .github/workflows/ |
Workflows YAML compatibles con Actions |
| Modelo de ejecución | Controlador + agentes (SSH, inbound, Docker, Kubernetes) | Runners registrados por proyecto, grupo o instancia; ejecutor shell, docker o kubernetes | Runners hospedados por GitHub o propios | Runners propios, ejecutor docker o host |
| Secretos | Credenciales cifradas en jenkins_home, con ámbito global o por carpeta |
Variables de proyecto/grupo, con protected y masked | Secrets de repositorio, entorno y organización | Secrets de repositorio y organización |
Jenkins con keystore Java
En el curso, nginx termina TLS y Jenkins habla HTTP por la red interna del compose. La alternativa es que Jenkins sirva HTTPS él mismo cargando un keystore Java, un fichero que guarda el certificado y la clave en el formato que entiende Java. Se usa cuando no hay ningún proxy delante, por ejemplo en un servidor único que no publica nada más, o cuando la política de la empresa exige TLS hasta el propio proceso Java. A cambio, cada renovación del certificado obliga a rehacer el keystore y a reiniciar Jenkins, y la contraseña del keystore hay que guardarla en algún sitio.
# compose.yml
services:
  jenkins:
    image: jenkins/jenkins:lts-jdk21
    ports: ["8443:8443"]
    volumes:
      - jenkins_home:/var/jenkins_home
      - ./certs:/certs:ro
    environment:
      JENKINS_OPTS: "--httpPort=-1 --httpsPort=8443 --httpsKeyStore=/certs/jenkins.jks --httpsKeyStorePassword=changeit"
volumes:
  jenkins_home:
El keystore se construye a partir del certificado y la clave que emite la CA interna:
# Certificado + clave -> PKCS12 -> JKS
openssl pkcs12 -export -in jenkins.crt -inkey jenkins.key -certfile ca.crt \
  -name jenkins -out jenkins.p12 -passout pass:changeit
keytool -importkeystore -srckeystore jenkins.p12 -srcstoretype PKCS12 \
  -srcstorepass changeit -destkeystore jenkins.jks -deststorepass changeit
--httpPort=-1 apaga el HTTP en claro. La contraseña del keystore va en claro en el compose; en el laboratorio es aceptable, en producción se pasa con un fichero .env fuera del repositorio o se termina TLS en el proxy inverso, que es lo que hace la instalación del curso.
Operar Jenkins: directorio, actualizaciones y copias
Ampliación de Usuarios y permisos y de Hardening del controlador, en la sesión 31: lo que en una empresa rodea a un Jenkins como el del curso y que en el laboratorio no se monta.
- Autenticación contra LDAP/AD (el directorio de usuarios de la empresa) o GitLab cuando exista (plugins
ldapygitlab-oauth); usuarios locales solo en el laboratorio. Cuando alguien deja la empresa, su cuenta se desactiva en un sitio, no en quince. - Actualizaciones: el controlador con la LTS (una versión cada doce semanas con parches entre medias) y los plugins revisados al menos una vez al mes. El panel de plugins marca en rojo los que tienen avisos de seguridad publicados en jenkins.io/security.
- Backup de
jenkins_home(configuración, jobs, credenciales cifradas). Con JCasC, la configuración ya está en Git; lo que queda por salvar es el historial de ejecuciones y, sobre todo,secrets/master.keyysecrets/hudson.util.Secret, sin los cuales las credenciales cifradas del backup no sirven. Untardel volumen con el contenedor parado, o el pluginthinBackup, cada noche.
La directiva matrix
Ampliación de Más directivas que hacen falta, en la sesión 35.
matrix genera una etapa por cada combinación de ejes; es útil para probar contra varias versiones:
stage('Test matrix') {
    matrix {
        axes {
            axis { name 'PY'; values '3.11', '3.12', '3.13' }
        }
        agent { docker { image "python:${PY}"; label 'docker' } }
        stages {
            stage('pytest') { steps { unstash 'src'; sh 'pytest' } }
        }
    }
}
Enlaces
- Pipeline Syntax (jenkins.io): la referencia del declarativo;
when,parallel,matrix,postyoptionscon todos sus valores. - Using Docker with Pipeline: la diferencia entre
agent { docker },docker.buildydocker.withRegistry, con ejemplos. - Installing Jenkins with Docker: la instalación oficial en contenedor y las opciones de
JENKINS_OPTS. - Configuration as Code plugin: documentación y una carpeta
demos/con YAML de ejemplo para casi cada plugin. - Securing Jenkins: CSRF, aislamiento del controlador, Agent → Controller security y cómo se publican los avisos.
- Using credentials: tipos, ámbitos y
withCredentials, incluido el aviso sobre interpolación de Groovy. - Using Jenkins agents: SSH, inbound y el porqué de las etiquetas.
- GitLab CI/CD YAML reference: para traducir cualquier construcción del
Jenkinsfilea.gitlab-ci.yml. - Deploy a registry server (Distribution): TLS, autenticación y almacenamiento del registry.
- Verify repository client with certificates (Docker): el directorio
certs.dy cómo Docker decide en quién confía. - Continuous Integration, Martin Fowler: el texto de referencia sobre qué es CI y por qué; corto y sin herramientas.
UT7 · Monitorización del entorno
Dos cosas distintas de la UT7. La primera es el programa de sus 12 horas en la formación en empresa (la UT7b del calendario), con las cinco evidencias que se entregan: está aquí porque no se da en el centro, pero no es opcional. La segunda, como en el resto de unidades, son los apartados que no se explican en clase ni necesita ninguna hoja obligatoria: la retención y el almacenamiento a largo plazo de Prometheus, el presupuesto de error con sus números, la pila montada desde cero en un solo compose, el formato de exposición de las métricas, el modelo de datos y la cardinalidad, los exporters más habituales, el descubrimiento de contenedores, la elección entre Grafana Alerting y las reglas de Prometheus, TLS y basic auth en la pila, la protección de sus datos y los enlaces para ampliar.
En la empresa: monitorización avanzada
Este es el programa de la UT7b: las 12 horas de esta unidad que se hacen en la formación en empresa, después de las dos sesiones del centro. Sirven para ver la pila en un entorno que no cabe en tres VM y completan los criterios de evaluación 4i, 4j y 4k. Lo que se espera hacer, o al menos observar con quien lo hace:
- Alertas con enrutado y silencios reales: árbol de rutas por equipo y severidad, guardias (PagerDuty, Opsgenie o turnos en Telegram), inhibiciones entre capas (si cae el switch, no avisan los 40 hosts detrás), silencios ligados a ventanas de mantenimiento y revisión de las alertas que nadie atiende (una alerta un mes en firing sin que nadie la mire, sobra).
- KPI de negocio: métricas que no son de infraestructura (pedidos por minuto, tiempo de cola, usuarios activos) expuestas por la aplicación o leídas de la base de datos, en un dashboard para gente no técnica.
- SLI/SLO y error budget: al menos un SLO acordado con la empresa, el SLI en PromQL que lo mide, un panel con el presupuesto restante y una alerta de burn rate (el método está en Error budget y burn rate, más abajo).
- Seguridad de la pila: cómo se autentica Grafana (LDAP, OAuth), quién ve qué (carpetas y permisos por equipo), cómo llegan las credenciales a los exporters, qué retención hay y si existe Thanos, Mimir o un servicio gestionado detrás.
Las cinco evidencias de la UT7b, que van a la memoria de la formación en empresa (una página por punto, con capturas anonimizadas si hace falta):
- Esquema de la pila de monitorización de la empresa: qué recoge, dónde se guarda y cuánto tiempo (CE 4i).
- Extracto del árbol de rutas de Alertmanager (o equivalente) comentado: quién recibe qué (CE 4j).
- Un dashboard de KPI de negocio, con la consulta de al menos un panel explicada (CE 4j).
- Un SLO escrito (SLI, objetivo, ventana), con el cálculo del error budget y la alerta asociada (CE 4j).
- Lista de medidas de seguridad de la pila y una propuesta de mejora justificada (CE 4k).
Retención y almacenamiento
Conviene saber cuánto disco y memoria va a pedir la pila y qué pasa cuando los 45 días de retención del laboratorio se quedan cortos; aquí va el cálculo aproximado y las herramientas del largo plazo.
La TSDB de Prometheus escribe bloques de 2 h que luego compacta en bloques mayores (hasta un 10 % de la retención). La compresión (delta de deltas para timestamps, XOR para valores) deja cada muestra en 1 a 2 bytes. Cálculo aproximado de disco: series activas × muestras por segundo por serie × bytes por muestra × segundos de retención. Para las 7 000 series del laboratorio a 15 s y 45 días: 7 000 / 15 × 1,5 × 3 888 000 ≈ 2,7 GB, más la WAL (write-ahead log, el diario donde apunta las muestras antes de formar bloque: las últimas 2 a 3 h sin compactar) y la memoria del head, que suele limitar antes que el disco.
Dos límites que conviene tener claros. Prometheus es un servidor único: no se agrupa ni replica; la alta disponibilidad se hace con dos Prometheus idénticos leyendo los mismos targets y Alertmanager deduplicando. Y la retención de años o las consultas globales sobre varios Prometheus no son su problema: para eso existen Thanos y Grafana Mimir, que reciben los bloques o las muestras por remote write (Prometheus las reenvía a otro servidor según las escribe) y las guardan en almacenamiento de objetos (S3, MinIO). Aparecen en cualquier empresa mediana; en el curso quedan en mención.
Error budget y burn rate
Cuando un SLO se escribe como un porcentaje, lo que sobra hasta el 100 % es el presupuesto de error: el tiempo que el servicio puede estar mal sin incumplir el compromiso. Con un SLO del 99,5 % en 30 días queda un 0,5 %, que son 216 minutos, 3 h 36 min al mes (30 × 24 × 60 × 0,005).
| Objetivo en 30 días | Presupuesto de error | Qué permite de verdad |
|---|---|---|
| 99 % | 7 h 12 min | Una ventana de mantenimiento larga al mes y algún susto |
| 99,5 % | 3 h 36 min | El objetivo razonable para un servicio interno sin guardias |
| 99,9 % | 43 min | Un reinicio planificado y poco más; obliga a despliegues sin corte |
| 99,99 % | 4 min 19 s | No da ni para reiniciar una máquina virtual; exige redundancia real |
El presupuesto es una herramienta de decisión, no un castigo. Si a mitad de mes se ha gastado el 90 %, se congelan los despliegues arriesgados y el esfuerzo se va a estabilizar; si sobra presupuesto, se asume más riesgo y se aprovecha para migrar, actualizar o probar. Esa conversación es la que evita las dos posturas estériles: la de quien no quiere desplegar nunca y la de quien despliega el viernes a las siete.
En el laboratorio el SLI de disponibilidad es el de la unidad, la fracción del tiempo en que la API ha respondido a Prometheus en la ventana entera:
En la empresa lo habitual es medirlo desde fuera, que es como lo vive quien paga, con una sonda de blackbox_exporter (ver Exporters más habituales); la consulta es la misma cambiando up{job="app"} por probe_success de la sonda.
El burn rate es la velocidad a la que se gasta ese presupuesto: un burn rate de 1 lo agota justo al acabar la ventana, y uno de 14,4 lo agota en dos días. Las alertas por burn rate combinan dos ventanas, una larga para reconocer el incidente y una corta para dejar de avisar en cuanto se recupera, y comparan la tasa de error con el presupuesto multiplicado por ese factor:
(1 - avg_over_time(up{job="app"}[1h]))   > 14.4 * 0.005
and
(1 - avg_over_time(up{job="app"}[5m]))   > 14.4 * 0.005
Esto es lo que sustituye en la empresa a las alertas de "CPU por encima del 85 %": no avisan de que una máquina está ocupada, sino de que el servicio se está gastando el mes. El método completo, con la tabla de ventanas y factores recomendados, está en Alerting on SLOs del SRE Workbook, enlazado en los Enlaces de esta misma unidad. En el módulo 5169 se trabaja entero, con números y con la alerta montada, en la UT4, sesión 21.
La pila en un solo compose
Así se despliega la pila entera desde cero con Docker Compose en una sola VM: cuatro contenedores (Prometheus, Alertmanager, Grafana y un correo de pruebas) más un exporter en cada máquina vigilada. En el curso no se monta así, porque la pila de mon01 la levantó y la cerró el módulo 5169 y la UT7 trabaja sobre ella; esto es la referencia para montarla en otro sitio.
En el compose conviene fijarse en los volúmenes con nombre (los datos sobreviven a un docker compose down), en la configuración montada en solo lectura, en los flags de retención y en que nada se publica fuera de 127.0.0.1: a Grafana se llega por un nginx con TLS y al resto por túnel.
# compose.yml (una VM de monitorización)
services:
  prometheus:
    image: prom/prometheus:v3.5.0
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml:ro
      - ./alerts.yml:/etc/prometheus/alerts.yml:ro
      - ./targets:/etc/prometheus/targets:ro
      - ./tls:/etc/prometheus/tls:ro
      - prom_data:/prometheus
    command:
      - --config.file=/etc/prometheus/prometheus.yml
      - --storage.tsdb.retention.time=45d
      - --storage.tsdb.retention.size=8GB
      - --web.enable-lifecycle
      - --web.listen-address=:29090
    ports: ["127.0.0.1:29090:29090"]
    restart: unless-stopped
  alertmanager:
    image: prom/alertmanager:v0.28.1
    volumes:
      - ./alertmanager.yml:/etc/alertmanager/alertmanager.yml:ro
      - am_data:/alertmanager
    command:
      - --config.file=/etc/alertmanager/alertmanager.yml
      - --storage.path=/alertmanager
      - --web.listen-address=:29093
    ports: ["127.0.0.1:29093:29093"]
    restart: unless-stopped
  grafana:
    image: grafana/grafana:12.1.0
    environment:
      GF_SECURITY_ADMIN_PASSWORD__FILE: /run/secrets/grafana_admin
      GF_USERS_ALLOW_SIGN_UP: "false"
      GF_SERVER_HTTP_PORT: "23000"
    volumes:
      - graf_data:/var/lib/grafana
      - ./grafana/provisioning:/etc/grafana/provisioning:ro
      - ./grafana/dashboards:/var/lib/grafana/dashboards:ro
      - ./secrets/grafana_admin:/run/secrets/grafana_admin:ro
    ports: ["127.0.0.1:23000:23000"]   # delante va un nginx con TLS en el 443
    restart: unless-stopped
  mailpit:
    image: axllent/mailpit:v1.22.3
    environment:
      MP_UI_BIND_ADDR: "0.0.0.0:28025"
    ports: ["127.0.0.1:28025:28025"]   # interfaz web; SMTP en 1025 solo dentro de la red de compose
    restart: unless-stopped
volumes: { prom_data: {}, am_data: {}, graf_data: {} }
Las versiones se fijan siempre (nada de latest en una pila que tiene que ser reproducible). Los puertos son los de la franja del curso, y cada servicio escucha dentro de su contenedor en el mismo número con el que se publica: lo fija --web.listen-address en Prometheus y en Alertmanager, GF_SERVER_HTTP_PORT en Grafana y MP_UI_BIND_ADDR en Mailpit. Si solo se cambia el ports:, el contenedor sigue escuchando en su puerto de fábrica y la conexión se corta. El command de Alertmanager repite además las dos opciones que su imagen trae de serie, porque al escribirlo se sustituyen. --web.enable-lifecycle permite recargar la configuración con curl -X POST http://localhost:29090/-/reload sin reiniciar el contenedor. La retención por tiempo y por tamaño se combinan: lo primero que se cumpla borra bloques antiguos.
En cada máquina a vigilar:
- node_exporter (puerto 29100 en el curso): CPU, memoria, disco, red, carga, systemd del host. Se instala con el paquete
prometheus-node-exporterde Debian, que ya trae su unidad de systemd y su usuario de servicio y lee sus opciones de la líneaARGSde/etc/default/prometheus-node-exporter, donde va--web.listen-address=:29100(en el curso viene así en la plantilla 9000), o con el binario oficial si hace falta una versión más nueva que la del repositorio; también existe como contenedor con--pid=hosty los volúmenes/proc,/sysy/montados en solo lectura. Conviene dejarlo fuera de Docker: un exporter que depende de Docker no puede avisar de que Docker se ha caído. - cAdvisor: CPU, memoria, red y disco por contenedor, leyendo los cgroups (el mecanismo del kernel con el que Docker limita y contabiliza los recursos de cada contenedor). Va como contenedor (
gcr.io/cadvisor/cadvisor) con/var/run/docker.sock,/sysy/var/lib/dockermontados, y con--port=28081en sucommandpara que escuche dentro del contenedor en el mismo puerto con el que se publica en la IP de la zona: el 28081 y no el 28080, que enapp01es el de la API del curso. Es glotón: con muchos contenedores conviene arrancarlo con--docker_only=true --housekeeping_interval=30s.
# prometheus.yml
global:
  scrape_interval: 15s
  evaluation_interval: 15s
rule_files: ["alerts.yml"]
alerting:
  alertmanagers:
    - static_configs: [{ targets: ["alertmanager:29093"] }]
scrape_configs:
  - job_name: prometheus
    static_configs: [{ targets: ["localhost:29090"] }]
  - job_name: node
    static_configs:
      - targets: ["10.10.3.10:29100", "10.10.0.10:29100", "10.10.0.20:29100"]
  - job_name: cadvisor
    static_configs: [{ targets: ["10.10.2.10:28081"] }]
  - job_name: jenkins
    scheme: https                      # Jenkins solo se publica por su nginx, en el 443
    metrics_path: /prometheus/
    tls_config: { ca_file: /etc/prometheus/tls/ca.crt }
    static_configs: [{ targets: ["jenkins.lab:443"] }]
Con scrape_interval: 15s y un entorno de cuatro hosts (unas 1 000 series por node_exporter, otras 2 000 de cAdvisor con veinte contenedores, 300 de Jenkins) el entorno queda en torno a 7 000 series activas y 470 muestras por segundo: unos 60 MB al día en disco, algo menos de 3 GB en los 45 días de retención. Se comprueba con du -sh sobre prom_data al cabo de una semana.
El formato de exposición
Para entender lo que Prometheus guarda hay que ver primero lo que lee: cada exporter publica una página de texto que se puede abrir con el navegador, y conviene saber leerla porque es lo primero que se mira cuando un panel sale vacío.
Un /metrics es texto plano, una métrica por línea, con dos líneas de comentario opcionales (HELP y TYPE) que la documentan. Esto es un extracto real de lo que devuelve un node_exporter, por ejemplo el de db01 con curl -s http://10.10.3.10:29100/metrics desde mon01 (node_exporter expone entre 500 y 1500 líneas según el hardware):
# HELP node_cpu_seconds_total Seconds the CPUs spent in each mode.
# TYPE node_cpu_seconds_total counter
node_cpu_seconds_total{cpu="0",mode="idle"} 118372.63
node_cpu_seconds_total{cpu="0",mode="iowait"} 41.2
node_cpu_seconds_total{cpu="0",mode="system"} 1204.77
node_cpu_seconds_total{cpu="0",mode="user"} 3521.12
node_cpu_seconds_total{cpu="1",mode="idle"} 118401.02
# HELP node_memory_MemAvailable_bytes Memory information field MemAvailable_bytes.
# TYPE node_memory_MemAvailable_bytes gauge
node_memory_MemAvailable_bytes 6.1478912e+09
# HELP node_filesystem_avail_bytes Filesystem space available to non-root users in bytes.
# TYPE node_filesystem_avail_bytes gauge
node_filesystem_avail_bytes{device="/dev/sda1",fstype="ext4",mountpoint="/"} 2.4512e+10
# HELP http_request_duration_seconds Duración de las peticiones (ejemplo de una app instrumentada)
# TYPE http_request_duration_seconds histogram
http_request_duration_seconds_bucket{handler="/api",le="0.1"} 240
http_request_duration_seconds_bucket{handler="/api",le="0.5"} 310
http_request_duration_seconds_bucket{handler="/api",le="1"} 318
http_request_duration_seconds_bucket{handler="/api",le="+Inf"} 320
http_request_duration_seconds_sum{handler="/api"} 41.2
http_request_duration_seconds_count{handler="/api"} 320
Los cuatro tipos:
- Counter: solo sube (o se pone a cero cuando el proceso reinicia). Segundos de CPU, bytes enviados, peticiones servidas, builds fallidas. El valor bruto no dice nada; lo que interesa es su velocidad, y para eso está
rate(). - Gauge: sube y baja. Memoria disponible, temperatura, número de contenedores en ejecución. Se lee tal cual.
- Histogram: cuenta observaciones en cubos (
_bucketcon etiquetale, "less or equal") acumulativos, más_sumy_count. En el ejemplo, 240 peticiones tardaron 0,1 s o menos, 310 tardaron 0,5 s o menos (incluye las 240 anteriores) y hubo 320 en total. Con esto se calculan percentiles en el servidor conhistogram_quantile, y se pueden sumar histogramas de varias instancias. - Summary: el cliente calcula los percentiles y los expone ya hechos (
{quantile="0.95"}). Es más preciso pero no se puede agregar entre instancias: la media de dos p95 no es el p95 global. En la práctica se prefiere histogram.
Prometheus 3 acepta también OpenMetrics, una versión estandarizada de este mismo texto, pero lo que se ve en los exporters es esto.
Modelo de datos y cardinalidad
Este apartado explica de qué depende que Prometheus vaya ligero o se muera por falta de memoria, y la respuesta no es "cuántos datos guarda" sino "cuántas series distintas". Entender la diferencia evita el error más caro de esta tecnología.
Una serie temporal es la combinación única de nombre de métrica y conjunto de pares etiqueta=valor. node_cpu_seconds_total en un host de 4 núcleos con 8 modos de CPU son 32 series, no una. Prometheus añade automáticamente job (el nombre del bloque de scrape) e instance (host:puerto) a todo lo que lee, y guarda cada serie como una secuencia de (timestamp, valor) comprimida en su TSDB (la base de datos de series temporales que lleva integrada).
El coste de Prometheus está en el número de series, no en el de muestras: cada serie activa consume memoria en el "head block" (unos pocos KB) y entrada de índice; cada muestra nueva de una serie existente cuesta un par de bytes. Por eso una etiqueta con muchos valores distintos es venenosa: a ese número de valores distintos se le llama cardinalidad. Ejemplo real: un desarrollador con buena intención añade user_id a http_requests_total. Con 50 000 usuarios, 20 rutas y 5 códigos de estado son 5 millones de series potenciales en lugar de 100; la memoria se dispara, las consultas que tardaban 50 ms tardan 30 s y el proceso muere por OOM (el kernel lo mata al quedarse sin memoria). Lo mismo con IPs de cliente, sesiones, IDs de contenedor efímeros o marcas de tiempo en una etiqueta. La regla: una etiqueta debe tener pocos valores posibles (método HTTP, código de estado, host, servicio). Lo que identifica a un usuario va al log, no a la métrica. Para vigilarlo, prometheus_tsdb_head_series da las series activas y Status → TSDB Status en la interfaz enseña las diez métricas y etiquetas con más cardinalidad.
Exporters más habituales
En el laboratorio se leen cuatro fuentes, pero en la empresa cada servicio tiene su exporter y la pregunta es siempre la misma: qué puerto abre, qué mide y qué necesita. Esta tabla es la chuleta de los más habituales, con el puerto de fábrica de cada uno y, en los que monta el laboratorio, el de la franja del curso; el párrafo de después explica el único que mide desde fuera.
| Exporter | Puerto | Para qué | Comentario |
|---|---|---|---|
| node_exporter | 9100 de fábrica; 29100 en el curso | Sistema operativo del host | El primero que se instala en cualquier máquina Linux |
| cAdvisor | 8080 de fábrica; 28081 en el curso, dentro y fuera del contenedor | Contenedores por cgroup | Mantenido por Google; en Kubernetes va dentro del kubelet |
| blackbox_exporter | 9115 de fábrica | Sondas desde fuera: HTTP, TCP, ICMP, DNS | Prometheus le pasa la URL como parámetro; mide lo que ve el usuario (código, latencia, caducidad del certificado TLS) |
| postgres_exporter | 9187 de fábrica; 29187 en el curso | Conexiones, transacciones, tamaño, réplica de PostgreSQL | Necesita un usuario de solo lectura en la BD, con pg_monitor |
| nginx-prometheus-exporter | 9113 de fábrica | Conexiones activas y peticiones de nginx | Lee stub_status; para métricas por ruta hace falta un módulo de terceros o Traefik |
| Plugin Prometheus de Jenkins | 443 (https://jenkins.lab/prometheus/) |
Builds, duración, cola, ejecutores | Prefijo default_ en sus métricas propias (las de cola y ejecutores van sin él); se puede exigir autenticación en el endpoint |
Blackbox cambia el punto de vista: los demás miden desde dentro ("el proceso usa 300 MB"); blackbox mide desde fuera ("la URL responde 200 en 120 ms y el certificado caduca en 41 días"), que es lo que le importa al que paga. Un job de blackbox contra la aplicación es el SLI de disponibilidad más honesto que se puede tener, y probe_ssl_earliest_cert_expiry - time() < 14*86400 es una alerta que ha salvado más de un fin de semana. En el laboratorio del curso no se instala.
Descubrimiento con docker_sd_configs
Además de file_sd, Prometheus sabe descubrir contenedores. Con docker_sd_configs habla con el socket de Docker (o con un tcp:// protegido con TLS) y descubre los contenedores en marcha, exponiendo sus etiquetas como __meta_docker_container_label_*. Con relabel_configs se decide qué contenedores se leen (por ejemplo, los que tienen la etiqueta prometheus.scrape=true) y en qué puerto. Es la antesala de kubernetes_sd_configs, que funciona igual. En el laboratorio se usa file_sd, generado con Ansible desde el inventario.
Grafana Alerting o reglas de Prometheus
Grafana 12 trae su propio motor de alertas, equivalente a Alertmanager y configurable desde la interfaz. En la UT7 las reglas viven en Prometheus porque se evalúan junto a los datos, siguen funcionando si Grafana se cae, se validan con promtool y van en Git; Grafana Alerting encaja cuando la alerta cruza varias fuentes de datos o cuando quien la mantiene no toca YAML. Conviene elegir una de las dos para cada tipo de alerta: duplicarlas acaba en dos notificaciones y nadie sabe cuál es la buena.
TLS y basic auth en Prometheus y los exporters
Desde la versión 2.24 el servidor de Prometheus (y todos los exporters oficiales, que comparten el mismo toolkit) aceptan un --web.config.file con TLS y usuarios de basic auth. Las contraseñas van en bcrypt (htpasswd -nBC 10 admin genera el hash).
# web.yml (para Prometheus y para node_exporter)
tls_server_config:
  cert_file: /etc/prometheus/tls/mon01.crt
  key_file: /etc/prometheus/tls/mon01.key
basic_auth_users:
  scraper: "$2y$10$Q8v7...hash bcrypt..."
Si se pone basic auth en los exporters, Prometheus tiene que presentarla al leer: en cada scrape_config, scheme: https, tls_config: { ca_file: /etc/prometheus/tls/ca.crt } y basic_auth: { username: scraper, password_file: /etc/prometheus/secrets/scraper.pass }. La CA es la del curso, la de la A3.2, y el certificado del servidor lleva el nombre mon01 en el SAN (el campo del certificado donde van los nombres de host que cubre). Alertmanager y Grafana también hablan con Prometheus: si Prometheus pide contraseña, hay que darles las mismas credenciales. En el laboratorio del curso, el módulo 5169 cifra así el node_exporter de app01 en su A3.2, y el job node-tls de la UT7 lo lee con esas credenciales.
El repositorio de datos de la pila
Los volúmenes prom_data y graf_data son el repositorio de datos, y quien llega a ellos tiene el histórico entero sin pasar por ninguna contraseña. Permisos restringidos en el host (usuario nobody para Prometheus, 472 para Grafana), retención definida (45 días en el curso) y copia de seguridad: los dashboards como JSON en Git, que es lo que hace la A7.2 con el panel de la plataforma, y, si el histórico importa, snapshots de la TSDB con curl -XPOST http://localhost:29090/api/v1/admin/tsdb/snapshot copiados fuera de la máquina.
Dos cosas que se olvidan. La primera, que el snapshot necesita --web.enable-admin-api, y esa misma API permite borrar series enteras con una petición HTTP: se activa el rato que dura la copia y se vuelve a quitar, nunca se deja puesta "por comodidad". La segunda, que la base de datos de Grafana dentro de graf_data guarda los usuarios, los tokens de servicio y las credenciales de las fuentes de datos cifradas con la clave secreta de la instancia: una copia de ese volumen vale tanto como la contraseña de administración si la clave viaja al lado. Las copias se guardan con las mismas restricciones de acceso que el original, y quien pueda restaurarlas debe estar en la misma lista corta que quien puede entrar en mon01.
Enlaces
- Prometheus: Overview: la documentación oficial, empezando por la arquitectura y el modelo de datos. Todo lo de esta unidad está ahí con más detalle.
- Querying basics (PromQL) y Functions: la referencia de selectores, operadores y funciones; conviene tenerla abierta mientras se hace la A7.1.
- Configuration (prometheus.yml): todas las opciones de scrape, descubrimiento (
file_sd_configs,docker_sd_configs) y relabeling. - Alerting rules y Alertmanager configuration: plantillas de anotaciones, rutas, inhibiciones y todos los receptores.
- Securing Prometheus: TLS and basic auth y web configuration: el
web.config.fileque usa el node_exporter deapp01desde la A3.2 de Mantenimiento. - Prometheus storage: cómo funciona la TSDB, retención, snapshots y remote write.
- Grafana documentation: Provisioning: fuentes de datos y dashboards desde ficheros, la base para versionarlos en Git.
- Grafana Alerting: para comparar con las reglas de Prometheus.
- Node Exporter Full (dashboard 1860): el dashboard que la A7.2 deja para cuando sobra tiempo, y una buena cantera de consultas.
- Google SRE Workbook: Alerting on SLOs: el método de burn rate y error budget que aparece en la empresa.
- cAdvisor y node_exporter: el README de cada uno tiene la lista de métricas y los flags de arranque (los colectores de node_exporter se activan y desactivan uno a uno).