Curso de especialización · Curso 2026-27
Despliegue de plataformas de contenedores
Apuntes de la asignatura
Víctor Sellés, con apoyo de Claude (Anthropic)
Versión v1.2-12-g80b217d · 80b217d · https://victor-educ.github.io/apuntes-5166/
Texto e imágenes propias con licencia CC BY-SA 4.0. Las imágenes de terceros llevan su atribución al pie.
Despliegue de plataformas de contenedores
Aquí están los apuntes de toda la asignatura, unidad por unidad, con las actividades de cada sesión y las prácticas evaluables. Es el mismo material que se trabaja en clase, ampliado con lo que no cabe en dos horas y con enlaces a la documentación oficial para no quedarse en lo que se explica en clase. La asignatura hermana, Mantenimiento del sistema de contenedores, tiene su propio sitio con la misma estructura.
De qué va la asignatura
Un contenedor no corre en el aire. Debajo hay una máquina virtual, debajo de la máquina virtual un hipervisor, alrededor una red con subredes y cortafuegos, y por encima algo que decide cuándo se despliega una versión nueva y avisa si ha ido mal. Esta asignatura se ocupa de todo eso: de la plataforma sobre la que se ejecutan los contenedores, no de los contenedores en sí. Todo eso se monta desde cero, pieza a pieza, hasta llegar a un entorno completo que se despliega solo.
Estos son los conceptos que vertebran el curso, en el orden en que aparecen:
- Virtualización. Qué hace un hipervisor, cómo KVM reparte CPU, memoria y disco entre máquinas virtuales, y cómo se crea una VM en veinte segundos a partir de una plantilla con cloud-init. Se trabaja con Proxmox VE.
- Redes privadas virtuales. Diseñar el direccionamiento de varios entornos (dev, pre, pro) que no se solapen ni se vean entre sí, con sus subredes por capa, su router, su DHCP y su DNS interno.
- Seguridad por capas. DMZ externa, DMZ interna y zona interna separadas por un cortafuegos con política de denegar por defecto, un proxy inverso que publica el servicio y pruebas que demuestran que el aislamiento funciona.
- Nube pública. La misma infraestructura alquilada por horas: consola, línea de comandos y SDK de AWS, Azure o Google Cloud. Se trabaja en la empresa.
- Infraestructura como código. Todo lo anterior escrito en ficheros que OpenTofu y Ansible aplican de forma reproducible, versionado en Git, probado y escaneado en busca de errores de seguridad.
- Integración continua. Un orquestador (Jenkins) que, con cada cambio en el repositorio, construye, prueba, empaqueta y despliega el servicio, con gestión de errores y mínimo privilegio.
- Monitorización. Sobre la pila de Prometheus y Grafana que monta la asignatura hermana, las métricas de hosts, contenedores y del propio orquestador, un panel con los indicadores de la plataforma y una alerta que llega por correo cuando algo se cae.
flowchart LR
    UT1["<b>UT1</b><br><small>Hipervisor</small>"]:::pieza
    UT2["<b>UT2</b><br><small>VPC</small>"]:::pieza
    UT3["<b>UT3</b><br><small>Seguridad por capas</small>"]:::pieza
    UT5["<b>UT5</b><br><small>IaC</small>"]:::pieza
    UT6["<b>UT6</b><br><small>Pipeline CI</small>"]:::pieza
    UT7["<b>UT7</b><br><small>Monitorización</small>"]:::pieza
    UT4["<b>UT4</b><br><small>Nube pública<br>en la empresa</small>"]:::infra
    FE["<b>Formación en empresa</b><br><small>UT4 · UT7b · UT8</small>"]:::infra
    UT1 --> UT2 --> UT3 --> UT5 --> UT6 --> UT7
    UT3 -.-> UT4
    UT7 -.-> FE
    classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
    classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
    classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
    classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
    classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
    classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5px
Cada unidad se apoya en la anterior. Las de trazo discontinuo se cursan en la empresa.
Cada unidad se apoya en la anterior: la red de la UT2 es donde la UT3 pone el cortafuegos, la UT5 recrea esa red desde código y la UT6 ejecuta ese código desde un pipeline. No conviene saltarse ninguna.
Qué hay en esta web
-
Los apuntes de las siete unidades. Cada una empieza con un par de párrafos sobre lo que se busca y sigue con las sesiones en orden: en cada una, la teoría que se explica ese día y, a continuación, su hoja de práctica. La práctica evaluable cierra la unidad con su rúbrica.
-
Las 43 sesiones del curso con fecha, unidad y lo que se hace en cada una. La vista de calendario muestra el detalle al pasar el ratón y lleva a la actividad con un clic. Incluye festivos y el periodo de formación en empresa.
-
Resultados de aprendizaje y criterios de evaluación con la unidad donde se trabaja cada uno, cómo se calcula la nota, las herramientas de la asignatura y la metodología de las sesiones.
-
Cómo queda el entorno que se construye durante el curso, requisitos de cada puesto, convenciones de nombres y direcciones, repositorios que hay que crear y qué hacer cuando algo se rompe.
-
Lo que se teclea una y otra vez: Proxmox, red y diagnóstico, OpenTofu, Ansible, escáneres de seguridad, Docker, certificados, Jenkins, Prometheus y Git.
-
Los términos de la asignatura en una o dos frases, con la unidad donde se explican a fondo. Para cuando un término suene pero no se sitúe.
-
Los apartados de cada unidad que van más allá de lo que se hace en clase y los enlaces para seguir por cuenta propia, ordenados por unidad.
-
Documentación oficial de cada herramienta, libros que merecen la pena, sitios donde practicar fuera del aula y los créditos de las imágenes.
-
Mantenimiento del sistema de contenedores
La asignatura hermana, que se cursa a la vez los martes y jueves. Sobre el laboratorio que se monta aquí, allí se vigila, se prueba, se actualiza, se copia y se retira el servicio.
Unidades
| UT | Título | Horas | Dónde | RA · CE |
|---|---|---|---|---|
| UT1 | Virtualización e hipervisores | 12 | Centro | RA1 a |
| UT2 | Nubes privadas virtuales (VPC) | 14 | Centro | RA1 b, c |
| UT3 | Seguridad por capas: DMZ externa, DMZ interna y zona interna | 12 | Centro | RA1 d |
| UT4 | Nube pública: consola, CLI y SDK | 12 | Empresa | RA2 a–e |
| UT5 | Infraestructura como código (OpenTofu + Ansible) | 18 | Centro | RA3 a–d |
| UT6 | Orquestador de integración continua (Jenkins) | 18 | Centro | RA4 a–h |
| UT7 | Monitorización: Prometheus + Grafana | 4 + 12 | Centro + Empresa | RA4 i, j, k |
| UT8 | Proyecto integrador y puesta en producción | 6 | Empresa | Todos |
Los exámenes de evaluación van después de la UT3 (primera evaluación, 11 de diciembre de 2026) y después de la UT7 (segunda evaluación, 24 de marzo de 2027, que entra UT5, UT6 y UT7), así que la teoría y los exámenes terminan antes de Pascua. Después de Pascua, las dos últimas sesiones (7 y 9 de abril) se dedican a un proyecto conjunto con el resto de asignaturas del curso, que se plantea aparte. El módulo son 120 h oficiales, 90 en el centro y 30 en la empresa; el calendario del curso 2026-27 deja 43 sesiones, o sea 86 h en el centro, porque la semana del 12 al 16 de abril ya no tiene clase. Las dos sesiones de examen y las dos de proyecto están dentro de esas 86 h.
Cómo usar estos apuntes
- Conviene leer la sesión antes de clase. Cada unidad está ordenada por sesiones, con la teoría de ese día seguida de su hoja de práctica. En clase la explicación es corta y el laboratorio largo; los apuntes cubren lo que no da tiempo a explicar.
- Los comandos están pensados para copiarlos en el laboratorio. Si algo no funciona igual en la versión instalada, el primer sitio donde mirar es la sección "Errores frecuentes" de la unidad.
- Las hojas de práctica numeradas (A1.1, A1.2...) se hacen en la sesión que se indica y no se entregan: su último apartado, «Para practicar», dice qué conviene apuntar, responder y guardar, y la práctica evaluable de la unidad parte muchas veces de ello. La práctica evaluable cierra la unidad y es lo que se entrega por Aules. Lo que va más allá de lo que se hace en clase está apartado en Para ampliar, para no cargar las unidades.
- Conviene documentar sobre la marcha: una captura con fecha, la salida de un comando, el fichero de configuración. Al final de la unidad eso es la práctica.
Antes de empezar
Se dan por sabidos el manejo de la terminal de Linux con soltura, qué es una dirección IP con su máscara y una puerta de enlace, y el uso de Docker al menos para levantar un contenedor y leer sus logs. Si algo de eso no está fresco, la página de laboratorio tiene un apartado de repaso con enlaces.
Todo el software es libre o tiene una versión gratuita suficiente: Proxmox VE, OPNsense, OpenTofu, Ansible, Jenkins, Gitea, Prometheus y Grafana. No hace falta pagar nada, y en la UT4, que es la única que toca nube de pago, la plataforma la pone la empresa.
Sobre estos apuntes
Este material lo ha escrito Víctor Sellés para la asignatura con el apoyo de Claude; la nota completa sobre cómo se ha elaborado está en la página del módulo. Los errores y los comandos que hayan dejado de funcionar se pueden comunicar en clase o abrir como issue en el repositorio. El texto se publica con licencia CC BY-SA 4.0; las imágenes de terceros llevan su atribución al pie. La versión publicada aparece en el pie de cada página.
Unidades
UT1 · Virtualización e hipervisores
Esta es la primera unidad del módulo y la que sostiene todas las demás. Todo lo que se despliega en el curso corre sobre máquinas virtuales: las redes, el cortafuegos y los proxies, el servicio en Docker y su monitorización, los pipelines de Jenkins. Y esas máquinas virtuales corren sobre un hipervisor, el software que reparte un equipo físico entre todas ellas, que hay que saber instalar, configurar y, sobre todo, entender. La unidad monta un Proxmox VE propio en cada puesto, construye una plantilla con cloud-init (el servicio que configura una VM en su primer arranque) de la que saldrán decenas de VM en las próximas semanas y mide qué aguanta y qué no aguanta el laboratorio. La unidad siguiente, la UT2, parte de ese mismo Proxmox: desde finales de octubre le añade redes definidas por software para construir una VPC, la red privada que ofrece cualquier nube pública.
Sesión 1 · Presentación e instalación del hipervisor
Todo el módulo necesita un laboratorio de muchas máquinas: un servidor web, otro de aplicación, una base de datos, la monitorización, varios routers, un cortafuegos y un servidor de integración continua. Comprar una máquina física para cada una es imposible en un aula, y además cada alumno necesita las suyas para poder romperlas sin afectar a nadie. La solución es la de cualquier empresa: un solo equipo que reparte su hardware entre muchas máquinas virtuales gracias a un hipervisor. Después de 20 minutos de presentación del módulo y su evaluación y del laboratorio, esta sesión monta ese hipervisor, y la teoría va en el orden en que se toman las decisiones: qué es virtualizar y en qué se diferencia de los contenedores que ya se conocen, qué tipos de hipervisor hay y por qué el curso usa Proxmox VE, y qué tiene que tener el equipo para instalarlo. Este último apartado no se explica en clase, pero la hoja manda leerlo antes de crear la VM exterior, porque su punto más delicado, la virtualización anidada, es el que más disgustos da. Al acabar, hay un Proxmox VE instalado dentro de una VM del portátil y su consola web abierta en el puerto 8006.
Qué es virtualizar y para qué sirve
El problema: un servidor por aplicación. Durante años, cada aplicación de una empresa tenía su propio servidor físico. Era la forma sencilla de aislarlas (si una se cuelga o se actualiza mal, las demás ni se enteran) y de dar a cada una el sistema operativo que pedía. El precio era una sala llena de máquinas casi siempre ociosas, cada una con su consumo eléctrico, su hueco en el armario y su garantía, y semanas de espera cada vez que hacía falta un servidor nuevo.
Qué es virtualizar. Virtualizar es ejecutar varios sistemas operativos independientes sobre un mismo hardware físico. Un software llamado hipervisor reparte la CPU, la memoria, el disco y la red entre las máquinas virtuales (VM) y las mantiene aisladas entre sí. Cada VM cree que tiene un ordenador para ella sola: una BIOS o UEFI, una o varias CPU (las vCPU, CPU virtuales que el hipervisor reparte entre los núcleos físicos), una controladora de disco, una tarjeta de red. Nada de eso existe físicamente; es el hipervisor el que lo fabrica y el que decide en cada instante qué VM usa el núcleo físico número 3 o quién escribe en el disco. Así se conserva el aislamiento de un servidor por aplicación sin pagar una máquina por cada una.
flowchart TB
    VM1["<b>VM 1</b><br><small>Debian · nginx<br>su propio kernel</small>"]:::pieza
    VM2["<b>VM 2</b><br><small>Windows · ERP<br>su propio kernel</small>"]:::pieza
    VM3["<b>VM 3</b><br><small>Debian · PostgreSQL<br>su propio kernel</small>"]:::pieza
    HV["<b>Hipervisor</b><br><small>reparte CPU, RAM, disco y red · mantiene las VM aisladas</small>"]:::act
    HW["<b>Hardware físico</b><br><small>32 núcleos · 256 GB de RAM · SSD · tarjeta de red</small>"]:::infra
    VM1 --> HV
    VM2 --> HV
    VM3 --> HV
    HV --> HW
    classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
    classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
    classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
    classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
    classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
    classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5px
Cada VM se cree sola en el ordenador. Lo que ve (BIOS, CPU, disco, tarjeta de red) lo fabrica el hipervisor.
De dónde sale. La idea es casi tan vieja como la informática comercial: a principios de los años setenta, IBM ya repartía sus grandes ordenadores entre muchos usuarios, cada uno con su propio sistema, porque una máquina así era demasiado cara para dedicarla a una sola tarea. En los PC llegó mucho más tarde. Los procesadores x86 no estaban pensados para ello, y las primeras soluciones, como VMware en 1999, tenían que reescribir sobre la marcha, por software, las instrucciones delicadas de cada VM. En 2005 y 2006 Intel y AMD añadieron a sus procesadores unas extensiones de virtualización (VT-x y AMD-V) que hacen ese trabajo en el propio hardware, y sobre ellas está construido el hipervisor que usa el curso.
Para qué se usa. Se virtualiza por cinco razones que aparecen en cualquier empresa, y las cinco salen en el curso:
- Consolidación. Un servidor actual tiene 32 o 64 núcleos y 256 GB de RAM, y ninguna aplicación normal los usa. Con virtualización, ese servidor aloja decenas de VM en lugar de una sola aplicación, y la factura de electricidad y de armario se divide entre todas. Es lo que hace el laboratorio: un solo Proxmox por puesto, con todas las máquinas del curso dentro.
- Aislamiento. Si una VM falla, se cuelga o se compromete, las demás siguen. El hipervisor es la frontera de seguridad.
- Snapshots y clonado. Se guarda el estado de una VM y se vuelve a él en segundos, y se sacan copias idénticas de una VM ya preparada. Antes de una actualización arriesgada, snapshot; si sale mal, se vuelve atrás y a otra cosa. En el laboratorio, el clonado se practica en la sesión 3, el 14 de octubre, y los snapshots en la 4, dos días después.
- Portabilidad. Una VM se mueve entre servidores sin reinstalar, incluso encendida (migración en vivo), así que el hardware se cambia sin que el servicio se entere. En el laboratorio no se monta, porque hacen falta varios servidores; está en Clúster y migración en vivo.
- Base de la nube. Toda nube pública es, por debajo, hipervisores gestionados a gran escala: una instancia actual de Amazon EC2 es una VM sobre Nitro, un hipervisor basado en KVM, y una de Azure corre sobre Hyper-V. Lanzar una instancia en la nube es hacer con una API lo mismo que aquí se hace con
qm create.
VM frente a contenedor
Por qué la comparación. El título del módulo habla de contenedores y Docker ya se conoce de antes, así que conviene aclarar desde el principio qué relación hay entre lo que se hace en esta unidad y los contenedores. Un contenedor no es una VM pequeña: es un proceso normal del host al que el kernel aísla con dos mecanismos propios, los namespaces, que deciden qué ve el proceso (sus propios procesos, su red, su sistema de ficheros), y los cgroups, que deciden cuánto puede gastar. No hay hardware fabricado ni un segundo sistema operativo: todos los contenedores de un host usan el mismo kernel.
flowchart TB
    subgraph CT["Contenedores"]
        direction TB
        CA1["<b>App</b>"]:::pieza --> CM["<b>Motor de contenedores</b>"]:::pieza
        CA2["<b>App</b>"]:::pieza --> CM
        CA3["<b>App</b>"]:::pieza --> CM
        CM --> CK["<b>Kernel del host</b><br><small>uno solo, compartido · aquí está la frontera</small>"]:::act
        CK --> CHW["<b>Hardware</b>"]:::infra
    end
    subgraph MV["Máquinas virtuales"]
        direction TB
        MA1["<b>App</b>"]:::pieza --> MS1["<b>SO invitado</b><br><small>kernel propio</small>"]:::pieza
        MA2["<b>App</b>"]:::pieza --> MS2["<b>SO invitado</b><br><small>kernel propio</small>"]:::pieza
        MS1 --> MH["<b>Hipervisor</b><br><small>aquí está la frontera</small>"]:::act
        MS2 --> MH
        MH --> MHW["<b>Hardware</b>"]:::infra
    end
    classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
    classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
    classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
    classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
    classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
    classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5px
La frontera de aislamiento está en sitios distintos: en la VM es el hipervisor; en el contenedor, el kernel que todos comparten.
En qué se diferencian. Casi todo sale de esa diferencia de partida, fabricar un ordenador entero o aislar un proceso:
| Máquina virtual | Contenedor | |
|---|---|---|
| Qué virtualiza | Hardware completo (CPU, disco, red) | Solo el espacio de usuario; comparte el kernel del host |
| Sistema operativo | Cada VM lleva el suyo, con su propio kernel | Usa el kernel del host |
| Arranque | Segundos a minutos | Milisegundos |
| Tamaño | GB | MB |
| Aislamiento | Fuerte (la CPU ejecuta la VM en un modo invitado que vigila el hipervisor) | Medio (namespaces y cgroups sobre un kernel compartido) |
| Caso típico | Servidores completos, distintos SO, seguridad, hipervisor anidado | Aplicaciones, microservicios, CI/CD |
Por qué el curso usa los dos. En este curso los contenedores se ejecutan dentro de máquinas virtuales: el hipervisor da la infraestructura y los contenedores dan la aplicación. Es exactamente lo que hace cualquier proveedor cloud con un clúster gestionado de Kubernetes, el orquestador de contenedores más extendido: los nodos que ejecutan los contenedores son VM. La razón está en la frontera de aislamiento. Un contenedor no puede ejecutar otro kernel ni otro sistema operativo, y un proceso que escape de un contenedor está en el kernel del host, al lado de todo lo demás que corre en él; un proceso que escape de una VM (cosa muchísimo más rara) está en el hipervisor. Esa diferencia es la razón de que los proveedores no mezclen contenedores de clientes distintos sobre el mismo kernel.
Tipos de hipervisor
Dos formas de colocar el hipervisor. Un hipervisor puede instalarse directamente sobre el hardware, haciendo él mismo de sistema operativo de la máquina (tipo 1, bare metal), o como un programa más dentro de un sistema operativo de escritorio (tipo 2, hosted). La diferencia está en quién manda sobre el hardware: en el tipo 1, el propio hipervisor; en el tipo 2, el sistema de escritorio, al que el hipervisor pide los recursos como cualquier otra aplicación.
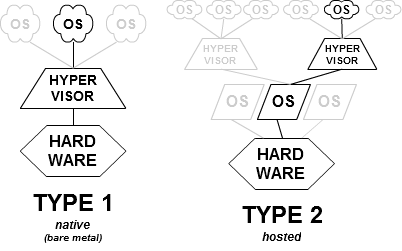
| Tipo 1 (bare metal) | Tipo 2 (hosted) | |
|---|---|---|
| Dónde se instala | Directamente sobre el hardware | Sobre un sistema operativo de escritorio |
| Rendimiento | Alto | Menor (hay un SO por medio) |
| Uso | Servidores, centros de datos, nube | Pruebas, desarrollo, laboratorio |
| Ejemplos | Proxmox VE (KVM), VMware ESXi, Microsoft Hyper-V, Xen | VirtualBox, VMware Workstation, Parallels |
En el laboratorio conviven los dos. El VirtualBox o el VMware Workstation del portátil es de tipo 2, y dentro de él va Proxmox VE, que es de tipo 1. No es lo normal en una empresa, pero permite que cada alumno tenga su hipervisor completo y lo pueda romper sin afectar a nadie. El precio es tener un hipervisor dentro de otro, la virtualización anidada, que tiene su punto en los requisitos hardware.
La trampa de la clasificación
KVM es un módulo del kernel de Linux, así que un Debian de escritorio con KVM y virt-manager (una aplicación gráfica para crear VM) es técnicamente de tipo 1: el kernel que gestiona las VM es el mismo que gestiona el hardware, aunque se use como si fuera de tipo 2. Lo que distingue de verdad a un hipervisor de producción no es la etiqueta sino que el sistema anfitrión esté dedicado y recortado a esa función, con una capa de gestión encima. Eso es Proxmox VE.
Por qué Proxmox VE. Proxmox VE lo publicó en 2008 una empresa austriaca como un Debian con todo lo necesario para virtualizar ya integrado: KVM, el hipervisor que lleva dentro el kernel de Linux, para las VM; LXC para contenedores de sistema, que se comportan como una máquina Linux completa pero comparten el kernel del host; y una consola web para manejarlo todo. Es libre (licencia AGPLv3) y es lo más parecido a una nube privada que se puede montar en un aula. Desde que Broadcom compró VMware y cambió su licenciamiento en 2024, es también lo que muchas pymes y centros educativos han adoptado en producción. Proxmox VE 8 está construido sobre Debian 12 (bookworm) y Proxmox VE 9 sobre Debian 13 (trixie); en el laboratorio del curso se instala la 9, pero todo lo que hay en estos apuntes vale para las dos salvo donde se indique.
Requisitos hardware
Material de consulta
Esto no se explica en clase: lo necesitas para la hoja de práctica de esta sesión.
Antes de instalar nada conviene saber qué tiene que tener el equipo y qué hay que activar en el hipervisor exterior. El punto de la virtualización anidada es el que más disgustos da: si se salta, Proxmox se instala igual, pero sus VM no arrancan con KVM, y nada avisa hasta que se crea la primera.
La CPU: las extensiones de virtualización. El hipervisor del curso, KVM, no imita la CPU: ejecuta el código de cada VM directamente en el procesador físico, y para eso necesita las extensiones de virtualización del procesador, Intel VT-x o AMD-V, que le añaden un modo de ejecución reservado a las VM. Sin ellas, KVM no funciona. En Linux se comprueba con grep -Ec '(vmx|svm)' /proc/cpuinfo, que tiene que dar más de 0 (vmx es la bandera de Intel y svm la de AMD); en Windows, en la pestaña Rendimiento del Administrador de tareas. Si no aparecen en un equipo moderno, casi siempre es que están desactivadas en la BIOS/UEFI.
Opcional: ceder un dispositivo físico. Otra extensión, VT-d en Intel y AMD-Vi en AMD (la IOMMU, la unidad que controla a qué memoria puede llegar cada dispositivo), permite dar a una VM una tarjeta gráfica o de red física entera (passthrough). En el curso no se usa.
Un hipervisor dentro de otro: la virtualización anidada. Las extensiones son del procesador físico, y por defecto un hipervisor no se las enseña a sus VM: les da una CPU virtual sin ellas. Para instalar Proxmox dentro de una VM, como en el laboratorio, el hipervisor exterior tiene que pasárselas, y cada uno lo activa a su manera:
- En un host Linux con KVM viene activada por defecto desde el kernel 4.20. Se comprueba con
cat /sys/module/kvm_intel/parameters/nested(okvm_amd), y si dijeraNse activa conoptions kvm-intel nested=1(okvm-amd) en/etc/modprobe.d/kvm.conf. Si el hipervisor exterior es otro Proxmox, la VM debe tener además el tipo de CPUhost. - En VirtualBox, «Enable Nested VT-x/AMD-V» en la pestaña de procesador, o
VBoxManage modifyvm pve --nested-hw-virt on. - En VMware Workstation, «Virtualize Intel VT-x/EPT or AMD-V/RVI» en la configuración del procesador.
- En Windows hay una trampa: con Hyper-V activo (o algo que lo usa por debajo, como WSL2 o la integridad de memoria de Windows 11), VirtualBox y VMware Workstation se ejecutan encima de él y no pueden ofrecer la anidada. Hay que desactivarlo.
Sin la anidada, el Proxmox de dentro se instala sin quejarse, pero al arrancar una VM dirá que KVM no está disponible. Lo único que le queda entonces es la emulación pura (TCG), en la que QEMU traduce cada instrucción por software, a una velocidad diez o veinte veces menor.
flowchart LR
    Q1{"<b>¿La CPU trae<br>VT-x o AMD-V?</b>"}:::dato
    B1["<b>Activarlo en<br>la BIOS o UEFI</b>"]:::act
    Q2{"<b>¿Proxmox irá dentro<br>de otra VM?</b>"}:::dato
    N["<b>Activar la anidación</b><br><small>en el hipervisor de fuera</small>"]:::act
    OK(["<b>KVM funcionará</b>"]):::ok
    TCG(["<b>Emulación pura TCG</b><br><small>10 o 20 veces más lento</small>"]):::riesgo
    Q1 -- No --> B1 --> Q1
    Q1 -- Sí --> Q2
    Q2 -- No --> OK
    Q2 -- Sí --> N
    N -- "se hace" --> OK
    N -- "se olvida" --> TCG
    classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
    classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
    classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
    classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
    classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
    classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5px
El camino que hay que recorrer antes de instalar. Saltarse el último paso es lo que más disgustos da.
Cómo se comprueba desde dentro. Ya instalado, la prueba de que la anidación funciona es que el procesador que ve el nodo tiene la bandera vmx o svm y que el módulo de KVM ha cargado. El fichero /sys/module/kvm_intel/parameters/nested (o kvm_amd) resume las dos cosas: solo existe si el módulo ha cargado, cosa que solo ocurre si el procesador trae la bandera, y su valor dice si ese KVM, a su vez, pasaría las extensiones a sus propias VM.
Memoria, disco y red.
- RAM: el hipervisor consume poco (un Proxmox recién instalado usa alrededor de 1 GB), pero cada VM necesita la suya: en el laboratorio, entre 512 MB y 3 GB según lo que corra, más unos 2 GB que se reservan para el propio Proxmox. La cuenta completa está en el presupuesto de memoria. Con ZFS hay que sumar lo que reserve la caché ARC (la caché de lectura de ZFS en RAM; el instalador de Proxmox la limita al 10 % de la RAM, con máximo de 16 GB, desde la 8.1).
- Almacenamiento: SSD. Proxmox usa por defecto LVM-thin (aprovisionamiento ligero: cada disco solo ocupa lo que se ha escrito en él). Un disco mecánico con cuatro VM haciendo E/S aleatoria a la vez es la experiencia más frustrante que puede dar un laboratorio.
- Red: una interfaz basta para empezar; dos permiten separar la gestión del tráfico de las VM, y tres o cuatro son lo normal en un servidor de producción (gestión, VM, almacenamiento y migraciones). En el laboratorio, la VM de Proxmox va en modo puente (bridged), para que el nodo y sus VM sean una máquina más de la red del aula. Eso obliga a que el hipervisor exterior deje pasar tramas con direcciones MAC que no son la de su VM, sino las de las VM de dentro: en VirtualBox, el adaptador puente necesita el modo promiscuo en «Permitir todo». Por la misma razón conviene que el puesto vaya por cable, porque un puente sobre Wi-Fi suele dar problemas con esas direcciones.
A1.1 Instalar Proxmox VE (sesión 1)
Objetivo Al terminar tienes un Proxmox VE 9 instalado dentro de una VM de tu portátil, entras en su consola web en el puerto 8006 y has comprobado desde dentro que su KVM tiene la CPU que necesita. Es el hipervisor sobre el que vas a construir todo el curso, y esa última comprobación es la que asegura que sus VM irán a la velocidad del procesador y no emuladas.
Antes de empezar
- VirtualBox o VMware Workstation instalado en tu equipo, con 16 GB de RAM y al menos 80 GB libres en un SSD.
- La ISO de Proxmox VE 9 (la última 9.x de la web de Proxmox, alrededor de 1,5 GB). Descárgala antes de clase si puedes: la red del aula se resiente cuando la bajan treinta personas a la vez.
- Lo explicado al principio de la sesión: qué es virtualizar, VM frente a contenedor y tipos de hipervisor. Los requisitos hardware no se explican en clase: lee ese apartado antes del paso 2, sobre todo el punto de la virtualización anidada.
Pasos
Vas a montar el laboratorio de fuera adentro, comprobando cada capa antes de poner la siguiente encima: primero tu equipo, después la VM exterior que alojará Proxmox, luego Proxmox dentro de ella con su consola web y, al final, desde dentro de Proxmox, la prueba de que la capa exterior le pasa la virtualización. Ese último paso es el que más importa: si la anidación falla, nada protesta hasta que arranca la primera VM, el 14 de octubre.
-
Comprueba que tu CPU puede virtualizar. Sin las extensiones VT-x o AMD-V activas en tu equipo no hay KVM en ningún nivel, así que es lo primero que se mira. Compruébalo como se indica en Requisitos hardware y, si están desactivadas, actívalas en la BIOS/UEFI antes de seguir: sin ellas no hay práctica.
Pista: en Windows lo dice la pestaña Rendimiento del Administrador de tareas («Virtualización: habilitado»). Mira también que no esté activo Hyper-V, que deja a VirtualBox y a VMware sin anidada.
-
Crea la VM exterior con la anidación activada. Es la máquina que va a alojar todo el laboratorio: tipo Linux Debian 64 bits, 4 vCPU, 12 GB de RAM, 60 GB de disco, red en modo puente (bridged) y virtualización anidada activada. La memoria es la que necesitan las VM de las próximas semanas (la cuenta está en el presupuesto de memoria); el modo puente pone a Proxmox, y después a sus VM, en la red del aula, que es desde donde vas a entrar en ellas; y la anidación es lo que dejará a Proxmox usar KVM.
Pista: la anidación es una opción del hipervisor exterior, distinta en cada uno, y en VirtualBox el adaptador puente necesita además el modo promiscuo; las dos están en Requisitos hardware. Si se olvidan, Proxmox se instala igual y el fallo no se ve hasta el paso 5.
-
Instala Proxmox VE. Hazlo desde la ISO, con el disco y el sistema de ficheros que propone el instalador (ext4 con LVM-thin). Anota el nombre de host, la IP de gestión y la puerta de enlace que le das: esa IP es la dirección del nodo durante todo el curso, la de su consola web y la de su SSH.
Pista: el instalador pide el nombre de host completo, con dominio:
pve.lab, por ejemplo. -
Entra en la consola web. Desde el navegador de tu portátil, en el puerto 8006, como
rooty con el realmLinux PAM, el de los usuarios del sistema, porque de momento el único que existe es su root. Llegar hasta aquí demuestra que el nodo es alcanzable desde tu puesto, que es desde donde vas a administrarlo.Pista: la consola va por HTTPS con un certificado autofirmado, así que el navegador avisa; al entrar, Proxmox avisa además de que no hay suscripción. Las dos cosas son normales en el laboratorio.
-
Comprueba desde dentro que KVM tiene su CPU. Desde la shell del nodo, comprueba cuántas CPU ve Proxmox y si su KVM ha podido cargar con las extensiones de virtualización, con el fichero
nestedque se explica al final de Requisitos hardware. Es la prueba de que la anidación del paso 2 funciona, y la medida que pide la práctica evaluable para la fila de la anidada.
Comprobación La consola web muestra el nodo con su CPU, su RAM y los almacenes local y local-lvm; nproc devuelve 4 y el fichero nested existe y devuelve Y (o 1). Si no existe, el módulo de KVM no ha cargado porque la VM exterior no le pasa las extensiones: revisa el paso 2 antes de la próxima clase. Es el error más habitual de la unidad y está descrito en Errores frecuentes.
Para practicar Responde en el documento de la unidad, junto a una captura del panel principal con la IP y el nombre de host: ¿qué tipo de hipervisor es Proxmox? ¿Y el que has usado para alojarlo? ¿Qué devuelve cat /sys/module/kvm_intel/parameters/nested (o kvm_amd) dentro de tu Proxmox, y qué significa?
Si te sobra tiempo Averigua con pveversion -v qué kernel y qué versión de QEMU lleva tu Proxmox, y compara su /etc/network/interfaces con el ejemplo del apartado de red: localiza el vmbr0 y la tarjeta física que tiene como puerto.
Sesión 2 · Configuración inicial de Proxmox
La sesión 1 dejó un Proxmox recién instalado, y recién instalado todavía no sirve para trabajar: sus repositorios apuntan a uno de pago, así que no se actualiza; solo tiene el usuario root; no se sabe dónde va a guardar los discos de las VM; y su única red es la del aula. Esta sesión lo deja listo para que nazcan las primeras VM. La teoría empieza por cómo está construido Proxmox, porque todo lo demás son piezas de esa arquitectura, y sigue con las cuatro que toca la hoja: de dónde se actualiza, dónde guarda los discos, cómo conecta las VM a la red y quién puede hacer qué. Al acabar, el Proxmox está actualizado, con un usuario administrador que no es root, un segundo bridge interno y las herramientas de medida instaladas.
Proxmox VE
Arquitectura
Una distribución, no un programa. Proxmox VE no es una aplicación más: es un Debian completo al que se le han añadido el hipervisor (KVM, con QEMU para los dispositivos de cada VM), las herramientas de contenedores de sistema LXC y una capa de gestión propia. Esa capa son unos servicios del sistema (pvedaemon, pveproxy, pvestatd...) que reciben las peticiones, comprueban quién las hace y las ejecutan, y se puede usar por tres puertas: la consola web del puerto 8006, una API REST (una interfaz por HTTP con la que un programa hace lo mismo que la web) y las órdenes de terminal del nodo.
flowchart TB
    USR["<b>Quien administra</b><br><small>consola web :8006 · API REST · qm, pct, pvesm…</small>"]:::act
    PVE["<b>Servicios de gestión (pve)</b><br><small>autentican, validan y ejecutan</small>"]:::pieza
    CFG["<b>/etc/pve</b><br><small>toda la configuración</small>"]:::dato
    KVM["<b>KVM / QEMU</b><br><small>máquinas virtuales</small>"]:::pieza
    LXC["<b>LXC</b><br><small>contenedores de sistema</small>"]:::pieza
    DEB["<b>Debian + kernel Linux</b>"]:::infra
    HW["<b>Hardware</b>"]:::infra
    USR --> PVE
    PVE --- CFG
    PVE --> KVM
    PVE --> LXC
    KVM --> DEB
    LXC --> DEB
    DEB --> HW
    classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
    classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
    classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
    classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
Da igual pulsar en la web, llamar a la API o escribir qm: las tres puertas acaban en los mismos servicios y en la misma configuración.
Dónde vive la configuración. Toda la configuración está en /etc/pve, que no es un directorio normal sino un sistema de ficheros propio de Proxmox, guardado en una base de datos y pensado para compartirse entre los nodos de un clúster; cómo lo hace está en Clúster y migración en vivo. Cada VM, por ejemplo, es un fichero de texto de pocas líneas, /etc/pve/qemu-server/<ID>.conf, que es lo que enseña qm config <ID>.
Por qué importan las órdenes. La web es la forma más cómoda de empezar, pero lo que se hace con clics no se puede repetir ni revisar. Cada clic tiene su orden equivalente, y son esas órdenes las que permiten automatizar. El curso lo hace más adelante, con ellas y con la API: en noviembre, unos scripts levantan de una vez un entorno entero (UT2, redes), y desde mediados de diciembre la infraestructura se declara en ficheros con OpenTofu (UT5, infraestructura como código).
Las de uso diario:
| Herramienta | Para qué | En el curso |
|---|---|---|
qm |
Máquinas virtuales: crear, arrancar, clonar, snapshots, migrar | Desde la A1.3, en casi todas las hojas |
pct |
Contenedores LXC | El contenedor ct01 de la A1.4 |
pvesm |
Almacenamiento: listar, añadir, ver ocupación | La revisión de almacenes de la A1.2 y las medidas de la A1.5 |
pveum |
Usuarios, grupos, roles y permisos | admin@pve en la A1.2 |
vzdump |
Copias de seguridad | La copia de web01 en la A1.4 |
pveam |
Descargar plantillas de contenedor | La plantilla de ct01 en la A1.4 |
pvecm |
Clúster: crear, añadir nodos, ver quórum | No se usa: el laboratorio tiene un solo nodo |
pveperf |
Medida rápida de CPU y disco del host | Las medidas de la A1.5 |
Puertos que conviene tener en la cabeza: 8006 (web y API), 22 (SSH) y 5900 a 5999 (consolas VNC). Los de la otra consola remota (SPICE), el clúster y las migraciones están también en Clúster y migración en vivo.
Repositorios y actualizaciones
El problema: un Proxmox recién instalado no se actualiza. Proxmox se actualiza con apt, como cualquier Debian, pero sus paquetes propios (el kernel, QEMU, LXC, la consola web) no salen de los repositorios de Debian sino de los de Proxmox. El que queda activado tras la instalación es pve-enterprise, reservado a quien paga una suscripción, y lo mismo pasa con el de Ceph, el almacenamiento distribuido que aparece más abajo. Sin una clave de suscripción, apt update falla con un error 401 (no autorizado) y el nodo se queda sin parches de seguridad.
Qué repositorios hay. Proxmox publica sus paquetes en tres: pve-enterprise, con los paquetes más probados, para quien tiene suscripción; pve-no-subscription, gratuito, que recibe los mismos paquetes antes y con menos pruebas, y que su propia documentación recomienda para pruebas y uso no productivo; y pvetest, para probar lo que todavía no ha salido. El laboratorio usa pve-no-subscription, que es lo que corresponde a un aula; una empresa con Proxmox en producción paga la suscripción, que además le da soporte. El aviso de «No valid subscription» que sale al entrar en la web es parte de la misma historia: avisa, pero no impide nada.
Dónde se cambian. En Proxmox VE 9 cada repositorio es un fichero .sources de /etc/apt/sources.list.d/, escrito en el formato de bloques de apt llamado deb822: pve-enterprise.sources y ceph.sources vienen de la instalación, y el de pve-no-subscription va en proxmox.sources. En la 8 eran líneas en ficheros .list. La web los gestiona en nodo > Updates > Repositories, que los añade, activa y desactiva sin editar nada a mano.
Por qué se reinicia si entra un kernel. Una actualización puede traer un kernel nuevo (un paquete proxmox-kernel-...). El nodo sigue funcionando con el antiguo hasta que se reinicia, y con él los módulos de KVM que usan las VM. Conviene reiniciar justo después de actualizar, con el nodo todavía vacío, y no en mitad de una sesión con VM encendidas.
Almacenamiento
El problema: dónde van los discos. Una VM necesita un disco, y las ISO de instalación, las plantillas y las copias de seguridad necesitan sitio. Proxmox no lo resuelve con carpetas fijas: lo organiza en almacenes (storages). Cada almacén tiene un tipo, que dice cómo y dónde guarda (como ficheros de un directorio, como volúmenes de un disco, en otro servidor por la red), y una lista de contenidos que admite (imágenes de disco, ISO, plantillas de contenedor, copias de seguridad, snippets). Si una orden intenta dejar algo en un almacén que no lo admite, falla, y es uno de los errores típicos de la primera semana.
Los dos de la instalación. La instalación por defecto crea dos, uno para ficheros y otro para discos:
local(tipo directorio, en/var/lib/vz): ISO, plantillas de contenedor y copias de seguridad, y también snippets (ficheros auxiliares, como los de cloud-init) si se le activa ese contenido. Si se le activa el de discos, puede alojar también discos de VM en formato qcow2 o raw, como ficheros en/var/lib/vz/images/<vmid>/.local-lvm(tipo LVM-thin, sobre el volumenpve/data): discos de VM y de contenedores. LVM es el gestor de volúmenes de Linux, que reparte un disco en volúmenes lógicos; thin quiere decir que esos volúmenes se crean con su tamaño nominal, pero solo toman espacio del conjunto común (el pool) a medida que se escribe en ellos. Admite snapshots.
La separación tiene sentido: una ISO o una copia son ficheros, y lo natural es guardarlas en un directorio; el disco de una VM rinde más como volumen de bloques, sin un sistema de ficheros del host por medio.
Otros almacenes. Según el caso, se añaden otros:
- ZFS (un sistema de ficheros que gestiona él mismo los discos): si hay discos de sobra. Snapshots instantáneos, compresión transparente (lz4), sumas de verificación de cada bloque, replicación integrada entre nodos (
pvesr) y RAID por software sin controladora. A cambio, RAM para la caché ARC y una cierta penalización de escritura por el copy-on-write: al modificar un bloque, ZFS escribe la versión nueva en otro sitio en lugar de sobrescribir la antigua. - NFS, SMB o iSCSI: almacenamiento compartido entre varios nodos, requisito para migrar en vivo sin copiar el disco y para la alta disponibilidad.
- Ceph: almacenamiento distribuido integrado en Proxmox; a partir de tres nodos.
- Proxmox Backup Server: destino de backups deduplicados.
Cómo se elige. Con lo que pesa cada opción; el laboratorio, con un solo disco, usa la primera columna:
| LVM-thin | ZFS | Directorio (ext4/xfs) | |
|---|---|---|---|
| Formato de disco de VM | raw (volumen de bloques) | raw (zvol) | qcow2 o raw (fichero) |
| Snapshots | Sí, de bloques, rápidos | Sí, instantáneos | Solo con qcow2 |
| Thin provisioning | Sí | Sí | Sí con qcow2 (crece bajo demanda) |
| Clones enlazados | Sí | Sí | Sí con qcow2 |
| Integridad de datos | La del disco | Checksums, autocorrección con redundancia | La del sistema de ficheros |
| Coste en RAM | Ninguno | ARC (GB) | Ninguno |
| Cuándo | Un solo disco, laboratorio, lo simple | Varios discos, datos que importan, replicación | Almacén compartido NFS, ISOs, backups |
raw y qcow2. Son los dos formatos de disco de VM. raw es una imagen byte a byte del disco, sin cabecera: lo más rápido, y lo que usan LVM y ZFS. qcow2 (QEMU Copy On Write, versión 2) es un formato de fichero con metadatos que permite crecer bajo demanda, snapshots internos, compresión y una imagen base de la que cuelgan otras (así se hacen los clones enlazados en un directorio). Con qcow2 se paga una capa de traducción entre la posición en el disco virtual y la posición en el fichero, y una fragmentación que se nota con el tiempo; en un directorio sobre SSD la diferencia con raw es de un 5 a un 10 % en E/S aleatoria, aceptable para laboratorio. Las imágenes cloud se distribuyen en qcow2 porque es lo compacto; al importarlas a LVM-thin, Proxmox las convierte a raw automáticamente.
El aviso: el thin provisioning. Prometer más disco del que hay merece un aviso serio. Un almacén de 200 GB puede tener asignados 10 discos de 50 GB (500 GB "prometidos") porque solo ocupan lo escrito. Mientras las VM estén medio vacías, perfecto. El día que dos de ellas se llenen a la vez y el pool llegue al 100 %, LVM-thin no puede atender las escrituras: las VM reciben errores de E/S, sus sistemas de ficheros pasan a solo lectura o se corrompen, y no se puede ni borrar un snapshot para hacer sitio porque borrar también necesita metadatos. En ZFS el comportamiento es similar cuando el pool se llena, agravado por el copy-on-write. Por eso se vigila con lvs, en sus columnas Data% (los datos) y Meta% (el espacio donde el pool apunta qué bloque es de qué volumen, que también puede llenarse), o con zpool list en ZFS.
flowchart LR
    subgraph POOL["Pool thin de 200 GB"]
        direction TB
        ESCRITO["<b>Escrito de verdad</b><br><small>120 GB</small>"]:::dato
        LIBRE["<b>Libre</b><br><small>80 GB</small>"]:::infra
    end
    subgraph PROM["Prometido a las VM: 500 GB"]
        direction TB
        D1["<b>10 discos de 50 GB</b><br><small>cada VM cree que los tiene enteros</small>"]:::pieza
    end
    RIESGO["<b>Si el pool llega al 100 %</b><br><small>errores de E/S, sistemas de ficheros en solo lectura,<br>y no se puede ni borrar un snapshot para hacer sitio</small>"]:::riesgo
    PROM -.-> POOL
    POOL --> RIESGO
    classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
    classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
    classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
    classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
    classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
    classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5px
Sobreasignar es normal y es la gracia del thin provisioning. Lo que no es opcional es vigilar Data% y activar el descarte.
Por qué un pool thin solo crece. Cuando dentro de una VM se borra un fichero, su sistema de ficheros marca esos bloques como libres, pero el pool no se entera: para él siguen escritos. El descarte (discard, o TRIM en los SSD) es el aviso con el que el invitado le dice al disco qué bloques ya no usa, y con él el pool los recupera. Hacen falta dos cosas: discard=on en el disco de la VM, para que el aviso llegue hasta el pool, y fstrim periódico dentro del invitado, que es quien lo envía (Debian ya lo trae como temporizador de systemd). Sin descarte, un pool thin solo crece.
# Ocupación real del pool thin y de cada disco
lvs pve/data
lvs -o lv_name,lv_size,data_percent pve
# Descarte desde el host, a través del agente QEMU
qm guest cmd 110 fstrim
Red
El problema: una tarjeta física para muchas VM. Cada VM necesita su tarjeta de red conectada a alguna red, pero el host tiene una sola tarjeta física y no se la puede dar entera a cada VM. Proxmox lo resuelve como se resolvería con máquinas físicas, con un switch: crea un bridge de Linux (vmbr0), que es un switch virtual dentro del kernel del host, y le conecta la tarjeta física como si fuera el cable que va al switch del aula.
Cómo se conectan las VM. Cada tarjeta virtual de una VM aparece en el host como una interfaz tap, que es su otro extremo (tap110i0 es la net0 de la VM 110), y Proxmox la conecta al bridge como un puerto más. Así las VM quedan en la misma red que el host, cada una con su propia MAC, y reciben IP del DHCP del aula como cualquier otra máquina. La IP del host tampoco va en la tarjeta física, sino en el bridge: una vez la tarjeta es un puerto del switch, solo hace de cable, y el host se conecta a su propio switch como uno más.
flowchart TB
    RED(("<b>Red del aula</b>")):::infra
    ENO["<b>eno1</b><br><small>tarjeta física</small>"]:::infra
    BR0["<b>vmbr0</b><br><small>bridge · switch virtual · 192.168.1.50/24</small>"]:::pieza
    T1["<b>tap110i0</b>"]:::pieza
    T2["<b>tap120i0</b>"]:::pieza
    V1["<b>VM 110</b><br><small>net0</small>"]:::act
    V2["<b>VM 120</b><br><small>net0</small>"]:::act
    BR1["<b>vmbr1</b><br><small>sin puerto físico · 10.10.10.1/24 · VLAN aware</small>"]:::pieza
    T3["<b>tap160i0</b>"]:::pieza
    V3["<b>VM 160</b><br><small>red interna</small>"]:::act
    RED --- ENO --- BR0
    BR0 --- T1 --- V1
    BR0 --- T2 --- V2
    BR1 --- T3 --- V3
    classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
    classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
    classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
    classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
    classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
    classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5px
Una interfaz tap por tarjeta virtual. vmbr1 no tiene puerto físico: lo que se conecta ahí no sale del host, que es justo lo que se busca para una red interna.
El fichero. La configuración está en /etc/network/interfaces y la aplica ifupdown2 sin reiniciar, con ifreload -a; la web hace eso mismo al pulsar «Apply Configuration». Así queda con los dos bridges del laboratorio:
auto lo
iface lo inet loopback

iface eno1 inet manual

auto vmbr0
iface vmbr0 inet static
    address 192.168.1.50/24
    gateway 192.168.1.1
    bridge-ports eno1
    bridge-stp off
    bridge-fd 0

auto vmbr1
iface vmbr1 inet static
    address 10.10.10.1/24
    bridge-ports none
    bridge-stp off
    bridge-fd 0
    bridge-vlan-aware yes
    bridge-vids 2-4094
En cada bridge, bridge-ports dice qué tarjeta física tiene enchufada (none, ninguna), y bridge-stp off y bridge-fd 0 desactivan el protocolo con el que los switches evitan los bucles (STP) y la espera que impone antes de dejar pasar tráfico por un puerto nuevo. Con un solo bridge no hay bucle posible, y así la tarjeta de una VM que arranca transmite desde el primer momento.
Para qué sirve vmbr1. Es un bridge sin tarjeta física: lo que se conecta a él solo llega a las otras VM del mismo bridge y al host, que tiene la 10.10.10.1, y no sale a la red del aula. Es el sitio de las redes de prueba del curso. Las dos últimas líneas del ejemplo, bridge-vlan-aware y bridge-vids, lo preparan para separar varias redes por etiquetas (VLAN), y no se ponen al crearlo. Se añaden en la sesión 5, el 21 de octubre, cuando se explican las VLAN.
Usuarios y permisos
Por qué no trabajar como root. Tras la instalación solo existe root@pam, el root de Linux del nodo. Su contraseña abre también el SSH y la consola del sistema, con él se puede hacer todo sin ningún límite y, si varias personas lo comparten, nadie sabe después quién hizo qué. La buena práctica es la de cualquier sistema: un usuario administrador con nombre propio para el trabajo diario, y root reservado para lo que solo root puede hacer (algunas operaciones del nodo y la consola del host).
De dónde salen los usuarios: el realm. Cada usuario pertenece a un realm, que dice dónde se comprueba su contraseña: pam son los usuarios Linux del host y pve son usuarios propios de Proxmox, guardados en /etc/pve/user.cfg, que no existen para el sistema operativo y no pueden entrar por SSH. También se pueden enganchar directorios externos: LDAP, Active Directory y OpenID Connect. Por eso, al entrar en la web, hay que elegir el realm del usuario.
Qué puede hacer cada uno. Un permiso son siempre tres cosas juntas: quién (un usuario o un grupo), qué puede hacer (un rol, que es un conjunto de privilegios: Administrator, PVEAdmin, PVEVMAdmin, PVEVMUser, PVEAuditor, PVEDatastoreUser...) y sobre qué parte del árbol de objetos (/, /vms/100, /storage/local, /nodes/pve1), con o sin propagación a los hijos.
Los tokens. Un token de API es una clave con la que un programa habla con Proxmox sin contraseña. Se crea sobre un usuario y hereda o recorta sus permisos, así que un programa nunca puede más que el usuario del que cuelga. En esta unidad no se crea ninguno: los necesitan los scripts y OpenTofu con los que el curso automatiza Proxmox a partir de noviembre.
flowchart LR
    U["<b>Usuario</b><br><small>admin@pve</small>"]:::act
    R["<b>Rol</b><br><small>Administrator · PVEVMAdmin<br>PVEAuditor · PVEDatastoreUser</small>"]:::dato
    P["<b>Ruta del árbol</b><br><small>/ · /vms/100 · /storage/local · /nodes/pve1</small>"]:::dato
    ACL(["<b>Permiso</b><br><small>usuario + rol + ruta, con o sin propagación</small>"]):::ok
    TK["<b>Token de API</b><br><small>cuelga del usuario y hereda o recorta sus permisos</small>"]:::pieza
    U --> ACL
    R --> ACL
    P --> ACL
    U --> TK
    ACL -.-> TK
    classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
    classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
    classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
    classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
    classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
    classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5px
Un permiso son siempre tres cosas: quién, qué puede hacer y sobre qué parte del árbol. El token hereda los del usuario o los recorta, nunca los amplía.
pveum user add admin@pve --password 'CambiaEsto' --comment "Administrador del laboratorio"
pveum acl modify / --users admin@pve --roles Administrator
pveum user list
pveum acl list
A1.2 Configuración inicial (sesión 2)
Objetivo Un Proxmox actualizado, con un usuario administrador que no es root, un segundo bridge interno y las herramientas de medida instaladas. Es lo que necesita el nodo antes de que empiecen a nacer VM: parches de seguridad, un usuario para el trabajo diario, una red interna para las pruebas y el material de la plantilla ya descargado.
Antes de empezar
- El Proxmox de A1.1 arrancado y accesible en el puerto 8006, con
nestedenY. - Lo explicado al principio de la sesión: arquitectura y herramientas, repositorios, almacenamiento, red y usuarios y permisos.
Pasos
Vas a dejar el nodo listo en el orden en que cada cosa hace falta. Primero los repositorios y la actualización, porque todo lo demás instala paquetes y un kernel nuevo obliga a reiniciar, mejor ahora que con VM encendidas. Después miras cómo guarda los discos, antes de crear el primero. Luego creas el usuario con el que trabajarás desde hoy y la red interna de las pruebas. Al final dejas en marcha lo que más tarda: las descargas.
-
Cambia a los repositorios sin suscripción. Activa
No-Subscriptiony desactiva los dosenterprise(pve-enterprisey el deceph) desde nodo > Updates > Repositories, y mira desde la shell cómo han quedado los ficheros. Sin este paso el nodo no se actualiza nunca, por lo que se explica en Repositorios y actualizaciones. -
Actualiza el nodo. Con los repositorios buenos, actualiza todo el sistema: es lo que deja al nodo con sus parches de seguridad al día antes de que nazca la primera VM. Si entra un kernel nuevo (un paquete
proxmox-kernel-...), reinicia antes de seguir, por lo que se explica al final de Repositorios y actualizaciones. -
Mira dónde guarda los discos. Anota qué contenido admite cada almacén,
localylocal-lvm, y el tamaño del pool thin con su ocupación de datos y de metadatos, con las órdenes de Almacenamiento. Lo primero te dice dónde puede ir cada cosa que crees a partir de ahora; lo segundo, con el nodo vacío, es la referencia con la que verás crecer el pool cuando lleguen la plantilla, los clones y los snapshots. -
Crea tu usuario de trabajo. Crea el usuario
adminen el realmpve, con el rolAdministratorsobre/, como en Usuarios y permisos, y desde ahora trabaja con él. Entrar con él en la web es la prueba de que el usuario y su permiso están bien; root queda para lo que solo puede hacer root, como la shell del nodo.Pista: al entrar en la web con
admin, el realm esProxmox VE authentication server, noLinux PAM. -
Crea la red interna. Crea en nodo > Network el segundo bridge,
vmbr1, con10.10.10.1/24y sin puerto físico. Es la red de Red que no sale del host, la que usan las pruebas del curso.Pista: en la web, el cambio no se aplica hasta pulsar Apply Configuration.
-
Deja preparado lo que más tarda. Instala en el host las herramientas de medida (
stress-ng,fio,iperf3ysysstat) y deja descargado el material de la plantilla: la imagen cloud de Debian 13 en/rooty el paquetelibguestfs-tools, que traevirt-customize. Son descargas largas que, con treinta puestos a la vez, saturan la red del aula; hechas hoy, la sesión 3, el 14 de octubre, empieza directamente por la plantilla.Pista: la imagen es
debian-13-genericcloud-amd64.qcow2, dehttps://cloud.debian.org/images/cloud/trixie/latest/. Si tu Proxmox es 8, la de bookworm (debian-12-genericcloud-amd64.qcow2).
Comprobación apt update termina sin errores 401; pveum user list muestra admin@pve; ip -br addr muestra vmbr0 con la IP del aula y vmbr1 con 10.10.10.1/24; fio --version responde; ls -lh /root/debian-13-genericcloud-amd64.qcow2 muestra la imagen entera y virt-customize --version contesta.
Para practicar Guarda en el documento de la unidad una captura de los repositorios, de /etc/network/interfaces y de pveum user list, y apunta allí el tamaño del pool thin y la salida de virt-customize --version. La práctica evaluable parte de esas tres capturas.
Si te sobra tiempo Crea un segundo usuario con rol PVEAuditor sobre /, entra con él y anota qué puede ver y qué no puede tocar.
Sesión 3 · Primera VM y plantilla
Con el Proxmox preparado, toca crear máquinas. Instalar cada una desde la ISO, como se hizo con el propio Proxmox, cuesta veinte minutos de preguntas del instalador, y el curso va a necesitar decenas de VM, empezando por las tres de hoy. La solución es la de cualquier nube: partir de una imagen con el sistema ya instalado, convertirla en plantilla y sacar de ella copias que se configuran solas en su primer arranque. La teoría sigue el orden en que se construye: qué se decide al crear una VM (sus parámetros y la CPU que ve), de dónde sale su disco (la imagen cloud y lo que se le añade antes de usarla), cómo se personaliza cada copia (cloud-init) y cómo se hacen las copias (plantillas y clones). La hoja construye la plantilla 9000 y saca de ella web01, app01 y mon01, las tres con IP y acceso SSH desde el nodo y desde el puesto del alumno. Las dos últimas llevan Docker porque Mantenimiento traslada a ellas al día siguiente, el 15 de octubre, el servicio del curso y su monitorización.
Máquinas virtuales en Proxmox
Crear una VM: los parámetros que importan
Qué se decide al crear una VM. Para Proxmox, una VM es una lista de piezas de hardware virtual escrita en su fichero de configuración. Casi todas tienen un valor por defecto razonable; estas son las que cambian algo, cada una con su porqué:
- ID y nombre. El ID es un número único en el clúster, de 100 en adelante, y es lo que usan todas las órdenes, que no aceptan nombres. Conviene reservar rangos: 9000 en adelante para plantillas es la costumbre, y el laboratorio reparte el resto por entorno y zona en sus convenciones.
- Origen del disco. Una ISO de instalación, o una imagen de disco ya instalada que se importa, que es lo que hace el curso con la plantilla.
- Disco. Bus
scsicon controladoraVirtIO SCSI single, formato raw sobrelocal-lvm,discard=onpara que el descarte llegue al pool thin yssd=1si el almacén es SSD, para que el invitado lo trate como tal. VirtIO son dispositivos pensados para máquinas virtuales, mucho más rápidos que imitar hardware real. Con thin, se puede ser generoso en tamaño, pero siendo consciente de lo que suma. - CPU. Número de núcleos (
cores), un solo socket y el tipo, que tiene apartado propio más abajo. - Memoria. Fija o con ballooning: un driver dentro del invitado que, cuando el host necesita memoria, la reserva dentro de la VM y se la devuelve al host, como un globo que se hincha. Con ballooning,
--memoryes el máximo y--balloonel mínimo hasta el que el host puede reclamar. En el curso las VM van con memoria fija. El ballooning se ensaya en la A1.5, el 21 de octubre, porque lo pide la práctica evaluable. - Red. Modelo virtio, el bridge al que se conecta y, si procede, la etiqueta VLAN y el cortafuegos de Proxmox.
- Firmware y máquina (el tipo de BIOS y de placa base que imita QEMU): SeaBIOS con i440fx por defecto; OVMF (UEFI) con q35 para passthrough de PCIe, Secure Boot o Windows 11 (que además exige un TPM virtual, un chip de seguridad emulado).
- Agente QEMU. Es un servicio dentro de la VM por el que Proxmox le pregunta su IP, la apaga limpiamente, congela su sistema de ficheros durante una copia y le manda ejecutar
fstrim. Hacen falta las dos mitades: el agente instalado dentro (en el curso va dentro de la imagen de la plantilla, como se explica más abajo) y activado en la VM (--agent enabled=1), que es lo que crea el canal por el que hablan.
qm create 190 --name prueba --memory 2048 --balloon 1024 --cores 2 --cpu x86-64-v2-AES \
  --scsihw virtio-scsi-single --scsi0 local-lvm:20,discard=on,ssd=1 \
  --net0 virtio,bridge=vmbr1 --ostype l26 --agent enabled=1
qm config 190
El ejemplo usa un ID del rango de pruebas (150 a 199) y vmbr1 sin etiqueta VLAN, donde el host tiene la 10.10.10.1; con esa misma VM se sigue en el diagrama de cloud-init de más abajo.
Tipos de CPU y su efecto en la migración
Qué CPU ve la VM. Un programa no sabe de antemano en qué procesador corre: se lo pregunta con la instrucción cpuid, que responde el modelo y una lista de banderas, una por cada capacidad del procesador (AVX para cálculo vectorial, AES-NI para cifrado por hardware, SSE4.2...). Dentro de una VM quien responde es KVM, y no con la CPU real, sino con lo que Proxmox le haya configurado. Esa respuesta decide qué instrucciones cree tener el invitado, y los compiladores y las bibliotecas eligen su forma de trabajar en función de ella.
Por qué no enseñar siempre la CPU real. Porque una VM puede cambiar de máquina. Si un programa ha visto una bandera y la usa, y la VM pasa a un servidor cuyo procesador no la tiene, el programa muere con «illegal instruction». El tipo de CPU es un compromiso entre rendimiento (enseñar todo lo que tiene el procesador) y portabilidad (enseñar solo lo que tienen todos los servidores por los que puede pasar la VM):
| Tipo | Qué expone | Ventaja | Inconveniente |
|---|---|---|---|
host |
Todas las banderas de la CPU física | Máximo rendimiento; necesario para virtualización anidada y para algunas cargas (AVX-512, compilación) | La VM solo puede migrar en vivo a un host con exactamente la misma CPU; si cambia de máquina, el invitado puede caer con "illegal instruction" |
x86-64-v2-AES |
Nivel de microarquitectura v2 (instrucciones SSE hasta SSE4.2) más AES-NI, el cifrado por hardware | Por defecto para VM nuevas desde Proxmox VE 8; funciona en cualquier CPU desde 2010 y migra entre hosts distintos | Sin AVX/AVX2: cargas numéricas o de cifrado moderno van más lentas |
x86-64-v3, x86-64-v4 |
v2 más AVX y AVX2 (v3); más AVX-512 (v4) | Buen compromiso en un clúster homogéneo moderno | Exige que todos los nodos tengan esas banderas |
kvm64 |
Un Pentium 4 con extensiones mínimas | Corre en cualquier sitio; era el valor por defecto hasta la 7 | Muy pobre: sin SSE4, sin AES-NI; muchas distribuciones actuales lo rechazan porque exigen x86-64-v2 |
Modelos con nombre (EPYC-Rome, Skylake-Server...) |
Las banderas de esa familia concreta | Reproducible y portable dentro de una gama | Hay que saber qué hardware hay debajo |
En el curso. En el laboratorio, anidado y con un solo nodo, host es lo razonable para el Proxmox interior cuando el hipervisor exterior es otro Proxmox (así puede virtualizar a su vez), y x86-64-v2-AES para las VM creadas dentro, que es lo que pone Proxmox cuando no se indica otra cosa. En una empresa con un clúster de nodos comprados en años distintos se elige el mínimo común denominador (a menudo v2 o v3) o se define un modelo de CPU propio en /etc/pve/virtual-guest/cpu-models.conf para toda la organización. Cambiar el tipo de CPU exige apagar y encender la VM, y un reinicio desde dentro no basta: la CPU queda fijada cuando arranca el proceso que ejecuta la VM en el host, y reiniciar el invitado no relanza ese proceso.
Imágenes cloud y cómo se preparan
Por qué no se instala desde la ISO. Instalar desde la ISO, como se hizo con el propio Proxmox, cuesta veinte minutos de preguntas y deja una máquina con decisiones tomadas a mano: su nombre, su usuario, su contraseña. Para una plantilla se quiere justo lo contrario, un sistema ya instalado pero sin nada propio, que cada copia complete en su primer arranque.
Qué es una imagen cloud. Es un disco con el sistema operativo ya instalado, genérico (sin usuarios, sin claves, sin nombre de máquina), pequeño (unos pocos GB, que crecen hasta el tamaño del disco que se le dé) y con cloud-init dentro, esperando su configuración. Las distribuciones las publican para las nubes públicas, y sirven igual para Proxmox. Debian publica varias variantes: generic, que funciona en cualquier entorno con cloud-init, incluso en hardware físico; genericcloud, igual pero con menos drivers de hardware en el kernel y más pequeña, que es la que usa el curso; y nocloud, sin cloud-init, que arranca directamente con root y solo sirve para pruebas. Vienen en qcow2, y al importarlas a local-lvm Proxmox las convierte a raw.
Lo que le falta y cómo se añade. La imagen de Debian no trae dos cosas que el curso quiere en todas las VM. Una es el agente QEMU, sin el que Proxmox no ve la IP de la VM. La otra es node_exporter (paquete prometheus-node-exporter), un pequeño servicio que publica por HTTP las métricas de la máquina (CPU, memoria, disco, red) para que las recoja Prometheus, el sistema de monitorización del curso. De fábrica escucha en el puerto 9100, y el curso lo pone en el 29100, el de su franja de puertos (todos los servicios del curso usan el de fábrica más 20000; el porqué, en Puertos). Eso también se deja escrito en la propia imagen, para que toda VM salga ya así. Los dos agentes se podrían instalar en el primer arranque con cloud-init, pero solo en una VM con salida a Internet, y en el curso muchas VM nacen sin ella, en redes internas que no salen del host. Por eso se meten dentro de la imagen antes de importarla, con virt-customize, del paquete libguestfs-tools. Esta herramienta modifica una imagen de disco sin arrancarla: la abre con una pequeña máquina auxiliar propia y ejecuta dentro el gestor de paquetes de la imagen, como si se instalara en el sistema ya en marcha.
virt-customize -a debian-13-genericcloud-amd64.qcow2 --install qemu-guest-agent,prometheus-node-exporter \
  --write '/etc/default/prometheus-node-exporter:ARGS="--web.listen-address=:29100"'
La segunda línea es la del puerto: --write escribe ese fichero dentro de la imagen; es el que lee el servicio de node_exporter al arrancar, y --web.listen-address le dice dónde escuchar (:29100, en todas las direcciones de la máquina). Lo que se instala y se escribe así queda en la imagen y, por tanto, en la plantilla y en cada VM que salga de ella, con sus servicios en marcha desde el primer arranque.
cloud-init
El problema: copias idénticas. Un clon es una copia exacta del disco de la plantilla. Si nadie hace nada, todas las copias arrancan con el mismo nombre de máquina, sin un usuario con el que entrar y sin su propia configuración de red. Hay que dar a cada una su identidad (nombre, usuario, claves SSH, IP) y ampliar su disco, y nadie quiere entrar por consola en cada VM para hacerlo.
Qué es y de dónde sale. cloud-init es el estándar para configurar una VM en su primer arranque: usuario, contraseña o clave SSH, nombre de host, red, paquetes, comandos. Nació en Canonical, la empresa de Ubuntu, para configurar las imágenes de Ubuntu en la nube de Amazon, y se generalizó después: hoy lo usan todas las nubes (AWS, Azure, GCP, OpenStack) y lo llevan instalado y activado todas las imágenes cloud de Debian, Ubuntu, Rocky o Fedora.
Cómo funciona. Es un servicio que arranca muy pronto, antes que la red. Busca una fuente de datos (datasource), el sitio donde la nube le deja la configuración de esa máquina concreta, y lee de ella tres ficheros: user-data, con lo que hay que hacer (usuarios, claves, paquetes, comandos); meta-data, con la identidad de la instancia, sobre todo su instance-id; y network-config, con la red. Después lo aplica en cuatro etapas: init-local (configura la red a partir de network-config), init (ya con red: usuarios, claves SSH, redimensionado del disco), modules:config y modules:final (paquetes, runcmd, mensaje de fin). Todo queda registrado en /var/log/cloud-init.log (detallado) y /var/log/cloud-init-output.log (salida de los comandos). Al terminar, cloud-init apunta en el disco el instance-id que ha configurado, y en los arranques siguientes no repite lo que se hace una vez por instancia, salvo que el instance-id cambie.
Cómo se lo da Proxmox. Proxmox usa el datasource NoCloud, el pensado para cuando no hay una nube detrás: genera al vuelo una imagen ISO de unos 4 MB con etiqueta cidata que contiene los tres ficheros, la conecta a la VM como un CD-ROM (ide2: local-lvm:vm-110-cloudinit) y cloud-init la encuentra al arrancar buscando un volumen con esa etiqueta. Los datos salen de los parámetros cloud-init de la VM (--ciuser, --sshkeys, --ipconfig0, --nameserver...), y cada vez que se cambia uno, Proxmox regenera la ISO en el siguiente arranque. Se puede ver exactamente lo que va a recibir la VM sin arrancarla:
Tres detalles de lo que genera Proxmox explican cosas que se ven en las hojas:
- El
user-dataes deliberadamente corto: nombre de host (el nombre de la VM), usuario, contraseña cifrada, claves SSH ypackage_upgrade: true, que actualiza todos los paquetes en el primer arranque. Esto último va activado salvo que se desactive con--ciupgrade 0. Necesita salida a Internet y alarga unos minutos el primer arranque; en una VM sin Internet ese paso falla, aunque el usuario, las claves y la red ya estén aplicados. - El
instance-idlo calcula Proxmox a partir del contenido deluser-datay delnetwork-config, así que cada clon, que tiene otro nombre, es para cloud-init una instancia nueva. - La red de cada tarjeta solo se configura si tiene su
--ipconfigN: para una tarjeta sin él, Proxmox no le pasa a cloud-init ninguna configuración.
Más de lo que da Proxmox: los snippets. Si hace falta más (instalar paquetes, crear varios usuarios, ejecutar comandos), se escribe un fichero YAML propio en el almacén local como snippet (un fichero auxiliar que Proxmox guarda junto a las ISO) y se referencia con --cicustom "user=local:snippets/web.yaml". Proxmox deja entonces de generar el user-data y usa ese tal cual, pero sigue generando la red. La primera línea, #cloud-config, no es un comentario cualquiera: es la que le dice a cloud-init que el fichero es configuración y no un script. En el curso no hace falta para nada obligatorio: se practica en «Si te sobra tiempo» de la A1.3.
#cloud-config
hostname: web01
users:
  - name: ops
    groups: [sudo]
    shell: /bin/bash
    sudo: ALL=(ALL) NOPASSWD:ALL
    ssh_authorized_keys:
      - ssh-ed25519 AAAAC3NzaC1lZDI1NTE5AAAA... ops@portatil
package_update: true
packages:
  - qemu-guest-agent
runcmd:
  - systemctl enable --now qemu-guest-agent
sequenceDiagram
    participant A as Administrador
    participant P as Proxmox (qm)
    participant Q as QEMU
    participant C as cloud-init (VM)
    A->>P: qm set 190 --ciuser ops --ipconfig0 ip=10.10.10.11/24,gw=10.10.10.1
    A->>P: qm start 190
    P->>P: genera ISO NoCloud (user-data, meta-data, network-config)
    P->>Q: arranca la VM con la ISO en ide2
    Q->>C: arranque del kernel invitado
    C->>C: busca datasource, encuentra volumen cidata
    C->>C: init-local: aplica network-config (IP estática)
    C->>C: init: crea usuario, instala clave SSH, amplía el disco
    C->>C: config y final: paquetes, runcmd
    C-->>A: la VM responde por SSH con la clave
Todo el trabajo lo hace la VM en su primer arranque; Proxmox solo le engancha el volumen cidata y la enciende. Por eso cuando falla se depura dentro de la VM, no en el host.
Cuando falla. Que no funcione a la primera es frecuente, y se depura dentro de la VM:
# Dentro de la VM (por la consola noVNC de Proxmox si no hay SSH)
cloud-init status --long        # done / running / error, y con --long el detalle
cloud-init query -a | head -50  # qué datasource encontró y qué metadatos leyó
grep -iE "warn|error|traceback" /var/log/cloud-init.log
cat /var/log/cloud-init-output.log
# Forzar que se vuelva a ejecutar como si fuera el primer arranque
cloud-init clean --logs && reboot
Dos detalles que ahorran horas.
- La plantilla no se arranca nunca. El primer arranque genera cosas que deberían ser únicas de cada máquina, como su identificador (
/etc/machine-id), y las deja grabadas en el disco que van a copiar todos los clones. cloud-init sí se repite en cada clon, porque suinstance-ides otro, pero el identificador de máquina no lo regenera nadie: los clones nacerían con el mismo y, como el cliente DHCP de las imágenes de Debian se identifica con él, podrían recibir todos la misma IP. - El tamaño del disco se da en la plantilla. El disco de la imagen cloud es pequeño, y cloud-init amplía la partición y el sistema de ficheros hasta el tamaño del disco en cada arranque (
growpartyresizefs). Si el disco se amplía en la plantilla antes de convertirla (qm disk resize 9000 scsi0 20G, oqm resizeen versiones anteriores), todos los clones nacen con ese tamaño; si no, habría que ampliar cada clon y reiniciarlo.
Plantillas y clonado
Qué es una plantilla. Una VM convertida con qm template deja de poder arrancarse: solo se puede clonar. Internamente, Proxmox marca su disco como base de solo lectura (en LVM-thin pasa a llamarse base-9000-disk-0), y eso es lo que permite que los clones cuelguen de él sin miedo a que cambie.
El flujo completo. Es el mismo en el aula y en producción, y es el orden de la A1.3:
- Descargar una imagen cloud de Debian o Ubuntu (formato qcow2) y meterle lo que le falte con
virt-customize. - Crear una VM con esa imagen como disco y añadirle el disco cloud-init.
- Darle la configuración cloud-init común a todas las copias y ampliar su disco.
- Convertirla en plantilla (
qm template), sin haberla arrancado nunca. - Clonar: linked clone (rápido, comparte el disco base con la plantilla y solo escribe las diferencias en un volumen propio; para pruebas y aulas) o full clone (independiente, copia completa del disco; para producción y para poder borrar la plantilla o mover el clon a otro almacén).
- Ajustar en cada clon lo que cambie (memoria, red, IP) y arrancarlo: cloud-init hace el resto.
Qué hereda un clon. El clon copia la configuración entera de la VM, parámetros de cloud-init incluidos, así que nace con el usuario, las claves y la red de la plantilla, y con su propio nombre. Solo hay que cambiar lo que sea distinto. Lo que más se cambia es la memoria, y qm clone no la admite: por eso cada clonado del curso va seguido de un qm set <ID> --memory.
Enlazado o completo. Con una plantilla, crear una VM nueva pasa de 20 minutos de instalación a 20 segundos. Un linked clone sobre LVM-thin tarda menos de un segundo porque no copia nada; un full clone de 20 GB tarda lo que tarde el disco en copiar lo que hay escrito (unos segundos en SSD para unos pocos GB reales). El precio del linked clone es la dependencia: no se puede borrar la plantilla mientras exista un clon, y todos los clones leen de los mismos bloques base, lo que en disco mecánico se nota. En el curso, las VM que viven todo el año (web01, app01, mon01) son completas, para que no dependan de la plantilla aunque haya que rehacerla; las de prueba, que duran una sesión, son enlazadas.
flowchart TB
    IMG["<b>Imagen cloud</b><br><small>qcow2 de Debian</small>"]:::dato
    VM["<b>VM</b><br><small>con el disco y el disco cloud-init</small>"]:::pieza
    TPL["<b>Plantilla</b><br><small>disco base en solo lectura</small>"]:::dato
    LC["<b>Clon enlazado</b><br><small>solo guarda las diferencias</small>"]:::pieza
    FC["<b>Clon completo</b><br><small>independiente</small>"]:::pieza
    CI(["<b>cloud-init</b><br><small>da a cada clon su IP, su usuario y su clave</small>"]):::ok
    IMG --> VM
    VM -- "qm template" --> TPL
    TPL -- "linked · menos de 1 s" --> LC
    TPL -- "full · copia lo escrito" --> FC
    LC -. "mientras exista,<br>la plantilla no se borra" .-> TPL
    LC --> CI
    FC --> CI
    classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
    classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
    classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
    classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
    classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
    classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5px
De 20 minutos de instalación a 20 segundos. El clon enlazado es más rápido pero queda atado a la plantilla.
A1.3 Plantilla cloud-init y clonado (sesión 3)
Objetivo Una plantilla cloud-init (VM 9000) con el agente QEMU y el de métricas ya dentro, de la que salen web01, app01 y mon01, las tres con IP y acceso SSH desde el nodo y desde tu puesto, y app01 y mon01 con Docker instalado, listas para Mantenimiento mañana. Desde hoy, crear una VM del laboratorio es clonar y ajustar, y las dos asignaturas trabajan sobre las mismas máquinas.
Antes de empezar
- Proxmox actualizado,
vmbr1creado y usuarioadmin(A1.2). - La imagen cloud de Debian 13 en
/rootylibguestfs-toolsinstalado, del paso 6 de la A1.2. Si no lo dejaste hecho, hazlo ahora: el resto de la hoja depende de eso. - Un terminal en tu puesto con
sshyscp(en Windows, PowerShell ya los trae): a las VM se entra desde el nodo Proxmox y desde tu puesto. - Lo explicado al principio de la sesión: imágenes cloud, cloud-init y plantillas y clonado. Para los parámetros del
qm create, crear una VM y tipos de CPU.
Pasos
Vas a construir la plantilla en el orden en que se usa cada pieza: primero preparas lo que llevará dentro (los paquetes de la imagen y las claves de acceso), después creas la VM 9000 con esa imagen como disco, le das la configuración de cloud-init y la congelas como plantilla. Solo entonces clonas, y no las tres de golpe: primero web01, para probar la plantilla, y después app01 y mon01. Un fallo de la plantilla se arregla una vez; si lo descubres con tres clones hechos, te toca arreglarlo cuatro veces.
-
Prepara la imagen con los dos agentes. Mete dentro de la imagen, antes de importarla, el agente QEMU (
qemu-guest-agent) y el de métricas (prometheus-node-exporter), como se explica en Imágenes cloud y cómo se preparan. Así los traerá en marcha toda VM que salga de la plantilla, aunque nazca sin Internet. El de métricas tiene que quedar ya en el puerto del curso, el 29100, y no en su 9100 de fábrica: es donde lo busca Mantenimiento, y lo que no se deja escrito en la imagen habría que corregirlo después en cada VM.Pista: exporta antes
LIBGUESTFS_BACKEND=direct. El puerto va en la misma orden, con el--writede la teoría. Tarda unos minutos: mientras, haz el paso 2. -
Reúne las claves que abrirán las VM. Junta en un fichero del nodo las dos claves públicas que van a entrar en las VM, la de tu puesto y la del propio nodo, una por línea. Las VM no tendrán contraseña, así que solo entrará quien tenga una de esas claves: la del nodo te sirve para administrarlas desde Proxmox, y la de tu puesto es la que usará Mantenimiento desde mañana.
Pista: si alguna no existe, créala con
ssh-keygen -t ed25519, sin contraseña. La del puesto se copia al nodo, por ejemplo como/root/puesto.pub. -
Crea la VM 9000 con la imagen como disco. Crea la VM 9000,
debian-tpl, con los parámetros de Crear una VM salvo tres: 2 GB sin ballooning, la red envmbr0, que es la que heredan los clones y la que les da IP del aula, y la imagen importada como disco. Añádele el disco cloud-init, por donde le llegará la configuración, y la consola serie, que es la que usan las imágenes cloud y la que te dejará ver arrancar a los clones aunque falle su red.Pista: créala sin disco e impórtalo después; lo demás, con el arranque desde ese disco, va en la segunda orden:
-
Dale la configuración común y congélala. Configura cloud-init en la 9000 con lo que tendrán todas las VM: el usuario
ops, las claves del paso 2 e IP por DHCP. Amplía su disco a 20 GB y conviértela en plantilla sin haberla arrancado nunca; el porqué de las dos cosas está en los dos detalles del final de cloud-init. Antes de convertirla, comprueba conqm cloudinit dumpque eluser-datalleva las dos claves, cada una en una sola línea: una clave mal pegada deja fuera de todos los clones a quien la usa. -
Prueba la plantilla con
web01. Clonaweb01(ID 110, clon completo, 1 GB), saca su IP con el agente QEMU y entra por SSH comoopsdesde el nodo. Antes de clonar nada más, comprueba que la plantilla ha hecho su trabajo: cloud-init ha terminado y los dos agentes están activos, el de métricas en el 29100. Ten paciencia con el primer arranque: cloud-init actualiza los paquetes y tarda unos minutos en terminar.Pista: si el agente aún no responde, la IP sale en la consola de la VM (
qm terminal 110, de la que se sale con Ctrl+O). -
Clona las dos VM de Mantenimiento. Clona
app01(ID 120, 2 GB) ymon01(ID 103, 3 GB), completas y con la red de la plantilla (el porqué de cada ID y cada RAM, en las convenciones del laboratorio), e instala en las dos Docker Engine con el plugin compose, usable poropssinsudo, porque Mantenimiento despliega allí sus pilas con Docker Compose. Entra en las dos desde tu puesto, que es como entra Mantenimiento mañana: si la clave del puesto no ha llegado a las VM, es hoy cuando tienes que saberlo. No levantes ningún servicio: los compose son de Mantenimiento.Pista: espera a que cloud-init termine (
cloud-init status --wait), que mientras actualiza tiene ocupado apt; después, el script oficial dehttps://get.docker.cominstala Docker y compose en Debian 13. El grupodockerno se aplica hasta que sales y vuelves a entrar por SSH.
Comprobación qm list muestra 9000 como plantilla y las VM 110, 120 y 103 con 1024, 2048 y 3072 MB; entras por SSH como ops sin contraseña en web01 desde el host y en app01 y mon01 desde tu puesto; qm guest cmd 110 network-get-interfaces responde sin haber instalado nada dentro; cloud-init status --long dice done y los dos agentes están active; desde el nodo, curl -s http://<IP de web01>:29100/metrics devuelve las métricas de web01; en app01 y en mon01, docker --version y docker compose version responden con el usuario ops y sin sudo.
Para practicar Guarda en el documento de la unidad la salida de qm list, de cloud-init status --long dentro de web01 y de docker compose version en app01 y en mon01. Responde allí, en dos o tres líneas y a partir de Plantillas y clonado: ¿en qué se diferencian un clon completo y uno enlazado, y cuánto ocupa cada uno? Anota las IP de app01 y mon01: las necesitas mañana en Mantenimiento.
Si te sobra tiempo Comprueba con números esa diferencia: mira lvs pve, saca de la plantilla un clon enlazado, web02 (ID 150, 1 GB), y vuelve a mirarlo. Compara de qué depende el volumen de web02 y de qué el de web01, y lo que ocupa cada uno. Practica también con los snippets de cloud-init, que es como se personaliza una VM cuando no se puede tocar la imagen: activa el contenido snippets en local (Datacenter > Storage > local > Edit), guarda el YAML del apartado de cloud-init en /var/lib/vz/snippets/web.yaml, clona una VM con --cicustom "user=local:snippets/web.yaml" y comprueba qué ha hecho el fichero en el primer arranque. Ten en cuenta que el packages: de ese YAML solo funciona si la VM tiene salida a Internet; por eso el agente de esta plantilla va dentro de la imagen y no aquí. Rompe algo a propósito: clona una VM, quítale la red que hereda de la plantilla (qm set <ID> --delete ipconfig0) y depúrala con cloud-init status --long y /var/log/cloud-init.log.
Sesión 4 · VM vs LXC, snapshots y límites
Desde la sesión 3 hay VM funcionando, y con ellas aparecen dos preguntas que no se pueden contestar sin saber qué hay debajo. La primera es de coste: por qué una VM tarda quince segundos en arrancar y se queda con cientos de megas del host, y cuándo bastaría con algo más ligero. La segunda es de seguridad: qué hacer cuando un cambio sale mal, o cuando se pierde el disco. La teoría responde en ese orden: qué son KVM y QEMU y por qué virtio es más rápido que el hardware imitado, que explica lo que cuesta una VM; qué es un contenedor LXC y cuánto se ahorra con él, con números; y qué es un snapshot y por qué no es una copia de seguridad. Las copias con vzdump no se explican en clase, pero el último paso de la hoja las usa. Al acabar, hay una tabla con medidas propias de VM frente a LXC, un snapshot de web01 al que se ha vuelto y un backup restaurado como VM 151.
Cómo funciona KVM/QEMU por debajo
Lo que hay debajo de una VM. Saber qué ocurre por debajo de un «Start» permite interpretar un problema de rendimiento en lugar de ir probando opciones. Una VM en marcha son tres piezas que trabajan juntas: KVM, en el kernel, que ejecuta su código; QEMU, un proceso del host, que le fabrica los dispositivos; y la capa de gestión de Proxmox, que pone de acuerdo a las dos.
KVM: la CPU. Durante años, virtualizar un PC fue difícil porque el procesador x86 no avisaba de todo lo que un sistema invitado intentaba hacer con el hardware, y el hipervisor tenía que vigilarlo por software. Las extensiones VT-x y AMD-V de los requisitos hardware lo resolvieron en el propio procesador, con un modo de ejecución reservado a las VM, y KVM (Kernel-based Virtual Machine) es la forma en que Linux las aprovecha. Entró en el kernel en 2007 y son dos módulos: kvm.ko, genérico, y kvm_intel.ko o kvm_amd.ko, de cada fabricante. KVM no emula nada: ejecuta el código del sistema operativo invitado directamente en el procesador físico, a velocidad nativa. Mientras el invitado ejecuta código corriente no hay nadie por medio, y esa es la razón de que una VM rinda casi como la máquina física. La CPU solo abandona el modo invitado cuando ocurre algo que el hipervisor tiene que atender, casi siempre un acceso a un dispositivo o una interrupción: a esa salida se la llama VM exit, KVM resuelve lo que haya que resolver y devuelve el control a la VM (VM entry). Cada VM exit cuesta del orden de un microsegundo, así que el rendimiento de una VM se juega en cuántos se producen. El modo que la CPU reserva al hipervisor y la traducción de memoria del invitado por hardware están en Dentro de KVM y QEMU.
QEMU: los dispositivos. KVM solo se ocupa de la CPU y la memoria; el resto del ordenador lo pone QEMU, un emulador libre que existía desde 2003 y que sabía imitar un PC entero por software (es la emulación pura, TCG, de los requisitos hardware). Con KVM debajo, QEMU deja la CPU en manos del hardware y se queda con los dispositivos. Es un proceso de usuario ordinario, uno por VM: en el host se ve con ps aux | grep kvm como /usr/bin/kvm -id 110 -name web01 ..., y eso es lo que mira el «Si te sobra tiempo» de la A1.4. QEMU pide a KVM que cree la VM, lanza un hilo por cada vCPU y se queda esperando: mientras la VM ejecuta código corriente, el proceso no hace nada. Cuando llega un VM exit que KVM no puede resolver solo (casi siempre una entrada o salida), el control sube hasta QEMU, que es quien emula los dispositivos: la placa base (i440fx o q35), la controladora SATA, la tarjeta de red, la tarjeta gráfica, el reloj y el firmware (SeaBIOS u OVMF para UEFI). Ahí está el coste que hay que retener: cada acceso del invitado a un dispositivo emulado obliga a salir de la VM y a subir hasta un proceso de usuario. Es justo eso lo que elimina virtio, el apartado que viene a continuación, y lo que en un Proxmox anidado se paga dos veces, porque cada salida atraviesa dos hipervisores.
flowchart LR
subgraph HW["Hardware · CPU con VT-x/AMD-V"]
CPU["<b>Núcleos físicos</b>"]:::infra
end
subgraph KERNEL["Kernel Linux del host"]
KVM["<b>kvm.ko + kvm_intel.ko</b><br><small>/dev/kvm</small>"]:::act
end
subgraph QEMU["Proceso QEMU · espacio de usuario"]
VCPU["<b>Hilo vCPU 0</b>"]:::pieza
VCPU1["<b>Hilo vCPU 1</b>"]:::pieza
DEV["<b>Emulación de dispositivos</b><br><small>virtio, e1000, SATA, gráfica</small>"]:::pieza
end
subgraph VM["Máquina virtual"]
GUEST["<b>Kernel invitado</b><br><small>se ejecuta a velocidad nativa</small>"]:::dato
end
VCPU -- "arranca la vCPU" --> KVM
VCPU1 -- "arranca la vCPU" --> KVM
KVM -- "VM entry" --> GUEST
GUEST -- "VM exit · E/S, interrupciones" --> KVM
KVM -- "E/S no resuelta" --> DEV
KVM --> CPU
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxEn naranja la pieza que hace el trabajo de verdad: el módulo del kernel. Cada VM exit es una vuelta a él, y de ahí que virtio importe tanto.
La capa de gestión. La tercera pieza son los servicios de Proxmox de la sesión 2 (pvedaemon, pveproxy, pvestatd, del paquete pve-manager), que traducen lo que se pide en la web o con qm en la línea de órdenes de QEMU adecuada y en operaciones sobre el almacenamiento. El fichero /etc/pve/qemu-server/110.conf es la descripción de la VM; QEMU nunca lo lee, lo lee Proxmox para construir la orden con la que lanza QEMU. Por eso un cambio como el tipo de CPU queda pendiente en una VM encendida hasta que se apaga y se vuelve a encender: hasta entonces sigue corriendo el mismo proceso, con la orden antigua. Solo lo que admite conexión en caliente, como un disco o una tarjeta de red, se aplica al momento.
Paravirtualización y virtio
El problema: imitar hardware real es caro. Si QEMU puede emular cualquier tarjeta, ¿por qué no se usa siempre la e1000, una tarjeta de red de Intel que reconoce cualquier sistema? Porque emular hardware real es lento. El driver de una e1000 escribe en decenas de registros por cada paquete, y en una VM cada una de esas escrituras es un VM exit. Con 10 Gbit/s de tráfico, la CPU del host se pasaría el día saliendo y entrando de la VM.
La solución: que el invitado sepa que es una VM. La alternativa es la paravirtualización: el sistema invitado sabe que está virtualizado y usa un driver diseñado para hablar con el hipervisor en lugar de fingir que hay hardware. La idea la popularizó Xen en 2003; el estándar en KVM es virtio, que nació dentro del propio Linux para servir a cualquier hipervisor y hoy es una especificación abierta, publicada por el consorcio OASIS. Un dispositivo virtio no tiene registros que emular; tiene colas (virtqueues) en memoria compartida entre invitado y QEMU. El invitado encola descriptores de paquetes o de bloques, avisa una vez ("kick") y QEMU procesa el lote. El número de VM exits por operación baja de decenas a uno, o a cero cuando se combina con vhost (el procesado se hace en el kernel del host sin pasar por QEMU).
flowchart TB
subgraph EMU["Tarjeta emulada · e1000"]
direction TB
G1["<b>Driver del invitado</b><br><small>cree que hay una tarjeta real</small>"]:::pieza
X1["<b>Decenas de VM exits</b><br><small>por paquete</small>"]:::riesgo
Q1["<b>QEMU</b><br><small>emula registro a registro</small>"]:::pieza
G1 --> X1 --> Q1
end
subgraph VIR["Paravirtualizado · virtio"]
direction TB
G2["<b>Driver virtio</b><br><small>sabe que está virtualizado</small>"]:::pieza
X2["<b>Un kick por lote</b><br><small>colas en memoria compartida</small>"]:::ok
Q2["<b>QEMU</b><br><small>procesa el lote · con vhost, el kernel del host</small>"]:::pieza
G2 --> X2 --> Q2
end
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxLa diferencia no es el hardware sino cuántas veces hay que salir de la VM. Por eso virtio es el ajuste por defecto en Proxmox.
En Proxmox, virtio en todo. Por eso en Proxmox las opciones por defecto son las que son y no hay que cambiarlas:
- Disco: VirtIO SCSI (
scsihw: virtio-scsi-pcio mejorvirtio-scsi-single, que da un hilo de E/S por disco). Frente a IDE o SATA emulados, multiplica el rendimiento de E/S varias veces y añade el descarte de bloques (TRIM) que necesita el thin provisioning de la sesión 2. Existe tambiénvirtio-blk(busvirtio0), algo más antiguo; SCSI es hoy el recomendado porque admite muchos discos por controladora y comandos SCSI reales. - Red: virtio (
virtio-net). Es el único modelo que llega a las velocidades de la red física. Se usae1000ortl8139solo con sistemas antiguos sin drivers virtio. - Memoria: virtio-balloon, el driver del ballooning de la sesión 3.
- Consola y agente: virtio-serial, el canal por el que habla el agente QEMU.
Linux lleva los drivers virtio en el kernel desde hace más de una década, así que cualquier imagen cloud de Debian o Ubuntu arranca con ellos sin hacer nada.
\"He instalado Windows y no ve el disco\"
Windows no trae los drivers virtio. Hay que cargarlos desde la ISO virtio-win durante la propia
instalación, en el paso en el que el instalador pide dónde instalar. Es la pregunta más repetida
en los foros de Proxmox.
LXC frente a VM, con números
Un contenedor que se comporta como una máquina. Proxmox ofrece contenedores de sistema LXC junto a las VM. LXC (Linux Containers) apareció en 2008 como un conjunto de herramientas para crear contenedores con los namespaces y los cgroups de la sesión 1, y las primeras versiones de Docker, en 2013, se apoyaban en él. Pero un contenedor LXC no es un contenedor Docker. Uno de Docker ejecuta una aplicación, normalmente un solo proceso; uno LXC ejecuta un sistema operativo completo desde init (systemd, sshd, cron), solo que sin kernel propio. Comparte el del host, con el mismo aislamiento que Docker, y Proxmox lo gestiona como si fuera una VM ligera: consola, snapshots, backups, migración en frío.
Cómo se crea. Se descarga una plantilla de sistema (un archivo comprimido con el sistema de ficheros de una distribución mínima) y se crea el contenedor a partir de ella:
pveam update
pveam available --section system | grep debian
pveam download local debian-12-standard_12.7-1_amd64.tar.zst
pct create 170 local:vztmpl/debian-12-standard_12.7-1_amd64.tar.zst \
--hostname ct01 --memory 512 --cores 1 --rootfs local-lvm:4 \
--net0 name=eth0,bridge=vmbr0,ip=dhcp --unprivileged 1 --features nesting=1
pct start 170
pct enter 170
Dos opciones de esa orden merecen explicación. --unprivileged 1 hace que el root de dentro del contenedor sea, para el host, un usuario cualquiera sin privilegios: si algo escapa del contenedor, escapa sin poder. --features nesting=1 deja al contenedor crear sus propios namespaces dentro, que es lo que necesita el systemd de las distribuciones actuales para funcionar bien.
Los números. Medidas de referencia tomadas sobre un portátil con SSD NVMe y un Proxmox anidado. Sirven para comparar el orden de magnitud, no para copiarlas: cada laboratorio da números distintos, y por eso se vuelven a tomar en la actividad A1.4.
| VM Debian (2 vCPU, 2 GB, virtio) | LXC Debian (1 núcleo, 512 MB) | |
|---|---|---|
| Arranque hasta prompt SSH | 12 a 18 s | menos de 2 s |
| RAM usada en el host en reposo | 350 a 450 MB (RAM tocada por el invitado más QEMU) | 25 a 40 MB |
| Espacio en disco tras instalar | 1,3 GB (imagen cloud desplegada) | 450 MB |
uname -r |
El kernel de la imagen cloud (6.1 en Debian 12, 6.12 en Debian 13) | El kernel del host Proxmox (6.x de Proxmox) |
| Sobrecarga de CPU | 2 a 5 % en cargas normales, más en E/S intensa | Prácticamente cero |
| Densidad en un host de 32 GB | 10 a 12 VM de 2 GB | 60 o más contenedores de 512 MB |
Las diferencias salen de lo que cada uno tiene que hacer. La VM arranca su firmware y su propio kernel antes de llegar a init; el contenedor arranca init como un proceso más sobre un kernel que ya está en marcha. La VM tiene en memoria su kernel, sus cachés y el proceso QEMU; el contenedor, solo sus procesos. Y uname -r dice de quién es el kernel que responde: la VM tiene el suyo, el contenedor ve el del host.
Por qué no se usa para todo.
- Comparten kernel: menor aislamiento; un fallo del kernel afecta a todos, y un contenedor privilegiado con acceso a
/deves root en el host. Conviene usar siempreunprivileged 1salvo que haya un motivo claro para no hacerlo. - No ejecutan otro kernel ni otro sistema operativo: nada de Windows, nada de FreeBSD, nada de módulos de kernel propios, nada de hipervisor anidado.
- Docker dentro de LXC funciona (con
nesting=1ykeyctl=1) pero es una configuración que Proxmox desaconseja oficialmente en producción; Docker se ejecuta en una VM. - No hay migración en vivo de contenedores; se migran apagados (o con un reinicio muy corto).
La regla práctica. Servicios de infraestructura pequeños y Linux (DNS, un proxy, un Pi-hole, un runner de Jenkins) en LXC; todo lo que sea plataforma de contenedores, cargas con kernel propio o algo que necesite migración en vivo, en VM. En este módulo casi todo va en VM precisamente porque encima se ejecuta Docker.
Snapshots
El problema. Antes de una operación arriesgada (una actualización, un cambio de configuración que no se sabe cómo acabará) se quiere un camino de vuelta que se recorra en segundos. Reinstalar o restaurar una copia de seguridad cuesta mucho más.
Qué es. Un snapshot es una foto del disco de una VM en un momento, y opcionalmente de su RAM, si la VM está encendida y se marca «include RAM». Se vuelve a ella con un clic o con qm rollback 110 antes-nginx. Sin la RAM, la VM vuelve apagada, con el disco tal como estaba en el momento de la foto; con ella, vuelve encendida y en el mismo punto en que estaba.
Un snapshot no es una copia de seguridad
Vive en el mismo disco y en el mismo almacén que la VM. Si muere el SSD, mueren los dos. Para eso
están vzdump y Proxmox Backup Server, que copian a otro sitio.
Cómo lo hace sin copiar nada. La técnica es el copy-on-write que se vio con ZFS en la sesión 2: al crear el snapshot no se copia ningún dato, y a partir de ese momento cada bloque que la VM modifica se escribe en un sitio nuevo, mientras el original se conserva para el snapshot. Cómo se hace en concreto depende del almacén:
- En LVM-thin, el snapshot es un volumen lógico nuevo (
snap_vm-110-disk-0_antes-nginx) que comparte todos los bloques con el disco original. A partir de ese momento cada escritura de la VM sobre un bloque compartido se hace en un bloque nuevo (copy-on-write a nivel de bloque del pool). El snapshot ocupa cero al crearse y va creciendo con lo que la VM modifique. La lista está enlvs pve. - En ZFS es igual pero a nivel de sistema de ficheros:
zfs list -t snapshot. Crear y destruir es instantáneo. - En un directorio con qcow2, el snapshot es interno al fichero: qcow2 guarda una tabla de snapshots y hace copy-on-write de sus propios clústeres.
qemu-img snapshot -l vm-110-disk-0.qcow2los lista. Con raw en un directorio no hay snapshots.
Lo que cuesta. En cualquiera de los tres, cada snapshot activo añade una capa de indirección a las lecturas y escrituras. Tres o cuatro no se notan; veinte encadenados durante meses sí, y además consumen espacio del pool que nadie ve en el disco de la VM. La costumbre correcta es snapshot antes de una operación arriesgada y borrarlo (o consolidarlo) en cuanto se confirma que todo va bien. El agente QEMU permite congelar el sistema de ficheros del invitado un instante mientras se hace el snapshot, de modo que sea consistente; sin agente, el snapshot equivale a un corte de corriente y el invitado tendrá que revisar el sistema de ficheros al restaurar.
flowchart LR
A["<b>Disco de la VM</b><br><small>bloques A B C D</small>"]:::dato
S["<b>Se crea el snapshot</b><br><small>comparte los cuatro bloques · ocupa 0</small>"]:::dato
W["<b>La VM modifica B</b><br><small>copy-on-write: B' va a un bloque nuevo</small>"]:::pieza
RB["<b>rollback</b><br><small>se vuelve a A B C D</small>"]:::act
DEL["<b>delsnapshot</b><br><small>se suelta B y se libera espacio</small>"]:::ok
A --> S --> W
W -- "salió mal" --> RB
W -- "salió bien" --> DEL
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxEl snapshot no copia nada al crearse: crece con lo que la VM cambie después. Vive en el mismo disco que la VM, así que no es una copia de seguridad.
qm snapshot 110 antes-nginx --description "Antes de instalar nginx"
qm listsnapshot 110
qm rollback 110 antes-nginx
qm delsnapshot 110 antes-nginx
Backups con vzdump y Proxmox Backup Server
Material de consulta
Esto no se explica en clase: lo necesitas para la hoja de práctica de esta sesión.
Lo que no resuelve un snapshot. Un snapshot vive en el mismo disco que la VM, así que no protege de perder ese disco, ni de borrar la VM por error. Para eso hace falta una copia completa guardada en otro sitio, y en Proxmox la herramienta integrada es vzdump.
Cómo funciona vzdump. Copia la VM entera (configuración y discos) a otro almacén, y se puede programar desde Datacenter > Backup. Tiene tres modos, que se diferencian en cuánto molestan a la VM: stop (apaga la VM, copia y la enciende; el único con consistencia total garantizada), suspend (la pausa mientras copia) y snapshot (el habitual: hace un snapshot temporal, copia desde él mientras la VM sigue funcionando y lo borra al terminar; con el agente QEMU congela el sistema de ficheros para que sea consistente). El resultado es un fichero .vma.zst (el formato de archivo de VM de Proxmox, comprimido) o .tar.zst (contenedor) en el directorio dump del almacén elegido, por ejemplo /var/lib/vz/dump/vzdump-qemu-110-2026_10_16-10_30_00.vma.zst. Se restaura con qmrestore o desde la web, con la posibilidad de cambiar el ID y el almacén de destino. La copia guarda también la configuración, MAC de la tarjeta incluida, así que la VM restaurada es un gemelo de la original.
vzdump 110 --storage local --mode snapshot --compress zstd --notes-template "{{guestname}}"
ls -lh /var/lib/vz/dump/
qmrestore /var/lib/vz/dump/vzdump-qemu-110-*.vma.zst 151 --storage local-lvm
Cuando las copias crecen. Cada copia de vzdump a fichero es completa, así que con muchas VM y retención larga el disco se acaba pronto. Proxmox Backup Server (PBS) es un producto aparte, también libre, que guarda cada trozo de disco una sola vez y solo lee lo cambiado desde la copia anterior; cómo lo hace está en Proxmox Backup Server.
Lo que se encuentra fuera del aula
En una empresa con Proxmox, PBS es la opción normal. En el laboratorio del curso no se monta, pero
conviene saber que existe y que "backup a local" es lo mínimo, no lo correcto: una copia en
el mismo servidor que el original no protege de que se estropee ese servidor.
A1.4 VM frente a LXC, snapshots (sesión 4)
Objetivo Una tabla con tus medidas de VM frente a LXC, un snapshot de web01 al que has vuelto y un backup restaurado como VM 151. Con la tabla pones números propios a la diferencia entre una VM y un contenedor, que la práctica evaluable te va a pedir; con el snapshot y el backup pruebas las dos formas de volver atrás y lo que protege cada una.
Antes de empezar
web01funcionando con agente QEMU y acceso SSH (A1.3).- Lo explicado al principio de la sesión: KVM/QEMU y virtio, LXC frente a VM y snapshots. Para el paso del backup, vzdump es material de consulta.
Pasos
La hoja tiene dos mitades. En la primera mides una VM y un contenedor con las mismas medidas, para que la comparación valga: primero web01, que ya existe, y después ct01, que creas hoy. En la segunda proteges web01 de las dos formas de la teoría, de la más rápida a la más segura: un snapshot, que te devuelve atrás en segundos pero vive en el mismo disco, y un backup, que tarda más pero sobrevive a perder ese disco.
-
Mide la VM. Mide
web01desde apagada: la RAM usada en el host antes y después de arrancarla, su tiempo de arranque y suuname -r. Son las tres filas de LXC frente a VM que mejor muestran lo que cuesta tener un kernel propio.Pista: en la VM, el tiempo de arranque es lo que tarda en contestar por SSH; dentro,
systemd-analyzelo desglosa. -
Mide un contenedor igual. Crea el contenedor
ct01(ID 170, no privilegiado, 512 MB) como en LXC frente a VM y toma las mismas medidas. Compara suuname -rcon el de la VM y con el del host: es la prueba directa de quién tiene kernel propio y quién no.Pista: si el nombre de la plantilla de Debian ha cambiado, usa el que muestre
pveam available. -
Vuelve atrás con un snapshot. Haz un snapshot de
web01llamadoantes-nginx, mirandolvs pveantes y después: el volumen que aparece es el que tendrás que explicar al final con lo visto en Snapshots. Instala nginx dentro, vuelve al snapshot y comprueba si nginx sigue. Es el uso normal de un snapshot: una red de seguridad justo antes de un cambio.Pista: tras el rollback,
web01queda apagada. -
Haz una copia que sobreviva al disco. Haz un backup de
web01alocalen modo snapshot, apunta lo que ocupa y lo que tarda, y restáuralo como VM 151 con las órdenes de vzdump. Restaurar es la mitad que importa: de una copia que nunca se ha restaurado no se sabe si sirve.Pista: arranca la 151 con
web01apagada: tienen la misma MAC y en el mismo bridge se pisarían.
Comprobación Tienes tiempo de arranque, RAM en el host y uname -r para la VM y para el LXC (el LXC muestra el kernel del host); tras el rollback, nginx no está en web01; en lvs pve apareció snap_vm-110-disk-0_antes-nginx al crear el snapshot; qm list muestra la 151 y arranca.
Para practicar Guarda en el documento de la unidad tu tabla VM frente a LXC con sus capturas y las de lvs pve antes y después del snapshot, explicando qué volumen apareció, y apunta el tamaño y el tiempo del backup. La práctica evaluable parte de la tabla.
Si te sobra tiempo Borra el snapshot (qm delsnapshot 110 antes-nginx) y comprueba en lvs pve que el volumen desaparece. Con web01 encendida, ps aux | grep 'kvm -id 110' en el host te enseña la línea de QEMU completa que Proxmox ha construido desde /etc/pve/qemu-server/110.conf: localiza en ella el disco virtio-scsi, la tarjeta virtio-net y el tipo de CPU.
Sesión 5 · Redes en el hipervisor
Hasta ahora cada VM ha ido a una de dos redes: la del aula, por vmbr0, o la interna del host, por vmbr1. Una plataforma de verdad necesita bastantes más, separadas entre sí, y esta sesión repasa todas las formas que tiene el hipervisor de conectar VM y qué resuelve cada una, desde el bridge de la sesión 2 hasta las que agrupan tarjetas o hacen de router. Después explica a fondo la que monta la hoja, la VLAN, que es la forma habitual de llevar muchas redes aisladas por un mismo bridge o un mismo cable. La segunda mitad de la hoja es de otro tipo: medir con herramientas propias qué aguanta el laboratorio, porque el criterio de evaluación de la unidad pide conocer las capacidades y limitaciones del hipervisor, y eso no se aprende leyendo. Ese apartado no se explica en clase: conviene leerlo antes del paso 4 de la hoja, porque la tabla que sale de él es el borrador de la práctica evaluable. Al acabar, hay tres VM en vmbr1 repartidas en dos VLAN que solo se ven dentro de su VLAN, y las primeras medidas de CPU, disco y red del laboratorio.
Modalidades de red: bridge, NAT, VLAN y bond
Cinco formas de conectar una VM. Todas se construyen con el bridge de Red, y se diferencian en adónde llega lo que se conecta a él:
- Bridge simple (
vmbr0coneno1como puerto): las VM están en la misma red que el host y reciben IP del router del aula. Es la opción con la que se instala Proxmox y la que da acceso inmediato a las VM desde el portátil; en esta unidad, la deweb01,app01ymon01. - Bridge sin interfaz física (
bridge-ports none): red interna solo entre VM y el host. Es la base de las VPC. Las VM no salen a Internet salvo que alguien enrute por ellas. - NAT: el bridge interno más dos cosas en el host, que pasa a hacer de router:
ip_forward, que le deja reenviar paquetes de una red a otra, y una regla de masquerade, que cambia la dirección de origen de lo que sale de las VM por la suya, para que las respuestas vuelvan a él. Es cómodo cuando el aula solo da una IP y hacen falta muchas VM con salida a Internet sin exponerlas. Se configura conpost-upen el bridge; la documentación de Proxmox trae el ejemplo exacto. - VLAN-aware bridge (
bridge-vlan-aware yes): un solo bridge transporta varias redes separadas por etiquetas; cada VM indica la suya (tag) en la tarjeta virtual. Es la forma de tener varias redes aisladas con un solo bridge, lo que se monta en la actividad A1.5, y se explica en el apartado siguiente. - Bond: varias tarjetas físicas agrupadas en una interfaz
bond0, para tener redundancia o sumar ancho de banda; esbond0, no las tarjetas, lo que se pone como puerto del bridge. La VM de Proxmox del laboratorio tiene una sola tarjeta, así que aquí no se monta: los modos y un fichero de ejemplo están en Bond: modos y configuración.
flowchart TB
subgraph S1["Bridge simple · la VM está en la red del aula"]
direction LR
A1["<b>VM</b>"]:::act --- A2["<b>vmbr0</b>"]:::pieza --- A3["<b>eno1</b>"]:::infra --- A4(("<b>Red del aula</b>")):::infra
end
subgraph S2["Bridge sin puerto físico · red interna"]
direction LR
B1["<b>VM</b>"]:::act --- B2["<b>vmbr1</b><br><small>bridge-ports none</small>"]:::pieza
end
subgraph S3["NAT · el host hace de router"]
direction LR
C1["<b>VM</b>"]:::act --- C2["<b>vmbr1</b><br><small>ip_forward + masquerade</small>"]:::pieza --- C3(("<b>Internet</b>")):::infra
end
subgraph S4["VLAN aware · varias redes por un bridge"]
direction LR
D1["<b>VM</b><br><small>tag 10</small>"]:::act --- D2["<b>vmbr0</b><br><small>vlan-aware</small>"]:::pieza
D3["<b>VM</b><br><small>tag 20</small>"]:::act --- D2
D2 --- D4["<b>trunk</b><br><small>al switch del aula</small>"]:::infra
end
subgraph S5["Bond · redundancia o ancho de banda"]
direction LR
E1["<b>eno1</b>"]:::infra --- E2["<b>bond0</b>"]:::pieza
E3["<b>eno2</b>"]:::infra --- E2
E2 --- E4["<b>vmbr0</b>"]:::pieza
end
S1 ~~~ S2 ~~~ S3 ~~~ S4 ~~~ S5
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxLas cinco conviven en el mismo host. En la A1.5 se monta la cuarta.
Cambiar la red del host a distancia
Un error en /etc/network/interfaces deja sin acceso al Proxmox. En un laboratorio anidado queda la consola de la VM exterior y no pasa nada; en un servidor real, los cambios se hacen desde la web (que valida y aplica con ifreload) o se deja programado un sleep 120 && ifreload -a con la configuración antigua a mano. Y antes de tocar vmbr0, conviene comprobar qué interfaz física es la buena con ip -br link y ethtool eno1.
VLAN: varias redes en un mismo bridge
El problema. Con bridges sin tarjeta física se pueden hacer redes aisladas, pero cada red nueva es un bridge nuevo, y un bridge no puede salir del host sin una tarjeta física propia. En una empresa pasa lo mismo con los switches: no se compra un switch, ni se tira un cable, por cada red. La solución estándar es la VLAN (red local virtual, definida en el estándar IEEE 802.1Q): un mismo switch, o un mismo bridge, separa varias redes como si fueran switches distintos.
Cómo funciona. A cada trama Ethernet se le puede añadir una etiqueta con un número de VLAN, del 1 al 4094. El switch solo entrega una trama a los puertos de su misma VLAN, así que dos máquinas en VLAN distintas no se ven aunque estén en el mismo switch: para hablar, tendrían que pasar por un router. Los puertos son de dos tipos. Uno de acceso pertenece a una sola VLAN y sus tramas viajan sin etiqueta, así que la máquina conectada no sabe nada de VLAN. Uno troncal (trunk) lleva varias VLAN a la vez, cada trama con su etiqueta, y es el que une un switch con otro.
Cómo lo hace un bridge de Proxmox. Con bridge-vlan-aware yes, el bridge se comporta como uno de esos switches. La etiqueta que se pone en la tarjeta de una VM (tag=10) convierte su interfaz tap en un puerto de acceso de la VLAN 10: el bridge quita la etiqueta a lo que entrega a la VM y se la pone a lo que la VM envía, así que la VM no sabe en qué VLAN está. La línea bridge-vids 2-4094 dice qué VLAN admite el bridge en sus puertos. Si las VLAN tuvieran que salir del host, la tarjeta física haría de puerto troncal, y el puerto del switch del aula al que va conectada tendría que estar configurado igual; en un bridge sin tarjeta física, como vmbr1, no hace falta nada más. En el host, bridge vlan show lista cada puerto con sus VLAN: un puerto de acceso aparece con una sola VLAN, marcada como PVID (la que se asigna a lo que entra sin etiqueta) y Egress Untagged (lo que sale, sale sin ella).
Y el host. La IP que el host tiene en el bridge, la 10.10.10.1 de vmbr1, va sin etiqueta, en la VLAN por defecto del bridge, que es la 1. Por eso el host no llega a las VM de la VLAN 10 ni de la 20, que es justo el aislamiento que se busca. Cuando el host necesita un pie en una VLAN, se le crea una interfaz VLAN sobre el bridge con una IP de esa red: vmbr1.30 sería la del host en la VLAN 30, y es lo primero que monta la práctica evaluable.
Capacidades y limitaciones, y cómo medirlas
Material de consulta
Esto no se explica en clase: lo necesitas para la hoja de práctica de esta sesión.
Por qué se mide. El criterio de evaluación pide conocer las capacidades y limitaciones del hipervisor, y eso no se aprende leyendo: se mide. Casi todo lo que ofrece un hipervisor consiste en prometer más de lo que hay (más vCPU que núcleos, más memoria, más disco), y su límite no es un número del manual, sino el punto en que esa promesa deja de cumplirse porque todas las VM piden a la vez. Primero va la tabla de qué permite hacer un hipervisor y dónde está el riesgo de cada cosa, y después las herramientas con las que tomar las medidas propias.
| Capacidad | Qué permite | Límite o riesgo |
|---|---|---|
| Sobreasignación de CPU | Dar más vCPU en total que núcleos físicos (4:1 es habitual en cargas de oficina) | Si todas trabajan a la vez, se degrada todo; el steal time (tiempo que la vCPU esperó a que el host le diera un núcleo) dentro de las VM lo delata |
| Ballooning de RAM | Recuperar memoria no usada (Proxmox empieza a reclamarla cuando el host pasa del 80 %) | Nunca sobreasignar más de lo físico + swap; el invitado necesita el driver virtio-balloon, y la RAM reclamada sale de su caché de disco, así que rinde peor |
| Hotplug | Añadir disco, red, CPU o RAM en caliente | Depende del SO invitado; RAM requiere numa=1 y que el invitado reconozca los módulos añadidos; la CPU en caliente solo con vcpus menor que cores |
| Virtualización anidada | Hipervisor dentro de VM | Rendimiento reducido (cada VM exit del hipervisor interior es un VM exit del exterior); solo laboratorio |
| Passthrough (IOMMU) | Dar una tarjeta gráfica, una controladora o una tarjeta de red a una VM | El dispositivo deja de estar disponible para el host y la VM ya no puede migrar en vivo |
| LXC | Contenedores de sistema muy ligeros | Comparten kernel: menor aislamiento; no ejecutan otro kernel |
| Snapshots | Volver atrás en segundos | Muchos snapshots encadenados frenan el disco y llenan el pool |
| Thin provisioning | Prometer más disco del que hay | Pool lleno = VM corruptas; hay que vigilar y descartar |
Hay otra forma de ahorrar memoria, la fusión de páginas iguales entre VM, que en el laboratorio no se toca; está en Fusión de páginas iguales.
Regla de oro: medir antes de sobreasignar. Un hipervisor de aula con 32 GB no debe albergar 20 VM de 2 GB "porque no se usan todas a la vez". Tarde o temprano se usan, y lo que ocurre entonces es mucho peor que haber puesto 12: el host se queda sin memoria y su OOM killer (el mecanismo del kernel que mata procesos cuando se agota la memoria) mata, sin avisar, la VM que más ocupa.
Las herramientas. La práctica evaluable pide precisamente una tabla como la de arriba, pero con las medidas del laboratorio propio. Todas las herramientas están en los repositorios de Debian (apt install stress-ng fio iperf3 sysstat), y cada una mide una cosa:
stress-ngcarga la CPU y cuenta el trabajo hecho en bogo ops/s, una unidad propia que solo sirve para compararla consigo misma: la misma prueba en la misma VM, con y sin otra VM trabajando a la vez.fiomide el disco. La prueba de bloques de 4 KB en posiciones al azar, con un 70 % de lecturas, imita a una base de datos, que es el peor caso para un disco; la de bloques de 1 MB seguidos imita la copia de ficheros grandes, el mejor.--direct=1se salta la caché de memoria del invitado, que si no daría la velocidad de la RAM y no la del disco, y las cifras que importan son las IOPS (operaciones por segundo) y la latencia.iperf3mide la red entre dos máquinas: en una se arranca como servidor y en la otra como cliente.sysstattraeiostatysar, para observar el host mientras las VM trabajan.
# Inventario del host
nproc; lscpu | grep -E "Model name|Thread|Core|Socket|Flags" | cut -c1-120
free -h # RAM total, usada, disponible (no "free")
pvesm status # almacenes y ocupación
lvs pve/data # % de datos y metadatos del pool thin
cat /sys/module/kvm_intel/parameters/nested # Y si la anidada está activa
# CPU: cuántos núcleos reales hay detrás de las vCPU
pveperf # BOGOMIPS, REGEX/SECOND, FSYNCS/SECOND del host
stress-ng --cpu 2 --timeout 60s --metrics-brief # dentro de una VM, uno por vCPU; repetir en dos VM a la vez
top # dentro de la VM, columna "st" (steal): CPU que el host no le dio
# Disco: latencia y IOPS reales (dentro de la VM, sobre el disco virtio)
fio --name=rand4k --ioengine=libaio --rw=randrw --rwmixread=70 --bs=4k --size=1G \
--numjobs=1 --iodepth=32 --direct=1 --runtime=60 --time_based --group_reporting
fio --name=seq1m --ioengine=libaio --rw=write --bs=1M --size=2G --direct=1 --group_reporting
# Red: ancho de banda entre dos VM del mismo bridge y entre VM y host
iperf3 -s # en una VM, por ejemplo app01
iperf3 -c IP-de-app01 -t 30 -P 4 # desde la otra
# Memoria: cuánto libera el ballooning
qm monitor 110 # y dentro: info balloon
Cómo se anota. Conviene anotar no solo el resultado sino la condición: "fio 4k aleatorio 70/30 en web01 con app01 en reposo: 18 000 IOPS; con app01 ejecutando el mismo fio: 9 500 IOPS cada una". Ese segundo número es el límite del hipervisor; el primero es solo lo que hace un SSD. Lo mismo con iperf3: entre dos VM del mismo bridge suelen salir varios Gbit/s aunque la tarjeta física sea de 1 Gbit/s, porque el tráfico nunca sale del host; hacia fuera, lo que dé la tarjeta.
A1.5 Redes: VLAN (sesión 5)
Objetivo Tres VM en vmbr1 repartidas en dos VLAN que solo se ven dentro de su VLAN, y las primeras medidas de CPU, disco y red de tu laboratorio. Las VLAN son la forma habitual de separar redes sobre un mismo bridge, y las medidas son el borrador de la tabla de capacidades de la práctica evaluable.
Antes de empezar
- Plantilla 9000 y
vmbr1(A1.2 y A1.3);web01yapp01funcionando envmbr0;stress-ng,fioeiperf3instalados en el host. - Lo explicado al principio de la sesión: red, modalidades de red (bridge simple, VLAN-aware, bond y NAT) y VLAN en un bridge. Para las medidas, capacidades y limitaciones es material de consulta: lee ese apartado antes del paso 4.
Haz la cuenta de RAM antes de encender
El Proxmox tiene 12 GB y se queda con cerca de 2; web01 (1 GB), app01 (2 GB) y mon01 (3 GB) ya suman 6. Tres clones con los 2 GB que heredan de la plantilla pasarían de los 10 disponibles: por eso las VM de prueba van con 512 MB y se apagan en cuanto termina la comprobación de VLAN. app01 y mon01 siguen encendidas toda la sesión, porque las usa Mantenimiento. Si vas justo, apaga la VM 151, ct01 y web02, que ya no hacen falta.
Pasos
La hoja tiene dos partes independientes. En la primera montas el aislamiento por VLAN en el orden en que lo atraviesa una trama: primero el bridge que entiende de etiquetas, después las VM con su etiqueta y al final la prueba de quién ve a quién, desde las VM y desde el host. En la segunda mides el laboratorio. Entre una y otra apagas las VM de prueba, porque la memoria no da para todo a la vez, y las medidas se toman en web01 y app01, que tienen Internet para instalar las herramientas.
-
Haz que
vmbr1entienda de etiquetas. Hazlo VLAN aware desde nodo > Network. Sin esto, el bridge pasa por alto las etiquetas de las tarjetas y todas las VM se verían entre sí, como se explica en VLAN: varias redes en un mismo bridge. -
Clona las VM de prueba en sus VLAN. Clona de la plantilla tres VM de prueba, enlazadas porque solo viven esta sesión y con 512 MB porque la memoria no da para más, con la tarjeta en
vmbr1e IP fija por cloud-init, porque en esa red no hay DHCP:vlan10a(160,192.168.10.11/24) yvlan10b(161,192.168.10.12/24) con la etiqueta 10, yvlan20a(162,192.168.20.11/24) con la 20.vlan10alleva además, para que lo ensayes hoy, lo que pide la práctica evaluable: ballooning con un mínimo de 256 MB y puerta de enlace192.168.10.1, aunque hoy nadie tenga esa dirección.Pista: la etiqueta va en la propia tarjeta (
--net0 virtio,bridge=vmbr1,tag=10). El host no llega a esas VLAN, así que solo se entra por la consola: ponles una contraseña con--cipassword(por ejemplo,lab). -
Comprueba quién ve a quién. Desde la consola de
vlan10ay devlan20a, comprueba que cada VM solo ve a las de su VLAN: el ping que llega demuestra que la red funciona, y el que falla, que está aislada. Después localiza en el host en qué VLAN ha puesto el bridge cada interfaztap, que es la misma comprobación vista desde dentro del switch. Al terminar, apaga las tres, porque el paso 4 necesita esa RAM; si no vas a hacer «Si te sobra tiempo», destrúyelas.Pista:
qm terminal 160abre la consola serie, de la que se sale con Ctrl+O. En el host,bridge vlan show. -
Mide el laboratorio. Mide CPU, disco y red en
web01yapp01, que están envmbr0y pueden instalar paquetes, con las herramientas de capacidades y limitaciones: CPU y disco, primero enweb01sola y después conapp01haciendo lo mismo a la vez; la red, entre las dos. El número que importa es el que sale cuando las dos compiten, porque es el límite del hipervisor; por eso anota junto a cada número la condición en que lo tomaste.Pista: las herramientas hay que instalarlas también dentro de cada VM, no solo en el host.
Comprobación qm config 160 muestra balloon: 256 y la puerta de enlace en ipconfig0; el ping funciona entre 192.168.10.11 y 192.168.10.12 y falla hacia 192.168.20.11; bridge vlan show coloca cada tap en su VLAN; las tres VM de prueba aparecen como stopped en qm list al empezar las medidas, y app01 y mon01 siguen encendidas; tienes un valor de bogo ops/s, de IOPS y de Gbit/s con y sin carga simultánea.
Para practicar Dibuja en el documento de la unidad, en Mermaid o a mano, las tres VM, el bridge y las VLAN, y guarda las capturas del ping y de bridge vlan show. Pasa a una tabla las medidas de CPU, disco y red con la condición de cada una: la práctica evaluable parte de ella.
Si te sobra tiempo Vuelve a encender las tres VM de prueba y mide con iperf3 el ancho de banda entre las dos VM de la VLAN 10: para instalarlo necesitan Internet, así que añade a cada una una segunda tarjeta temporal en vmbr0 (qm set 160 --net1 virtio,bridge=vmbr0, dentro sudo dhclient sobre la interfaz nueva que muestre ip -br link), instala, quita la tarjeta (qm set 160 --delete net1) y mide entre 192.168.10.11 y 192.168.10.12. Cambia vlan20a a tag 10 (qm set 162 --net0 virtio,bridge=vmbr1,tag=10) y comprueba que ahora sí responde al ping desde vlan10a. Al terminar, vuelve a apagar las tres o bórralas con qm destroy.
Sesión 6 · Práctica evaluable
Esta sesión no tiene teoría nueva: demuestras que sabes hacer sin hoja lo que has hecho en las cinco anteriores, sobre el Proxmox que montaste en ellas. El criterio de la unidad (RA1 a) tiene dos mitades, y el informe recoge las dos: un hipervisor instalado y configurado, con una VM desplegada exactamente como se pide, y el conocimiento de sus capacidades y limitaciones, demostrado con medidas propias. Los primeros 10 minutos son para aclarar el enunciado; el resto es tiempo de trabajo. La tabla de capacidades y limitaciones no pide medidas nuevas: sale de las que ya tomaste en las hojas con las herramientas del apartado capacidades y limitaciones de la sesión 5, cada una con la condición en que se tomó.
El orden de lo que sigue no es casual: primero haces sitio en la memoria, porque app-eval no cabe con todo encendido; después abres el camino para llegar a ella, porque en su VLAN no hay nada; y solo entonces la despliegas.
Antes del enunciado, la RAM. Apaga lo que no hace falta hoy: web01, la VM 151 restaurada, el contenedor ct01 y, si siguen encendidas, web02 y las VM de la VLAN. app01 y mon01 siguen encendidas, porque las usa Mantenimiento. Quedan unos 2 GB del propio Proxmox, los 5 GB de esas dos VM y los 3 GB de app-eval: 10 de los 12 GB.
Después, el camino de entrada. Una VM en la VLAN 30 de vmbr1 no tiene DHCP, ni salida a Internet, ni camino hacia el host, porque la 10.10.10.1 del host en vmbr1 va sin etiquetar (por qué, en VLAN: varias redes en un mismo bridge). Crea primero en el host la interfaz VLAN vmbr1.30, con 192.168.30.1/24: en la web es Create > Linux VLAN, sobre vmbr1 y con tag 30. Esa dirección es la puerta de entrada por SSH a la VM, que lleva una IP fija de esa misma red por cloud-init. El agente QEMU no hay que instalarlo: viene dentro de la plantilla desde la A1.3, que es justo lo que salva esta práctica, porque sin Internet no se puede instalar nada en el primer arranque. Por la misma razón, la actualización de paquetes que cloud-init hace en ese primer arranque solo puede fallar: puedes desactivarla con la opción que explica cloud-init o, si la dejas, no te extrañe ver ese fallo en su registro aunque la VM esté bien.
Enunciado. Despliega desde la plantilla propia una VM llamada app-eval, con un ID libre del rango de pruebas de dev (150 a 199), 2 vCPU, 3 GB de RAM con ballooning (mínimo 1 GB), disco de 20 GB, red en vmbr1 con VLAN 30, IP fija por cloud-init en 192.168.30.0/24 con puerta de enlace 192.168.30.1, usuario ops con clave SSH y agente QEMU funcionando.
Entrega Un informe (máximo 3 páginas) con:
- Configuración del hipervisor, reutilizando lo que guardaste en la A1.2 (pasos 1, 4 y 5 de la A1.2): repositorios sin
pve-enterprise,pveum user listconadmin@pvey/etc/network/interfaces, ahora convmbr1.30. - Comandos o capturas del proceso: creación de
vmbr1.30en el host, clonado,qm setyqm cloudinit dump(las mismas órdenes que los pasos 4 y 6 de la A1.3 y el paso 2 de la A1.5). - Evidencia de que la VM cumple lo pedido:
qm config <ID de la VM>(qmno acepta nombres de VM, solo ID; el ID sale deqm list),free -hynprocdentro de la VM,lsblk, IP en la VLAN 30 visible en la web de Proxmox gracias al agente, acceso SSH comoopsdesde el host a través de192.168.30.1. - Una tabla de capacidades y limitaciones del hipervisor del laboratorio (CPU, RAM, disco, red, anidada) con una medida real de cada una y la condición en que se tomó: CPU, disco y red del paso 4 de la A1.5, RAM de los pasos 1 y 2 de la A1.4 y anidada del paso 5 de la A1.1.
| Criterio (RA1 a) | Peso |
|---|---|
| Hipervisor instalado y configurado correctamente (repos, usuario, red) | 30 % |
| VM cumple la especificación y se demuestra | 40 % |
| Tabla de capacidades y limitaciones con medidas reales | 30 % |
Cuando hayas entregado, destruye las VM de prueba de la unidad, que ya no hacen falta y dejan libre el rango 150 a 199 para las unidades siguientes: app-eval, la 151 restaurada, web02 (150) si la creaste y el contenedor ct01 (170). web01, app01 y mon01 se quedan.
Errores frecuentes en el laboratorio
"KVM virtualisation configured, but not available" al arrancar la primera VM en el Proxmox anidado. La virtualización anidada no está activada en el hipervisor exterior, la VM exterior no tiene CPU host (si el exterior es otro Proxmox) o Hyper-V está activo en el Windows del puesto. Se comprueba en la shell del Proxmox: si grep -Ec '(vmx|svm)' /proc/cpuinfo da 0 y no existe /sys/module/kvm_intel (o kvm_amd), el módulo de KVM no ha podido cargar porque la CPU que ve no trae las extensiones, y el problema está fuera. Como parche para salir del paso, kvm: 0 en la configuración de la VM la ejecuta en emulación (lentísima); no es una solución.
Las VM de vmbr0 no reciben IP del aula, aunque el Proxmox sí la tiene. El hipervisor exterior descarta las tramas dirigidas a direcciones MAC que no son la de su propia VM, que son justo las de las VM de dentro. En VirtualBox se arregla poniendo en «Permitir todo» el modo promiscuo del adaptador puente de la VM de Proxmox, y reiniciando el nodo si no basta. Si el puesto va por Wi-Fi, el puente puede no dejar pasar esas direcciones de ninguna forma, y hay que ir por cable.
Proxmox no actualiza: "401 Unauthorized" en apt update. Sigue activo el repositorio pve-enterprise, o el de Ceph, que también es enterprise: los dos exigen suscripción. Hay que desactivarlos y añadir pve-no-subscription (en la web: nodo > Updates > Repositories). En Proxmox VE 9 los repositorios están en formato deb822 en /etc/apt/sources.list.d/*.sources; en la 8, en *.list. Mientras esté el enterprise, apt fallará aunque el resto esté bien.
La VM clonada no coge IP o no acepta la clave SSH. Por orden de probabilidad: (1) el disco cloud-init no está en la VM (qm config 110 | grep cloudinit); (2) la clave de ese origen no está en el fichero que se pasó a --sshkeys (por ejemplo, entra desde el nodo y no desde el puesto porque faltó /root/puesto.pub), o se pegó con saltos de línea o sin el ssh-ed25519 inicial (qm cloudinit dump 110 user lo muestra); (3) falta --ipconfig0: sin él, Proxmox no le pasa a cloud-init ninguna configuración de red para esa tarjeta; (4) la plantilla se arrancó antes de convertirla, y los clones comparten el identificador de máquina de aquel arranque, así que pueden pedir y recibir la misma IP: hay que rehacer la plantilla desde la imagen, sin arrancarla. cloud-init status --long y /var/log/cloud-init.log en la consola noVNC resuelven el 90 %.
El clon arranca con el disco del tamaño de la imagen. No se amplió el disco de la plantilla antes de convertirla, ni el del clon. Se amplía con qm disk resize 110 scsi0 20G y basta con reiniciar la VM, porque cloud-init amplía la partición y el sistema de ficheros en cada arranque. Sin reiniciar, dentro: sudo growpart /dev/sda 1 && sudo resize2fs /dev/sda1.
"TASK ERROR: storage 'local-lvm' does not support content type 'iso'" o al revés con imágenes. Cada almacén admite unos contenidos: las ISO y plantillas van a local, los discos a local-lvm. Se cambia en Datacenter > Storage, pero lo normal es usar cada uno para lo suyo.
El pool thin se llena y las VM se quedan en solo lectura. lvs pve/data con Data% cerca de 100. Liberar: borrar snapshots viejos, backups dejados en local-lvm por error, VM de prueba. Luego fstrim en todas las VM con discard=on. Y a partir de ahí, dimensionar: la suma de discos asignados no debería pasar del doble del pool en un laboratorio.
El agente QEMU aparece como "not running" aunque está instalado. Falta --agent enabled=1 en la VM (se añade y se apaga y enciende la VM, no basta un reinicio) o dentro el servicio no está activo (systemctl status qemu-guest-agent). Las imágenes cloud de Debian no lo traen instalado de origen; por eso en A1.3 se añade a la imagen con virt-customize antes de importarla, y todas las VM clonadas de la plantilla 9000 lo llevan.
node_exporter contesta en el 9100 y no en el 29100. La imagen se preparó sin el --write de Imágenes cloud y cómo se preparan, y el servicio arranca con el fichero de fábrica del paquete, con ARGS vacío. Dentro del clon, ss -tlnp muestra el puerto en el que escucha, y /etc/default/prometheus-node-exporter no lleva la línea del curso. En las VM ya clonadas se escribe esa línea a mano y se reinicia prometheus-node-exporter; la plantilla se rehace desde la imagen, a la que basta pasar otra vez virt-customize con solo el --write, porque la primera pasada ya le dejó los paquetes.
Las VM en VLAN 10 y 20 se ven entre sí. El bridge no es VLAN-aware (falta bridge-vlan-aware yes y aplicar la configuración) o las VM se conectaron sin tag. bridge vlan show en el host muestra en qué VLAN está cada tap.
Ping entre VM de la red interna funciona pero no salen a Internet. Es lo esperado en un bridge sin puerto físico. Si hace falta salida, se pone NAT en el host (ip_forward y MASQUERADE hacia vmbr0). En la UT2, la de la VPC, a partir del 4 de noviembre la da una VM router en cada entorno.
Rendimiento de disco pésimo en la VM (cientos de IOPS). Disco en bus IDE o SATA en lugar de VirtIO SCSI, o caché de disco en writethrough sobre disco mecánico, o el host anidado con disco de VirtualBox en formato dinámico sobre un disco lento. Conviene comprobar qm config y medir con fio en el host y en la VM para localizar la capa que frena.
"illegal instruction" en un programa dentro de la VM tras moverla de portátil. La VM tenía CPU host en un equipo con AVX y ahora corre en uno sin él. Hay que cambiar a x86-64-v2-AES y apagar y encender.
Los enlaces para ampliar y los apartados que van más allá de lo que se hace en clase están en Para ampliar.
UT2 · Nubes privadas virtuales (VPC)
La UT1 dejó un Proxmox funcionando, una plantilla Debian con cloud-init (ID 9000; cloud-init es lo que configura nombre, red y usuario en el primer arranque de cada clon) y dos bridges (los switches virtuales del nodo). Todas las VM clonadas hasta ahora cuelgan de vmbr0, la red del aula: reciben la dirección del router del aula y se ven con cualquier equipo de la clase. Para probar vale, pero un servicio de verdad no se monta así, por dos razones. La primera es que sus piezas no deberían compartir red: si alguien se hace con el servidor web, que es lo que se ve desde fuera, no debería tener la base de datos a un paso. La segunda es que lo que se ensaya no debería poder tocar lo que está en marcha. Por eso las empresas trabajan con varios entornos: dev (desarrollo), donde se construye y se prueba sin miedo a romper; pre (preproducción), una copia de producción donde se ensaya cada cambio antes de hacerlo de verdad; y pro (producción), donde corre el servicio que usan los clientes.
Esta unidad construye la red de esos tres entornos. Cada uno es una VPC, una red privada definida por software: un bloque de direcciones propio, partido en cuatro subredes (gestión, front, back y data), con su router, su DHCP y su DNS, y aislado de los otros dos, de forma que lo que pase en dev no pueda alcanzar pre ni pro. Se hace en el orden en que se haría en una empresa: el plano en papel, la red de dev en el SDN de Proxmox, el router que reparte direcciones y nombres, las pruebas que demuestran que funciona, pre y pro aislados de dev y, al final, lo mismo escrito en un script que habla con la API de Proxmox, para poder repetirlo sin clics. app01 y mon01 se quedan de momento en la red del aula, porque Mantenimiento las usa a diario, y esta unidad les deja reservadas su dirección y su nombre. Llegan a la VPC el 27 de noviembre, ya detrás del cortafuegos que monta la unidad de seguridad por capas (UT3).
Sesión 7 · Diseño de la VPC dev
Antes de crear una sola red en Proxmox hay que decidir cómo será, porque el direccionamiento es lo más caro de cambiar después. Esta sesión hace ese plano. La teoría empieza por lo que se quiere imitar, la VPC de una nube pública, y por sus piezas, porque todas tienen equivalente en el laboratorio. Después baja al direccionamiento en el orden en que se decide: el repaso del cálculo de subredes, qué rangos se pueden usar sin chocar con nadie, y cómo se reparten entre entornos y zonas, con una convención para las direcciones y otra para los números de VM. La hoja aplica todo eso a un plano propio de los tres entornos.
Qué es una VPC
El problema que resuelve. En una nube pública, miles de clientes comparten los mismos centros de datos, los mismos switches y los mismos cables. Cada uno necesita una red que se comporte como si fuera solo suya: con sus propias direcciones, que nadie de fuera pueda alcanzar y que pueda dividir como quiera. Eso no se puede hacer recableando cada vez que un cliente crea o borra una red: se hace con software. Una VPC (Virtual Private Cloud, nube privada virtual) es justo eso, una red privada y aislada, definida por software, dentro de una infraestructura que se comparte con otros. AWS presentó con ese nombre su servicio de redes privadas en 2009, y hoy es el primer recurso que se crea en cualquier nube: dentro de ella van las subredes, las máquinas, los balanceadores y las bases de datos gestionadas.
Lo mismo en una nube privada. En una nube privada como Proxmox u OpenStack (la plataforma libre más extendida para montarlas) el concepto es idéntico aunque cambie el nombre: SDN (red definida por software), red de proyecto, red de tenant (es decir, de cliente). La idea de fondo es la misma en todas: el rango de direcciones, cómo se trocea y qué sale a Internet lo decide quien diseña la red, y nadie de fuera de la VPC puede alcanzar sus máquinas salvo que se le abra la puerta. En el laboratorio, lo que se comparte es el nodo Proxmox, y quienes necesitan redes separadas son los tres entornos. Todo lo que se monta en esta unidad tiene así un nombre y un equivalente en cualquier nube pública, y quien entienda aquí las piezas las reconocerá en cualquier proveedor.
Las piezas. Son siempre las mismas, cambie el proveedor que cambie. En la tabla salen siglas (CIDR, NAT, SNAT, EVPN) que se explican cuando se usan, en esta sesión y en las siguientes; de momento basta con la columna del medio:
| Componente | Qué es | Equivalente en Proxmox |
|---|---|---|
| Bloque CIDR | Rango de IP de toda la VPC (p. ej. 10.10.0.0/16) | El rango del entorno, repartido entre las subnets de sus VNets |
| Subred | Trozo del bloque, normalmente por capa o zona (10.10.1.0/24) | VNet + Subnet en SDN |
| Zona de disponibilidad | Centro de datos independiente dentro de una región | Nodo del clúster |
| Tabla de rutas | Hacia dónde sale cada subred | Router virtual (VM) o zona EVPN |
| Gateway de Internet / NAT | Salida a Internet de subredes públicas o privadas | VM con NAT / firewall, o SNAT del SDN |
| DNS interno | Nombres para las máquinas de la VPC | dnsmasq en el router del entorno |
| Grupos de seguridad | Reglas de tráfico por instancia | Firewall de Proxmox (nivel VM) o del router |
El laboratorio tiene un solo nodo, así que no hay zonas de disponibilidad que repartir; qué son y cómo se simulan con uno o con dos nodos está en Zonas de disponibilidad.
Zonas: una subred por papel. Dentro de la VPC, las máquinas no van todas juntas. Una aplicación web típica tiene tres capas: el servidor web o proxy que recibe las peticiones de fuera, la aplicación que las procesa y la base de datos que guarda los datos. Cada capa necesita una exposición distinta (el proxy tiene que verse desde Internet; la base de datos, solo desde la aplicación), y por eso cada una va en su propia subred, que en el curso se llama zona: front para el proxy, back para la aplicación y data para la base de datos, más una cuarta, gestión, para lo que administra y vigila (el puesto de administración y la monitorización). Separarlas en subredes es lo que permite poner reglas entre ellas, porque el tráfico de una zona a otra tiene que pasar por el router, que es donde se puede filtrar. El cortafuegos que pone esas reglas sustituye al router el 20 de noviembre, al empezar la unidad de seguridad por capas.
Subredes públicas y privadas. Una subred es pública cuando tiene ruta directa a Internet en los dos sentidos: ahí van balanceadores, proxies inversos y bastiones (las máquinas por las que se entra a administrar). Una subred es privada cuando solo sale por NAT (puede descargar paquetes, nadie puede entrar) o directamente no sale (la base de datos no tiene ninguna razón para hablar con Internet). En el laboratorio, front será la subred «pública» de cada entorno; back y data, las privadas; y gestión, privada y además solo accesible desde una red concreta.
Los nombres en cada proveedor. La misma idea recibe estos nombres en cada sitio:
| Concepto | Proxmox SDN | AWS | Azure | GCP |
|---|---|---|---|---|
| Red privada aislada | Zona + VNet | VPC | Virtual Network (VNet) | VPC network |
| Subred | Subnet | Subnet (ligada a una AZ) | Subnet | Subnet (ligada a una región) |
| Zona de disponibilidad | Nodo | Availability Zone | Availability Zone | Zone |
| Salida NAT | VM router / SNAT | NAT Gateway | NAT Gateway | Cloud NAT |
| DNS interno | dnsmasq | Route 53 Resolver | Azure DNS privado | Cloud DNS |
| Reglas por instancia | Firewall de Proxmox | Security Group | NSG (grupo de seguridad de red) | Firewall rules |
| Unión de dos VPC | Ruta en el router | VPC Peering / Transit Gateway | VNet Peering | VPC Peering |
Lo que se monta en el curso. Cada entorno del laboratorio es una VPC con sus cuatro zonas y su router. Solo dev llega al final del curso, con el servicio entero; pre recibe sus máquinas en enero y vive hasta marzo, para ensayar los despliegues; y pro se queda en red, sin servicio, porque para lo que se usa en el curso, demostrar que un entorno no alcanza a otro, no le hace falta más. Los tres se diseñan hoy juntos porque su direccionamiento tiene que encajar.
Diseño de direccionamiento
Por qué se dibuja antes. Cambiar un rango de IP cuando ya hay veinte máquinas, un DNS y reglas de cortafuegos que lo referencian cuesta una tarde entera y algún disgusto, porque hay que cambiarlo todo a la vez y cualquier olvido deja algo sin conexión. Cinco minutos de papel ahorran eso. El direccionamiento se decide en tres pasos, que son los tres apartados siguientes: saber calcular qué cabe en cada bloque, elegir de qué rango se sacan los bloques para no chocar con nadie, y repartirlos entre entornos y zonas con una convención que se lea de un vistazo.
Repaso rápido de CIDR y subnetting
De dónde sale la notación. Hasta 1993, las direcciones IPv4 se repartían en clases de tamaño fijo (A, B y C: redes de unos 16 millones, de 65 536 o de 256 direcciones), y una organización que necesitaba dos mil direcciones recibía una clase B entera y desperdiciaba el resto. CIDR (Classless Inter-Domain Routing, enrutado entre dominios sin clases) permite cortar la red por cualquier bit; se introdujo precisamente para dejar de malgastar direcciones y para que las tablas de rutas de Internet no crecieran sin control. Hoy toda red se escribe así.
Cómo se lee. Una dirección IPv4 son 32 bits. La notación CIDR 10.10.1.0/24 dice que los 24 primeros bits identifican la red y los 8 restantes al host. Con eso se calcula todo lo demás:
- Máscara: 24 bits a uno,
255.255.255.0. - Direcciones en la red: 2^(32-24) = 256.
- Hosts utilizables: 256 menos la dirección de red (
10.10.1.0) y la de broadcast (10.10.1.255), 254. - Primera y última IP de host:
10.10.1.1y10.10.1.254.
El mismo cálculo con otros prefijos habituales:
| Prefijo | Máscara | Direcciones | Hosts útiles | Ejemplo | Broadcast |
|---|---|---|---|---|---|
| /16 | 255.255.0.0 | 65 536 | 65 534 | 10.10.0.0/16 | 10.10.255.255 |
| /22 | 255.255.252.0 | 1 024 | 1 022 | 10.10.4.0/22 | 10.10.7.255 |
| /24 | 255.255.255.0 | 256 | 254 | 10.10.1.0/24 | 10.10.1.255 |
| /26 | 255.255.255.192 | 64 | 62 | 10.10.1.64/26 | 10.10.1.127 |
| /28 | 255.255.255.240 | 16 | 14 | 10.10.1.16/28 | 10.10.1.31 |
| /30 | 255.255.255.252 | 4 | 2 | 10.10.9.0/30 | 10.10.9.3 |
Dónde puede empezar un bloque. Conviene fijarse en el /22: 10.10.4.0/22 cubre desde 10.10.4.0 hasta 10.10.7.255, es decir, cuatro /24 seguidos. El truco para no equivocarse es que la dirección de red tiene que ser múltiplo del tamaño del bloque en el octeto que se parte: un /22 solo puede empezar en .0, .4, .8, .12... del tercer octeto. 10.10.5.0/22 no es una red válida (su red real sería 10.10.4.0/22) y Proxmox lo rechaza al crear la subnet. En AWS y Azure, además, el proveedor se reserva cinco direcciones de cada subred, las cuatro primeras y la última, así que un /28 allí se queda en 11 hosts.
Para no calcular de cabeza. Una herramienta que conviene tener a mano es ipcalc (paquete ipcalc en Debian) o sipcalc. Da de un bloque su máscara, su primera y su última dirección y el número de hosts, que es justo lo que la A2.1 pide para justificar cada tamaño:
$ ipcalc 10.10.4.0/22
Address: 10.10.4.0 00001010.00001010.000001 00.00000000
Netmask: 255.255.252.0 = 22 11111111.11111111.111111 00.00000000
Network: 10.10.4.0/22 00001010.00001010.000001 00.00000000
HostMin: 10.10.4.1
HostMax: 10.10.7.254
Broadcast: 10.10.7.255
Hosts/Net: 1022 Class A, Private Internet
RFC 1918 y el problema del solapamiento
Qué rangos se pueden usar. Las direcciones públicas de Internet son únicas en el mundo y las reparten unos registros regionales; dentro de una organización no hacen falta, porque esas máquinas no se anuncian a Internet. La RFC 1918 (las RFC son los documentos que fijan los estándares de Internet), de 1996, reservó para ese uso tres rangos que nunca se enrutan en Internet y que cualquiera puede usar dentro de su red: 10.0.0.0/8 (16 millones de direcciones), 172.16.0.0/12 (de 172.16.0.0 a 172.31.255.255, un millón) y 192.168.0.0/16 (65 536). Junto con el NAT, la traducción de direcciones que hace el router al salir a Internet, son lo que ha permitido estirar las direcciones IPv4 mucho más allá de lo que daban de sí. Además existe 100.64.0.0/10 (RFC 6598), pensado para el CGNAT de los operadores (el NAT a gran escala que hacen los proveedores de fibra), que algunas empresas usan para redes de tránsito precisamente porque nadie lo pone en una oficina.
El problema: el solapamiento. El error clásico es elegir el rango sin pensar en el futuro. Dos redes que hoy están separadas pueden tener que hablarse mañana: dev con pre para promocionar una imagen, la VPC de la empresa con la del proveedor por VPN, una nube privada con AWS por peering. Si las dos usan 192.168.1.0/24 (y lo usan, es la red por defecto de medio mundo), una máquina de un lado que quiera hablar con 192.168.1.10 del otro lado no tiene forma de saber a cuál se refiere: la tabla de rutas le dice que esa red es local y el paquete nunca sale. La solución en ese momento es NAT doble (traducir un lado a un rango ficticio), y quien lo haya tenido que mantener no lo repite. Por eso:
- Un bloque distinto por entorno, sin solapar. En el curso:
10.10.0.0/16para dev,10.20.0.0/16para pre,10.30.0.0/16para pro. Los huecos entre medias (10.11 a 10.19) quedan para crecer. - Dentro de cada entorno, una subred por zona: front, back, data y gestión.
- Evitar
192.168.0.0/24,192.168.1.0/24,10.0.0.0/24y172.16.0.0/24.
Los cuatro rangos que no hay que usar nunca
Son los que trae por defecto cualquier router doméstico y casi cualquier VPN de teletrabajo. El día que
alguien se conecte desde casa a la VPN de la empresa, su router y la red de destino serán la misma red y
no habrá arreglo limpio. Elegir un bloque raro dentro de 10.0.0.0/8 evita ese problema.
flowchart TB
subgraph MAL["Si los dos eligen lo mismo"]
direction LR
E1["<b>Empresa A</b><br><small>192.168.1.0/24</small>"]:::riesgo
VPN1{{"<b>VPN</b><br><small>hay que unirlas</small>"}}:::pieza
E2["<b>Empresa B</b><br><small>192.168.1.0/24</small>"]:::riesgo
X["<b>192.168.1.10 es ambiguo</b><br><small>la tabla de rutas dice que es local:<br>el paquete no sale nunca</small>"]:::riesgo
E1 --- VPN1 --- E2
VPN1 --> X
end
subgraph BIEN["El plan del curso"]
direction LR
D["<b>dev</b><br><small>10.10.0.0/16</small>"]:::ok
P["<b>pre</b><br><small>10.20.0.0/16</small>"]:::ok
R["<b>pro</b><br><small>10.30.0.0/16</small>"]:::ok
H["<b>10.11 a 10.19</b><br><small>huecos para crecer</small>"]:::infra
D --- P --- R --- H
end
MAL ~~~ BIEN
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxElegir el rango es una decisión de dentro de cinco años. El día que haya que unir dos redes, o no se solapan o toca NAT doble.
Por qué /16 por entorno y /24 por subred
El tamaño del bloque. Un /16 son 65 534 hosts útiles y en dev habrá seis máquinas. Parece un desperdicio, pero el espacio privado no cuesta dinero y lo que sí cuesta es renumerar. Con un /16 hay 256 subredes /24 posibles por entorno, así que se puede dar una a cada zona, otra a cada zona de disponibilidad (front-a, front-b), otra a cada cliente si el entorno se vuelve multi-tenant (varios clientes sobre el mismo hardware), y aún sobran doscientas. Un /24 por subred da 254 hosts, más que suficiente para una zona, y tiene la ventaja de que se lee de un vistazo: en 10.10.2.37 se ve que es dev (10.10), back (.2) y un servidor fijo (.37) sin mirar ninguna tabla. Ese «se lee de un vistazo» es lo que salva al leer una captura de tráfico a las cinco de la tarde.
El reparto del curso. Este es el ejemplo usado en el curso (la A2.1 pide inventar uno propio). El segundo octeto es el entorno y el tercero, la zona: front, back y data llevan el 1, el 2 y el 3, en el orden en que las recorre una petición, y gestión, que no es de ninguna capa, se queda el 0.
| Entorno | Bloque | Gestión | Front | Back | Data |
|---|---|---|---|---|---|
| dev | 10.10.0.0/16 | 10.10.0.0/24 | 10.10.1.0/24 | 10.10.2.0/24 | 10.10.3.0/24 |
| pre | 10.20.0.0/16 | 10.20.0.0/24 | 10.20.1.0/24 | 10.20.2.0/24 | 10.20.3.0/24 |
| pro | 10.30.0.0/16 | 10.30.0.0/24 | 10.30.1.0/24 | 10.30.2.0/24 | 10.30.3.0/24 |
Dentro de cada /24. Una convención de direcciones que se repite en todas las subredes: .1 el router del entorno, que además hace de DNS y de DHCP; .2 a .9 reservadas para servicios de red, que en esta unidad no se usan; .10 a .99 servidores con IP fija (el DHCP les da siempre la misma, reservada por su MAC); .100 a .199 rango DHCP dinámico para máquinas de usar y tirar; .200 a .254 pruebas de un rato y direcciones que no son de una máquina concreta, como la de un balanceador. Conviene escribirla en la memoria y respetarla: la convención vale más que el rango concreto, porque es lo que permite saber qué es una dirección sin buscarla.
El número de la VM. Proxmox identifica cada VM por un número, que es lo que se teclea en cada orden qm. Conviene fijar su convención desde el primer día, porque un número que dice dónde vive la máquina hace que un ID equivocado salte a la vista: la centena es el entorno (1 dev, 2 pre, 3 pro) y la decena es la zona, con el mismo dígito que el tercer octeto de su subred (0 gestión, 1 front, 2 back, 3 data). Así 120 es app01 de dev, en back, con la 10.10.2.10, y 230 es db01 de pre, en data, con la 10.20.3.10. El router de cada entorno se queda con el primer número de la franja de gestión: 100, 200 y 300. Los nombres cortos se repiten en los tres entornos a propósito; lo que los distingue es el dominio y el ID. La tabla completa de máquinas y números está en las convenciones del laboratorio.
flowchart LR
INET(("<b>Internet</b><br><small>red del aula</small>")):::infra
subgraph DEV["dev · 10.10.0.0/16"]
RDEV["<b>router-dev</b><br><small>.0.1 / .1.1 / .2.1 / .3.1</small>"]:::act
MDEV["<b>gestión</b><br><small>devmgmt · 10.10.0.0/24</small>"]:::dato
FDEV["<b>front</b><br><small>devfront · 10.10.1.0/24 · web01</small>"]:::pieza
BDEV["<b>back</b><br><small>devback · 10.10.2.0/24 · app01</small>"]:::pieza
DDEV["<b>data</b><br><small>devdata · 10.10.3.0/24 · db01</small>"]:::dato
RDEV --- MDEV
RDEV --- FDEV
RDEV --- BDEV
RDEV --- DDEV
end
subgraph PRE["pre · 10.20.0.0/16"]
RPRE["<b>router-pre</b>"]:::act
FPRE["<b>front</b><br><small>prefront · 10.20.1.0/24</small>"]:::pieza
BPRE["<b>back</b><br><small>preback · 10.20.2.0/24</small>"]:::pieza
RPRE --- FPRE
RPRE --- BPRE
end
INET -- vmbr0 --> RDEV
INET -- vmbr0 --> RPRE
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxEntre dev y pre no hay ninguna línea, y eso es justo el aislamiento: no es una regla que prohíbe, es que no existe el camino.
A2.1 Diseño (sesión 7)
Objetivo Tener el plano de los tres entornos en papel, con una tabla de direccionamiento propia justificada. Es el ejercicio de diseño que pide el criterio de evaluación y el primer punto de la memoria de la práctica evaluable. El laboratorio se monta después con los rangos del curso, que son los que comparten las dos asignaturas, pero las decisiones son las mismas que tomas hoy: un bloque por entorno, una subred por zona y una convención para las direcciones y otra para los ID.
Antes de empezar
- Papel o una herramienta de dibujo (un diagrama Mermaid vale), el nodo de la UT1 para
ipcalcy tu equipo del aula congit. - Explicado en esta sesión: qué es una VPC y el diseño de direccionamiento, con el repaso de CIDR, la RFC 1918 y el reparto en /16 y /24.
Pasos
Vas a hacer el plano en el orden de la teoría: primero el dibujo, con las piezas de cada entorno; después los números, eligiendo los bloques y repartiéndolos; luego su justificación, y al final la comprobación de que no chocan con nada. El último paso no es de diseño: crea el repositorio donde vas a guardar el trabajo de las hojas, empezando por el de hoy.
-
Dibuja los tres entornos. Representa dev, pre y pro con sus cuatro zonas, el router de cada uno y los servicios de red que dará (DHCP, DNS y NAT), como el esquema de Por qué /16 por entorno y /24 por subred pero con tus nombres. Fíjate en lo que no tiene que haber: ninguna línea entre entornos, porque el aislamiento es que no exista el camino.
-
Elige tus bloques y rellena la tabla. Haz tu tabla de direccionamiento (entorno, bloque, gestión, front, back, data) con un bloque de la RFC 1918 distinto del ejemplo, y escribe en una línea por qué ese: que no choque con las redes que ya existen ni con las que podrían tener que unirse algún día, como explica el problema del solapamiento. Es solo el ejercicio de diseño: el laboratorio se monta con los rangos del ejemplo, que son los que usan las dos asignaturas.
-
Justifica cada tamaño. Para cada bloque y cada subred, su máscara, sus direcciones, sus hosts útiles y su broadcast, y por qué ese tamaño y no otro. Añade la convención de IP dentro de cada /24 y el rango de ID de VM por entorno, las dos del apartado de diseño: son las reglas que harán que una dirección o un número de VM digan dónde vive cada máquina.
-
Comprueba que nada se solapa. Con
ipcalcen el nodo, comprueba que ningún bloque se solapa con otro, ni entre entornos ni con la red del aula, que es la devmbr0. Un solapamiento con la red del aula no da error al crear nada: aparece semanas después, como una máquina a la que no se llega.Pista:
ipcalcno compara bloques; te da la primera y la última dirección de cada uno, y el solapamiento se ve al ponerlos en orden. -
Crea el repositorio de entregas. Crea en tu equipo del aula
entregas-5166, el repositorio Git donde guardas el trabajo de las hojas de esta asignatura, con una carpeta por hoja dentro deut2/(la de hoy,ut2/a21). De momento es local: el 6 de noviembre, en la A2.4, pasa al puesto de administración, y el 17 de noviembre recibe su remoto en el Gitea que monta la A2.6 de Mantenimiento.
Comprobación Ningún bloque se solapa entre sí ni con la red del aula, cada tamaño está justificado con el cálculo de hosts y git -C entregas-5166 status responde.
Para practicar Guarda en ut2/a21 de entregas-5166 el esquema y la tabla de direccionamiento con las justificaciones.
Sesión 8 · Crear la VPC dev con SDN
Con el plano hecho, toca construir la red de dev. En la UT1 se vio cómo se hace una red interna a mano: un bridge sin puerto físico en el /etc/network/interfaces del nodo. Eso sirve para una red, pero no para doce (cuatro zonas por tres entornos) que, además, en un clúster habría que repetir igual en cada nodo. Para eso Proxmox tiene el SDN: la red se describe una vez, en la configuración del clúster, y cada nodo la construye. La teoría va de lo general a lo concreto: qué es el SDN y sus tres objetos; por qué cada zona del diseño lleva su propia VNet; qué tipo de zona del SDN se elige y por qué; qué pasa por debajo al aplicar, que es donde se mira cuando algo falla; y el DHCP que trae el propio SDN, que da las primeras direcciones mientras el entorno no tiene router propio. La hoja crea la zona y las cuatro VNets de dev y conecta a ellas las dos primeras VM del servicio.
SDN en Proxmox
El problema. Una VNet de la VPC no es más que un bridge en el nodo, como los que ya se han creado a mano. Pero hacerlo así tiene dos pegas. Cada bridge se escribe en el fichero de red de un nodo, y en un clúster hay que repetirlo idéntico en todos, nodo a nodo; y nada lleva la cuenta de qué direcciones están dadas ni a quién. Un SDN (Software-Defined Network, red definida por software) resuelve las dos: la red se describe una sola vez, en un sitio central, y el software crea en cada nodo los bridges, las VLAN o los túneles que hagan falta y lleva el registro de las direcciones. Proxmox lo trae instalado de serie desde la versión 8.1, en Datacenter → SDN.
Tres objetos, de lo general a lo particular. La jerarquía tiene tres niveles y conviene tenerla clara:
- Zona: define el tipo de red y en qué nodos existe. Es el «cómo se transporta el tráfico».
- VNet: una red virtual dentro de la zona. Al crear una VM aparece en el desplegable de bridges como si fuera un
vmbrNmás. Es el «cable» al que se conecta la máquina. - Subnet: un rango CIDR dentro de la VNet, con gateway opcional, rango DHCP opcional y SNAT opcional.
Y dos servicios alrededor. Además hay dos objetos transversales: IPAM (gestión de direcciones IP: el registro de qué IP está asignada a quién; el que viene de serie se llama pve y guarda el estado en /etc/pve/priv/ipam.db) y DNS (integración con un servidor PowerDNS externo para que el IPAM registre nombres automáticamente; en el laboratorio del curso no se usa, porque los nombres los resuelve el router del entorno con dnsmasq).
Los apartados que siguen deciden cómo se usan esos objetos en el curso: cuántas VNets, de qué tipo de zona, qué ocurre al aplicar y quién reparte las direcciones.
Una VNet por zona, una subred por VNet
Dos significados de «zona». En el SDN, la zona es el tipo de red: el laboratorio tiene una sola, lab, de tipo Simple. En el diseño de la VPC, zona es cada una de las cuatro partes de un entorno: gestión, front, back y data. El título de este apartado habla de las segundas: las cuatro VNets de dev, una por zona del diseño, van todas dentro de la misma zona del SDN.
Por qué no una sola VNet con cuatro subredes. Proxmox admite varias subredes dentro de la misma VNet, pero no conviene aprovecharlo. Una VNet es un bridge, es decir, un único dominio de capa 2 (el trozo de red en el que las máquinas se encuentran directamente por su MAC, sin pasar por ningún router). Dos subredes en el mismo bridge comparten el mismo cable virtual: a una máquina le basta con ponerse una dirección de la otra subred para hablar con sus vecinas sin pasar por el router, y entonces ningún cortafuegos puede garantizar nada. Para filtrar entre dos redes, el tráfico tiene que pasar obligatoriamente por un router, y para eso cada red tiene que colgar de su propio bridge. Si las cuatro zonas de dev vivieran en una sola VNet, no habría dónde filtrar entre ellas.
Por eso cada entorno tiene cuatro VNets, una por zona, y cada VNet una sola subred. En dev quedan así:
| VNet | Subred | Zona |
|---|---|---|
devmgmt |
10.10.0.0/24 | gestión |
devfront |
10.10.1.0/24 | front |
devback |
10.10.2.0/24 | back |
devdata |
10.10.3.0/24 | data |
El nombre. Se forma juntando el entorno y la zona, sin guiones: devmgmt, devfront, devback, devdata, y lo mismo en los otros dos entornos (prefront, preback, proback, prodata...). No es una manía de estilo: el ID de una VNet, igual que el de una zona, admite como máximo ocho caracteres alfanuméricos, así que un nombre como vdev-front, con diez caracteres y un guion, Proxmox lo rechaza al crearlo.
Tipos de zona y cuándo usar cada uno
Qué decide el tipo de zona. En un solo nodo, cualquier VNet acaba siendo un bridge y el tipo de zona apenas se nota. La diferencia aparece con varios nodos: una VM del nodo 1 y otra del nodo 2 conectadas a la misma VNet tienen que verse, y su tráfico tiene que viajar entre los nodos por la red física, mezclado con el de las demás VNets sin confundirse con él. Cada tipo de zona resuelve ese transporte de una manera:
| Zona | Cómo funciona | Alcance | Cuándo |
|---|---|---|---|
| Simple | Crea un bridge Linux sin interfaz física por cada VNet. Aislado. Puede hacer SNAT hacia fuera. | Un nodo (las VM de otro nodo no ven la red) | Laboratorio de un solo nodo, redes de pruebas, lo que se usa en la A2.2 |
| VLAN | Cada VNet es un tag 802.1Q sobre un bridge físico existente (vmbr0). El switch físico tiene que dejar pasar esas VLAN. | Todo el clúster, si el switch está configurado | Empresa pequeña con switches gestionables; lo más habitual en producción on-premise |
| QinQ | VLAN dentro de VLAN (802.1ad). Una VLAN de servicio por zona y VLAN de cliente por VNet. | Clúster | Proveedores que necesitan más de 4094 segmentos o aislar clientes que a su vez usan VLAN |
| VXLAN | Encapsula tramas Ethernet en UDP (puerto 4789) entre los nodos. No necesita nada del switch físico. | Clúster (túnel entre las IP de los nodos) | Clúster de varios nodos sin control sobre la red física; nube |
| EVPN | VXLAN más BGP (el protocolo de enrutado de Internet, aquí hablado por el software FRR) para anunciar MAC e IP entre nodos, con enrutado distribuido: cada nodo es gateway de sus VM. | Clúster, y puede salir a routers externos | Cuando se quiere que el SDN enrute entre VNets sin una VM router; es lo más parecido a una VPC de nube |
El criterio. Elegir bien la zona es la decisión más importante de esta unidad y la que menos se puede deshacer, porque cambiar de zona implica recrear las VNets. El criterio habitual: Simple en un laboratorio de un solo nodo y sin control del switch, que es el caso del curso; en una empresa con dos o tres nodos y switches propios, VLAN, que es lo que el equipo de redes ya entiende; VXLAN cuando los nodos están en sitios distintos o la red física no es propia; EVPN solo cuando de verdad haga falta que el enrutado sea distribuido, porque añade BGP y FRR a la ecuación y eso se depura peor.
VLAN 802.1Q frente a VXLAN
Los dos tipos de zona que se usan fuera del laboratorio llevan varias redes por el mismo cable de dos maneras distintas: la VLAN, la misma de la A1.5, etiqueta la trama Ethernet y necesita que cada switch del camino conozca la etiqueta; VXLAN envuelve la trama entera dentro de un paquete UDP/IP, atraviesa routers y no exige nada al switch. La comparación completa (tamaño del identificador, coste de proceso y cuándo se elige cada una) está en VLAN frente a VXLAN. Del lado práctico solo hay que retener una consecuencia: esa envoltura añade unos 50 bytes, así que con VXLAN la MTU (el tamaño máximo de paquete que admite una interfaz) de las VM baja a 1450 si la red física va a 1500.
Si se olvida la MTU, el fallo no parece de red
Los ping pequeños funcionan y las transferencias grandes se cuelgan sin dar error. Es el síntoma más
engañoso de la unidad: parece el disco, parece la aplicación, y es la MTU. Ante una transferencia que se
para, conviene comparar dos ping con la fragmentación prohibida: ping -M do -s 1400, que cabe aunque
haya cabecera de VXLAN, y ping -M do -s 1472, que es un paquete de 1500 bytes justos. Si el primero
llega y el segundo no, es la MTU.
Qué hace Apply por debajo
Escribir no es aplicar. La configuración del SDN se escribe en /etc/pve/sdn/ (ficheros zones.cfg, vnets.cfg, subnets.cfg), que está en el sistema de ficheros del clúster y por tanto se replica a todos los nodos. Pero escribir ahí no cambia nada en la red: hasta que se aplica, la consola muestra los cambios como pendientes, y así se pueden preparar varios y aplicarlos juntos. Al pulsar Apply (o pvesh set /cluster/sdn), cada nodo genera el fichero /etc/network/interfaces.d/sdn con los bridges, VLAN o túneles VXLAN que le tocan y ejecuta ifreload -a (de ifupdown2, la herramienta que gestiona las interfaces de red en Proxmox), que aplica los cambios sin reiniciar la red.
flowchart TB
WEB["<b>Apply</b><br><small>en la web o pvesh set /cluster/sdn</small>"]:::act
CFG["<b>/etc/pve/sdn/</b><br><small>zones.cfg · vnets.cfg · subnets.cfg<br>replicado a todos los nodos</small>"]:::dato
GEN["<b>Cada nodo genera lo suyo</b><br><small>/etc/network/interfaces.d/sdn</small>"]:::pieza
IFR["<b>ifreload -a</b><br><small>aplica sin reiniciar la red</small>"]:::act
RED(["<b>Bridges, VLAN o túneles en marcha</b>"]):::ok
CFG -. "escribir aquí solo<br>no cambia nada" .-> GEN
WEB --> CFG
WEB --> GEN --> IFR --> RED
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxLa configuración vive en el clúster; la red de verdad la levanta cada nodo al aplicar.
Lo que queda en el nodo. Un ejemplo de lo que aparece para una zona Simple con la VNet devfront; las otras tres salen igual, cada una con su nombre y su alias:
Si la subnet lleva gateway, como en la A2.2, el bloque tiene además una línea address 10.10.1.1/24: es el .1 que el nodo se pone en ese bridge para hacer de router de la subred, y es lo que hay que quitar cuando el entorno tiene su propio router.
Si Apply no hace nada. Si en /etc/network/interfaces no está la línea source /etc/network/interfaces.d/* (viene en instalaciones nuevas, pero no siempre en las actualizadas desde versiones antiguas), Apply dirá que todo va bien y no habrá ningún bridge. Es la primera cosa que se comprueba cuando "el SDN no hace nada".
DHCP e IPAM integrados
Qué aporta. Una VNet recién creada es solo un cable: las VM que se conectan a ella no reciben dirección de nadie. Desde Proxmox 8.1, una zona puede llevar DHCP: dnsmasq. Proxmox arranca entonces una instancia de dnsmasq por zona (unidad dnsmasq@<zona>.service, configuración en /etc/dnsmasq.d/<zona>/) que escucha en las VNets de esa zona y entrega las IP que el IPAM ha reservado para cada VM. Con una zona Simple y la subnet de devfront con gateway 10.10.1.1 y rango DHCP 10.10.1.100-10.10.1.199, al conectar una VM a devfront (al crearla o al cambiarle el bridge) el IPAM le reserva una IP libre del rango y la ata a su MAC, y cuando la VM arranca, dnsmasq se la sirve. El gateway .1 lo pone Proxmox en el propio bridge del nodo, así que el nodo es el router de esa subred; si además se marca SNAT en la subnet, el nodo cambia la dirección de origen de las VM por la suya al salir, que es lo que se llama NAT de origen, y las VM tienen Internet sin ninguna VM router.
Lo que necesita el nodo. Para que funcione hace falta el paquete dnsmasq instalado en el nodo pero con la unidad genérica deshabilitada, porque si no compite con las instancias por zona:
Por qué es provisional. Es cómodo, y para probar es perfecto, pero se queda corto para un entorno de verdad, por razones prácticas y didácticas a la vez: el DHCP del SDN no hace DNS con nombres propios ni deja tocar opciones finas; con él, el nodo, que es el hipervisor de todo el laboratorio, hace además de router de los entornos; y el router del entorno es donde van a vivir las reglas de cortafuegos entre zonas. Por eso, el 4 de noviembre, se sustituye por una VM router propia, router-dev. Ese relevo tiene un paso obligatorio: al montar el router hay que quitar el gateway y el rango DHCP de las subredes del SDN, porque el .1 de una subred solo puede estar en un sitio. Entender qué hace el SDN por debajo (un bridge con el .1, un dnsmasq por zona y una regla de NAT) es lo que permite arreglarlo cuando falla.
Alternativa sin SDN
Lo que existía antes del SDN sigue funcionando y es lo mismo hecho a mano: en /etc/network/interfaces un bridge sin bridge-ports (sin interfaz física, por tanto aislado dentro del nodo) por cada zona, vmbr10 para gestión, vmbr11 para front, vmbr12 para back y vmbr13 para data, y una VM router con una pata en cada uno de ellos y otra en vmbr0 que hace DHCP, DNS y NAT. Si el SDN da guerra, esto es el plan B y es equivalente para la práctica evaluable.
A2.2 Crear la VPC dev con SDN (sesión 8)
Objetivo Tener las cuatro VNets de dev funcionando en el SDN, una por zona, con dos VM de zonas distintas que reciben IP de su subred. Es la primera vez que una VM sale de la red del aula, y estas cuatro VNets son las que usa dev hasta el final del curso: a ellas se conectan después el router del entorno, el cortafuegos y, el 27 de noviembre, app01 y mon01.
Antes de empezar
- El nodo de la UT1 con la plantilla 9000, la consola web como
root@pamy una sesión SSH contra él. - Los rangos de dev son los de las convenciones del laboratorio, no los de tu tabla de la A2.1.
web01(110),app01ymon01existen desde la A1.3, envmbr0. Hoyweb01pasa a la VPC;app01ymon01se quedan, porque Mantenimiento las usa a diario: las traslada la A3.3 el 27 de noviembre, ya con cortafuegos.- Explicado en esta sesión: zonas, VNets y subnets del SDN, una VNet por zona, el tipo de zona, qué hace Apply y el DHCP integrado.
Pasos
Vas a construir la red en el orden de los objetos del SDN, de lo general a lo particular: primero preparas el nodo para que pueda dar DHCP, después creas la zona, dentro de ella las VNets y en cada VNet su subred, y solo entonces aplicas, porque hasta ese momento nada existe en la red. Con la red en marcha conectas las dos primeras VM y compruebas, desde ellas y desde el IPAM, que cada una ha recibido una dirección de su propia subred.
-
Prepara el nodo para dar DHCP. El DHCP del SDN arranca un dnsmasq propio por zona, así que el paquete tiene que estar instalado en el nodo y su servicio genérico, parado, para que no compita con él, como dice DHCP e IPAM integrados.
-
Crea la zona
lab. En Datacenter → SDN, una zona Simple con IDlab, DHCPdnsmasqe IPAMpve. Simple, porque el laboratorio es un solo nodo sin control del switch (tipos de zona). Es la zona de los tres entornos durante todo el curso. -
Crea las cuatro VNets de dev. En la zona
lab, una VNet por zona del diseño:devmgmt,devfront,devbackydevdata, con los aliasdev gestion,dev front,dev backydev data. Los nombres no se eligen: son los de las convenciones del laboratorio, y caben en los ocho caracteres que admite Proxmox. -
Dale a cada VNet su subred. Una sola por VNet: el /24 de su zona, con gateway en el
.1y rango DHCP de.100a.199, que es la franja dinámica de la convención. Hoy los sirve el nodo; el 4 de noviembre pasan al router del entorno. -
Aplica y comprueba lo que ha hecho Apply. Aplica la configuración y comprueba en el nodo las tres cosas que tiene que haber dejado Apply: los cuatro bridges, su definición en
/etc/network/interfaces.d/sdnydnsmasq@laben marcha. Ese fichero es una de las evidencias de la memoria de la evaluable. -
Conecta las dos primeras VM. Conecta a la VPC sus dos primeras VM de servicio, las dos con IP por DHCP:
web01(110) adevfront, ydb01(130), que nace hoy de la plantilla con 2 GB, adevdata. Busca en Datacenter → SDN → IPAM la IP que ha recibido cada una, entra por SSH desde el nodo y guarda suip ay suip r: tienen que coincidir con lo que dice el IPAM, y la ruta por defecto, apuntar al.1de su subred.Pista:
web01no se clona otra vez: apágala, cámbiale el bridge conqm sety arráncala. Desde el nodo entras conssh ops@<IP>, porque hoy es el.1de cada subred y su clave va en la plantilla.
Comprobación ip -br link show type bridge lista las cuatro VNets: devfront y devdata, que ya tienen una VM conectada, en UP, y devmgmt y devback en DOWN mientras no se les conecte nada, que es lo normal en un bridge vacío; web01 tiene una IP del rango 10.10.1.100 a 10.10.1.199 con gateway 10.10.1.1, y db01 una de 10.10.3.100 a 10.10.3.199 con gateway 10.10.3.1, cada una de su propia subred; el IPAM lista las dos VM con su MAC e IP; cada VM hace ping a su .1. Que web01 alcance a db01 no es cosa de hoy: eso lo hace el router del entorno, que llega el 4 de noviembre. Si una VM no coge IP, journalctl -u dnsmasq@lab -f en el nodo mientras la reinicias enseña el DORA o su ausencia.
Para practicar Guarda en ut2/a22 de tu repositorio una captura del SDN aplicado con las cuatro VNets, el contenido de /etc/network/interfaces.d/sdn y la salida de ip a de las dos VM.
Si te sobra tiempo Marca SNAT en la subnet de devfront, aplica, y comprueba desde web01 que ping -c 3 deb.debian.org sale a Internet sin ninguna VM router.
Sesión 9 · DHCP y DNS propios
Con el DHCP del SDN, web01 y db01 tienen dirección, pero se la da el nodo: una cualquiera del rango, que puede cambiar, sin un nombre que la resuelva y con el propio hipervisor haciendo de router de las subredes. Un entorno de verdad necesita una máquina suya que haga cuatro trabajos: encaminar el tráfico entre las cuatro zonas, sacarlo a Internet, dar a cada servidor siempre la misma dirección y resolver los nombres de todos. Es el router del entorno, router-dev. La teoría sigue el orden en que se monta: primero la VM con una pata en cada VNet y el reenvío IP, que la convierte en router; después la diferencia entre enrutar y hacer NAT, que decide qué tráfico se traduce y cuál no; y al final dnsmasq, que reparte direcciones y nombres. La hoja retira el DHCP del SDN y monta router-dev en ese mismo orden.
Servicios de red: enrutado, NAT, DHCP y DNS
Cuatro servicios en una máquina. Una VNet es un cable. Lo que la convierte en una red utilizable son cuatro servicios: alguien que encamine el tráfico entre subredes, alguien que lo traduzca al salir a Internet, alguien que reparta direcciones (el DHCP) y alguien que convierta nombres en direcciones (el DNS). Con el SDN, el nodo hacía dos, el gateway y el DHCP. Desde hoy los cuatro los hace una VM por entorno, y este apartado la monta pieza a pieza. Es el apartado con más configuración de la unidad; la A2.4 y la A2.5 salen de aquí.
Router de entorno
Por qué una VM y no el nodo. El nodo podría seguir siendo el router de las subredes, como hasta ahora, pero entonces el hipervisor de todo el laboratorio sería también la puerta de cada entorno, y un error en su configuración de red afectaría a la vez a todos los entornos y al propio nodo. Una VM por entorno separa los papeles: se puede reiniciar, romper o sustituir sin tocar el nodo ni los otros entornos, y es lo que tiene una VPC de nube pública, un router propio por red. El 20 de noviembre, al empezar la unidad de seguridad por capas, su sitio lo ocupa un cortafuegos, OPNsense, con las mismas direcciones.
Una pata en cada VNet. El router es una VM Debian 13 clonada de la plantilla, con una interfaz por VNet y otra hacia el exterior. Cada pata cuelga de un bridge distinto, y eso es justo lo que permite filtrar entre zonas: el tráfico de una zona a otra solo puede ir de una pata a otra atravesando el router. En Proxmox las interfaces virtio (las tarjetas de red paravirtualizadas, las más rápidas para una VM) aparecen dentro de la VM como ens18, ens19, ens20... en el orden de net0, net1, net2. El número no es casual: Linux nombra cada tarjeta por la ranura PCI en la que la encuentra, y Proxmox pone net0 en la ranura 18 de la placa virtual, net1 en la 19, y así sucesivamente. Convención del curso: ens18 exterior (vmbr0, IP del aula por DHCP), ens19 gestión (devmgmt, .0.1), ens20 front (devfront, .1.1), ens21 back (devback, .2.1) y ens22 data (devdata, .3.1).
El .1 solo puede estar en un sitio. El router es el .1 de las cuatro subredes, y es el único: por eso, antes de que dnsmasq entre en juego, hay que quitar el gateway y el rango DHCP que el SDN puso en cada subred. Si se dejan, en cada red hay dos máquinas que dicen ser el .1 (el nodo y el router) y dos servidores DHCP repartiendo; las VM cogen una oferta u otra según quién conteste antes y la red se vuelve impredecible.
flowchart LR
AULA(("<b>Red del aula</b><br><small>vmbr0</small>")):::infra
R["<b>router-dev</b><br><small>Debian 13 · net.ipv4.ip_forward = 1</small>"]:::act
G["<b>gestión</b><br><small>devmgmt · 10.10.0.0/24 · .0.1</small>"]:::pieza
F["<b>front</b><br><small>devfront · 10.10.1.0/24 · .1.1 · web01</small>"]:::pieza
B["<b>back</b><br><small>devback · 10.10.2.0/24 · .2.1 · app01</small>"]:::pieza
D["<b>data</b><br><small>devdata · 10.10.3.0/24 · .3.1 · db01</small>"]:::pieza
AULA -- "ens18 · DHCP" --- R
R -- "ens19" --- G
R -- "ens20" --- F
R -- "ens21" --- B
R -- "ens22" --- D
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxUna pata por VNet, en el orden de net0, net1, net2… Sin el reenvío activado, el router acepta lo suyo y tira el resto: front y back no se hablan.
El reenvío IP. Por defecto, un Linux se comporta como un equipo final, no como un router: acepta los paquetes dirigidos a una de sus direcciones y descarta los que van a otra máquina. Para que reenvíe de una red a otra hay que activar el reenvío IP, que en Debian viene apagado. Sin él, front y back no se hablan aunque el router tenga pata en las dos. El fichero de /etc/sysctl.d/ hace que el cambio sobreviva al reinicio, y sysctl --system lo aplica en el momento:
Cómo encamina. Con el reenvío activo, el router ya encamina entre sus cuatro redes, porque todas son redes directamente conectadas: cuando web01 (10.10.1.10) manda un paquete a db01 (10.10.3.10), su tabla de rutas dice que 10.10.3.0/24 no es local y lo envía al gateway 10.10.1.1; el router mira su tabla, ve que 10.10.3.0/24 está en ens22 y lo reenvía. No hace falta añadir ninguna ruta: un router conoce sin más las redes a las que está conectado. Las rutas estáticas aparecen cuando una máquina tiene que llegar a una red que no es la suya por un camino que no es su ruta por defecto.
Enrutar frente a hacer NAT
Dos operaciones distintas. Se confunden mucho. Enrutar es reenviar el paquete sin tocarlo: la IP de origen que ve db01 es la de web01, y db01 puede responder porque tiene ruta de vuelta. NAT (traducción de direcciones) es reescribir la IP de origen (SNAT, o su variante masquerade) o la de destino (DNAT) al pasar por el router. Nació a mediados de los noventa como remedio provisional al agotamiento de las direcciones IPv4, el mismo problema que llevó a la RFC 1918: dentro, direcciones privadas; en el borde, una sola pública que las representa a todas. Para que la respuesta vuelva, el router apunta cada conexión traducida en su tabla de seguimiento de conexiones (conntrack) y, cuando llega la respuesta, deshace el cambio y se la entrega a la VM que la pidió.
Dónde se hace cada una. Dentro de un entorno se enruta, nunca se hace NAT: las zonas tienen que ver la IP real de quien las llama; si no, los logs de la base de datos dirán que todas las conexiones vienen del router, y ningún cortafuegos podrá distinguir front de back. NAT se hace en el borde, hacia fuera, por dos razones: la red del aula (o Internet) no sabe volver a 10.10.0.0/16, y no conviene que desde fuera se sepa cómo es la red por dentro. En nube pública es lo mismo: dentro de la VPC todo se enruta, y solo el NAT Gateway o el Internet Gateway traducen.
flowchart TB
subgraph DENTRO["Dentro del entorno: se enruta"]
direction LR
W["<b>web01</b><br><small>10.10.1.10</small>"]:::pieza
RT["<b>router</b><br><small>reenvía sin tocar</small>"]:::act
DB["<b>db01 ve 10.10.1.10</b><br><small>la IP real de quien llama</small>"]:::ok
W --> RT --> DB
end
subgraph FUERA["Hacia fuera: se hace NAT"]
direction LR
W2["<b>web01</b><br><small>10.10.1.10</small>"]:::pieza
RT2["<b>router</b><br><small>masquerade en ens18</small>"]:::act
NET["<b>El aula ve la IP del router</b><br><small>no sabría volver a 10.10.0.0/16</small>"]:::infra
W2 --> RT2 --> NET
end
DENTRO ~~~ FUERA
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxSi se hace NAT dentro, los registros de db01 dirán que todas las conexiones vienen del router, y ningún cortafuegos podrá distinguir front de back.
El NAT de salida, con nftables. nftables es el cortafuegos del kernel de Linux y lo que trae Debian 13 (iptables sigue existiendo, pero en Debian es una capa de compatibilidad que traduce sus órdenes a nftables). Sus reglas se agrupan en tablas y cadenas, y cada cadena se engancha en un punto del recorrido del paquete por el kernel. El NAT de salida va en postrouting, el último punto antes de que el paquete salga, cuando ya se sabe por qué interfaz lo hace:
nft add table ip nat
nft add chain ip nat postrouting '{ type nat hook postrouting priority 100 ; }'
nft add rule ip nat postrouting oifname "ens18" masquerade
masquerade es un SNAT que usa la IP que tenga la interfaz de salida en ese momento, útil cuando ens18 la recibe por DHCP.
Que dure. Las órdenes nft cambian las reglas en memoria, y un reinicio las borra. Para que duren se guardan en /etc/nftables.conf, que el servicio nftables carga en cada arranque. Lo más cómodo es volcar lo que hay en memoria, conservando al principio la línea flush ruleset del fichero que trae Debian, que vacía las reglas antes de cargar las del fichero (sin ella, cada recarga añade otra copia de la regla):
dnsmasq: DHCP y DNS en uno
Qué es y por qué este. dnsmasq es un servidor DHCP y un DNS cacheador (guarda las respuestas que obtiene de otros servidores para no repetir la pregunta) en un solo binario de medio megabyte, y es lo que hay dentro de casi todos los routers domésticos, de OpenWrt, de libvirt y del propio SDN de Proxmox. Para una VPC de laboratorio es la herramienta correcta: hace DHCP con opciones por subred, sirve nombres para las máquinas internas y reenvía el resto a un DNS público. En una empresa grande lo sustituyen un servidor DHCP dedicado y un DNS propio o gestionado, pero los conceptos son los mismos.
El fichero de dev. Se instala con apt install dnsmasq en la VM router y toda la configuración va en /etc/dnsmasq.d/. Este es el fichero del entorno dev, comentado línea a línea. Conviene fijarse sobre todo en tres bloques: las interfaces en las que escucha, los rangos DHCP con su etiqueta por subred y las reservas por MAC; el resto son opciones de DNS que se explican justo después:
# /etc/dnsmasq.d/dev.conf
# Escuchar solo en las patas internas, nunca en la exterior
interface=ens19
interface=ens20
interface=ens21
interface=ens22
bind-interfaces
# DNS: dominio interno y resolución de nombres
domain=dev.lab
local=/dev.lab/
expand-hosts
no-resolv
server=1.1.1.1
server=9.9.9.9
dhcp-authoritative
# DHCP: un rango por subred, cada uno con su etiqueta (tag)
dhcp-range=set:mgmt,10.10.0.100,10.10.0.199,12h
dhcp-option=tag:mgmt,option:router,10.10.0.1
dhcp-range=set:front,10.10.1.100,10.10.1.199,12h
dhcp-option=tag:front,option:router,10.10.1.1
dhcp-range=set:back,10.10.2.100,10.10.2.199,12h
dhcp-option=tag:back,option:router,10.10.2.1
dhcp-range=set:data,10.10.3.100,10.10.3.199,12h
dhcp-option=tag:data,option:router,10.10.3.1
# Opciones comunes: DNS y dominio de búsqueda para todos
dhcp-option=option:dns-server,10.10.0.1
dhcp-option=option:domain-search,dev.lab
# Reservas por MAC: siempre la misma IP y nombre
dhcp-host=bc:24:11:aa:bb:cc,web01,10.10.1.10
dhcp-host=bc:24:11:aa:bb:dd,app01,10.10.2.10
dhcp-host=bc:24:11:aa:bb:ee,db01,10.10.3.10
dhcp-host=bc:24:11:aa:bb:ff,mon01,10.10.0.20
# Registros DNS que no son máquinas con DHCP
address=/api.dev.lab/10.10.1.10
host-record=lb.dev.lab,10.10.1.200
# Logs (quitar en producción; en clase interesa dejarlos)
log-dhcp
log-queries
Qué hace cada bloque.
- Las interfaces.
interface=ybind-interfaceshacen que dnsmasq atienda solo en las cuatro patas internas. Si escuchara también enens18, contestaría a las consultas de DNS de cualquier equipo del aula, que no tiene por qué ver los nombres de dev. - Los tags.
dhcp-range=set:front,...etiqueta confronta cualquier cliente que reciba IP de ese rango, ydhcp-option=tag:front,...aplica esa opción solo a los etiquetados. Así cada subred recibe su propio router (.1) aunque el DNS sea el mismo para todas. dnsmasq elige el rango por la interfaz de llegada de la petición DHCP, por eso da igual que las cuatro subredes estén en el mismo fichero. - Las opciones comunes. El router va en la opción de cada tag, pero el DNS y el dominio de búsqueda son los mismos para todas las subredes: la
10.10.0.1. Cualquier dirección del router serviría, porque es la misma máquina, y una sola hace que todas las VM tengan el mismo servidor en su configuración. El dominio de búsqueda es lo que permite escribirdb01a secas: el cliente le añade.dev.labantes de preguntar. - Las reservas (
dhcp-host). La MAC de una VM de Proxmox se ve en el hardware de la VM o conqm config 110 | grep net0. El prefijobc:24:11, los tres primeros bytes de la MAC, identifica al fabricante y es el que usa Proxmox por defecto. Al reservar, la IP queda fuera del rango dinámico (.10, no.100) para que no haya conflicto. Cuando la VM recoge su concesión, dnsmasq da de alta además su nombre en el DNS con esa IP, y por eso los nombres deapp01ymon01no resuelven todavía: sus reservas están para cuando lleguen a la VPC. El 20 de noviembre, el cortafuegos que sustituye arouter-devlas copia de este fichero. domainyexpand-hosts.domain=dev.labhace dos cosas: se lo da a los clientes como su dominio y se lo añade a los nombres que llegan por DHCP, así queweb01responde también comoweb01.dev.lab.expand-hostshace lo mismo con los nombres que haya en el/etc/hostsdel propio router, que sin esa línea solo responderían por su nombre corto.local=/dev.lab/dice que dnsmasq es autoritativo para ese dominio y no reenvía preguntas sobre él a losserver=. Sin esta línea, preguntar pornoexiste.dev.labacabaría en Cloudflare, con la latencia y la fuga de información que eso supone.no-resolvevita que dnsmasq lea/etc/resolv.confdel propio router, que en Debian con DHCP enens18apunta al DNS del aula. Aquí interesa el control explícito: lo que no es dedev.labva solo a los dosserver=, dos DNS públicos por si uno falla.- Los registros sueltos.
address=/api.dev.lab/10.10.1.10da un nombre más a una dirección que ya tiene otro:api.dev.labes el nombre del servicio y apunta aweb01porque el servicio se va a publicar a través de su nginx; responde además a cualquier nombre que acabe enapi.dev.lab.host-recordcrea un registro suelto, con su resolución inversa: aquí, la dirección reservada para un balanceador. dhcp-authoritativele dice a dnsmasq que es el único servidor DHCP de esas redes. Importa cuando un cliente pide seguir con una concesión que dnsmasq no tiene apuntada, porque se la dio otro servidor (el del SDN, por ejemplo) o porque el router ha perdido su fichero de concesiones. Sin esa línea, dnsmasq la trata como ajena: si la petición llega a toda la red, como cuando el cliente arranca, no contesta, y el cliente espera hasta rendirse y empezar de cero; si llega dirigida a él, la rechaza. Con ella, la acepta en el acto si la dirección es válida para ese cliente, y solo la rechaza (con un NAK) si no lo es. Solo se pone cuando dnsmasq es de verdad el único servidor de la red: otra razón para retirar antes el del SDN.- Los logs.
log-dhcpylog-queriesescriben en el journal cada fase del DHCP y cada consulta de DNS. En el laboratorio interesan para ver qué pasa; en producción se quitan, porque llenan el disco y dejan escrito qué consulta cada máquina.
Ponerlo en marcha. Se comprueba la sintaxis y se aplica con:
Dónde mirar cuando una VM no tiene IP. Las concesiones activas están en /var/lib/misc/dnsmasq.leases (una línea por cliente: expiración en epoch, o segundos desde 1970, MAC, IP, nombre, client-id). Es el primer sitio al que mirar cuando "esta VM no tiene IP". Con log-dhcp el diálogo completo queda en el journal:
dnsmasq-dhcp[612]: DHCPDISCOVER(ens20) bc:24:11:aa:bb:cc
dnsmasq-dhcp[612]: DHCPOFFER(ens20) 10.10.1.10 bc:24:11:aa:bb:cc
dnsmasq-dhcp[612]: DHCPREQUEST(ens20) 10.10.1.10 bc:24:11:aa:bb:cc
dnsmasq-dhcp[612]: DHCPACK(ens20) 10.10.1.10 bc:24:11:aa:bb:cc web01
Las cuatro fases (Discover, Offer, Request, Ack; DORA) son el intercambio con el que un cliente consigue su dirección: pregunta a toda la red quién reparte (Discover), un servidor le ofrece una dirección (Offer), el cliente la pide formalmente (Request) y el servidor la confirma (Ack). Si aparece Discover sin Offer, dnsmasq no tiene rango para esa interfaz o no escucha en ella. Si aparece Offer sin Request, el cliente no ha recibido la oferta (normalmente un firewall o un bridge mal conectado). Si aparece un NAK, la IP que pide el cliente no cuadra con el rango.
sequenceDiagram
participant W as web01 (cloud-init)
participant R as router-dev (dnsmasq)
participant D as 1.1.1.1
W->>R: DHCPDISCOVER (broadcast, ens20)
R->>W: DHCPOFFER 10.10.1.10, router .1.1, dns .0.1
W->>R: DHCPREQUEST 10.10.1.10 hostname=web01
R->>W: DHCPACK (12h) y alta de web01.dev.lab
W->>R: DNS A db01.dev.lab?
R->>W: 10.10.3.10 (local, autoritativo)
W->>R: DNS A deb.debian.org?
R->>D: reenvío
D->>R: 151.101.x.x
R->>W: respuesta cacheadaEl router del entorno responde lo suyo y reenvía el resto: db01.dev.lab sale de su propia tabla y deb.debian.org va a 1.1.1.1 y se queda en la caché.
Del lado de las VM. No hay que hacer nada especial: los clones de la plantilla 9000 llevan ip=dhcp en cloud-init, así que en cada arranque piden dirección, mandan su nombre de host (el --name del clon) en la petición y reciben el DNS y el dominio de búsqueda. El resultado es que web01 resuelve db01.dev.lab y db01 a secas sin que nadie haya tocado /etc/hosts. Cuando una tarjeta necesita IP fija, como las patas internas del propio router, se le da con su --ipconfigN (para net2, la pata de front, --ipconfig2 ip=10.10.1.1/24), y el DNS de la VM se fija con --nameserver. En el router ese DNS es uno público, 1.1.1.1, y no el suyo: la primera vez que arranca, su dnsmasq todavía no existe, y necesita resolver nombres para instalarlo.
A2.3 DHCP y DNS propios (sesión 9)
Objetivo Que la VM router-dev, con una pata en cada VNet y dnsmasq, reparta IP, gateway y DNS a las VM de dev en lugar del SDN, con reserva por MAC para web01 y db01 y el nombre api.dev.lab resolviendo. Desde hoy cada máquina de dev tiene una dirección que no cambia y un nombre, que es lo que necesitan las reglas de un cortafuegos; y lo que dejas en dev.conf (reservas y nombres) es lo que copia el cortafuegos que sustituye a router-dev el 20 de noviembre.
Antes de empezar
- La zona
laby las cuatro VNets de la A2.2 aplicadas, conweb01endevfrontydb01endevdatafuncionando. - Los rangos de dev del curso a mano: aquí se usan el
.1de cada subred y las IP fijas del rango.10a.99. - Explicado en esta sesión: el router de entorno, enrutar frente a hacer NAT y dnsmasq.
Pasos
El orden lo marca el .1. Primero lo dejas libre, retirando del SDN el gateway y el DHCP; después creas la máquina que lo ocupa; luego la conviertes en router (reenvío y NAT) y, ya con salida a Internet, le instalas dnsmasq, que reparte direcciones y nombres. Al final compruebas el resultado desde los clientes: primero el DORA en el journal del router, después la resolución y la salida desde web01.
-
Deja libre el
.1. Desde hoy el gateway y el DHCP de dev son del router, así que retíralos del SDN: deja las cuatro subnets de dev sin rango DHCP, sin gateway y sin SNAT, y aplica. Tiene que ser lo primero: si queda alguno, en cuanto arranque el router habrá dos.1o dos DHCP en la misma red. -
Crea
router-dev. VM 100, 512 MB y DNS1.1.1.1, con cinco tarjetas en este orden:net0envmbr0por DHCP ynet1anet4endevmgmt,devfront,devbackydevdata, cada una con el.1de su subred fijo. Ese orden da en la VM los nombresens18aens22que usadev.conf, y el DNS público es el que le deja instalar paquetes antes de tener el suyo.Pista: cada
--netNva con su--ipconfigN, por ejemplo--net2 virtio,bridge=devfront --ipconfig2 ip=10.10.1.1/24. -
Conviértelo en router. Activa el reenvío IP y el NAT de salida por
ens18, los dos persistentes, como en router de entorno y enrutar frente a hacer NAT. Con eso las cuatro zonas se alcanzan entre sí y salen a Internet, que es lo que necesitan las VM para instalar lo que usan los pasos siguientes.Pista: entras desde el nodo por SSH a la IP que el DHCP del aula le da en
ens18. -
Monta dnsmasq. Instálalo en el router con el
dev.confde dnsmasq: DHCP y DNS en uno, tal cual salvo las MAC de las cuatro reservas, y arráncalo con la sintaxis comprobada y el journal abierto. Las reservas son cuatro, no dos:app01(10.10.2.10, en back) ymon01(10.10.0.20, en gestión) siguen en el bridge del aula, pero la A3.3 las traslada a esta VPC el 27 de noviembre con su misma MAC y una sola tarjeta, y al llegar tienen que recibir su IP y seguir llamándose igual.Pista: la MAC de cada VM está en la línea
net0deqm config <ID>, en el nodo:web01es la 110,app01la 120,db01la 130 ymon01la 103. -
Sigue el DORA de cada VM. Reinicia
web01ydb01para que pidan dirección al router, y sigue en su journal el DORA de cada una: qué IP le ofrece y por qué interfaz llega su petición. La IP demuestra que la reserva funciona; la interfaz, que dnsmasq elige el rango por la pata en la que oye al cliente.Pista: desde el nodo ya no llegas a ellas por SSH, pero
qm rebootno lo necesita. -
Comprueba el resultado desde un cliente. Desde
web01, verifica que tiene su IP reservada y el DNS y el dominio de búsqueda del router, quedigcontra10.10.0.1resuelvedb01.dev.lab,db01a secas,api.dev.laby un nombre de Internet, y que sale a Internet por el NAT. Son las tres cosas que el router tiene que dar a cada máquina: dirección, nombres y salida.Pista: el nodo ya no es el
.1de front: entra saltando por el router, conssh -J ops@<IP de aula de router-dev> ops@10.10.1.10.digestá enbind9-dnsutils.
Comprobación web01 tiene 10.10.1.10 y db01 tiene 10.10.3.10, no una del rango dinámico; ninguna subred del SDN conserva gateway ni rango DHCP, así que el .1 es solo el router; dig con @10.10.0.1 devuelve NOERROR y flag aa para dev.lab; los nombres externos resuelven y el ping a Internet responde; en /var/lib/misc/dnsmasq.leases hay una línea por VM. Si el DISCOVER no aparece en el journal, revisa que la VM cuelga de su VNet y que dnsmasq escucha ahí (ss -ulnp | grep :67).
Para practicar Guarda en ut2/a23 del repositorio dev.conf comentado, /etc/nftables.conf, el DORA de una VM sacado de journalctl -u dnsmasq y la salida de los dig del paso 6: dev.conf lo pide la memoria de la evaluable.
Si te sobra tiempo Comprueba qué hace dhcp-authoritative. Quítala y, con dnsmasq parado, vacía su fichero de concesiones, como si el router lo hubiera perdido; arráncalo y fuerza en web01 la renovación de su concesión. Compara en el journal lo que contesta dnsmasq sin la línea con lo que contesta cuando la vuelves a poner y repites la prueba.
Sesión 10 · Comunicación entre zonas
Con router-dev en marcha, dev parece funcionar: las VM tienen dirección y nombre, y salen a Internet. Pero «parece funcionar» no es una prueba, y el criterio de evaluación pide demostrar con evidencias que las zonas se comunican como deben. Esta sesión hace dos cosas, en este orden. Primero crea el sitio desde el que se administra y se prueba todo el resto del curso, el puesto de administración, porque desde que router-dev es el .1 de cada subred el nodo ya no tiene dirección en ninguna de ellas. Después demuestra la comunicación entre front y data con cuatro herramientas, cada una contestando a una pregunta distinta, y provoca a propósito el fallo más típico, un router que no reenvía, para aprender a reconocerlo. La teoría es la de las pruebas: desde dónde se prueba, qué demuestra cada herramienta y cómo se leen sus salidas, y la plantilla con la que cada prueba queda escrita. La diferencia entre enrutar y hacer NAT, que es lo que la captura tiene que enseñar, está en Enrutar frente a hacer NAT.
Cómo se prueba una red
Funcionar no es estar demostrado. Una red que "funciona" sin pruebas escritas no vale en esta asignatura ni en una empresa: dentro de un mes nadie recordará qué se comprobó, desde dónde ni con qué resultado. Probar una red es hacerle preguntas concretas (¿hay camino?, ¿escucha el servicio?, ¿resuelve el nombre?, ¿pasa el tráfico por donde debe?), cada una con la herramienta que la contesta, desde un origen conocido, y dejarlo escrito con fecha; la evaluable pide cinco pruebas así. Este es además el apartado que explica a fondo nmap y tcpdump en las dos asignaturas: cuando vuelven a salir, se repasan remitiendo a él.
Desde dónde se prueba: el puesto de administración
El problema. Mientras el SDN repartía las direcciones, a las VM de la VPC se entraba desde el nodo, porque era el .1 de cada subred. Con router-dev, el nodo ya no tiene dirección en ninguna, y la única forma de llegar es saltar por la pata del aula del router. Sirve para un día, pero no como costumbre: el router es una pieza de red que se va a sustituir por un cortafuegos, y no es sitio para guardar herramientas ni repositorios. Hace falta una máquina fija, dentro de gestión, desde la que se llegue a todas las zonas.
El bastión. Es el puesto de administración, admin01 (VM 105): una VM pequeña con dos tarjetas, una en la red del aula y otra en gestión con la 10.10.0.50. Es la única máquina con un pie en cada lado, así que todo lo que se administra pasa por ella. A una máquina así se le llama bastión (en inglés, jump host): es la puerta de entrada, y por eso la que más se vigila y la que menos cosas debe tener expuestas. En el curso guarda además las herramientas y las copias de trabajo de los repositorios, empezando hoy por entregas-5166.
Su tabla de rutas. Con dos tarjetas, admin01 tiene dos caminos, y hay que decirle cuál usar para cada destino. La ruta por defecto va por el aula, porque es por donde se entra en ella y por donde sale a Internet. La red de gestión, 10.10.0.0/24, la conoce sin más, porque está conectada a ella. Pero front, back y data no lo están: sin nada más, los paquetes hacia 10.10.1.10 saldrían por la ruta por defecto hacia el aula y se perderían. Hace falta una ruta estática que diga que todo el bloque de dev, 10.10.0.0/16, se alcanza a través de router-dev por su pata de gestión, la 10.10.0.1. Cuando dos rutas sirven para un mismo destino, gana la más específica: para 10.10.0.20 sigue mandando la de gestión (/24), que va directa, y para el resto del bloque, la nueva (/16). La ruta por defecto no se cambia al router porque entonces las respuestas a quien entra desde el aula saldrían por otro camino, traducidas por el NAT del router, y la conexión se rompería.
Por qué en una unidad de systemd. La ruta se podría poner a mano con ip route, pero se perdería en el primer reinicio. Tampoco va en los ficheros de red de la VM, porque los escribe cloud-init y los puede regenerar. Lo robusto es una unidad de systemd de un solo disparo que la pone cada vez que la red está lista:
# /etc/systemd/system/ruta-lab.service, en admin01
[Unit]
Description=Ruta al resto de dev por router-dev
After=network-online.target
Wants=network-online.target
[Service]
Type=oneshot
RemainAfterExit=yes
ExecStart=/sbin/ip route replace 10.10.0.0/16 via 10.10.0.1 dev ens19
[Install]
WantedBy=multi-user.target
Type=oneshot dice que es una orden que se ejecuta y termina, no un servicio que se queda corriendo, y RemainAfterExit=yes hace que systemd la siga dando por activa después, así que systemctl status dice si se aplicó y systemctl restart la vuelve a ejecutar. replace en lugar de add hace que no falle si la ruta ya existe. ens19 es la tarjeta de gestión, la segunda de la VM. El mismo patrón sirve para cualquier cosa de red que tenga que sobrevivir al reinicio sin depender de cloud-init.
Entrar y saltar. Desde el puesto del alumno se entra en admin01 por su IP del aula, y desde ahí a cualquier VM por su IP interna. Para no copiar la clave privada al bastión, se entra con ssh -A, que le presta el agente de claves del puesto mientras dura la conexión: las VM ven la clave de siempre sin que salga del puesto. Para eso la clave tiene que estar cargada en el agente (ssh-add -l la lista). Es razonable en un bastión propio; en uno compartido, quien fuera root en él podría usar esa clave mientras la conexión siguiera abierta. La otra forma de saltar, ssh -J, no deja nada en el bastión ni necesita agente, y es la que usa el laboratorio cuando todo queda detrás del cortafuegos.
Qué demuestra cada herramienta
Cada herramienta contesta a una pregunta, y solo a esa. La tabla resume cuál; después va cómo leer lo que devuelven, que es la parte que nadie enseña.
| Prueba | Herramienta | Qué demuestra |
|---|---|---|
| Conectividad | ping, traceroute |
Hay ruta en los dos sentidos y el destino responde |
| Puertos abiertos | nmap -sT -p- host, ss -tlnp |
Qué servicios escuchan (desde fuera y desde dentro) |
| Resolución | dig web01.dev.lab @10.10.0.1 |
DNS interno correcto |
| DHCP | journalctl -u dnsmasq, ip a |
Concesiones entregadas y recibidas |
| Aislamiento | nmap -sn 10.20.1.0/24 desde dev, y la tabla de rutas del router |
Debe no encontrar nada, y el router no tiene camino hacia ese bloque |
| Tráfico real | tcpdump -i ens22 port 5432 |
Qué pasa de verdad por el cable |
ping: hay camino de ida y vuelta. ping manda un eco ICMP (el protocolo de mensajes de control de IP, el que lleva los ecos, los avisos de destino inalcanzable y los de tiempo agotado) y espera la respuesta. Que responda demuestra ruta de ida, ruta de vuelta y que el destino no filtra ICMP. Que no responda no demuestra casi nada: puede ser ruta, firewall, o que el destino está apagado. Destination Host Unreachable desde la IP propia significa que no hay ARP (el protocolo que traduce una IP a una MAC dentro de la misma subred), es decir, el destino está (o debería estar) en la misma subred y no contesta; desde la IP del router significa que el router no tiene ruta. Un 100% packet loss sin más mensaje suele ser un firewall que descarta en silencio.
traceroute: por dónde pasa. traceroute (o tracepath, que viene instalado en Debian sin paquetes extra) enseña por qué routers pasa el paquete. Lo consigue con el TTL, un contador de saltos que lleva cada paquete y que cada router resta en uno: cuando llega a cero, el router descarta el paquete y avisa al origen con un ICMP de tiempo agotado, y ese aviso revela su dirección. traceroute manda primero sondas que solo pueden dar un salto, después dos, y así hasta llegar al destino, de modo que cada router del camino se delata por turno. En el laboratorio, de web01 a db01 debe salir exactamente un salto intermedio, 10.10.1.1. Si salen asteriscos desde el primer salto, el router no reenvía (falta ip_forward) o tira el paquete a propósito con una ruta blackhole (una ruta que descarta en silencio lo que va a una red): un router que no reenvía un paquete tampoco contesta como salto intermedio, así que ni siquiera aparece su dirección.
ss y nmap: qué escucha, visto desde dentro y desde fuera. ss -tlnp (sockets TCP en escucha, numérico, con proceso) se ejecuta en la máquina destino y dice qué está escuchando y en qué dirección. 0.0.0.0:5432 escucha en todas; 127.0.0.1:5432 solo en local, y ese es el motivo número uno de "el puerto está abierto pero desde fuera no conecta". nmap -sT -p- host desde otra máquina hace la comprobación complementaria: open es que el servicio contesta, closed es que la máquina responde con RST (el paquete TCP de rechazo: hay ruta, no hay servicio), filtered es que no responde nada (firewall o sin ruta).
nmap -sn: la prueba de aislamiento y su límite. Para la prueba de aislamiento se usa nmap -sn, que solo descubre hosts sin escanear puertos; el resultado esperado desde dev contra 10.20.1.0/24 es 0 hosts up. Se barre un /24 y no el /16 entero porque cada dirección que no contesta agota su tiempo de espera, y con 65 536 direcciones el barrido se alarga muchos minutos sin demostrar nada más. Cuidado con leerlo como prueba: un 0 hosts up solo dice que nadie contestó a las sondas, y sale igual si no hay camino que si lo hay y algo las descarta en silencio. Lo que demuestra que no hay camino es la tabla de rutas del router (ip r, con la ruta blackhole hacia ese bloque) junto con un ping y un traceroute que no pasan de dev; por eso la prueba se documenta con las tres salidas y el motivo se anota en la memoria. Aparte, cuando origen y destino están en la misma red, nmap lanzado como root pregunta por ARP en vez de mandar sondas IP; en el laboratorio no ocurre, porque dev y pre no comparten ningún bridge.
dig: qué resuelve y quién lo resuelve. dig es la herramienta para DNS; nslookup sirve, pero dig enseña más. Lo que importa de su salida:
$ dig web01.dev.lab @10.10.0.1
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 41977
;; flags: qr aa rd ra; QUERY: 1, ANSWER: 1, AUTHORITY: 0, ADDITIONAL: 1
;; ANSWER SECTION:
web01.dev.lab. 0 IN A 10.10.1.10
;; Query time: 0 msec
;; SERVER: 10.10.0.1#53(10.10.0.1)
status: NOERROR con una ANSWER es el resultado correcto. NXDOMAIN es que el servidor conoce el dominio y el nombre no existe (falta el dhcp-host o el address). SERVFAIL o timeout es que el servidor no responde o no tiene a quién reenviar. El flag aa (authoritative answer) confirma que dnsmasq responde por sí mismo gracias a local=/dev.lab/. Y @10.10.0.1 fuerza el servidor: sin él, dig usa el de /etc/resolv.conf, y si ese es otro la prueba no demuestra nada sobre el dnsmasq del router.
tcpdump: lo que pasa de verdad. tcpdump es la prueba definitiva porque no interpreta, muestra. Se ejecuta en el router, que es por donde pasa todo, con -n para que no resuelva nombres (más rápido y no ensucia el DNS que se está probando) e -i con la interfaz de la zona que interesa:
# tcpdump -ni ens22 port 5432
14:02:11.301 IP 10.10.1.10.51234 > 10.10.3.10.5432: Flags [S], seq 1092, win 64240, length 0
14:02:11.301 IP 10.10.3.10.5432 > 10.10.1.10.51234: Flags [S.], seq 887, ack 1093, win 65160, length 0
14:02:11.302 IP 10.10.1.10.51234 > 10.10.3.10.5432: Flags [.], ack 1, win 502, length 0
Eso es un handshake TCP completo (SYN, SYN-ACK, ACK) y demuestra que web01 llega a db01 y db01 responde, con las IP reales a ambos lados (no hay NAT dentro del entorno). Si solo aparecen [S] repetidos sin [S.], el paquete llega a db01 y db01 no responde: puerto cerrado con firewall, o db01 no tiene ruta de vuelta (gateway mal). Si aparece [R.], hay camino pero nadie escucha: es el closed de nmap. Si no aparece nada en ens22 pero sí en ens20, el router recibe y no reenvía. Para guardar la captura y abrirla en Wireshark, -w captura.pcap.
La plantilla de pruebas
Por qué una plantilla. Una salida de terminal suelta no dice desde dónde se lanzó, cuándo ni qué se esperaba de ella. La plantilla obliga a escribir las tres cosas, y el resultado esperado se escribe antes de lanzar la orden: si se escribe después, se acaba copiando lo obtenido y la prueba deja de probar. Esta es la que se rellena por cada prueba de la memoria:
Prueba 3 · Resolución DNS interna
Fecha: 2026-11-04 11:40 Origen: web01 (10.10.1.10) Destino: router-dev (10.10.0.1)
Comando: dig db01.dev.lab @10.10.0.1 +short
Esperado: 10.10.3.10
Obtenido: 10.10.3.10
Evidencia: captura dig-db01.png
La fecha importa porque una red cambia: la misma prueba de aislamiento puede dar otro resultado antes y después de tocar un router. El origen importa porque lo que se alcanza depende de desde dónde se mire.
A2.4 Comunicación entre zonas (sesión 10)
Objetivo Demostrar con ping, traceroute, nc y una captura de tcpdump que web01 (front) llega a db01 (data) a través del router, con las IP reales a ambos lados, y qué pasa cuando el router deja de reenviar. Es la evidencia del criterio de comunicación entre zonas y tres de las cinco pruebas de la memoria. De camino queda creado el puesto de administración, la máquina de la subred de gestión desde la que se alcanzan las cuatro zonas y que se usa el resto del curso.
Antes de empezar
router-devde la A2.3 funcionando, conweb01en front (10.10.1.10) ydb01en data (10.10.3.10).- El puesto de administración nace hoy y se queda el resto del curso, porque desde él se administra todo el laboratorio. Su clon lo puedes dejar hecho antes de clase.
- Cinco máquinas: el nodo, el puesto de administración,
web01,db01y el router. - Explicado en esta sesión: cómo se prueba una red, con el puesto de administración, qué demuestra cada herramienta y la plantilla de pruebas. De la sesión 9: el reenvío IP del router de entorno y enrutar frente a hacer NAT.
Pasos
Primero montas el sitio desde el que vas a trabajar, porque todo lo demás se lanza desde él: el puesto de administración, con su ruta, y tu repositorio de entregas. Después haces la prueba de comunicación entre front y data, con las cuatro herramientas y la captura abierta, y la lees paquete a paquete. Luego rompes el reenvío a propósito para ver cómo se reconoce ese fallo, y al final pasas a la plantilla las tres pruebas que pide la evaluable.
-
Crea el puesto de administración. Es
admin01(ID 105, 1 GB, un núcleo), connet0envmbr0por DHCP ynet1endevmgmtcon la10.10.0.50/24. Dale su ruta persistente a10.10.0.0/16por10.10.0.1en la unidadruta-lab.servicede Desde dónde se prueba. Comprueba que llega a Internet y a los cuatro.1: son los dos caminos de su tabla de rutas, el del aula y el de gestión.Pista: antes de copiar la unidad, mira con
ip -br aque la tarjeta de gestión esens19. -
Lleva allí tu repositorio de entregas. Pasa
entregas-5166desde tu equipo del aula al puesto de administración, congitinstalado allí: desde hoy el repositorio de entregas vive en esta VM, que es donde vas a generar las evidencias. -
Demuestra que front llega a data por el 5432. Deja algo escuchando en ese puerto de
db01, captura en la pata de data del router y lanza desdeweb01unping, untraceroutey unnc -zvcontradb01.dev.lab. Cada herramienta contesta a una pregunta de qué demuestra cada herramienta: si hay camino, por dónde pasa y si el puerto responde; la captura, qué viaja de verdad. La captura tiene que estar abierta antes de lanzar las pruebas, porque solo enseña lo que pasa mientras escucha.Pista: entra en el puesto de administración con
ssh -A, que le presta tu clave para saltar desde él aweb01,db01y el router por su IP interna. Como servidor bastanc -l -p 5432, denetcat-openbsd. -
Lee el handshake. Copia de la captura las tres líneas del handshake (
[S],[S.],[.]) y escribe debajo, en tres líneas, quién inicia, quién responde y con qué IP de origen llega el paquete adb01. Esa IP es la prueba de que dentro del entorno se enruta y no se hace NAT. -
Rompe el reenvío y aprende a reconocerlo. Desactiva el reenvío en el router y repite desde
web01elpingy eltraceroute: anota qué cambia y qué enseña una captura ICMP en la pata de front del router. Es el fallo más típico de un router recién montado, y haberlo visto una vez hace que se reconozca a la primera. Después vuelve a activarlo y confirma con unping.Pista:
sysctl -wcambia el valor en caliente, sin tocar el fichero de la A2.3. -
Documenta tres pruebas de la evaluable. Rellena la plantilla de pruebas para tres de las cinco pruebas de la evaluable: la conectividad intra-entorno (paso 3), la captura de tráfico (paso 4) y la resolución DNS, esta última con la salida de
dig db01.dev.lab @10.10.0.1que guardaste en la A2.3.
Comprobación El puesto de administración responde a los cuatro .1 y su ip route muestra 10.10.0.0/16 via 10.10.0.1 dev ens19 además de la ruta por defecto hacia el aula; el traceroute de web01 a db01 muestra un solo salto intermedio, 10.10.1.1; nc -zv dice succeeded; la captura en ens22 muestra origen 10.10.1.10 y destino 10.10.3.10, sin NAT; con ip_forward=0 el ping falla y el traceroute solo da asteriscos.
Para practicar Guarda en ut2/a24 del repositorio el ip route del puesto de administración con los cuatro ping del paso 1, la captura del handshake con tu explicación, los dos traceroute (con y sin reenvío) y las tres plantillas de prueba.
Si te sobra tiempo Instala PostgreSQL en db01 con listen_addresses = '*', conecta desde web01 con psql -h db01.dev.lab -U postgres y mira en /var/log/postgresql/ desde qué IP dice que viene la conexión.
Sesión 11 · Segundo y tercer entorno; aislamiento
Hasta aquí solo existe dev. La razón de tener tres entornos es que lo que se haga en uno no pueda afectar a los otros, y eso hay que construirlo y después demostrarlo, no darlo por supuesto. Esta sesión de práctica hace las dos cosas. Primero replica la red: pre igual que dev, con su router completo, y pro solo con sus VNets y su router, porque en el curso no tendrá servicio. Las ocho VNets nuevas son iguales salvo el nombre, así que se crean desde la línea de comandos con pvesh. Después cierra el paso entre entornos y lo demuestra desde dev con las pruebas de cómo se prueba una red, donde están también la plantilla y la lectura de nmap -sn. Los cinco minutos de explicación son el apartado de aislamiento: por qué dev no llega a pre sin que nadie lo prohíba y qué añade una ruta blackhole. Las órdenes de pvesh se copian de pvesh: la API desde el nodo, un apartado que se explica en la sesión siguiente, el 13 de noviembre.
Aislamiento y separación
Por construcción, no por prohibición. El aislamiento entre entornos se consigue sin escribir ninguna regla. Cada entorno tiene su bloque, sus cuatro VNets y su router, y en ningún router hay una ruta hacia el bloque de otro entorno. Un paquete de 10.10.1.10 con destino 10.20.1.10 llega a router-dev, que no tiene ruta para 10.20.0.0/16 y lo manda por la ruta por defecto (0.0.0.0/0, la que se usa cuando ninguna otra coincide) hacia ens18, la red del aula, donde nadie sabe qué es 10.20.0.0/16 y se pierde. Y aunque llegara a router-pre por algún camino, router-pre no tiene ruta de vuelta hacia 10.10.0.0/16. Lo que dev no puede alcanzar, no puede romper. Cuando haga falta unir entornos a propósito, se añade esa ruta concreta, en un solo sentido y filtrada. En nube pública eso se llama peering.
flowchart LR
O["<b>10.10.1.10</b><br><small>en dev</small>"]:::pieza
RD["<b>router-dev</b><br><small>no tiene ruta para 10.20.0.0/16</small>"]:::act
DEF["<b>ruta por defecto</b><br><small>sale por ens18 a la red del aula</small>"]:::infra
PERD(["<b>Se pierde</b><br><small>nadie en el aula sabe qué es 10.20.0.0/16</small>"]):::ok
BH["<b>ip route add blackhole</b><br><small>10.20.0.0/16 y 10.30.0.0/16</small>"]:::act
O -- "destino 10.20.1.10" --> RD --> DEF --> PERD
RD -. "mejor: rechazarlo aquí" .-> BH
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxEl aislamiento sale de que no hay ruta, no de que haya una regla. Lo que dev no alcanza, no lo puede romper.
Lo que añade una ruta blackhole. Ese «se pierde» depende de que nadie en el aula sepa llegar a 10.20.0.0/16, y eso no lo controla quien monta el entorno. Por eso cada router rechaza los bloques de los otros entornos antes de que lleguen a la ruta por defecto, con una ruta blackhole (agujero negro): en router-dev, ip route add blackhole 10.20.0.0/16 y ip route add blackhole 10.30.0.0/16. Funciona por la regla que ya se vio con la ruta del puesto de administración: cuando varias rutas sirven para un destino, gana la más específica, y un /16 lo es más que la ruta por defecto, que es un /0. El router tira esos paquetes en silencio, sin reenviarlos ni contestar. Es una línea por bloque; en la A2.5 se dejan en una unidad de systemd, con el mismo patrón que la del puesto de administración, para que sobrevivan al reinicio.
Sin blackhole, el NAT de salida puede romper el aislamiento
Si los tres routers hacen masquerade hacia vmbr0 y los tres están en la misma red del aula, un paquete de dev hacia 10.20.1.10 sale con la IP de router-dev al aula y, si algo en el aula enrutara 10.20.0.0/16 hacia router-pre, volvería a entrar. En el aula no ocurre, pero en una empresa donde el core conoce esas redes ocurre siempre, y es la prueba de aislamiento que falla en la evaluable.
Por qué pro se queda en red. En el curso pro no tiene servicio: sus VNets y su router bastan para probar que dev no lo alcanza, y lo dejan como un entorno vacío donde crear y destruir máquinas sin riesgo. Por eso router-pro se crea pero no se configura, y su VM de prueba lleva IP fija.
Separar clientes. Cuando varios clientes comparten hardware (multi-tenant), se sigue el mismo planteamiento, con una red por cliente.
Y dentro de cada entorno. Las zonas están en subredes distintas precisamente para poder filtrar entre ellas: front hablará con back solo por el 28080 de la API, back con data solo por el 5432, gestión llegará a todo por el 22 y nadie más llegará a gestión. Si las zonas estuvieran en un único /24, o en varias subredes dentro de la misma VNet, no habría dónde filtrar: el tráfico entre ellas no pasaría por el router. En esta unidad las zonas todavía se ven completas, porque el router reenvía todo. Esas reglas las pone el cortafuegos que ocupa el sitio del router el 20 de noviembre.
A2.5 pre, pro y aislamiento (sesión 11)
Objetivo Tener pre montado como dev (VNets y router con reenvío, NAT y dnsmasq), las VNets y el router de pro, y demostrar con pruebas documentadas que desde dev no se alcanza nada de pre ni de pro. Es el criterio de VPC diferenciadas por entorno y aisladas de la evaluable, y lo que montas de pre no se tira: router-pre y sus VNets son los que se usan en enero, cuando se despliegan en pre las máquinas del servicio.
Antes de empezar
- dev completo: las cuatro VNets,
router-devcon dnsmasq y NAT,web01ydb01. - pre es
10.20.0.0/16con la franja de ID 200, y pro,10.30.0.0/16con la 300 (convenciones del laboratorio). - Hoy se encienden dos routers y dos VM de prueba, todos a 512 MB: para dejar memoria, apaga
db01(130) al empezar. No hace falta hasta la evaluable. - Explicado en esta sesión: aislamiento y separación. De la sesión 10:
nmap -snen qué demuestra cada herramienta y la plantilla de pruebas. Para las VNets, el bloque de pvesh, que se explica el 13 de noviembre.
Pasos
Vas a replicar primero y a aislar después. Montas las redes y los routers de los dos entornos nuevos, dejas pre funcionando como dev y pones las rutas blackhole; solo entonces creas una VM de prueba en cada entorno, porque sin máquinas al otro lado una prueba de aislamiento no demostraría nada. Al final lanzas las pruebas desde dev, separas lo que demuestra de verdad que no hay camino de lo que solo lo sugiere, y lo pasas a la plantilla.
-
Monta las redes y los routers de pre y pro. Con
pvesh, las cuatro VNets de cada entorno en la zonalab(premgmt,prefront,preback,predatay sus cuatro depro), con una subred cada una sin gateway ni rango DHCP, porque de eso se encarga el router, y aplicadas; después,router-pre(200) yrouter-pro(300), comorouter-deven el paso 2 de la A2.3. Es la estructura de dev con otro prefijo, y por eso se hace con un bucle y no a clics.Pista: son las órdenes de pvesh sin
--gatewayni--dhcp-range, en un bucle sobremgmt front back data. Los routers salen de la plantilla 9000, no derouter-dev, que les pasaríadev.confy el resto de su configuración de dev. -
Deja pre funcionando como dev. Configura
router-precomorouter-dev: el reenvío y el NAT del paso 3 de la A2.3, y unpre.confsacado deldev.confdel apartado dnsmasq, con el dominio y el prefijo de pre y sin las cuatro reservas, que son de máquinas de dev.router-prono se configura hoy: pro se queda en red, y la VM de pro del paso 4 lleva IP fija.Pista: un
sedsacapre.confde una copia dedev.conf, que no puede quedarse en/etc/dnsmasq.d/: dnsmasq lee todos los ficheros de esa carpeta. -
Cierra el paso con rutas blackhole. Pon las rutas blackhole de aislamiento y separación en una unidad de systemd
blackhole.serviceen cada router, para que sobrevivan al reinicio: enrouter-dev, hacia10.20.0.0/16y10.30.0.0/16; enrouter-pre, hacia10.10.0.0/16y10.30.0.0/16. Sin ellas, el aislamiento dependería de que nadie en la red del aula supiera llegar a esos bloques.Pista: es el patrón de
ruta-lab.service(A2.4, paso 1), con una líneaExecStart=/sbin/ip route replace blackhole <bloque>por bloque. -
Pon una máquina al otro lado. Crea en front la
web01de prueba de cada entorno, a 512 MB: la 210 de pre, por DHCP, y la 310 de pro, con la10.30.1.10/24y gateway10.30.1.1fijos, porquerouter-prono reparte direcciones. Apunta la IP que coge la 210 en el DORA del journal derouter-pre: es la evidencia de la concesión DHCP que pide la memoria. -
Lanza las pruebas de aislamiento desde dev. Guarda las salidas de estas pruebas, lanzadas desde la
web01de dev:nmap -sncontra10.20.1.0/24y10.30.1.0/24,pinga10.20.1.1, a10.30.1.1y a la 210, ytraceroutea10.20.1.1, más elip rderouter-dev. Después destruye la 310, para que la A2.6 encuentre pro sin ninguna VM; la 210 se queda hasta la evaluable, porque su DORA es evidencia de la memoria. -
Explica qué demuestra cada salida. Escribe en tres o cuatro líneas por qué un
0 hosts upo unpingsin respuesta no bastan por sí solos y cuál de tus salidas demuestra de verdad que no hay camino. Después rellena la plantilla de pruebas para el aislamiento inter-entorno y para la concesión DHCP, con el DORA de la 210.
Comprobación ip -br link show type bridge en el nodo muestra las doce VNets en UP (dev*, pre* y pro*); la web01 de pre tiene una IP de 10.20.1.0/24 dada por router-pre; ningún ping ni traceroute desde dev llega a pre ni a pro; en router-dev y en router-pre, ip r muestra los dos blackhole; al terminar, qm list ya no tiene la 310.
Para practicar Guarda en ut2/a25 del repositorio pre.conf, el ip r de router-dev y de router-pre, las salidas del paso 5, lo que escribiste en el paso 6 y las dos plantillas de prueba.
Si te sobra tiempo Quita el blackhole de router-dev (ip route del blackhole 10.20.0.0/16), repite el ping a 10.20.1.1 y captura con tcpdump -ni ens18 icmp: el paquete sale masqueradeado al aula. Vuelve a ponerlo con systemctl restart blackhole.service. Después, configura router-pro como router-pre (pasos 2 y 3, con pro y 10.30).
Sesión 12 · Automatizar con la CLI de Proxmox
Hasta ahora la red se ha construido a clics y con órdenes sueltas: dev en la consola web, pre y pro con unas cuantas líneas de pvesh. Repetirlo para otro entorno costaría otra tarde, y cada repetición saldría un poco distinta. Automatizar es escribirlo una vez como un programa que cualquiera puede ejecutar y que da siempre el mismo resultado; pero un script que falla o duplica las máquinas si se ejecuta dos veces es peligroso, porque nadie se atreve a relanzarlo cuando se queda a medias, así que tiene que ser idempotente. La teoría recorre las formas de hablar con Proxmox sin la consola web, de la más concreta a la más general: qm y pct para las máquinas, pvesh para cualquier otra cosa de la API (el SDN incluido) y la API REST con un token, que es la única que funciona desde fuera del nodo. La hoja escribe los dos scripts, los prueba contra pro y reproduce dos llamadas a la API con curl desde el puesto de administración. Es la antesala de diciembre, cuando la unidad de infraestructura como código (UT5) describe las máquinas en ficheros y las crea con OpenTofu, que llama a esta misma API a través de un complemento para Proxmox, el provider.
Automatizar con la CLI y la API
Una sola API debajo de todo. Todo lo que hace la consola web de Proxmox pasa por la misma API REST (una API que se llama por HTTP, con rutas como las de una web, y responde en JSON). Las herramientas de la línea de comandos usan esos mismos métodos, ejecutados directamente en el nodo: qm para VM, pct para contenedores LXC (contenedores de sistema completo, más ligeros que una VM y distintos de los de Docker) y pvesh para cualquier ruta de la API, incluido el SDN, que no tiene comando propio. Cualquier herramienta que automatice Proxmox hace por debajo las mismas llamadas que aquí se hacen con pvesh y curl, y conocerlas permite leer sus errores.
qm y pct
Qué tiene que hacer el script. Crear un entorno es clonar tres VM de la plantilla, conectar cada una a la VNet de su zona y arrancarlas. Lo difícil no es eso, sino que se pueda ejecutar dos veces sin romper nada: idempotente quiere decir que ejecutarlo dos veces deja lo mismo que ejecutarlo una, sin errores ni duplicados. Es lo que permite relanzarlo con tranquilidad cuando falla a medias. Este script lo consigue preguntando antes de actuar: comprueba con qm status si cada VM existe y solo la clona si no. Recibe el nombre del entorno como argumento:
#!/bin/bash
# crea-entorno.sh dev|pre|pro
set -euo pipefail
ENV=${1:?Uso: $0 dev|pre|pro}
TPL=9000
case $ENV in
dev) BASE=100; NET=10.10 ;;
pre) BASE=200; NET=10.20 ;;
pro) BASE=300; NET=10.30 ;;
*) echo "entorno desconocido: $ENV" >&2; exit 1 ;;
esac
# host : decena del ID : zona, que es también el final del nombre de la VNet
for FILA in web01:10:front app01:20:back db01:30:data; do
HOST=${FILA%%:*}; RESTO=${FILA#*:}
DEC=${RESTO%%:*}; ZONA=${RESTO#*:}
ID=$((BASE+DEC))
BR=$ENV$ZONA # devfront, devback, devdata, prefront...
if qm status $ID >/dev/null 2>&1; then
echo "$HOST ($ID) ya existe, no se toca"
else
qm clone $TPL $ID --name $HOST --full
qm set $ID --memory 512 --net0 virtio,bridge=$BR --ipconfig0 ip=dhcp \
--searchdomain $ENV.lab --tags $ENV
fi
[ "$(qm status $ID | awk '{print $2}')" = running ] || qm start $ID
done
Y el de destrucción, que para y borra en orden inverso y tampoco falla si ya no hay nada:
#!/bin/bash
# destruye-entorno.sh dev|pre|pro
set -euo pipefail
ENV=${1:?Uso: $0 dev|pre|pro}
case $ENV in dev) BASE=100 ;; pre) BASE=200 ;; pro) BASE=300 ;; *) exit 1 ;; esac
for ID in $((BASE+30)) $((BASE+20)) $((BASE+10)); do
if qm status $ID >/dev/null 2>&1; then
qm stop $ID --timeout 30 || true
qm destroy $ID --purge
fi
done
Las decisiones de los dos scripts.
set -euo pipefailcorta al primer error (-e), trata como error usar una variable sin definir (-u) y no deja que un fallo se esconda dentro de una tubería (pipefail): un script de infraestructura que sigue adelante después de un fallo deja las cosas a medias.- La comprobación con
qm statusantes de clonar es lo que da la idempotencia. En el de destrucción, la misma comprobación hace que la segunda ejecución no encuentre nada que borrar y termine bien. --fullhace un clon completo en vez de enlazado: más lento y más disco, pero la VM no depende de la plantilla y se puede migrar.--memory 512es lo justo para arrancar: son VM de prueba, y tres más con la memoria de la plantilla no caben junto a lo que ya está encendido.--purgequita además la VM de los trabajos de copia, de replicación y de alta disponibilidad que la mencionen, para que no quede ninguna referencia a un ID que se va a reutilizar.NET, el prefijo del bloque, todavía no se usa: lo necesita la ampliación de la A2.6 que crea también la red.- Los ID siguen la convención de números de VM: la centena es el entorno y la decena, la zona.
pct, para contenedores. pct es equivalente para contenedores LXC (pct create, pct set --net0 name=eth0,bridge=devback,ip=dhcp, pct start). En este módulo se trabaja sobre VM porque los contenedores de aplicación van dentro con Docker, pero para un dnsmasq o un proxy un LXC gasta la décima parte de RAM y arranca en un segundo.
pvesh: la API desde el nodo
Para lo que no tiene comando. El SDN no tiene un qm propio: se maneja con pvesh, que recorre la API como si fuera un sistema de ficheros: get lee, create es POST, set es PUT y delete es DELETE. Se ejecuta como root en el propio nodo, así que no pide credenciales. Lo que hace la A2.2 en la consola web, para dos de las cuatro VNets:
pvesh create /cluster/sdn/zones --zone lab --type simple --dhcp dnsmasq --ipam pve
pvesh create /cluster/sdn/vnets --vnet devfront --zone lab --alias "dev front"
pvesh create /cluster/sdn/vnets/devfront/subnets --subnet 10.10.1.0/24 --type subnet \
--gateway 10.10.1.1 --dhcp-range start-address=10.10.1.100,end-address=10.10.1.199
pvesh create /cluster/sdn/vnets --vnet devback --zone lab --alias "dev back"
pvesh create /cluster/sdn/vnets/devback/subnets --subnet 10.10.2.0/24 --type subnet \
--gateway 10.10.2.1 --dhcp-range start-address=10.10.2.100,end-address=10.10.2.199
pvesh set /cluster/sdn # el Apply
Las otras dos VNets de dev, devmgmt y devdata, salen igual cambiando el nombre y el tercer octeto. Es el bloque que la A2.5 repite para pre y pro sin gateway ni rango DHCP, y el que la A2.6 mete en el script.
Para inspeccionar. pvesh get /cluster/sdn/vnets --output-format json, pvesh get /nodes/pve1/qemu, pvesh get /cluster/resources --type vm. pvesh usage /cluster/sdn/zones -v muestra todos los parámetros que acepta cada ruta, que es la documentación de la API en el propio nodo. La referencia completa y navegable está en el API Viewer.
La API REST con token: la antesala de OpenTofu
Desde fuera hay que identificarse. pvesh funciona porque lo ejecuta root en el nodo. Desde fuera, sea desde el puesto de administración o desde OpenTofu, hay que autenticarse contra https://nodo:8006/api2/json/, y la forma correcta es un token de API, no la contraseña de root. Con la contraseña de root, un script tendría todo el poder del nodo y, si el secreto se filtrara, habría que cambiar la contraseña de la que depende todo lo demás. Un token, en cambio, se crea para un usuario, tiene su propio secreto y se puede revocar sin cambiar ninguna contraseña.
Un usuario con lo justo. Primero, un usuario con los permisos justos para lo que va a hacer: para leer y crear VNets basta el rol PVESDNAdmin sobre /sdn, la parte de la API que gestiona el SDN. En el laboratorio es un usuario de prácticas, cli@pve, que la A2.6 borra al terminar.
pveum user add cli@pve --comment "Practicas de la API"
pveum acl modify /sdn --users cli@pve --roles PVESDNAdmin
pveum user token add cli@pve lab --privsep 0
El secreto. El último comando imprime el secreto una sola vez. --privsep 0 hace que el token herede los permisos del usuario; con 1 (el valor por defecto) el token tiene sus propios ACL (listas de permisos) y hay que asignárselos aparte. El secreto se guarda en un gestor de contraseñas o en un fichero .env fuera del repositorio; nunca en el script y nunca en Git.
La llamada. Con eso, la misma llamada que hacía pvesh se puede hacer desde cualquier sitio con curl. La cabecera Authorization lleva el usuario, el nombre del token y su secreto:
export PVE_TOKEN='PVEAPIToken=cli@pve!lab=4f3a1c2e-...-9b7d'
curl -sk -H "Authorization: $PVE_TOKEN" \
https://192.168.1.50:8006/api2/json/cluster/sdn/vnets | jq .
curl -sk -H "Authorization: $PVE_TOKEN" -X POST \
-d 'zone=lab&type=simple' \
https://192.168.1.50:8006/api2/json/cluster/sdn/zones
La primera llamada lee las VNets; la segunda es la que creó la zona lab en la A2.2, y repetida ahora contestaría que ya existe. -k salta la verificación del certificado autofirmado del nodo; en el provider de OpenTofu el equivalente es insecure = true, escrito a la vista en el código para que se vea que la verificación está desactivada. Lo correcto fuera del laboratorio es que el cliente confíe en la CA del clúster (/etc/pve/pve-root-ca.pem). La segunda llamada, escrita en OpenTofu, para comparar:
provider "proxmox" {
endpoint = "https://192.168.1.50:8006/"
api_token = var.pve_token # un token del mismo formato, desde una variable
insecure = true
}
resource "proxmox_virtual_environment_sdn_zone_simple" "lab" {
id = "lab"
dhcp = "dnsmasq"
}
Es la misma llamada, con un token del mismo formato, contra la misma ruta. Por eso, cuando un tofu apply falle con un 403 o un 400 Parameter verification failed, la forma de depurarlo es reproducirlo con curl como aquí.
flowchart TD
W["<b>Consola web</b><br><small>el navegador, puerto 8006</small>"]:::act
C["<b>curl + token</b><br><small>desde fuera del nodo</small>"]:::act
T["<b>OpenTofu</b><br><small>provider bpg/proxmox</small>"]:::act
Q["<b>qm · pct · pvesh</b><br><small>en el nodo, como root</small>"]:::act
API["<b>pveproxy</b><br><small>HTTPS en el 8006 · /api2/json<br>comprueba quién llama y qué puede hacer</small>"]:::pieza
M["<b>Los métodos de la API</b><br><small>el mismo código para todas las puertas<br>lo que necesita root, a través de pvedaemon</small>"]:::pieza
S["<b>El efecto real</b><br><small>/etc/pve/sdn/*.cfg · qm clone · ifreload</small>"]:::dato
W --> API
C --> API
T --> API
API --> M
Q -- "directamente, sin HTTP" --> M
M --> S
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxLas cuatro puertas acaban en los mismos métodos de la API: tres por HTTP, identificándose, y las órdenes del nodo directamente, como root. Por eso lo que aquí se aprende a mano es lo mismo que automatiza OpenTofu.
A2.6 Script de creación (sesión 12)
Objetivo Dos scripts, crea-entorno.sh y destruye-entorno.sh, que dado el nombre del entorno crean o borran su red y sus tres VM y se pueden ejecutar dos veces seguidas sin error, y una lectura y una creación reproducidas con curl desde el puesto de administración con el token de un usuario de prácticas, que borras al terminar. Son la primera vez que el curso crea infraestructura con un programa y no a mano, y lo que pide el criterio de los scripts de la evaluable.
Antes de empezar
- pre y la red de pro de la A2.5. Las pruebas de hoy se hacen contra
pro, que tiene sus VNets y ninguna VM desde que la A2.5 destruyó la 310: si los ID que crea el script (310, 320 y 330) estuvieran ocupados, los respetaría y la creación no se probaría de verdad. db01sigue apagada, como en la A2.5, porque hoy se encienden tres VM de prueba más.- Tu repositorio
entregas-5166en el puesto de administración (A2.4, paso 2). - Explicado en esta sesión: qm y pct, pvesh y la API REST con token.
Pasos
Primero las máquinas y después la red: el script de máquinas ya está en la teoría, y lo nuevo es añadirle la red. Luego pruebas los dos scripts como se prueba la idempotencia, ejecutando dos veces cada uno contra un entorno donde no pueden romper nada. La segunda mitad es la API desde fuera: un usuario de prácticas con su token, dos llamadas con curl desde el puesto de administración y la baja del usuario, que demuestra que un token se revoca sin tocar nada más.
-
Copia los dos scripts. En el nodo, crea
crea-entorno.shydestruye-entorno.shcopiando tal cual los dos scripts de qm y pct, que ya siguen la convención de ID del curso. -
Haz que el script cree también la red. Amplía
crea-entorno.shpara que, justo después delcasey antes de clonar, cree la zonalaby las cuatro VNets del entorno con su subred si no existen, y aplique el SDN. Con eso el script hace lo que pide la evaluable, crear la red y las VM de un entorno. Las subredes van sin gateway ni rango DHCP, como en la A2.5, y la comprobación previa es la misma idea queqm status: preguntar antes de crear.Pista:
pvesh getde una ruta que no existe termina con error, comoqm status: es la condición delif.$NET, el prefijo del bloque, ya lo define elcase. -
Prueba la idempotencia contra pro. Ejecuta dos veces cada script contra
pro, guardando la salida de cada ejecución encrea-1.log,crea-2.log,destruye-1.logydestruye-2.log, y apunta el código de salida de la segunda destrucción. La primera ejecución de cada uno demuestra que funciona; la segunda, que es idempotente. Al terminar, comprueba conqm listque no queda ninguna VM de la franja 310 a 330.destruye-entorno.sh devno se ejecuta nunca: borraríaweb01,app01ydb01, yapp01es la VM que Mantenimiento usa a diario desde el 15 de octubre. Tampocodestruye-entorno.sh pre, que se llevaría laweb01de prueba de la A2.5, evidencia de la evaluable. -
Crea un usuario de prácticas con su token. En el nodo,
cli@pvey su tokenlab, como en la API REST con token, con los permisos justos para el SDN. Guarda el token en el puesto de administración, fuera del repositorio, en~/.env-pve: una líneaPVE_TOKEN='PVEAPIToken=cli@pve!lab=<secreto>'que cargas consource.Pista: el secreto se imprime una sola vez. Escribe el fichero con un editor y con las comillas simples, que protegen el
!. -
Reproduce dos llamadas desde fuera. Con
curl, desde el puesto de administración y contra la IP del nodo en el aula, haz la lectura de las VNets y la creación de una VNet de pruebadevtesten la zonalab, con su Apply. Cuando la veas en la consola web, bórrala con el mismo token y vuelve a aplicar. Es lo mismo que hará OpenTofu, y la forma de depurarlo cuando falle.Pista: el Apply es un
PUTa/cluster/sdny el borrado, unDELETEa la ruta de la VNet, comopvesh setypvesh delete. -
Revoca el acceso y recoge las evidencias. Borra
cli@pve, que se lleva su token y sus permisos, comprueba que el mismocurlde lectura devuelve ahora 401 y borra~/.env-pve: un acceso que ya no hace falta no se deja vivo. Lleva aut2/a26los dos scripts, los cuatro.log, las salidas de loscurly el 401, y comprueba antes del commit quePVEAPITokenno aparece en el repositorio.Pista: el nodo copia con
scpal puesto de administración sin contraseña, porque su clave va en la plantilla.
Comprobación La segunda ejecución de crea-entorno.sh imprime "ya existe, no se toca" tres veces; la segunda de destruye-entorno.sh termina con código 0 sin salida; el curl de lectura devuelve JSON con las VNets de los tres entornos; devtest aparece y después desaparece de la consola web; ningún secreto está en el repositorio; después de borrar cli@pve, el mismo curl devuelve 401.
Para practicar Guarda en ut2/a26 del repositorio los dos scripts, los cuatro .log, las salidas de los curl y el 401 del paso 6: la memoria de la evaluable los usa tal cual.
Si te sobra tiempo Haz que crea-entorno.sh cree también el router del entorno con sus patas e IP fijas.
Sesión 13 · Práctica evaluable
Hoy cierras la memoria de la unidad: esquema, direccionamiento, configuración, scripts y las cinco pruebas documentadas. La memoria demuestra los dos criterios de la unidad, que las VPC están creadas, diferenciadas por entorno y aisladas, y que las direcciones, los nombres y la comunicación entre zonas son correctos. No pide nada nuevo: cada punto sale de un paso de las hojas A2.1 a A2.6, indicado entre paréntesis. Los diez primeros minutos son para aclarar dudas del enunciado. Empieza por recorrer la lista de comprobación de abajo, porque lo que falle hay que rehacerlo repitiendo su paso antes de escribir nada; después reúne las evidencias punto por punto y redacta. Enciende db01 al empezar (qm start 130), que está apagada desde la A2.5.
Entrega una memoria (máximo 6 páginas, PDF) con:
- Esquema de red de los tres entornos y tabla de direccionamiento con la justificación de tamaños (A2.1, pasos 1 a 3).
- Configuración del SDN:
/etc/network/interfaces.d/sdn(A2.2, paso 5) y las VNets de pre y pro (A2.5, paso 1). - Configuración de dnsmasq de un entorno, comentada (A2.3, paso 4).
- Scripts de creación y destrucción, con la salida de la segunda ejecución consecutiva (A2.6, pasos 1 a 3): enlace a
ut2/a26de tu repositorio de entregas, o anexo. - Cinco pruebas documentadas con la plantilla: conectividad intra-entorno, captura de tráfico y resolución DNS (A2.4, paso 6), y aislamiento inter-entorno y concesión DHCP (A2.5, paso 6).
Checklist antes de entregar:
- Los tres bloques no se solapan entre sí ni con la red del aula (A2.1, paso 4).
-
ip -br link show type bridgeen el nodo muestra las cuatro VNets de cada entorno enUP(A2.5, paso 1). - Cada VM recibe IP, gateway, DNS y dominio de búsqueda por DHCP (A2.3, pasos 5 y 6).
- El
web01de dev resuelve y alcanzadb01.dev.labpor el 5432 (A2.4, paso 3). - Desde dev no se alcanza ningún router ni VM de pre ni de pro (A2.5, pasos 3 y 5).
- Los scripts se ejecutan dos veces seguidas sin errores (A2.6, paso 3).
- Ningún token ni contraseña aparece en la memoria ni en el repositorio, y el usuario de prácticas ya no existe (A2.6, paso 6).
| Criterio | RA1 | Peso | Sale de |
|---|---|---|---|
| VPC creadas, diferenciadas por entorno y aisladas | b | 35 % | A2.2 y A2.5 |
| IP, DNS y comunicación entre zonas correctas | c | 35 % | A2.3 y A2.4 |
| Pruebas documentadas con evidencias | b, c | 20 % | A2.4, paso 6, y A2.5, paso 6 |
| Scripts funcionales e idempotentes, que crean la red y las VM de un entorno | b | 10 % | A2.6, pasos 1 a 3 |
Cuando la memoria esté entregada, destruye la VM de prueba de pre (210), cuyo DORA ya está en la memoria, y router-pro (300): pro se queda solo como red. Así, en enero, OpenTofu crea las VM de pre sin choques de ID.
Errores frecuentes en el laboratorio
- Apply del SDN dice OK y no aparece ningún bridge. Falta
source /etc/network/interfaces.d/*en/etc/network/interfaces, o el nodo no usa ifupdown2. Se comprueba conip link show devfronty concat /etc/network/interfaces.d/sdn. - La VM no recibe IP. Orden de comprobación:
qm config ID | grep net0(¿está en el bridge correcto?),journalctl -u dnsmasqen el router (¿llega el DISCOVER?),dnsmasq --test(¿sintaxis?), yss -ulnp | grep :67(¿escucha en la interfaz de esa subred?). El 80 % de las veces es una VM conectada avmbr0en vez de a la VNet, o dnsmasq escuchando enens20cuando la subred está enens21. - El DHCP del SDN y el dnsmasq del router compiten. Si queda activo el DHCP de la zona y además el router responde, las VM reciben dos ofertas y cogen la primera que llega; unas veces el gateway es el nodo y otras el router. Al pasar a la A2.3 hay que borrar el rango DHCP y el gateway de las cuatro subnets del SDN y aplicar: mientras la subnet tenga gateway, el nodo mantiene el
.1en su bridge y hay dos máquinas con la misma IP. - front llega a back por ping pero no a un puerto.
ip_forwardestá bien (el ping cruza), así que es el servicio:ss -tlnpen el destino, y comprobar si escucha en127.0.0.1o en0.0.0.0. PostgreSQL traelisten_addresses = 'localhost'por defecto. - ping funciona y las transferencias grandes se cuelgan. MTU. Ocurre con zonas VXLAN sin ajustar la MTU de las VM a 1450. Se confirma con
ping -M do -s 1472 destino(fragmentación prohibida, 1500 bytes totales): si falla, hay que bajar la MTU. digresuelve pero la aplicación no. La aplicación usa el/etc/resolv.confde la VM, no el servidor pasado adigcon@. Conviene mirarresolvectl statusocat /etc/resolv.conf: si cloud-init dejó el DNS del aula, el DHCP no está enviandooption:dns-server.- El puesto de administración llega a
10.10.0.1pero no a los otros tres.1ni a las VM de front, back y data. Falta la ruta a10.10.0.0/16, o la unidad no se ha ejecutado tras un reinicio:ip renadmin01tiene que mostrarla, ysystemctl status ruta-lab.service, deciractive (exited). Si la unidad falla, casi siempre es el nombre de la tarjeta:ip -br adice cuál es la de gestión. - Desde el puesto de administración no se puede saltar a ninguna VM (
Permission denied (publickey)). Conssh -A, el bastión solo presta la clave si está cargada en el agente del puesto:ssh-add -ltiene que listarla. En Windows el servicio del agente viene desactivado; si no se puede activar, saltar conssh -Jdesde el puesto no lo necesita. nmap -sncontra otro entorno dice0 hosts uppero un ping al router de pre responde. Un0 hosts upsolo dice que nadie contestó a las sondas, y no descarta que haya camino; el ping sí demuestra que hay una ruta que no debería existir. Hay que revisar si el router de dev tiene pata en la VNet de pre por error o si falta el blackhole (ip renrouter-dev, ysystemctl status blackhole.servicesi ha desaparecido tras un reinicio).- El script de creación falla la segunda vez con
VM 310 already exists. No es idempotente: falta la comprobación conqm statusantes de clonar. En la evaluable se ejecuta dos veces delante del profesor. qm clonefalla conlinked clone feature is not supportedo el clon tarda una eternidad. Sin--fullsobre almacenamiento que no soporta snapshots (directorio, NFS sin qcow2) no se puede clonar enlazado; con--fullse copia todo lo escrito. La plantilla del curso es de 20 GB nominales con unos 3 GB escritos, y lo que alarga el clon completo es lo escrito, no el tamaño nominal: conviene no instalar nada en la plantilla que no necesiten todos los clones.- El token de API devuelve
401 authentication failure. La cabecera es exactamenteAuthorization: PVEAPIToken=usuario@realm!nombre=secreto, con!y=literales; enbashel!dentro de comillas dobles dispara la expansión del historial. Hay que usar comillas simples.
Los enlaces para ampliar y los apartados que van más allá de lo que se hace en clase están en Para ampliar.
UT3 · Seguridad por capas: DMZ externa, DMZ interna y zona interna
La UT2 dejó una VPC por entorno (dev, pre, pro) con cuatro VNets, una por zona (gestión, front, back y data), y un router con una pata en cada una, con el enrutado entre ellas funcionando. Funcionaba demasiado bien: en la A2.4 se comprobó con nc que web01, en front, llegaba al 5432 de db01, en data, y lo mismo vale para cualquier máquina de cualquier zona hacia cualquier puerto de otra. Si alguien entrase en el proxy, que es lo único que se ve desde fuera, tendría la base de datos al alcance sin ningún filtro por medio. En esta unidad ese router se sustituye por un cortafuegos, cada zona recibe su papel de seguridad y esa red abierta se convierte en una red por capas donde cada salto está justificado, permitido de forma explícita y registrado.
La unidad sigue el orden en que se haría en una empresa. Primero se pone el cortafuegos en el sitio del router sin que las máquinas lo noten; después se le enseña qué dejar pasar y se publica la web hacia fuera con un certificado de la CA del curso; luego cada pieza del servicio pasa a su zona, con una regla por salto y la documentación de cada regla, y dos clientes que comparten la infraestructura quedan separados. Al final se demuestra con nmap y tcpdump (un escáner de puertos y un capturador de tráfico) que el aislamiento es real, y con todo ello se escribe el informe de la práctica evaluable. Lo que se construye aquí no se tira: el cortafuegos, sus reglas y la CA del curso se usan hasta el final del curso, también en Mantenimiento.
Sesión 14 · Modelo de seguridad por capas
Hoy router-dev deja su sitio a un cortafuegos, y antes de tocar nada hay que tener claro para qué. Por eso la teoría va de lo general a lo concreto: primero el modelo de seguridad por capas, que dice por qué se separa la red en zonas y qué papel tiene cada una, y cómo encaja en las cuatro VNets que ya existen; después las dos formas de colocar el cortafuegos, con uno o con dos; y al final cómo decide un cortafuegos con estado qué paquete pasa, que es lo que determina cuántas reglas hacen falta y en qué dirección se escriben. Lo que viene detrás, OPNsense con su instalación y el relevo de router-dev, es material de consulta para la hoja, y la variante con nftables queda apuntada al final. La hoja no escribe todavía ninguna regla de paso entre zonas: pone el cortafuegos en el sitio del router sin que ninguna VM se quede sin red, con la IP .1 en cada zona, el DHCP y el DNS traspasados, la regla 0 que deja a todas las zonas preguntar al cortafuegos por nombres y por la hora, y la consola web accesible solo desde gestión. Desde ese momento todo lo que cruza de una zona a otra pasa por el cortafuegos, y lo que sale de las zonas de servicio se queda en él. Las reglas de paso empiezan en la sesión siguiente, el 25 de noviembre.
Defensa en profundidad y zonas
El problema: un solo control nunca basta. Ningún control de seguridad es perfecto. El proxy tendrá una vulnerabilidad algún día, alguien subirá una imagen de contenedor con una librería vieja, un administrador reutilizará una contraseña. Si la seguridad de toda la red depende de que una de esas piezas no falle, un solo fallo basta para perderlo todo, que es justo lo que pasaba en la red abierta de la UT2.
Qué es la defensa en profundidad. Es el principio de poner varios controles en serie, asumiendo que cada uno fallará, de modo que cada capa que atraviesa un atacante le cuesta trabajo, le lleva tiempo y deja rastro en un log que alguien (o algo) está mirando. La idea y el nombre vienen de la estrategia militar: en lugar de una sola línea que tiene que pararlo todo, varias líneas sucesivas que frenan al atacante y dan tiempo a reaccionar.
Cómo se aplica en una red: las zonas. La forma clásica de organizarlo en red es agrupar las máquinas en zonas según lo expuestas que están y lo que guardan, y separar las zonas con un cortafuegos que solo deja pasar lo imprescindible de una a la siguiente. Lo que se ve desde Internet va en la zona más expuesta, porque es lo primero que caerá si algo cae, y lo más valioso, los datos, en la más profunda. A una zona expuesta de este tipo se le llama DMZ, zona desmilitarizada, otro término militar: una franja entre dos bandos que no es del todo de ninguno. En el curso hay dos DMZ, la externa y la interna, y detrás de ellas la zona interna:
| Zona | Qué aloja | Quién puede entrar | Hacia dónde sale |
|---|---|---|---|
| Exterior (WAN / Internet) | Usuarios, atacantes | Nadie | DMZ externa |
| DMZ externa | Lo que debe verse desde fuera: proxy inverso, balanceador, web estática, concentrador VPN | Internet, en puertos concretos (80/443) | DMZ interna, en puertos concretos |
| DMZ interna | Aplicación / API, colas, caché | DMZ externa | Zona interna, en puertos concretos |
| Zona interna | Bases de datos, almacenamiento, backups | DMZ interna y administradores | Nada hacia fuera, salvo actualizaciones puntuales |
| Gestión | Consola del firewall, SSH, Proxmox, monitorización | Administradores | Todas las zonas, solo en puertos de gestión |
Cada zona existe para proteger algo. La DMZ externa, para que el único que habla con Internet sea un proxy que no guarda nada de valor; la DMZ interna, para que la aplicación, que tiene la lógica del servicio y las credenciales de la base de datos, no hable nunca directamente con Internet; la zona interna, para que a los datos solo llegue la aplicación. La gestión va aparte porque desde ella se llega a todo: es la zona que más hay que proteger, y por eso las zonas de servicio solo entran en ella por excepciones escritas y justificadas, las de la matriz de reglas.
Las cuatro reglas del juego. Los principios que gobiernan las reglas son cuatro, y aparecen repetidos en cualquier auditoría:
- Denegar por defecto: todo lo que no está permitido expresamente se bloquea y se registra. La lista de reglas es una lista blanca, porque una lista negra solo bloquea lo que a alguien se le ocurrió prever.
- Tráfico solo hacia dentro por saltos: Internet nunca habla con la zona interna; la web nunca habla con la base de datos sin pasar por la aplicación. Cada zona solo inicia conexiones hacia la inmediatamente más profunda.
- Mínima exposición: un servicio en DMZ externa solo expone el puerto que necesita. La gestión (SSH, consola web, API de Proxmox) va por una red aparte que no es alcanzable desde ninguna zona de servicio.
- Registro: todo lo denegado, y todo lo permitido hacia zonas sensibles, queda en un log con marca de tiempo, regla que lo decidió, origen y destino. Sin registro, un ataque frenado no se distingue de uno que no ha ocurrido, y nadie se entera de que alguien lo está intentando.
La comparación con la red plana de router-dev es inmediata: allí una vulnerabilidad en el proxy daba acceso directo a la base de datos y al hipervisor; aquí cada capa que cae deja al atacante delante de otro filtro. El recorrido completo, capa por capa y con lo que frena cada una, está en Qué frena cada capa.
Mapa sobre la VPC de la UT2
No hay que rehacer la red. Las cuatro VNets de dev ya están, y su diseño ya tomó la decisión que hace posible todo lo que viene: una VNet por zona, es decir, un bridge distinto por zona. Entre dos bridges distintos no hay más camino que una máquina con una pata en cada uno, y esa máquina es el único sitio por el que pasa el tráfico entre zonas: hasta hoy, router-dev; desde hoy, el cortafuegos. Si dos de estas subredes compartieran bridge, su tráfico no pasaría por el cortafuegos y no habría dónde filtrarlo.
Lo que cambia es el papel de cada una. La subred front pasa a ser la DMZ externa, back la DMZ interna, data la zona interna y gestión la red de administración. En el entorno dev del aula queda así:
| Zona | VNet en Proxmox | Red | Gateway (firewall) | Máquinas |
|---|---|---|---|---|
| DMZ externa | devfront | 10.10.1.0/24 | 10.10.1.1 | web01 (proxy) |
| DMZ interna | devback | 10.10.2.0/24 | 10.10.2.1 | app01 |
| Zona interna | devdata | 10.10.3.0/24 | 10.10.3.1 | db01 |
| Gestión | devmgmt | 10.10.0.0/24 | 10.10.0.1 | Puesto de administración, mon01 |
| Exterior | vmbr0 (bridge del aula) | La del aula | Router del aula | Todo lo demás |
La tabla tiene cinco zonas porque el exterior también cuenta: es la red del aula, por la que llega lo que viene de Internet, y el cortafuegos tiene una pata en ella igual que en las otras cuatro.
flowchart LR
INET["<b>Internet</b><br><small>red del aula</small>"]:::infra
FW{{"<b>Firewall</b><br><small>todo pasa por aquí</small>"}}:::act
WEB["<b>web01</b><br><small>proxy inverso · 10.10.1.10</small>"]:::pieza
APP["<b>app01</b><br><small>API · 10.10.2.10</small>"]:::pieza
DB["<b>db01</b><br><small>PostgreSQL · 10.10.3.10</small>"]:::dato
ADM["<b>Puesto admin</b><br><small>10.10.0.50</small>"]:::act
INET -->|443| FW
FW -->|443| WEB
WEB -->|28080| FW
FW -->|28080| APP
APP -->|5432| FW
FW -->|5432| DB
ADM -->|22, 443 gestión| FW
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxNingún salto entre capas es directo: todos vuelven a pasar por el cortafuegos, y por eso se puede filtrar cada uno por separado.
El cortafuegos hereda las direcciones del router. El cortafuegos es el gateway de todas las zonas, con la IP .1 en cada una, así que ningún paquete cruza de una subred a otra sin pasar por él. Es el papel que hacía router-dev, y OPNsense lo hereda entero: sus cuatro direcciones .1, su DHCP con las mismas reservas y su DNS con los mismos nombres. Que sean exactamente las mismas no es casualidad: las VM de las zonas reciben por DHCP como puerta de enlace el .1 de su zona y como DNS la 10.10.0.1, y si el cortafuegos ocupa esas direcciones, ninguna tiene que cambiar nada. router-dev se apaga cuando el relevo está hecho y se destruye al cerrar la evaluable de la unidad, el 9 de diciembre.
Y añade un servicio: la hora. Desde hoy las zonas de servicio dejan de salir a Internet, para que una máquina comprometida no pueda descargar herramientas ni sacar datos, así que tampoco llegan a los servidores de hora públicos. El cortafuegos pasa a ser su servidor de hora por NTP, el protocolo de sincronización de la hora. No es un detalle: con la hora mal, los logs de dos máquinas no se pueden cruzar, y un certificado puede parecer caducado o todavía no válido.
DMZ con uno y con dos cortafuegos
La pregunta. Con las zonas decididas, queda dónde se pone el cortafuegos: uno solo con una interfaz por zona, o varios en serie. Las dos formas son clásicas y cada una tiene su coste.
Un cortafuegos con una interfaz por zona. Es el esquema de arriba: un solo equipo con cinco interfaces, una por zona. Es el diseño habitual en pymes y en laboratorios porque es barato y toda la política está en un sitio. Su punto débil es evidente: si el cortafuegos cae, o alguien lo configura mal, todas las capas caen a la vez.
Dos cortafuegos en serie. El diseño de dos cortafuegos pone uno de cara a Internet (el "front-end" o perimetral) que solo permite tráfico hacia la DMZ, y otro detrás (el "back-end") entre la DMZ y la red interna. Un atacante que comprometa el primero sigue teniendo el segundo por delante. Con dos firewalls también se reparte la carga: el perimetral absorbe el ruido de Internet y el interno solo ve tráfico ya filtrado.
Fabricantes distintos, y lo que cuesta. Una recomendación clásica de las guías de seguridad perimetral es que los dos cortafuegos sean de fabricantes distintos. Una vulnerabilidad de ejecución remota en el software del firewall (las ha habido en todos los grandes fabricantes) afectaría a los dos si son iguales; con dos fabricantes, el atacante necesita dos exploits distintos. El coste es que operaciones tiene que administrar dos productos, dos ciclos de parches y la misma política en dos sintaxis, y por eso muchas empresas medianas acaban con un solo firewall bien mantenido en lugar de dos mal mantenidos. En la práctica, un cortafuegos único bien parcheado y revisado cada trimestre protege más que dos que nadie se atreve a tocar.
La elección del curso. En el laboratorio se monta el modelo de un cortafuegos con una interfaz por zona: es el caso típico de una empresa mediana, cuesta una sola VM de 1 GB en un laboratorio que va justo de memoria y deja toda la política en un sitio que se puede revisar de una vez. Quien quiera el de dos puede usar OPNsense como perimetral y un Debian con nftables como interno: fabricantes distintos, gratis, y con el material de OPNsense y de la alternativa con nftables.
Cortafuegos con estado
Lo que hay que entender antes de la primera regla. Antes de escribir la primera regla hay que entender cómo decide el cortafuegos qué paquete pasa, porque de eso depende cuántas reglas hacen falta y en qué dirección se escriben. La idea del apartado es una: el cortafuegos recuerda las conexiones que ya aceptó, así que solo hay que permitir el primer paquete de cada una.
El problema de un filtro sin estado. Los primeros cortafuegos, a finales de los años ochenta, eran filtros de paquetes sin estado (stateless). Un filtro así mira cada paquete de forma aislada, por su origen, su destino, su protocolo, su puerto y sus flags (los bits de la cabecera TCP que dicen qué tipo de paquete es). Una conexión TCP tiene paquetes en los dos sentidos, y un filtro así necesita una regla para cada uno. Para permitir que web01 abra una conexión a app01:28080 harían falta dos reglas, una para el SYN de ida (el primer paquete de una conexión TCP, el que pide abrirla) y otra para la respuesta de vuelta. Y la de vuelta tendría que permitir tráfico desde el puerto 28080 de app01 hacia cualquier puerto alto de web01, porque el cliente sale de un puerto que el sistema elige al azar en cada conexión (el puerto efímero). Eso es un agujero: cualquier cosa que se origine en app01 con puerto de origen 28080 pasaría.
Cómo funciona uno con estado. Un cortafuegos con estado (stateful), el tipo que se generalizó en los años noventa y que hoy usan todos, recuerda las conexiones. Cuando ve el SYN de web01:43812 hacia app01:28080 y una regla lo permite, crea una entrada en su tabla de estados con la tupla (protocolo, IP origen, puerto origen, IP destino, puerto destino) y el estado de la conexión. Cuando llega el SYN-ACK de vuelta (la respuesta con la que el servidor acepta la conexión), no evalúa las reglas: busca en la tabla, encuentra la entrada, comprueba que el paquete es coherente con el estado (números de secuencia, flags) y lo deja pasar. Lo mismo con todos los paquetes siguientes en ambas direcciones, hasta que ve el cierre (FIN, o RST si la conexión se corta de golpe) o la entrada expira por inactividad.
sequenceDiagram
participant W as web01:43812
participant F as Cortafuegos
participant T as Tabla de estados
participant A as app01:28080
W->>F: SYN
F->>F: evalúa las reglas · hay una que lo permite
F->>T: crea la entrada (tcp, web01:43812, app01:28080)
F->>A: SYN
A->>F: SYN-ACK
F->>T: ¿coincide con algún estado?
T-->>F: sí, y el paquete es coherente
Note over F: no vuelve a mirar las reglas
F->>W: SYN-ACK
W->>A: datos en los dos sentidos
W->>F: FIN
F->>T: cierra la entradaSolo hay que permitir el primer paquete de cada conexión. Quien lo tiene claro escribe la mitad de reglas y entiende el error de «abre pero no responde».
Dónde está en Linux y en OPNsense. En Linux este mecanismo se llama conntrack (de connection tracking, seguimiento de conexiones) y es un módulo del kernel (nf_conntrack) que usan tanto iptables (el antecesor de nftables) como nftables. En OPNsense lo hace pf, el filtro de paquetes sobre el que está construido, que nació en OpenBSD y que FreeBSD, la base de OPNsense, incorporó después; su tabla se ve en Firewall → Diagnostics → States. Los nombres de los estados que siguen son los de conntrack, que son los que se escriben en las reglas de nftables; pf usa otros nombres para lo mismo. De forma simplificada:
| Estado | Significado |
|---|---|
new |
Primer paquete de una conexión que no está en la tabla. Es el único que se evalúa contra las reglas. |
established |
Paquetes de una conexión ya aceptada, en cualquier dirección. |
related |
Conexión nueva que el kernel sabe que pertenece a otra existente: el canal de datos de FTP, o un ICMP "puerto inalcanzable" en respuesta a un UDP saliente. |
invalid |
Paquete que no encaja con ningún estado ni es un inicio válido (un ACK suelto, un SYN-ACK sin SYN previo). Se descarta siempre. |
Para UDP e ICMP, que no tienen conexión, conntrack crea "pseudo-estados" basados en la tupla y un temporizador: si una máquina envía una consulta DNS al puerto 53 de un servidor, la respuesta que llegue desde ese servidor y ese puerto en los 30 segundos siguientes (el valor por defecto en Linux) se considera established.
Qué cambia al escribir reglas. Solo hay que escribir la regla del primer paquete, en la dirección en que se inicia la conexión. Es lo que hace que la política "DMZ externa puede iniciar hacia DMZ interna:28080, pero DMZ interna no puede iniciar nada hacia DMZ externa" se escriba con una sola línea. Cómo se consigue depende de la herramienta:
- En OPNsense no se escribe nada más. Cada regla Pass crea su estado sola (es la opción por defecto de toda regla, keep state), y las respuestas encajan en él antes de llegar a ninguna regla. Por eso en las reglas del curso no aparece nunca una regla para el tráfico de vuelta.
- En nftables hay que escribirlo. Una regla genérica
ct state established,related acceptal principio de la cadena. De ahí sale un error clásico: si esa regla no está, o está después de undrop, la conexión abre (el SYN pasa) pero nunca responde, y en tcpdump aparecen SYN, SYN-ACK... y el SYN-ACK muriendo en el firewall.
La tabla de estados no es infinita y sus entradas caducan: cuántas caben, qué ocurre cuando se llena y cuánto vive una conexión inactiva está en La tabla de estados por dentro.
OPNsense
Material de consulta
Esto no se explica en clase: es lo que necesitan la preparación de casa de la A3.1 y todos sus pasos.
Este apartado monta el cortafuegos del laboratorio: una VM con una pata en cada zona, la consola web solo accesible desde gestión, y el relevo de router-dev sin que ninguna máquina se quede sin red. Los menús cambian de una versión a otra (la 26.1 rebautizó el port forward como Destination NAT, y la 26.7 cambió la página de reglas por una nueva), así que más que los menús importan tres ideas, que valen para cualquier versión y para pfSense: las reglas se escriben con nombres (aliases), se evalúan en la interfaz por la que entra el paquete, y nada se aplica hasta pulsar Apply.
Qué es y de dónde sale. OPNsense es una distribución de cortafuegos basada en FreeBSD y en el filtro pf, con interfaz web y desarrollo abierto. Nació en 2015 como bifurcación de pfSense y las dos son funcionalmente muy parecidas: si en una empresa aparece pfSense, todo lo de esta sección aplica cambiando algún nombre de menú. Saca dos versiones al año, en enero y en julio, numeradas como año.mes (la 26.1 es la de enero de 2026 y la 26.7, la de julio), y en el curso se instala la última 26.x. Se usa OPNsense y no pfSense porque la interfaz es más limpia, parchea más rápido y su edición gratuita trae todo lo que el curso necesita.
Instalación en Proxmox
Una VM normal, con una tarjeta por zona. Se instala como una VM normal, con el ID 109 (el último de la franja de gestión de dev): imagen dvd o vga de la 26.x desde opnsense.org, 2 vCPU, 1 GB de RAM y 20 GB de disco, que es lo que le reserva el presupuesto de memoria del laboratorio. Con la instalación base y sin plugins de inspección basta; si el instalador va justo, se le suben a 2 GB mientras dura y se vuelve a 1 GB al terminar. Lo que la distingue es el número de interfaces: una por zona, cinco en este caso, cada una conectada a su bridge o VNet de Proxmox, y todas con el modelo VirtIO (el dispositivo paravirtualizado de KVM, el más rápido en Proxmox).
El orden de las tarjetas importa. Dentro de la VM, FreeBSD llama a las tarjetas VirtIO vtnet0, vtnet1... en el orden en que aparecen en el bus PCI, y Proxmox las coloca en el bus según su número (net0, net1...). Así que el número que recibe cada tarjeta al crearla decide qué vtnet será dentro, y con eso qué zona queda detrás de cada interfaz de OPNsense. La tabla del curso, que es la que manda:
| Interfaz OPNsense | vtnet | Bridge / VNet Proxmox | IP |
|---|---|---|---|
| WAN | vtnet0 | vmbr0 (aula) | DHCP del aula o fija |
| DMZEXT | vtnet1 | devfront | 10.10.1.1/24 |
| DMZINT | vtnet2 | devback | 10.10.2.1/24 |
| INT | vtnet3 | devdata | 10.10.3.1/24 |
| MGMT | vtnet4 | devmgmt | 10.10.0.1/24 |
Conviene apuntar qué MAC corresponde a qué bridge antes de arrancar: el asistente de la consola pide asignar cada vtnetN a su papel, y la MAC es la única forma de saber cuál es cuál sin adivinar.
Lo primero, cerrar la consola. Tras la instalación, la interfaz web escucha en todas las interfaces, con la regla "anti-lockout" (la que impide cerrarse el acceso a la propia consola) activa en LAN. La consola web es la pieza más valiosa de la red, porque quien entra en ella cambia todas las reglas, así que lo primero es dejarla escuchando solo en MGMT (System → Settings → Administration, "Listen interfaces"). Si un error deja fuera, la consola de Proxmox de la VM tiene un menú de texto con la opción "Reset to factory defaults" y otra para reasignar interfaces; no hace falta reinstalar.
El relevo de router-dev
El problema. Hoy router-dev es el .1 de las cuatro subredes, su servidor DHCP y su DNS, y el cortafuegos tiene que pasar a ser todo eso sin que ninguna VM se quede sin red. No pueden convivir: dos máquinas con la misma .1 en la misma red se pisan (el ARP de esa dirección salta de una MAC a otra y el ping funciona a ratos), y dos servidores DHCP en la misma red reparten cada uno a su manera. Por eso el relevo se hace como un cambio de guardia, en tres tiempos:
- Preparar sin aplicar. El cortafuegos recibe sus direcciones definitivas en las interfaces internas, pero con las interfaces apagadas, y una dirección provisional en gestión, la 10.10.0.2, para poder administrarlo mientras tanto. El DHCP y el DNS se copian de
router-dev: los mismos rangos, las mismas reservas por MAC y los mismos nombres, porque son los que esperan las VM. - Cambiar.
router-devsuelta sus direcciones internas y su dnsmasq, y en ese momento el cortafuegos activa las suyas y arranca sus servicios. - Comprobar y retirar. Solo cuando una VM ha renovado su concesión con el cortafuegos y conserva su IP se apaga
router-dev, sin borrarlo, por si hubiera que deshacer.
Hay margen para hacerlo con calma: cada VM tiene una concesión de 12 horas, la de dev.conf, así que aunque el DHCP desaparezca un rato, ninguna pierde su IP.
Quién hace el DHCP y quién el DNS. OPNsense trae el mismo dnsmasq que router-dev, en Services → Dnsmasq DNS & DHCP, y es el que hace el DHCP: las reservas se trasladan una a una con la MAC, la IP y el nombre de dev.conf, y si cada rango lleva el dominio dev.lab, los nombres <host>.dev.lab salen solos de ellas. Pero en una instalación nueva el puerto 53, el del DNS, no lo atiende dnsmasq sino Unbound, el servidor DNS que OPNsense trae activado, y Unbound no sabe nada de las reservas. La documentación de OPNsense lo resuelve en su ejemplo "DHCPv4 with DNS registration": dnsmasq pasa a escuchar en el 53053 y Unbound le reenvía (Query Forwarding) las preguntas de los dominios locales. En el laboratorio basta un reenvío, el del dominio lab, que incluye dev.lab y los nombres de gestión (mon01.lab con sus alias, y los que añaden después las unidades de integración continua). El mismo ejemplo marca tres opciones de dnsmasq que el laboratorio necesita: "DHCP fqdn", que da a cada máquina su nombre con el dominio; "DHCP register firewall rules", que abre paso al DHCP en cada interfaz, porque si no lo cortaría la denegación por defecto; y "Do not forward to system defined DNS servers", para que la pregunta por un nombre del laboratorio que no existe termine en dnsmasq y no dé vueltas entre los dos servidores.
Lo que deja pasar el primer día: la regla 0. En cuanto se activan las interfaces internas, se aplica la denegación por defecto: todo lo que entra por una interfaz sin reglas se descarta, y eso incluye las preguntas al propio cortafuegos. El DHCP tiene sus reglas automáticas, pero el DNS y la hora no, así que sin una regla ninguna VM resolvería un nombre. Por eso la primera regla del curso, la 0, se escribe en el mismo momento del relevo. Va en un grupo de interfaces, ZONAS, que reúne las cuatro zonas, para escribirla una sola vez para todas; su destino es This Firewall, que en OPNsense quiere decir cualquier dirección del propio cortafuegos; y deja pasar el DNS (53) y la hora (123), más el ping, que es la primera herramienta de diagnóstico. Los dos puertos van en un alias, p_infra (un alias es un nombre que se da a una lista de puertos o de direcciones). Lo que la regla 0 no deja pasar es la consola web: el 443 del cortafuegos no está en p_infra.
La excepción de estos días: gestión. OPNsense crea al instalarse unas reglas que dejan salir de LAN (la futura MGMT) hacia cualquier sitio, y por eso, después del relevo, desde el puesto de administración se sigue llegando a todo. Esas reglas se sustituyen por las propias de gestión en la sesión siguiente, el 25 de noviembre.
Alternativa: nftables en una VM Linux
La misma idea sin OPNsense. El mismo modelo de zonas se puede montar con un router Debian 13 con cinco interfaces y nftables, la herramienta con la que se escriben las reglas del cortafuegos del kernel de Linux, Netfilter. nftables entró en el kernel en 2014 para sustituir a iptables, y desde Debian 10 es lo que hay por debajo incluso cuando se usa la orden iptables; Docker y el firewall de Proxmox escriben sus reglas en ese mismo Netfilter. Se pierde la interfaz web y sus comodidades (aliases con resolución de nombres, vista de estados en directo) y se gana un fichero de texto de unas cuarenta líneas que se versiona en git como cualquier otro código.
Cuándo se elige cada uno. Se elige nftables cuando el cortafuegos tiene que quedar descrito en código desde el primer día, cuando no compensa mantener una VM más con su propio sistema operativo, o cuando quien lo administra ya trabaja en la línea de comandos. Se elige OPNsense cuando lo van a tocar varias personas, cuando hacen falta las herramientas de diagnóstico integradas o cuando interesa tener en la misma caja el proxy inverso, la VPN y la detección de intrusos. En el curso se usa OPNsense, así que esta alternativa no se explica en clase.
Dónde está el material. Cómo se lee un fichero de nftables (tablas, cadenas, hooks y políticas), el fichero /etc/nftables.conf completo del router del laboratorio, el recorrido de un paquete por los puntos donde el kernel puede filtrar y el orden en que se evalúan las cadenas están en nftables: el fichero de reglas completo. La A3.1 remite a ese material, desde su «Antes de empezar», para quien quiera montar esta variante.
A3.1 Instalar el firewall (sesión 14)
Objetivo Un OPNsense con una pata en cada una de las cinco zonas, con la IP .1 en cada red, cuya consola web solo responde desde MGMT, y web01 y db01 usándolo como puerta de enlace, como DNS y como servidor de hora. Es la pieza sobre la que se construye el resto de la unidad: desde hoy, todo lo que cruza de una zona a otra pasa por un sitio donde se puede filtrar y registrar. Lo difícil no es instalarlo, que se trae hecho de casa, sino el relevo: que ocupe el sitio de router-dev sin que ninguna VM note el cambio.
Antes de empezar
- La VPC dev de la UT2: las cuatro VNets,
router-devrepartiendo IP y nombres,web01(10.10.1.10) endevfrontydb01(10.10.3.10) endevdata.app01ymon01siguen envmbr0hasta la A3.3, con sus reservas por MAC endev.confdesde la A2.3. - El puesto de administración (VM 105, 10.10.0.50, de la A2.4), con su ruta
10.10.0.0/16 via 10.10.0.1: desde él administras el firewall toda la unidad. Entra conssh -A ops@<IP de aula de admin01>, que le presta tu clave para saltar aweb01y adb01. router-devsigue siendo el.1de las cuatro subredes: hasta el relevo del paso 5, las interfaces internas del firewall se configuran sin activar y MGMT lleva una dirección provisional.- La VM del firewall instalada y los paquetes de
web01ydb01puestos, con la preparación de casa del bloque siguiente. - Explicado en clase: el modelo de zonas, el mapa sobre la VPC y qué es un cortafuegos con estado. De consulta, para la preparación y todos los pasos: OPNsense, con su instalación y el relevo de router-dev. La variante con nftables en una VM Debian está en Para ampliar.
Preparación antes de la sesión: la VM del firewall, instalada
Son unos veinte minutos de clics que no dependen de nadie: se traen hechos de casa.
- Sube a Proxmox la ISO
dvdde OPNsense 26.x (desde casa, como la de la A1.1: treinta descargas a la vez saturan el aula) y crea la VM 109 con los recursos de Instalación en Proxmox y sus cinco NIC VirtIO en el orden exacto de aquella tabla, porque FreeBSD las numera por orden de bus PCI. Apunta la MAC de cada NIC: es la única forma de saber quévtnetes cada zona. - Instala con las opciones por defecto (usuario
installer, contraseñaopnsense), cambia la contraseña de root, retira la ISO y reinicia. - Mientras
web01ydb01aún salen a Internet porrouter-dev, instala lo que usarán las hojas del 25 y el 27 de noviembre, porque tras el relevo ya no salen:nginx nmap netcat-openbsdenweb01ypostgresql prometheus-postgres-exporter nmap netcat-openbsdendb01.
Pasos
Vas a sustituir router-dev por el cortafuegos en los tres tiempos del relevo. En los cuatro primeros pasos lo preparas todo sin pisar a router-dev, que sigue siendo el .1 de las cuatro redes: compruebas el punto de partida, asignas cada tarjeta a su zona, cierras la consola y copias el DHCP y el DNS. En el paso 5 haces el cambio en un solo movimiento y abres la regla 0 en ese mismo momento, y en el 6 compruebas que ninguna VM ha notado nada antes de apagar el router. Si vas justo de tiempo, lo que no puede quedarse a medias es el relevo: un cortafuegos preparado y sin activar no estorba a nadie, pero uno activado a medias deja las zonas sin red.
-
Comprueba el punto de partida. La VM 109 tiene que arrancar sin la ISO hasta el menú de OPNsense, con cada tarjeta en el bridge que dice la tabla de Instalación en Proxmox. Comprueba también que ninguna subnet del SDN conserva gateway ni rango DHCP, y si alguna los tiene, bórralos y aplica: un gateway olvidado en el SDN es un segundo
.1en esa red, y en el relevo chocaría con el cortafuegos.Pista: si no traes la VM hecha, hazla ahora sin explorar menús: lo que no puede quedarse sin tiempo es el relevo del paso 5.
-
Asigna cada tarjeta a su zona. Es el primer tiempo del relevo: preparar sin aplicar. Desde la consola de la VM, deja solo lo imprescindible para llegar a la web: WAN en
vtnet0por DHCP, y LAN envtnet4con la dirección provisional10.10.0.2/24y sin DHCP, porque en gestiónrouter-devsigue repartiendo direcciones. Desde la consola web, asignavtnet1avtnet3como DMZEXT, DMZINT e INT, con el.1/24de su zona, sin gateway (la única puerta de enlace del cortafuegos es la de la WAN) y sin marcar "Enable interface", y renombra LAN a MGMT. Las internas quedan con su dirección definitiva pero apagadas: activarlas ahora sería poner un segundo.1en cada red.Pista: la 10.10.0.2 solo existe dentro de gestión: llega a ella con un túnel por el puesto de administración (
ssh -L 28443:10.10.0.2:443 ops@<IP de aula de admin01>) y abrehttps://localhost:28443. -
Cierra la consola a todo lo que no sea gestión. Deja la consola web escuchando solo en MGMT, como dice Instalación en Proxmox: desde cualquier otra zona, la consola del cortafuegos no tiene que existir. No desactives la regla anti-lockout: es la que te garantiza el acceso a la consola hasta que escribas las reglas propias de MGMT, el 25 de noviembre.
-
Prepara el DHCP y el DNS sin aplicarlos. Copia en el cortafuegos, con las interfaces internas aún apagadas, lo que hoy da
router-dev: DHCP en las cuatro zonas, con el rango.100a.199y las cuatro reservas por MAC de tudev.conf(web0110.10.1.10,app0110.10.2.10,db0110.10.3.10 ymon0110.10.0.20), y DNS con el dominiodev.lab,api.dev.laben la 10.10.1.10 ymon01.lab(10.10.0.20) con los aliasgrafana.lab,prometheus.labygitea.lab. Las reservas de app01 y mon01 no se usan hasta el traslado del 27 de noviembre, pero tienen que estar ya, porque son las que les darán su IP en la VPC; y los nombres demon01.labson los que usa Mantenimiento desde ese día.Pista: es Services → Dnsmasq DNS & DHCP, con el reparto entre dnsmasq y Unbound de El relevo de router-dev. Si dejas vacíos el router y el DNS de cada rango, anuncia la IP de la interfaz, que es el
.1. -
Haz el relevo y abre lo mínimo. En un solo movimiento: deja
router-devsin DHCP ni IP internas y, en el firewall, activa DMZEXT, DMZINT e INT, pasa MGMT a la 10.10.0.1 y arranca el DHCP, el DNS y el servidor de hora. Crea en seguida la regla 0, porque desde que se activan las interfaces la denegación por defecto corta el DNS y la hora: en la pestaña de un grupo de interfacesZONAScon las cuatro zonas, dos reglas Pass hacia This Firewall, una TCP/UDP a un alias de puertosp_infra(53 y 123) y otra ICMP Echo Request, con la descripción "0 DNS, hora y ping al cortafuegos".Pista: en
router-dev, entrando por su IP del aula (ens18, que no se toca), basta parardnsmasqy bajarens19aens22. Al cambiar la IP de MGMT, rehaz el túnel con la 10.10.0.1. -
Cierra el relevo y comprueba que nadie lo ha notado. Es el tercer tiempo del relevo. Antes de apagar nada, comprueba que
web01renueva su concesión con el firewall y conserva la 10.10.1.10: es la prueba de que las reservas se han copiado bien. Ponweb01ydb01a tomar la hora del.1de su zona, que desde hoy es el único servidor de hora al que llegan, y apagarouter-devsin borrarlo: se queda así hasta la evaluable del 9 de diciembre, por si hubiera que deshacer el relevo. Por último, haz que el puesto de administración resuelva con el DNS del cortafuegos: no lo recibe por DHCP, porque en gestión tiene IP fija, y el que usa ahora no conoce los nombres del laboratorio.Pista:
networkctl renew ens18fuerza la renovación, y la hora va en un fichero de/etc/systemd/timesyncd.conf.d/conNTP=. El DNS del puesto se cambia desde el nodo, conqm set 105 --nameserver 10.10.0.1 --searchdomain laby un reinicio.
Comprobación
- Desde el puesto de gestión,
ping 10.10.0.1responde y la consola web abre. - Desde web01,
ping 10.10.1.1ydig db01.dev.labresponden por la regla 0, perocurl -k -m 3 https://10.10.1.1falla por timeout: la regla 0 no deja pasar el 443 y la consola, además, solo escucha en MGMT. - En Interfaces → Assignments la MAC de cada vtnet coincide con la que apuntaste para cada bridge.
ip routeen web01 y db01 muestradefault via 10.10.X.1, ytimedatectl timesync-statusel.1de su zona como servidor.
Para practicar Guarda en la carpeta ut3/ de tu repositorio una captura de Interfaces → Assignments y la tabla de las cinco interfaces de Instalación en Proxmox, completada con la MAC real de cada NIC y la IP que le has puesto.
Si te sobra tiempo Añade ya la sexta NIC del firewall, en vmbr1 y sin tag, que necesitarás el 2 de diciembre para los clientes, y comprueba en Interfaces → Assignments que FreeBSD la ve como vtnet5 después de reiniciar la VM.
Sesión 15 · Reglas por zona y publicación de un servicio
La A3.1 dejó el cortafuegos en el sitio de router-dev, pero sin reglas de paso: de las zonas de servicio solo salen las preguntas al propio cortafuegos (la regla 0), gestión llega a todas partes por las reglas de fábrica, y desde fuera no entra nada. Hoy el cortafuegos empieza a decidir, y el primer servicio se publica hacia el aula: la web de web01, con HTTPS y un certificado firmado por la CA del curso, que nace hoy y que usan después las dos asignaturas. La teoría va en el orden en que se necesita: primero los aliases, que son los nombres con los que se escriben las reglas; después dónde va cada regla y cuál gana cuando varias coinciden; luego el NAT, que es lo que permite llegar desde fuera a una máquina con dirección privada y lo que decidiría si las zonas salen a Internet; y al final los certificados, para que la web se pueda validar sin saltarse nada. El apartado de logs es consulta: es donde se ve lo que decide el cortafuegos, y la hoja lo usa desde el primer paso. La hoja comprueba primero que sin reglas nada pasa, crea la CA y el certificado, deja nginx sirviendo por HTTPS en web01, escribe las reglas de gestión y la publicación en la WAN, y lo prueba desde el aula con curl y nmap.
Aliases
El problema. Una regla escrita con direcciones sueltas (de 10.10.1.10 a 10.10.2.10 en el 28080) obliga a saber de memoria qué máquina es cada IP para entenderla, y cuando una máquina cambia de dirección hay que buscar y cambiar cada regla donde aparece, con el riesgo de olvidarse una.
Qué es un alias. Un alias es un nombre para un conjunto de IPs, redes, puertos o URLs, que las reglas usan en lugar de los valores. Así la regla se lee sola ("permitir srv_web a srv_app en p_app") y, cuando app01 cambie de IP o haya dos app, se cambia el alias y no diez reglas. Hay varios tipos: Host (una o varias direcciones; admite también nombres DNS, que OPNsense resuelve periódicamente), Network (una red), Port (una lista de puertos) y URL Table (una lista que se descarga de una URL, por ejemplo los rangos de IP de un proveedor, y se actualiza sola). Se crean en Firewall → Aliases.
Los del curso. Las reglas del laboratorio se escriben todas con aliases, nunca con IPs sueltas, y el nombre de cada alias dice qué es: srv_ para un servidor, net_ para una red y p_ para una lista de puertos. Estos son todos, con la hoja que los crea:
| Alias | Tipo | Valor | Para qué | Nace en |
|---|---|---|---|---|
p_infra |
Port | 53, 123 | La regla 0: DNS y hora del propio cortafuegos | A3.1 |
srv_web, srv_app y srv_db |
Host | 10.10.1.10, 10.10.2.10 y 10.10.3.10 | Las tres máquinas del servicio | A3.2 |
net_mgmt |
Network | 10.10.0.0/24 | Todo lo que vive en gestión | A3.2 |
p_web |
Port | 80, 443 | La publicación de la web y la salida a Internet | A3.2 |
p_app |
Port | 28080, y el 28090 desde la A3.3 | Lo que el proxy pide a app01 | A3.2 |
srv_gitea |
Host | 10.10.0.20; la 10.10.0.11 desde el 12 de febrero | La Gitea a la que empuja app01 | A3.3 |
net_cli_a y net_cli_b |
Network | 10.10.101.0/24 y 10.10.102.0/24 | Las redes de los dos clientes | A3.4 |
srv_mon, p_mon_app y p_mon_db |
Host y Port | 10.10.0.20 y los puertos de cada exporter | El scrape y los logs de la monitorización | A3.1 de Mantenimiento (26 nov) |
Reglas y orden de evaluación
Las dos preguntas. Con varias interfaces y varias reglas, cada paquete plantea dos preguntas: qué reglas se le aplican y, si varias coinciden, cuál decide.
Dónde va una regla: la interfaz por la que entra. Las reglas se organizan por interfaz y se evalúan sobre el tráfico que entra por esa interfaz (dirección "in", que es la habitual casi siempre). Para permitir que web01 hable con app01:28080, la regla va en DMZEXT, porque es por donde entra el paquete al firewall, aunque el destino esté en DMZINT; las respuestas no necesitan regla en DMZINT, porque las deja pasar la tabla de estados. En la página de reglas de las versiones actuales de OPNsense se elige la interfaz en un filtro y se ven todas las reglas que deciden sobre ella; en la vista clásica cada interfaz era una pestaña, y por eso en el curso se sigue diciendo "la pestaña DMZEXT".
La pregunta que resuelve el 90 % de las dudas
«¿Por qué interfaz llega este paquete al cortafuegos?». Esa es la pestaña donde va la regla. Para que
web01 hable con app01:28080 la regla va en DMZEXT, que es por donde entra, aunque el destino esté en
DMZINT.
flowchart TB
P["<b>Llega un paquete</b>"]:::dato
I{"<b>¿Por qué interfaz<br>entra?</b>"}:::act
PEST["<b>Esa pestaña</b><br><small>y solo esa · dirección in</small>"]:::pieza
AUT["<b>1 · Reglas automáticas</b><br><small>anti-lockout y otras que pone el sistema</small>"]:::infra
MIAS["<b>2 · Reglas propias</b><br><small>en orden, de arriba abajo</small>"]:::pieza
PRIM(["<b>La primera que coincide decide</b><br><small>las de debajo ya no se miran</small>"]):::ok
DENY(["<b>Si ninguna coincide: se descarta</b>"]):::riesgo
P --> I --> PEST --> AUT --> MIAS --> PRIM
MIAS -. "ninguna coincide" .-> DENY
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxEl orden importa porque gana la primera coincidencia. Una regla permisiva arriba anula todas las restrictivas de debajo.
Cuál decide: el orden. El orden de evaluación es el siguiente:
- Reglas automáticas, las que pone el propio sistema, como la anti-lockout.
- Reglas flotantes (Floating), que aplican a varias interfaces a la vez.
- Reglas de grupos de interfaces (en el laboratorio, la regla 0 del grupo
ZONAS). - Reglas de la interfaz concreta, de arriba abajo.
- Denegación implícita al final, que registra si está activado "Log packets matched by the default deny rule" en Firewall → Settings → Advanced.
La opción quick: por qué gana la primera. Aquí entra la opción quick, que está marcada por defecto en cada regla y merece explicación. pf evalúa toda la lista y aplica la última regla que coincide, salvo que una regla tenga quick, en cuyo caso la evaluación se detiene en ella. Como OPNsense marca quick en todo, en la práctica funciona como "la primera que coincide gana". Si se desmarca quick en una regla, esa regla solo se aplicará si ninguna posterior coincide. Se usa para escribir una regla genérica arriba ("permitir todo desde MGMT", sin quick) que las reglas posteriores más específicas pueden anular. Lo recomendable es dejar quick activado y ordenar las reglas de más específica a más general: es más fácil de leer y de auditar.
Qué lleva cada regla. Cada regla lleva acción (Pass, Block, Reject), interfaz, dirección, familia IP, protocolo, origen (con puerto opcional), destino y puerto, opción de log y una descripción. La descripción conviene ponerla siempre, porque es lo que aparece en el log, no el número de regla; en el curso empieza por el número de fila de la matriz de reglas ("3 Proxy a la API y a whoami"), y así cada línea del log lleva directamente a la justificación de su regla.
Block o Reject. Block descarta en silencio (el origen espera hasta agotar el timeout) y Reject responde con un TCP RST o un ICMP unreachable (el origen sabe al instante que no hay servicio). Hacia Internet se usa Block, para no dar información; entre zonas internas, Reject ahorra esperas a los servicios propios. En el laboratorio, sin embargo, todas las denegaciones son Block, la de por defecto incluida, por una razón práctica: las pruebas de seguridad de la unidad leen un filtered de nmap como prueba de que el paquete murió en el cortafuegos, y un Reject daría closed, que es lo mismo que contesta una máquina a la que el paquete sí ha llegado.
Aplicar, y lo que no cambia al aplicar. Las reglas nuevas se guardan y no entran en vigor hasta pulsar Apply. Y al aplicar, los estados existentes que ya no encajan con la política se mantienen hasta que expiran, porque esas conexiones las decide la tabla de estados y no las reglas: para cortar una conexión ya establecida hay que borrar su estado en Firewall → Diagnostics → States (o "Reset state table", que las corta todas).
NAT: port forward y outbound
El problema. web01 tiene una dirección privada, la 10.10.1.10, y la red del aula no sabe llegar a 10.10.0.0/16; en Internet, además, las direcciones privadas no se enrutan. De las zonas del servicio, desde fuera solo se ve la dirección WAN del cortafuegos, así que para pedir la web desde fuera el cortafuegos tiene que recibir la conexión en su WAN y pasársela a web01. En sentido contrario pasa lo mismo: una máquina de las zonas que quiera salir a Internet necesita que alguien cambie su dirección privada por una que tenga vuelta. Las dos cosas son NAT, traducción de direcciones, como el masquerade con el que router-dev daba salida a las zonas (en Enrutar frente a hacer NAT). Hacen falta dos tipos.
Port forward: hacia dentro. El port forward (DNAT, NAT de destino: cambia la IP de destino del paquete) publica un servicio interno en la IP WAN: WAN:443 → srv_web:443. En OPNsense se configura en Firewall → NAT → Destination NAT (en las versiones anteriores a la 26.1 se llamaba Port Forward), y su campo "Filter rule association" decide qué pasa con la regla de filtro que tiene que dejar pasar el paquete ya traducido. La opción del curso es Register rule: crea una regla de filtro enlazada en la interfaz WAN y la actualiza sola si cambia el NAT, así que aparece en la lista como cualquier otra, puede llevar log y entra en la matriz de reglas. "Pass" deja pasar el tráfico en la propia regla de NAT, sin regla de filtro visible, y "Manual" no crea ninguna.
El port forward sin regla de filtro no publica nada
Con "Manual" en "Filter rule association", OPNsense no crea la regla de filtro: el paquete se traduce y
después se bloquea en la interfaz WAN, y el síntoma es un curl que se queda colgado sin respuesta ni
error claro. Con "Register rule", la opción del curso, la regla se crea y se mantiene sola.
flowchart TB
subgraph IN["Port forward · DNAT, hacia dentro"]
direction LR
C1["<b>curl desde el aula</b><br><small>a WAN:443</small>"]:::act
N1["<b>NAT</b><br><small>destino → srv_web:443</small>"]:::pieza
FIL["<b>Filtro</b><br><small>la regla se escribe con el destino YA traducido</small>"]:::dato
S1(["<b>srv_web</b>"]):::ok
C1 --> N1 --> FIL --> S1
end
subgraph OUT["Outbound NAT · SNAT, hacia fuera"]
direction LR
Z["<b>Zona interna</b>"]:::pieza
N2["<b>NAT</b><br><small>origen → IP del firewall</small>"]:::pieza
I2(("<b>Internet</b>")):::infra
Z --> N2 --> I2
end
IN ~~~ OUT
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxEn pf el NAT va antes que el filtro. Es el motivo de que la regla lleve srv_web:443 y no la IP WAN, y de que mucha gente la escriba mal la primera vez.
Outbound NAT: hacia fuera. El Outbound NAT (SNAT, NAT de origen: cambia la IP de origen; en las versiones actuales de OPNsense la página se llama Firewall → NAT → Source NAT) permite que las zonas internas salgan a Internet con la IP del firewall. En modo automático OPNsense lo hace para todas las redes de sus interfaces, y en el laboratorio se deja así, porque quien decide qué sale no es el NAT sino las reglas de filtro: el NAT solo traduce lo que el filtro ya ha dejado pasar. La política del curso:
- Gestión sale siempre, a los puertos 80 y 443 (la fila 2 de la matriz de reglas): es donde viven las máquinas que descargan paquetes, imágenes y plugins.
- Las zonas de servicio no salen. Una máquina comprometida que puede salir a Internet descarga sus herramientas y saca los datos por el mismo camino; si no puede salir, el atacante se queda con lo que tenía. Cuando una hoja necesita instalar algo en ellas, abre una fila TEMPORAL en la pestaña de esa zona (origen la máquina, destino any, puertos
p_web, y en la descripción la palabraTEMPORALcon la fecha de alta y la de baja), instala y la borra en el mismo paso. Una regla temporal que se queda abierta es la forma más común de que un cortafuegos acabe dejándolo pasar todo.
Sin salida ni siquiera un rato
En producción las zonas internas no salen a Internet ni para actualizarse: toman los paquetes de un mirror o de una caché de paquetes (apt-cacher-ng, por ejemplo) que vive en gestión, y el outbound NAT se pone en modo Hybrid con solo las salidas justificadas.
Logs
Material de consulta
Esto no se explica en clase: lo necesitas para el paso 1 de la hoja de esta sesión y para las pruebas de las siguientes.
Para qué. El cortafuegos decide en silencio, y el log es lo único que dice qué ha decidido. En esta unidad es además la evidencia: una denegación que no deja línea en el log no se puede demostrar.
Dónde se mira. Firewall → Log Files → Live View muestra en tiempo real cada paquete que coincide con una regla que tiene log activado, y todos los de la denegación por defecto, si está activada la opción que la registra (conviene comprobarlo antes de la primera prueba). Cada línea trae interfaz, dirección, acción, origen, destino, protocolo y la etiqueta de la regla, que es su descripción: con el número de fila al principio, cada línea lleva a su justificación en la matriz. Conviene filtrar por interfaz o por etiqueta; con 20 VM escaneándose, el log sin filtro es inservible. Para el histórico está Plain View, y para enviarlo fuera, que es lo habitual en producción, System → Settings → Logging, en la pestaña Remote, permite mandar todo por syslog (el protocolo estándar de envío de logs) a un colector.
Qué reglas llevan log. Conviene activarlo en todas las reglas de denegación, porque registran lo que alguien intenta y no debe pasar, y en las de permiso hacia INT, porque dicen quién toca los datos. No en la regla de permiso de WAN:443, que generaría una línea por conexión web y solo serviría para llenar el disco; para eso están los logs de acceso del proxy.
Certificados
El problema. Publicar la web por HTTPS exige que el cliente pueda comprobar que habla con el servidor de verdad. Se puede pedir saltándose esa comprobación (curl -k, que es lo que hace la primera prueba de la hoja), pero entonces el cifrado no protege de casi nada: cualquiera que se ponga en medio presenta su propio certificado y el cliente lo acepta igual. Sirve para el primer minuto, para saber si el camino funciona, pero no es la forma de trabajar.
TLS, certificado y CA, lo justo. HTTPS es HTTP dentro de TLS, el protocolo que cifra la conexión y permite al cliente comprobar con quién habla. Al abrir la conexión, el servidor presenta su certificado: un documento que dice "esta clave pública es de api.dev.lab" y que lleva la firma de una CA (autoridad de certificación), alguien en quien el cliente ya confía. El cliente comprueba la firma con el certificado de la CA, que tiene guardado, y comprueba que el nombre al que se ha conectado está en el certificado. Aquí basta con eso y con que hay dos escenarios: una CA propia para lo que no ve Internet y Let's Encrypt para lo que tiene nombre público.
Por qué una CA propia, y una sola. Para nombres internos como api.dev.lab no sirve una CA pública, que solo firma nombres que puede comprobar desde Internet. Se podría poner en cada servicio un certificado autofirmado, pero entonces cada cliente tendría que confiar en cada certificado uno por uno. Con una CA propia, cada cliente confía en un solo fichero, ca.crt, y con él en todo lo que esa CA firme. El laboratorio tiene una sola, Lab 5166 CA, que nace hoy en el puesto de administración y firma todo lo que se cifra después en las dos asignaturas, empezando por el proxy de hoy.
Con openssl ca, no con el atajo. Se hace con openssl ca y no con el atajo de openssl x509 -req, porque openssl ca lleva el registro de lo emitido: index.txt apunta cada certificado con su número de serie, y eso es lo que permite revocar uno cuando haga falta y publicar la lista de revocados. Todo vive en ~/ca/ del puesto de administración, y ca.key no sale nunca de ahí: con esa clave se puede firmar un certificado para cualquier nombre del laboratorio, y todos los clientes lo aceptarían.
mkdir -p ~/ca/emitidos && chmod 700 ~/ca && cd ~/ca
touch index.txt
echo 1000 > serial
echo 1000 > crlnumber
El fichero de configuración, entero, en ~/ca/ca.cnf. Tiene dos secciones de extensiones, una para certificados de servidor y otra para certificados de cliente, y copy_extensions para que el certificado conserve los nombres que trae la petición:
[ ca ]
default_ca = ca_curso
[ ca_curso ]
dir = $ENV::HOME/ca
certificate = $dir/ca.crt
private_key = $dir/ca.key
database = $dir/index.txt # registro de lo emitido y lo revocado
serial = $dir/serial
crlnumber = $dir/crlnumber
new_certs_dir = $dir/emitidos # una copia de cada certificado, por número de serie
default_md = sha256
default_days = 365
default_crl_days = 30
policy = politica
copy_extensions = copy # copia el SAN que trae la petición
unique_subject = no # deja reemitir un certificado con el mismo nombre
[ politica ]
commonName = supplied
# servidores: proxy, exporters, Jenkins, registry
[ server_cert ]
basicConstraints = CA:FALSE
extendedKeyUsage = serverAuth
subjectKeyIdentifier = hash
authorityKeyIdentifier = keyid,issuer
# clientes que se identifican con certificado: Promtail, logcli
[ client_cert ]
basicConstraints = CA:FALSE
extendedKeyUsage = clientAuth
subjectKeyIdentifier = hash
authorityKeyIdentifier = keyid,issuer
Del fichero, las decisiones que importan:
- Dos clases de certificado.
server_certponeserverAuth, que solo vale para que un servidor se identifique, yclient_certponeclientAuth, para un cliente que se identifica ante un servidor (Promtail ante Loki, por ejemplo). Separarlas evita que un certificado de cliente robado sirva para hacerse pasar por un servidor. copy_extensions = copy. Los nombres del certificado (el SAN, que se explica más abajo) van en la petición, y sin esta líneaopenssl calos descartaría al firmar.unique_subject = no. Permite emitir otra vez un certificado con el mismo nombre, por ejemplo al renovarlo, sin revocar antes el anterior.default_days = 365. Un año por certificado, lo que dura el curso.
La CA se crea una sola vez, con una clave de curva elíptica y diez años de vida. La curva elíptica (P-256, la prime256v1 de la orden) da la misma seguridad que RSA con claves mucho más cortas, y la entienden todos los clientes del curso. La línea keyUsage no es decorativa: sin ella, los clientes que verifican en modo estricto (Python 3.13, por ejemplo) rechazan todo lo que firme la CA.
cd ~/ca
openssl req -x509 -newkey ec -pkeyopt ec_paramgen_curve:prime256v1 -nodes \
-keyout ca.key -out ca.crt -days 3650 -subj "/CN=Lab 5166 CA" \
-addext "keyUsage=critical,keyCertSign,cRLSign"
chmod 600 ca.key
Cada certificado, en dos órdenes. Cada certificado se emite después con dos órdenes, cambiando el nombre: una petición (CSR, la solicitud de firma con la clave pública y los nombres) y la firma de la CA. Conviene fijarse en el SAN (Subject Alternative Name, el campo del certificado donde van los nombres y las IP para los que vale): sin él los navegadores y los clientes modernos rechazan el certificado aunque la firma sea correcta, porque ya no miran el CN, el campo de nombre clásico.
openssl req -new -newkey ec -pkeyopt ec_paramgen_curve:prime256v1 -nodes \
-keyout api.dev.lab.key -out api.dev.lab.csr -subj "/CN=api.dev.lab" \
-addext "subjectAltName=DNS:api.dev.lab,IP:10.10.1.10"
openssl ca -config ~/ca/ca.cnf -extensions server_cert \
-in api.dev.lab.csr -out api.dev.lab.crt
openssl ca pregunta dos veces antes de firmar y de anotar; en un bucle se le añade -batch para que no pregunte. Un certificado de cliente es lo mismo con -extensions client_cert. Para comprobar lo emitido, openssl x509 -in api.dev.lab.crt -noout -ext subjectAltName enseña los nombres, y cat ~/ca/index.txt una línea por certificado, con una V delante mientras es válido. La revocación (openssl ca -revoke y -gencrl) se usa al final del curso, al dar de baja lo que ya no se necesita.
Que los clientes confíen en la CA. Después se instala ca.crt en los clientes (/usr/local/share/ca-certificates/ y update-ca-certificates en Debian) y curl deja de necesitar -k. Para algo más serio que un laboratorio, step-ca de Smallstep es una CA completa con protocolo ACME (el protocolo con el que un servidor pide y renueva certificados sin intervención humana, el mismo que usa Let's Encrypt), con certificados de vida corta que se renuevan solos.
Let's Encrypt, para lo que tiene nombre público. Es una CA pública y gratuita que emite certificados de 90 días validando que quien los pide controla el dominio: con HTTP-01, publicando un fichero en /.well-known/acme-challenge/ por el puerto 80 (en producción, otro motivo para publicar el 80 aunque después redirija a HTTPS), o con DNS-01, creando un registro TXT (un registro DNS de texto libre), que es la única opción para los comodines (*.dominio) y la habitual para servicios que no se ven desde Internet. La vida de los certificados públicos se está acortando: desde enero de 2026 Let's Encrypt ofrece certificados de seis días a quien los pida, y tiene anunciado bajar los de por defecto a 45 días en 2028. Con esas duraciones, renovar a mano deja de ser una opción: Certbot, Caddy, Traefik y el plugin ACME de OPNsense renuevan solos. Conviene vigilar que la renovación funcione: un certificado caducado un domingo es la avería más tonta y más frecuente de un servicio publicado.
A3.2 Publicar la web (sesión 15)
Objetivo https://api.dev.lab responde desde el aula con la web de web01, con un certificado firmado por la CA del curso, y un nmap desde el aula solo ve el 443 (y el 80). Es la primera vez que algo del laboratorio se publica hacia fuera, y la hoja lo demuestra desde los dos lados: lo publicado funciona y se valida sin saltarse nada, y lo demás no se ve. De paso nace la CA del curso, la que usan las dos asignaturas.
Antes de empezar
- El firewall de la A3.1 con la regla 0, y web01 y db01 apuntando a él.
- nginx, nmap y netcat-openbsd en web01, de la preparación de la A3.1. Si falta alguno, ábrele una fila temporal en DMZEXT como dice NAT: port forward y outbound, con la descripción
TEMPORAL alta 25-11 baja 25-11 apt en web01, y bórrala al terminar elapt. - Explicado en clase: Aliases, Reglas y orden de evaluación, NAT: port forward y outbound y Certificados. De consulta, para el paso 1: Logs. Para el paso 3, el fichero de nginx de El proxy inverso, que se explica el 27 de noviembre.
Pasos
Vas a abrir la primera puerta del cortafuegos en un orden pensado para que cada resultado se deba a lo que acabas de hacer. Primero compruebas que, sin reglas, no pasa nada: así sabes que lo que pase después es obra de tus reglas. Después preparas lo que va detrás de la puerta (la CA, el certificado y nginx en web01), y solo cuando está listo escribes las reglas y el port forward, porque una puerta abierta hacia un servicio a medio configurar es lo primero que encuentra un escaneo. Al final lo pruebas desde fuera, como lo vería cualquiera del aula: con curl, que lo publicado funciona y valida, y con nmap, que no se ve nada más.
-
Comprueba que sin reglas no pasa nada. Desde web01, intenta llegar al 22 de 10.10.2.10 y al 5432 de 10.10.3.10: los dos intentos tienen que acabar por timeout, no con "Connection refused", y las dos denegaciones tienen que salir en Live View filtrando por DMZEXT. El timeout dice que nadie contestó, y la línea del log, que fue el cortafuegos quien tiró el paquete (lo explica Logs). app01 todavía no está en la 10.10.2.10 (llega en la A3.3), pero da igual: lo que se prueba es que el paquete muere al entrar por DMZEXT.
-
Crea la CA del curso y el certificado del proxy. En el puesto de administración, crea la CA y el certificado de
api.dev.labcon los bloques de Certificados tal cual: la CA se crea una sola vez para todo el curso y Mantenimiento firma con ella desde mañana, así que las rutas y los nombres tienen que ser exactamente esos. Dejaapi.dev.lab.crtyapi.dev.lab.keyen/etc/ssl/de web01, la clave con permisos 600: es lo único que hace falta para hacerse pasar porapi.dev.lab. -
Sirve api.dev.lab por HTTPS en web01. Deja nginx sirviendo
api.dev.labdesde/etc/nginx/sites-available/api.dev.lab, enlazado ensites-enabled, con los dos bloquesserverde El proxy inverso: el del 80, que solo redirige a HTTPS, y el del 443, con el certificado del paso 2. Quita el sitiodefault, para que en el 80 no conteste nada más que tu redirección. Hoy el bloque 443 sirve una página estática en lugar de reenviar a la API, porque app01 no llega a la VPC hasta la A3.3.Pista: en el bloque 443, cambia los dos
locationporroot /var/www/html;eindex index.nginx-debian.html;, que es la página de bienvenida del paquete de Debian. Sin la líneaindex, nginx buscaindex.htmly responde 403. -
Abre solo lo que la matriz justifica. Crea los aliases de hoy de la tabla de Aliases (
srv_web,srv_app,srv_db,net_mgmt,p_webyp_app), aunquesrv_appysrv_dbno los use todavía ninguna regla tuya: Mantenimiento escribe con ellos mañana sus filas 11 a 13. Después escribe las reglas, cada una con su número de fila al principio de la descripción: en MGMT, las filas 5 y 2 de la Matriz de reglas, y solo entonces borra las reglas de fábrica "Default allow LAN to any", porque si las borras antes te quedas sin SSH hacia las zonas; en WAN, la fila 1, como port forward (Destination NAT) dep_webhaciasrv_web, con "Register rule" para que cree su regla de filtro, como en NAT: port forward y outbound.Pista: la regla de filtro de WAN tiene que llevar como destino
srv_web, ya traducido, y no la IP WAN: enpfel NAT va antes que el filtro. -
Pide la web desde fuera y valida el certificado. Desde tu equipo del aula, pide primero la web contra la IP WAN sin validar el certificado: si responde, el port forward y su regla funcionan. Después pídela sin
-kahttps://api.dev.lab, con la CA del curso instalada como/usr/local/share/ca-certificates/lab5166.crty el nombre apuntando a la IP WAN en tu/etc/hosts: si valida, la cadena de confianza y el SAN de Certificados están bien. Son dos pruebas distintas, y la primera no demuestra la segunda.Pista:
ca.crtestá en~/ca/del puesto de administración. Contra la IP WAN no valida nunca: el certificado solo vale para su SAN,api.dev.lab. -
Mira el cortafuegos como lo vería un atacante. Escanea desde el aula los puertos 22, 80, 443 y 28080 de la IP WAN con un escaneo SYN y sin ping previo (nmap se vio en Cómo se prueba una red). El 80 y el 443 tienen que salir abiertos y los otros dos
filtered, noclosed: es la diferencia entre un puerto que el cortafuegos esconde y uno al que alguien contesta.Pista: son
-sSy-Pn. El firewall no contesta al ping, y sin-Pnnmap da el host por caído y no escanea nada.
Comprobación
- El
curl -vsin-ktermina conSSL certificate verify oky un 200 con la página por defecto de nginx;curl -v http://api.dev.labdevuelve un 301 ahttps://api.dev.lab/. - El nmap muestra 443 y 80
open; 22 y 28080filtered. Si alguno saleclosed, revisa las reglas de WAN antes de seguir. - En el log, con filtro por interfaz WAN, ves los SYN al 22 y al 28080 denegados por la regla por defecto.
Para practicar Guarda en ut3/ una captura de Firewall → Rules (WAN y MGMT) y otra de NAT → Destination NAT, y la salida del curl -v sin -k y la del nmap, cada una encabezada con date; hostname, porque la matriz de pruebas de la A3.5 las reutiliza como evidencia. Guarda también ca.crt, nunca ca.key.
Si te sobra tiempo Mira en la salida del curl la cabecera Server y añade server_tokens off; en /etc/nginx/nginx.conf para dejar de regalar la versión.
Sesión 16 · DMZ interna y zona interna
Después de la A3.2, web01 está publicada pero sirve una página estática, y el servicio de verdad sigue donde estaba: el compose de app01, con su base de datos y su nginx dentro, en la red del aula y fuera de la VPC. Hoy el servicio toma la forma del modelo por capas: el proxy en la DMZ externa, la API en la DMZ interna y la base de datos en la zona interna, con una sola regla por salto. Es también el día del traslado: app01 y mon01 pasan del aula a la VPC, y con ellas la pila de Mantenimiento, que el 26 de noviembre dejó en OPNsense sus filas 11 a 13 para que la monitorización siga pasando. La teoría sigue el recorrido de una petición: primero el patrón de publicación, que dice por qué cada pieza va en su zona y qué regla necesita cada salto, y cómo se abre la base de datos solo a la aplicación; después el proxy inverso, la pieza que da la cara a Internet; y al final la documentación, porque con las reglas de hoy ya hay bastantes para que, sin un documento, nadie sepa dentro de un año por qué existe cada una. La hoja monta la cadena de abajo arriba (base de datos, reglas, API y proxy), la recorre desde el aula, demuestra que el proxy no llega a la base de datos y empieza la matriz de reglas.
Publicar un servicio
El problema. Con el firewall en pie, toca el primer servicio de verdad: una web que se ve desde Internet con HTTPS y cuya aplicación y base de datos no son alcanzables desde fuera. El servicio del curso son tres piezas en cadena, y cada una corre un riesgo distinto: el proxy habla con cualquiera de Internet, la API tiene la lógica del servicio y las credenciales de la base de datos, y la base de datos tiene los datos. Por eso cada una va en su zona, y el apartado junta lo que necesita cualquier cosa que se publique el resto del curso: el port forward, el proxy inverso en la DMZ externa y el certificado.
El patrón. Es siempre el mismo: Internet → firewall (port forward 443) → proxy inverso en DMZ externa → aplicación en DMZ interna → base de datos en zona interna. La aplicación no tiene IP pública ni ruta directa desde fuera. La base de datos solo acepta conexiones desde la subred de aplicación, y con un usuario de aplicación, no con postgres.
sequenceDiagram
participant U as Usuario (Internet)
participant FW as Firewall
participant P as web01 (proxy, DMZ ext)
participant A as app01 (DMZ int)
participant D as db01 (INT)
U->>FW: TLS a IP_WAN:443
FW->>P: DNAT a 10.10.1.10:443 (fila 1, en WAN)
P->>P: Termina TLS, añade X-Forwarded-For
P->>A: HTTP a 10.10.2.10:28080 (fila 3, en DMZEXT)
A->>D: SQL a 10.10.3.10:5432 (fila 4, en DMZINT)
D-->>A: Filas
A-->>P: JSON
P-->>U: Respuesta cifradaCada flecha cruza una zona y necesita su regla. El TLS termina en el proxy: de ahí hacia dentro el tráfico va en claro por la red interna.
Una regla por salto. Cada salto del diagrama entra al cortafuegos por una interfaz distinta, así que cada uno necesita su regla, en la interfaz por la que entra, y ninguna más: la fila 1 en WAN (Internet al proxy, que se escribió en la A3.2), la 3 en DMZEXT (el proxy a la API) y la 4 en DMZINT (la API a la base de datos). Las respuestas vuelven por la tabla de estados. Con eso, si alguien compromete el proxy, lo único que alcanza son los dos puertos de app01 de la fila 3; si compromete la API, el 5432 de db01, y con un usuario que solo puede tocar la base servicio. Hay una cuarta regla que no está en el camino de la petición, la fila 6: app01 trae y sube el código del servicio a la Gitea provisional, que vive en mon01, en gestión.
La base de datos, abierta solo a la aplicación
Dos filtros más, en la propia base de datos. El cortafuegos decide qué máquina llega al 5432 de db01; PostgreSQL decide, además, a quién deja entrar. Es la defensa en profundidad aplicada a los datos: si alguien abriese de más el cortafuegos, PostgreSQL seguiría rechazando lo que no conoce. Los dos filtros están en dos ficheros de /etc/postgresql/17/main/:
postgresql.confdice en qué direcciones escucha. En Debian, PostgreSQL escucha de fábrica solo enlocalhost, y desde app01 se vería como un puerto cerrado. Conlisten_addresses = '*'escucha en todas sus direcciones; quién llega de verdad lo deciden el cortafuegos y el fichero siguiente.pg_hba.confdice quién entra y cómo. Cada línea indica el tipo de conexión, la base, el usuario, la red de origen y el método de autenticación; PostgreSQL usa la primera línea que encaja con la conexión y rechaza la que no encaja con ninguna. La del curso solo deja entrar al usuarioapp, solo en su base y solo desde la subred de aplicación:
scram-sha-256 es el método de contraseña actual de PostgreSQL: el cliente demuestra que conoce la contraseña sin enviarla, de modo que quien capture el tráfico, que dentro de la red viaja sin cifrar, no se la lleva.
Un usuario para la aplicación y otro para la monitorización. La API se conecta con app, dueño de la base servicio y de nada más, y no con postgres, que es el superusuario: si alguien compromete la API, se lleva lo que puede hacer app. Con la misma lógica, postgres_exporter (el programa que publica en el 29187 las métricas de la base de datos para el Prometheus de mon01) entra con un usuario propio, monitor, que solo tiene pg_monitor, un rol que trae PostgreSQL para leer estadísticas sin poder tocar los datos.
Los datos, en su propio disco. El clúster de PostgreSQL vive en un disco aparte montado en /data, no en el disco del sistema. Así un disco de sistema lleno de logs no para la base de datos, y el de datos se puede ampliar, mover o medir sin tocar lo demás.
El proxy inverso
Qué es. Un proxy inverso recibe la conexión del cliente y abre otra distinta hacia el servidor interno. Se llama inverso porque hace lo contrario que el proxy clásico de una oficina, que representa a los clientes ante Internet: este representa a los servidores ante los clientes. Son dos conexiones TCP separadas, con consecuencias:
- Termina TLS. El certificado y la clave privada viven en el proxy; la aplicación puede hablar HTTP plano dentro de la DMZ interna (o TLS con certificado interno si la política lo exige). Renovar un certificado no toca la aplicación.
- Oculta la topología. El cliente ve una IP y un puerto. No sabe si detrás hay una máquina o veinte, ni en qué red están, ni qué servidor de aplicaciones usan. Las cabeceras
Servery los mensajes de error del backend se pueden reescribir. - Filtra rutas. Se puede publicar
/apiy/y dejar/admino/metricssolo accesibles desde MGMT, con unlocationy unallow/deny(directivas de nginx: una ruta y quién puede pedirla). En el laboratorio no hace falta: las métricas de la API están en su propio puerto, el 29102, que el proxy no publica y que solo lee Prometheus. - Pierde la IP del cliente, salvo que se la pase a la aplicación. Como la segunda conexión sale desde 10.10.1.10, la aplicación vería siempre esa IP. Por eso el proxy añade la cabecera
X-Forwarded-Forcon la IP original (yX-Forwarded-Protoconhttps, para que la aplicación genere enlaces correctos). La aplicación debe confiar en esas cabeceras solo si vienen del proxy; si aceptaX-Forwarded-Forde cualquiera, un cliente puede falsificar su IP. El RFC 7239 estandariza esto como cabeceraForwarded, pero en la práctica todo el mundo sigue usando lasX-Forwarded-*.
El fichero de web01. En Debian, cada sitio de nginx va en un fichero de /etc/nginx/sites-available/ y se activa con un enlace en sites-enabled/, que es lo único que lee nginx: así un sitio se desactiva quitando el enlace, sin borrar su configuración. Este es el de api.dev.lab en web01, tal como queda al terminar la A3.3. Son dos bloques server: el del puerto 80 solo redirige a HTTPS, y el del 443 termina TLS y reenvía a app01.
server {
listen 80;
server_name api.dev.lab;
return 301 https://$host$request_uri;
}
server {
listen 443 ssl;
http2 on;
server_name api.dev.lab;
ssl_certificate /etc/ssl/api.dev.lab.crt;
ssl_certificate_key /etc/ssl/api.dev.lab.key;
ssl_protocols TLSv1.2 TLSv1.3;
proxy_set_header Host $host;
proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
proxy_set_header X-Forwarded-Proto $scheme;
proxy_set_header X-Real-IP $remote_addr;
location / {
proxy_pass http://10.10.2.10:28080; # la API del curso
}
location /cabeceras/ {
proxy_pass http://10.10.2.10:28090; # whoami: enseña lo que le llega
}
}
Del fichero, las decisiones que importan:
- El 80 solo redirige. Quien escriba
http://api.dev.labacaba en HTTPS sin recibir nunca una página en claro, y por eso la regla de WAN publica el 80 además del 443. ssl_protocols TLSv1.2 TLSv1.3. Son las dos versiones vigentes de TLS; las anteriores están retiradas por inseguras, y ningún cliente actual las necesita.- Las cuatro cabeceras
proxy_set_header, que valen para todos loslocationdel bloque.Hostconserva el nombre que pidió el cliente, que si no sería la IP de app01;X-Forwarded-Forañade la IP del cliente a la lista de direcciones por las que ha pasado la petición;X-Forwarded-Protodice si el cliente llegó porhttps; yX-Real-IPlleva solo la IP del cliente, para las aplicaciones que no saben leer la lista. - Dos destinos.
/va a la API del curso en el 28080, y/cabeceras/a un contenedor de pruebas,whoami, en el 28090, que contesta con todas las cabeceras que recibe: es la forma de ver qué le añade el proxy a la petición antes de que llegue a la aplicación.
Con esto cargado (nginx -t valida, systemctl reload nginx aplica), curl https://api.dev.lab/health desde el aula devuelve la respuesta de la API, y curl https://api.dev.lab/cabeceras/, la de whoami con las cabeceras que ha añadido el proxy.
Otros proxies. nginx no es la única opción. Las otras dos habituales en empresas se diferencian sobre todo en cómo encuentran los servidores de detrás y en quién se ocupa de los certificados:
| Proxy | Cómo encuentra los backends | Certificados | Cuándo se elige |
|---|---|---|---|
| nginx | A mano: un proxy_pass por ruta |
A mano, o con certbot | Para aprender, porque obliga a entender cada cabecera; es el del curso |
| Traefik | Solo: lee las etiquetas de los contenedores en Docker o Kubernetes | Let's Encrypt integrado | Producción con contenedores que aparecen y desaparecen |
| Caddy | A mano, con un fichero de muy pocas líneas | Let's Encrypt automático, sin configurar nada | Un servicio pequeño en el que no se quiere pensar en certificados |
El criterio, en una línea: nginx para aprender, Traefik para producción con contenedores y Caddy para un servicio pequeño. El mismo proxy escrito para Caddy está en Caddy: el mismo proxy en cuatro líneas.
Documentación operativa
El problema. Con las reglas de hoy, el cortafuegos ya pasa de diez, y dentro de un año nadie recordará por qué existe cada una. Una regla de la que nadie sabe el motivo no se atreve a borrarla nadie, y así, regla a regla, un cortafuegos acaba dejándolo pasar todo. Por eso una red pasa a producción con los cuatro documentos que pide cualquier auditoría: el diagrama de zonas, la matriz de pruebas con evidencias y los dos que siguen. Estos dos se empiezan hoy; el diagrama y la matriz de pruebas, el 4 de diciembre.
Matriz de reglas
Qué es. Cada regla del firewall con su justificación, quién la pidió, quién la aprobó y cuándo se revisa; una regla sin justificación se borra. La fecha de revisión obliga a volver a preguntar si la regla sigue haciendo falta, que es la única forma de que el cortafuegos no crezca para siempre. Las filas de esta unidad el 27 de noviembre:
| # | Interfaz | Origen | Destino | Puerto | Acción | Log | Justificación | Solicitó | Aprobó | Revisión |
|---|---|---|---|---|---|---|---|---|---|---|
| 0 | ZONAS | any | This Firewall | p_infra (53, 123) e ICMP echo | Pass | no | DNS, hora y ping al propio cortafuegos | Sistemas | Sistemas | 2027-03 |
| 1 | WAN | any | srv_web | p_web (80, 443) | Pass | no | Publicación de api.dev.lab (el 80 solo redirige a HTTPS) | Desarrollo | Sistemas | 2027-03 |
| 2 | MGMT | net_mgmt | any | p_web (80, 443) | Pass | no | Gestión: consola del cortafuegos y salida a Internet | Sistemas | Sistemas | 2027-03 |
| 3 | DMZEXT | srv_web | srv_app | p_app (28080, 28090) | Pass | no | El proxy reenvía a la API y al contenedor de pruebas de cabeceras | Desarrollo | Sistemas | 2027-03 |
| 4 | DMZINT | srv_app | srv_db | 5432 | Pass | sí | La API consulta PostgreSQL | Desarrollo | Sistemas | 2027-03 |
| 5 | MGMT | net_mgmt | any | 22 | Pass | sí | Administración por SSH | Sistemas | Sistemas | 2027-03 |
| 6 | DMZINT | srv_app | srv_gitea | 23001 | Pass | no | app01 trae y sube el repositorio servicio (Gitea en mon01) |
Desarrollo | Sistemas | 2027-02 |
| 99 | todas | any | any | any | Block | sí | Denegación por defecto |
En «Solicitó» y «Aprobó» va el equipo, no una persona: el documento tiene que sobrevivir a quien lo firma.
En OPNsense la descripción de cada regla empieza por su número de fila, y así el log y el documento se cruzan sin buscar. Del 0 al 10 son de esta unidad; del 11 al 20, de Mantenimiento, que pone la 11 a la 13 (el scrape y los logs) el 26 de noviembre; del 21 en adelante, de las unidades posteriores, y la 99 es siempre la denegación. La 6 y la 13 son las únicas que entran en gestión, y la 6 se revisa en febrero porque el día 12 Gitea pasa a gitea01.
Procedimiento de cambios
Qué es. Quién puede pedir una regla, qué tiene que dar, quién la revisa y dónde se registra. Sin procedimiento, cada regla nueva depende de quién tenga ese día la contraseña del cortafuegos. Un procedimiento mínimo, el que se pide en la práctica:
- Quien necesita la regla abre una petición con origen, destino, puerto, protocolo, motivo y fecha de caducidad si es temporal.
- Sistemas comprueba que la regla respeta el modelo (no salta capas, usa aliases, no abre hacia MGMT sin un motivo escrito) y propone alternativa si no.
- Se aplica en dev, se ejecuta la fila correspondiente de la matriz de pruebas, y se pasa a pre y pro con el mismo cambio.
- Se añade la fila a la matriz de reglas con la referencia de la petición.
- Las reglas temporales llevan en la descripción
TEMPORALcon su fecha de alta y de baja, y su fila en la matriz mientras existen. En el laboratorio cada hoja cierra la suya en el mismo paso.
Cada paso evita un fallo concreto: sin petición escrita, nadie sabe después por qué está la regla; sin revisión, se cuelan reglas que saltan capas; sin prueba, una regla puede no hacer lo que dice; sin registro, la matriz deja de reflejar el cortafuegos; y sin fecha de baja, lo temporal se queda para siempre.
A3.3 Aplicación y datos (sesión 16)
Objetivo app01 y mon01 en la VPC, la base del servicio en db01 sobre su propio disco montado en /data, y la cadena Internet → proxy → app01 → db01 funcionando con las reglas mínimas; un intento del proxy contra la base de datos muere en el firewall y queda en el log. Al terminar, el servicio tiene por fin la forma del modelo de capas: cada pieza en su zona, una regla por cada salto permitido y la prueba de que el salto prohibido no se da. Desde hoy es también la red en la que trabaja Mantenimiento.
Antes de empezar
- La A3.2 terminada: aliases, port forward y nginx con certificado en web01.
- En db01, los paquetes de la preparación de la A3.1. Si falta alguno, ábrele una fila temporal en INT como dice NAT: port forward y outbound y ciérrala al terminar el
apt. - En OPNsense, las filas 11 a 13 que Mantenimiento dejó ayer en su A3.1: dejan pasar el scrape de mon01 y los logs de app01 desde el momento del traslado.
- El disco de db01 y el traslado de app01 y mon01, hechos con el bloque que sigue. Desde el traslado, a las máquinas de servicio se entra con salto por el puesto de administración (
ssh -J ops@<IP de aula de admin01> ops@10.10.2.10para app01); el laboratorio trae un~/.ssh/configde ejemplo para no escribirlo cada vez. - Explicado en clase: Publicar un servicio, con la base de datos abierta solo a la aplicación, El proxy inverso y Documentación operativa, con la matriz de reglas que empiezas hoy.
Preparación antes de la sesión: el disco de db01 y el traslado
Son unos veinte minutos de órdenes que no dependen de nadie. Lo de db01 vale cualquier día desde el 20 de noviembre; el traslado, solo después de la clase de Mantenimiento del 26, que todavía usa las dos VM en el bridge del aula. Si no llegas, empieza la sesión por aquí.
El disco de datos de db01. Añade en caliente a db01 (VM 130) un disco de 5 GB, formatéalo en ext4 sin particionar con la etiqueta datos y móntalo en /data desde fstab por esa etiqueta. Después lleva el clúster de PostgreSQL, todavía vacío, a /data/postgresql/17/main. Desde diciembre, Mantenimiento mide ese disco en sus indicadores de capacidad.
Pista: el disco se añade desde el nodo con qm set 130 --scsi1 local-lvm:5, y se monta por etiqueta porque /dev/sdb puede cambiar de orden entre arranques. El clúster se mueve con pg_dropcluster --stop 17 main y pg_createcluster -d <ruta> --start 17 main; el primero borra lo que haya, así que si habías probado algo, sácalo antes con pg_dumpall.
El traslado de app01 y mon01. Mientras app01 aún sale a Internet, descarga en ella la imagen traefik/whoami e instala netcat-openbsd. Después, desde el nodo, pasa app01 (120) a devback y mon01 (103) a devmgmt, con IP por DHCP y conservando su MAC, que es la clave de su reserva en el cortafuegos: con otra, caen en el rango dinámico y ni srv_app ni Prometheus las encuentran. Al terminar, borra las líneas con sus IP del aula, las de gitea.lab incluidas, del /etc/hosts de tu puesto, del puesto de administración y de mon01: esas IP ya no son suyas. Desde hoy, dentro de la VPC esos nombres los resuelve el cortafuegos, y desde tu puesto se llega a las dos máquinas con salto por el puesto de administración. El /etc/hosts de app01 se limpia en el paso 3.
Pista: qm config <ID> | grep net0 da la MAC, y qm set <ID> --net0 virtio=<MAC>,bridge=<VNet> --ipconfig0 ip=dhcp, con la VM apagada, la conserva.
Hasta el 1 de diciembre, los targets de app01 y de PostgreSQL de la monitorización estarán en DOWN, y es lo esperado: la A3.2 de Mantenimiento los lleva ese día a las direcciones de la VPC.
Pasos
Vas a montar la cadena de abajo arriba, cada pieza antes de la que depende de ella, y a recorrerla al final de punta a punta. Primero la base de datos en db01, porque la API no arranca sin ella; después las reglas entre capas, porque sin ellas app01 no llega ni a db01 ni a Gitea; luego la API, apuntando a db01, y el proxy de web01, apuntando a la API. Con todo en su sitio, pides el servicio desde el aula y compruebas el salto que no tiene que darse, el del proxy a la base de datos. Y al final escribes la matriz de reglas, que documenta lo que acabas de dejar funcionando.
-
Abre la base de datos solo a la aplicación. Deja PostgreSQL en db01 escuchando en todas sus direcciones, con el usuario
app(con la contraseña del.envdel servicio, que es de donde la lee la API) como dueño de la baseservicio, y enpg_hba.confuna línea que solo lo admita en esa base desde 10.10.2.0/24, conscram-sha-256, como en La base de datos, abierta solo a la aplicación. Después pon a postgres_exporter a leerla con un usuariomonitorque solo tenga el rolpg_monitor, y a escuchar en el 29187, el puerto del curso: es el exporter que Mantenimiento recoge desde el 1 de diciembre, y lo busca ahí.Pista: el exporter del paquete lo toma todo de
/etc/default/prometheus-postgres-exporter: la conexión, de la variableDATA_SOURCE_NAME, contra127.0.0.1:5432y consslmode=disable; el puerto, de la líneaARGS, con--web.listen-address, como el node_exporter de la plantilla. -
Escribe las reglas entre capas. Escribe las filas 3, 4 y 6 de la Matriz de reglas, cada una en la pestaña por la que entra el tráfico: la 3 en DMZEXT, y la 4 y la 6 en DMZINT. Antes, añade el 28090 al alias
p_app, para que la regla 3 cubra también el contenedor de pruebas, y creasrv_gitea(Host, 10.10.0.20, la de mon01, donde vive Gitea hasta el 12 de febrero): cuando Gitea se mude, cambiará el alias y no la regla. -
Lleva la API a su zona, contra db01. Arranca en app01 el contenedor de pruebas
whoami(imagentraefik/whoami) escuchando y publicado en el 28090, con--restart unless-stopped: el 20080, que le daría la regla de la franja, es el del nginx del compose del servicio, el 28080 es de la API y el 28081, de cAdvisor. Después quita del servicio lo que ya vive en otra máquina, para que en app01 quede solo la API, como dice el patrón:DB_HOST=10.10.3.10en/opt/servicio/.envy fuera de/opt/servicio/compose.ymllos serviciosdb,nginxypostgres_exporter, conapppublicando todavía el 28080, que es el que pide el proxy. Sube el cambio al repositorioservicio: el compose lo usan las dos asignaturas, y en Gitea tiene que estar como está de verdad.Pista: publicar el 28090 no basta: whoami escucha en su 80 de fábrica mientras su opción
--port, que va detrás del nombre de la imagen, no diga otro. En el compose, quita también eldepends_ondeappy levanta con--remove-orphans. El push sale por la regla 6 haciagitea.lab, que ahora resuelve el cortafuegos: borra antes la línea de ese nombre que la A2.6 de Mantenimiento dejó en el/etc/hostsde app01. -
Convierte web01 en proxy inverso. Cambia en el nginx de web01 la página estática de la A3.2 por el reenvío: el bloque 443 de
api.dev.labqueda como en El proxy inverso, con/hacia la API del 28080,/cabeceras/hacia whoami en el 28090 y las cuatro cabeceras que le dicen a la aplicación quién es el cliente de verdad. -
Recorre la cadena y demuestra el salto prohibido. Desde tu equipo del aula, pide
/itemsy/cabeceras/ahttps://api.dev.lab: si contestan, los tres saltos funcionan, y en la respuesta de whoami ves tu IP enX-Forwarded-For. Después demuestra desde web01 lo que el patrón prohíbe: un intento al 5432 de db01 tiene que acabar por timeout, con su denegación en Live View, en la interfaz DMZEXT. Las dos mitades juntas son la prueba de las capas: llega lo que tiene que llegar, y nada más.Pista:
/itemsdevuelve[]: los datos de prueba de octubre y noviembre no se trasladan, y la API crea el esquema vacío al arrancar. -
Empieza la matriz de reglas. Crea
matriz-reglas.mdcon la tabla de Matriz de reglas, que ya trae las filas del firewall de hoy, y añádele las filas 11 a 13 de Mantenimiento con la justificación de su tabla de puertos. Repásala contra OPNsense, porque una matriz solo vale si dice lo que hay de verdad: cada regla lleva su número al principio de la descripción, y cada regla temporal que siga abierta, su fila con la fecha de baja.
Comprobación
- Desde el aula,
curl https://api.dev.lab/itemsdevuelve la respuesta de la API y/cabeceras/la de whoami, con tu IP enX-Forwarded-For. - En app01,
docker compose -f /opt/servicio/compose.yml pssolo muestraapp. app01 y mon01 tienen la IP de su reserva, señal de que el traslado conservó la MAC. - Desde web01, el nc al 5432 termina por timeout (no "refused") y la línea está en el log en la interfaz DMZEXT.
- En db01,
df -h /datamuestra el disco de 5 GB,show data_directorydevuelve/data/postgresql/17/mainycurl -s localhost:29187/metricsdapg_up 1.
Para practicar Guarda en ut3/ matriz-reglas.md con la matriz justificada (las reglas actuales más la denegación por defecto), la salida de los dos curl y la del nc del paso 5, encabezadas con date; hostname, y la captura de la línea del log del nc. La evaluable parte de esta matriz.
Si te sobra tiempo Pon en web01, dentro de location /cabeceras/, proxy_set_header X-Forwarded-For "1.2.3.4"; y observa que whoami se lo cree: por eso la aplicación solo debe confiar en la cabecera si viene del proxy.
Sesión 17 · Separación de clientes
Hasta aquí la red tiene un solo dueño. Pero un proveedor no monta una infraestructura por cliente: la comparte, y al compartirla aparece un riesgo nuevo, que un cliente vea o ataque a otro con el que comparte red. Hoy se añaden dos clientes que usan el mismo servicio y no pueden verse entre sí, con la menor infraestructura nueva posible: dos redes etiquetadas, dos pestañas de reglas y el mismo proxy para los dos. La teoría recorre primero las formas de aislar clientes, de la más barata a la más cara, y por qué en el curso se usa una VLAN por cliente; después, cómo llegan esas VLAN a Proxmox y a OPNsense, y las dos reglas que necesita cada cliente. La hoja crea los dos clientes en sus VLAN, se las enseña al cortafuegos, escribe sus reglas y demuestra que llegan al proxy y a nada más.
Separación de clientes
El problema. Cuando la misma infraestructura sirve a varios clientes (multi-tenant: cada cliente es un inquilino) hay que garantizar que uno no ve ni afecta al otro. Si los dos estuvieran en la misma red, una máquina comprometida de un cliente podría escanear y atacar las del otro sin pasar por ningún filtro. Las opciones, de menos a más aislamiento:
- Separación lógica en la aplicación: un campo
cliente_iden cada tabla y unWHEREen cada consulta. Barata; un fallo de código lo expone todo, y los ha habido en empresas grandes. - VLAN o VNet por cliente con reglas de firewall que solo permiten tráfico cliente → servicios compartidos. Es lo habitual en proveedores medianos y lo que se hace en el módulo.
- VPC completa por cliente, con sus propias zonas y su propio firewall. Máximo aislamiento a nivel de red, más coste y más cosas que mantener. Es lo que dan AWS o Azure por defecto.
- Hardware dedicado: hosts de Proxmox separados por cliente. Solo lo justifica un contrato que lo exija.
La elección del curso. En la práctica del módulo se usa la opción 2: dos clientes en VLAN distintas que comparten el proxy y el firewall pero no se alcanzan. Es la que pide el criterio de evaluación, la habitual en proveedores medianos y la más barata que separa de verdad en la red: por cada cliente, una interfaz en el cortafuegos y dos reglas.
VLAN en Proxmox y en OPNsense
Qué es una VLAN, en una frase. Una VLAN separa redes lógicas sobre el mismo cable o el mismo bridge con una etiqueta numérica en cada trama Ethernet. Lo define el estándar IEEE 802.1Q, de 1998, y la etiqueta tiene 12 bits, de ahí que los números válidos vayan del 1 al 4094. Ya se usó en la A1.5, con las VLAN 10 y 20 sobre vmbr1.
En Proxmox. Un bridge marcado como VLAN aware deja pasar tramas etiquetadas; a cada VM se le asigna su etiqueta en la configuración de la NIC (tag=101), y el bridge la pone y la quita de forma transparente, así que la VM no sabe nada de VLAN: para ella, su tarjeta es una red normal. Los clientes van en vmbr1, que es VLAN aware desde la A1.5. Con el SDN se podría hacer lo mismo con más orden, con una VNet de tipo VLAN, pero eso exige una zona del SDN de tipo VLAN, y la del laboratorio, lab, es de tipo Simple.
El cortafuegos, en modo trunk. El cortafuegos tiene que estar en las dos VLAN a la vez, porque es el .1 de las dos y el único camino entre ellas y el resto. En vez de una tarjeta por VLAN, lleva una sola que transporta las dos con su etiqueta puesta, que es lo que se llama un trunk. En Proxmox, su NIC en vmbr1 va sin tag, y así el bridge le pasa las tramas de todas las VLAN etiquetadas; en OPNsense se crean dos interfaces VLAN (Interfaces → Devices → VLAN) sobre el padre vtnet5, con tags 101 y 102, y se les asignan las IP 10.10.101.1/24 y 10.10.102.1/24. Cada VLAN es una interfaz más a efectos de reglas, con su propia pestaña, y por defecto nada pasa entre ellas porque la denegación implícita se aplica igual.
Las direcciones. 10.10.101.0/24 y 10.10.102.0/24 caen dentro de 10.10.0.0/16, el bloque de dev, así que la ruta del puesto de administración hacia ese bloque ya las cubre y se entra en los clientes desde allí sin tocar nada. Y como las dos VLAN entran en el grupo ZONAS, la regla 0 les deja hacer ping a su .1, que es la primera comprobación de que la VLAN llega bien.
Las reglas de cada cliente. Son dos líneas, en la pestaña de su VLAN:
| Interfaz | Acción | Origen | Destino | Puerto | Log | Descripción |
|---|---|---|---|---|---|---|
| CLI_A | Pass | net_cli_a | srv_web | 443 | no | Cliente A al proxy compartido |
| CLI_A | Block | net_cli_a | any | any | sí | Cliente A: resto denegado |
| CLI_B | Pass | net_cli_b | srv_web | 443 | no | Cliente B al proxy compartido |
| CLI_B | Block | net_cli_b | any | any | sí | Cliente B: resto denegado |
La regla explícita de Block al final de cada pestaña es redundante con la denegación implícita, pero deja en el log una descripción legible y muestra la intención a quien lea la matriz sin conocer OPNsense. Con el proxy compartido hay un detalle más: si el cliente A hace una petición a api.dev.lab, el proxy la reenvía a app01 desde su propia IP, así que la aplicación tiene que distinguir clientes por otro medio (nombre de host, cabecera, autenticación), no por la IP de origen. El aislamiento de red garantiza que A no llega a la red de B; el aislamiento de datos sigue siendo responsabilidad de la aplicación.
Por qué los clientes llegan al proxy por dentro. Los clientes no entran por la WAN, como lo haría alguien de Internet, sino por su VLAN, igual que llegaría la oficina de un cliente conectada al proveedor por un enlace privado. Por eso van a la IP interna del proxy, la 10.10.1.10, que es la que permiten las reglas 7 y 9.
A3.4 Dos clientes (sesión 17)
Objetivo Dos VM de cliente en VLAN distintas llegan las dos al proxy por 443 y no se alcanzan entre sí ni llegan a ninguna otra zona, con la denegación registrada en el log. Es la separación de clientes que pide el criterio de evaluación, demostrada como la comprobaría un cliente desconfiado: desde su propia máquina, intentando llegar a la del otro.
Antes de empezar
- La A3.3 funcionando:
https://api.dev.lab/cabeceras/devuelve whoami. vmbr1, VLAN aware desde la A1.5, con una sexta NIC del firewall sin tag, que FreeBSD verá comovtnet5tras apagar y encender la VM 109. Si la añadiste en el «Si te sobra tiempo» de la A3.1, ya la tienes.- Explicado en clase: Separación de clientes y VLAN en Proxmox y en OPNsense.
Pasos
Vas a construir la separación de fuera adentro. Primero los clientes, que necesitan sus herramientas instaladas mientras todavía salen a Internet; después su lado del cortafuegos, las dos VLAN; luego las reglas, que deciden a qué llega cada uno; y al final la prueba, desde el cliente A, de que no llega al B pero sí al servicio. La matriz se actualiza al terminar, con las reglas ya probadas.
-
Crea los dos clientes y llévalos a su VLAN. Crea
cli-a(180) ycli-b(181), los clientes de la tabla de VM de prueba del laboratorio, como clones de la plantilla con 512 MB. Mientras siguen envmbr0, instálalesnmap,netcat-openbsdycurl: en su VLAN no tendrán salida a Internet, y son las herramientas de las pruebas del paso 4 y de la hoja del 4 de diciembre. Después pásalos avmbr1, como en VLAN en Proxmox y en OPNsense:cli-aen la VLAN 101 con la 10.10.101.10/24 ycli-ben la 102 con la 10.10.102.10/24, cada uno con el.1de su red como gateway.Pista: la VLAN la pone el bridge, no la VM:
tag=101en su--net0. La IP fija va en--ipconfig0, congw=. -
Enseña las VLAN al cortafuegos. Crea en OPNsense las VLAN 101 y 102 sobre
vtnet5, la tarjeta que hace de trunk, y actívalas como CLI_A y CLI_B, con la 10.10.101.1/24 y la 10.10.102.1/24, sin gateway y dentro del grupoZONAS, para que la regla 0 les valga también a ellas. Comprueba que cada cliente llega a su gateway, entrando en él desde el puesto de administración, que la regla 5 ya deja pasar: si el ping al.1no responde, la VLAN no está llegando y no tiene sentido seguir. -
Escribe las reglas de cada cliente. Crea los aliases
net_cli_a(10.10.101.0/24) ynet_cli_b(10.10.102.0/24) y las cuatro reglas de VLAN en Proxmox y en OPNsense, dos por pestaña, en ese orden y numeradas de la 7 a la 10 al principio de la descripción: en cada pestaña va primero el Pass al proxy y después el Block del resto, porque gana la primera que coincide. En el/etc/hostsde cada cliente, apuntaapi.dev.laba 10.10.1.10, la IP del proxy, que es la que permiten las reglas 7 y 9. -
Demuestra la separación. Desde el cliente A, intenta alcanzar al B de tres formas, de la más simple a la más completa: un ping, un descubrimiento de hosts de su red con nmap y un escaneo sin ping de sus puertos 22, 80 y 443. Localiza en Live View (CLI_A) las líneas de la regla 8: son la prueba de que fue el cortafuegos quien lo impidió. Desde los dos clientes, en cambio,
https://api.dev.lab/cabeceras/tiene que responder, porque un aislamiento que deja al cliente sin servicio no sirve.Pista: los clientes no tienen la CA del curso: ese
curlva con-k. -
Documenta las reglas nuevas. Añade las reglas 7 a 10 a
matriz-reglas.md, con su justificación: la matriz tiene que seguir diciendo lo mismo que el cortafuegos.
Comprobación
pingdesde A hacia B: 100 % de pérdida.nmap -sn: ningún host de B; solo aparece la 10.10.102.1, que es el propio cortafuegos y contesta por la regla 0.nmap -Pn: los tres puertosfiltered.curldesde A y desde B devuelve whoami conX-Forwarded-For10.10.101.10 o 10.10.102.10: la aplicación ve al cliente por la cabecera, no por la IP de origen, que es siempre la del proxy.- En Live View, filtrando por CLI_A, cada intento contra B aparece con la descripción "8 Cliente A: resto denegado".
bridge vlan showen el host de Proxmox muestra cada VM de cliente con su VLAN y el firewall con las dos.
Para practicar Guarda en ut3/ capturas de Firewall → Rules (CLI_A y CLI_B), la salida de las pruebas contra el cliente B del paso 4, encabezada con date; hostname, con su línea del log, y matriz-reglas.md actualizado.
Si te sobra tiempo Quita el tag de la NIC del cliente B y repite las pruebas contra él del paso 4: es el error más frecuente de la unidad y conviene haberlo visto antes de que ocurra por accidente. Vuelve a ponerlo.
Sesión 18 · Pruebas de seguridad
La red está montada: cortafuegos, zonas, servicio publicado y clientes separados. Pero una configuración, por bien hecha que esté, solo dice lo que se quería hacer; lo que demuestra que el aislamiento funciona es probarlo desde el punto de vista del atacante y dejar una evidencia fechada de cada prueba, que es además lo que pide el criterio de evaluación. nmap, nc y tcpdump ya se explicaron al probar la VPC, así que los diez minutos de hoy repasan lo justo y van a lo nuevo: por qué detrás de un cortafuegos lo que prueba el aislamiento es filtered y no closed, cómo se localiza con dos capturas dónde muere un paquete y cómo se ordena todo en la matriz de pruebas. Es una sesión casi entera de laboratorio: la hoja ejecuta la matriz desde cada zona, demuestra dos denegaciones con tcpdump en las dos interfaces del cortafuegos, tramita con el procedimiento de cambios lo que no salga como se esperaba y dibuja el diagrama de zonas. Con eso queda casi todo el material de la práctica evaluable.
Pruebas de seguridad
Repaso
nmap, nc y tcpdump, con los estados open, closed y filtered, se explicaron a fondo en Cómo se prueba una red. Aquí solo se repasa lo que hace falta para leer las pruebas con un cortafuegos delante.
Desde dónde se prueba. No basta con configurar: hay que demostrar que el aislamiento funciona, y demostrarlo desde el punto de vista del atacante, es decir, desde fuera de cada zona. Las pruebas se hacen desde la máquina que representa cada origen (el equipo del aula para Internet, web01 para la DMZ externa, la VM del cliente A para el cliente A), no desde el firewall: lo que sale del propio cortafuegos no entra por ninguna de sus interfaces, así que no pasa por las reglas que se quieren probar y no dice nada de lo que puede hacer cada zona.
nmap
nmap envía paquetes y clasifica cada puerto según la respuesta. Ya se conocen -sT (escaneo connect, el que hace nmap sin root) y -sn (descubrir hosts sin escanear puertos). Detrás de un cortafuegos hacen falta dos opciones más:
-sS: escaneo SYN (half-open). Envía un SYN y mira qué vuelve, sin completar la conexión, así que muchos servicios ni lo registran. Necesita root, y es el que usan las hojas de la unidad.-Pn: no hacer ping previo. Imprescindible cuando el firewall bloquea ICMP, porque si no nmap concluye que el host está caído y no escanea nada.
Con -p- se recorren los 65535 puertos TCP y -T4 lo acelera en una red de laboratorio sin pérdidas; -sU escanea UDP (lento, porque un puerto abierto que no responde y uno filtrado se ven igual), y -sV y -O sacan la versión de cada servicio y el sistema operativo, que es la información que regala el proxy.
Cómo se lee cada estado. Interpretar los estados es lo que separa una prueba de un comando lanzado a ciegas:
| Estado nmap | Qué recibió nmap | Qué significa en este modelo |
|---|---|---|
open |
SYN-ACK | Hay un servicio escuchando y el firewall lo deja pasar. |
closed |
RST | El paquete llegó a la máquina y no hay nada escuchando en ese puerto. El firewall no lo está filtrando. |
filtered |
Nada, o ICMP unreachable de tipo administrativo | Algo en medio descarta el paquete. Es lo que debe salir en todo lo que no está publicado. |
open\|filtered |
Nada (solo en UDP y algunos escaneos) | nmap no puede distinguir; hay que probar con nc o con tcpdump en el destino. |
Por qué filtered y no closed. Detrás de un cortafuegos con denegación en silencio, todo lo que no está publicado tiene que salir filtered: nadie contestó, y el log dice qué regla tiró el paquete. Un closed quiere decir que alguien respondió con un RST, y eso pide explicación aunque no haya servicio detrás. Si un escaneo desde fuera contra el 28080 de la WAN devuelve closed, o el paquete pasó el filtro y fue la máquina de destino quien contestó, porque alguna regla deja pasar más de lo que parece, o hay un Reject donde la política del laboratorio pone Block. Ese es justo el tipo de hallazgo que se pide en la práctica.
nc, curl y tcpdump
nc -zv 10.10.3.10 5432 (nc es netcat, un cliente TCP y UDP mínimo) prueba un puerto concreto y devuelve "succeeded" o "Connection refused" (llegó y no hay servicio, equivale a closed) o se queda esperando hasta el timeout (filtered). Con -w 3 se limita la espera. curl -kv https://api.dev.lab comprueba el servicio publicado de extremo a extremo, y con -v se ve el handshake TLS, el certificado presentado y las cabeceras de respuesta; ahí está la cabecera Server, que dice si se está regalando la versión de nginx.
Dónde muere un paquete. tcpdump es la herramienta para saber dónde muere un paquete. La técnica es capturar en dos sitios a la vez: en la interfaz de entrada del firewall y en la de salida.
# En el firewall (OPNsense tiene tcpdump; en el Debian también)
tcpdump -ni vtnet1 host 10.10.1.10 and port 28080 # entrada desde DMZEXT
tcpdump -ni vtnet2 host 10.10.1.10 and port 28080 # salida hacia DMZINT
Si el SYN aparece en la primera captura y no en la segunda, el firewall lo ha descartado y la línea correspondiente estará en el log. Si aparece en las dos y no hay respuesta, el problema está en app01 (servicio caído, escuchando solo en localhost, firewall local). Si ni siquiera aparece en la primera, el paquete no ha llegado al firewall: hay que revisar la ruta por defecto de la máquina origen. -n evita resoluciones DNS que ralentizan y confunden; -w captura.pcap guarda para abrir en Wireshark (el analizador gráfico de capturas), y -c 20 corta tras 20 paquetes para no llenar el disco.
En OPNsense, qué vtnet es cada zona está en la tabla de Instalación en Proxmox. Las interfaces de los clientes no son una vtnet sino una VLAN sobre vtnet5, con su propio nombre de dispositivo (empieza por vlan), que aparece en Interfaces → Assignments junto a CLI_A y CLI_B: es el que se pone en -i para capturar el tráfico de un cliente.
La matriz de pruebas
Qué es. Una fila por par origen/destino relevante, con puerto, resultado esperado (permitido/bloqueado) y resultado real. Lo esperado sale de la matriz de reglas: cada Pass es una fila que tiene que pasar, y cada salto que el modelo prohíbe, una que no. Cualquier discrepancia es un hallazgo que hay que corregir y volver a probar con el procedimiento de cambios; una matriz sin hallazgos en la primera pasada es sospechosa, no meritoria, porque lo normal es que algo no salga a la primera.
| Origen | Destino | Puerto | Esperado | Obtenido | Evidencia |
|---|---|---|---|---|---|
| Internet | proxy DMZ ext | 443 | Permitido | captura curl | |
| Internet | proxy DMZ ext | 22 | Bloqueado | nmap (filtered) | |
| Internet | app DMZ int | 28080 | Bloqueado | nmap (filtered) | |
| proxy | app | 28080 y 28090 | Permitido | nc | |
| proxy | db | 5432 | Bloqueado | nc + log del firewall | |
| proxy | Internet | 443 | Bloqueado | curl con timeout | |
| app | db | 5432 | Permitido | nc / psql | |
| app | proxy | 22 | Bloqueado | nc | |
| db | cualquiera | cualquiera | Bloqueado | nmap desde db01 | |
| cliente A | cliente B | cualquiera | Bloqueado | nmap -sn + tcpdump | |
| cliente A | proxy | 443 | Permitido | curl | |
| cliente A | app | 28080 | Bloqueado | nc | |
| Internet | consola del firewall | 443 | Bloqueado | curl -v a IP_WAN: el certificado es el de web01 |
La columna Evidencia dice con qué se demuestra cada fila: un curl que responde para lo permitido, un filtered o un timeout para lo bloqueado, y para las filas que más importan, además, la línea del log que dice qué regla lo decidió.
A3.5 Pruebas y evidencias (sesión 18)
Objetivo La matriz de pruebas completa, con evidencias fechadas desde las máquinas de origen, dos denegaciones demostradas con tcpdump en las dos interfaces del firewall, un hallazgo tramitado con el procedimiento de cambios y el diagrama de zonas del entorno. Con esto, lo construido en la unidad deja de ser una configuración y pasa a estar demostrado: es el material del informe de la práctica evaluable.
Antes de empezar
- Todo lo de las hojas A3.1 a A3.4 funcionando, y en
ut3/las evidencias de los pasos 5 y 6 de la A3.2, del paso 5 de la A3.3 y del paso 4 de la A3.4, que hoy se reutilizan. - Las herramientas, donde las dejaron las hojas anteriores: nmap y curl en tu equipo del aula, nmap y netcat-openbsd en web01 y db01, netcat-openbsd en app01 y los tres en los clientes.
tcpdumpse lanza en la consola del firewall. - Explicado en clase: Pruebas de seguridad, con el repaso de nmap y lo nuevo de hoy:
filteredfrente acloseddetrás del cortafuegos, las dos capturas y la matriz de pruebas.
Pasos
Vas a ir de lo general a lo concreto. Primero la matriz entera, que dice qué funciona y qué no desde cada origen; después, para dos filas bloqueadas, la prueba fina de dónde muere el paquete; luego tramitas lo que no haya salido como esperabas, que es justo lo que la matriz sirve para encontrar; y al final dejas el cortafuegos sin reglas temporales y dibujas el entorno tal como ha quedado. Reutiliza lo que puedas de las hojas anteriores: una prueba ya hecha y fechada vale tanto como una de hoy.
-
Ejecuta la matriz de pruebas. Completa
ut3/matriz-pruebas.mdcon la tabla de La matriz de pruebas, una columna Fecha más y al menos 8 filas, con las de los clientes. Las que ya probaste en la A3.2, la A3.3 y la A3.4 llevan la evidencia y la fecha de aquel día; las demás se ejecutan hoy, cada una desde su máquina de origen y nunca desde el firewall, con la salida encabezada pordate; hostnamey guardada enut3/evidencias/. La fecha y la máquina dentro de la propia salida son lo que convierte un comando en una evidencia. -
Localiza dónde muere el paquete en dos filas bloqueadas. Demuestra dos filas bloqueadas (proxy → db:5432 y cliente A → cliente B:22, por ejemplo) con dos capturas de tcpdump lanzadas a la vez en el firewall antes del intento, una en la interfaz por la que entra y otra en la que saldría, como en nc, curl y tcpdump. Guarda las dos salidas y anota en la columna Evidencia la línea de Live View que lo explica, con su etiqueta de regla: la captura dice dónde murió el paquete, y el log, qué regla lo tiró.
Pista: el nombre de cada interfaz está en el mismo apartado de la teoría. Sin dos consolas en el firewall, Interfaces → Diagnostics → Packet Capture captura en las dos interfaces a la vez.
-
Tramita cada hallazgo con el procedimiento. Escribe
ut3/procedimiento.mdcon los cinco pasos del Procedimiento de cambios, adaptados a tu laboratorio (quién pide, quién aprueba y dónde se registra), y tramita con él cada hallazgo, es decir, cada fila con un resultado distinto del esperado: enut3/hallazgos.md, la petición (origen, destino, puerto, motivo y fecha), la regla que lo causaba y cómo lo corregiste; enmatriz-reglas.md, la fila cambiada con la referencia de la petición, y al final, la prueba repetida. Un hallazgo corregido por fuera del procedimiento es un cambio que nadie sabrá explicar dentro de un año.Pista: el hallazgo típico es un
closeddonde debía haberfiltered. Si no aparece ninguno, prueba filas que no están en la tabla: gestión desde un cliente o el 22 de web01 desde app01. -
Deja el cortafuegos sin reglas temporales. Deja Firewall → Rules sin ninguna regla con
TEMPORALen la descripción: si queda alguna de las filas temporales de NAT: port forward y outbound, bórrala por el mismo procedimiento y anota la baja enmatriz-reglas.md. Una regla temporal olvidada es la forma más común de que un cortafuegos acabe dejándolo pasar todo, y la evaluable lo comprueba en la matriz de reglas. -
Dibuja el diagrama de zonas. Dibuja el diagrama de zonas de dev a partir del de Mapa sobre la VPC, con las máquinas de gestión, los dos clientes con su VLAN, y la subred y el
.1de cada red. Es lo primero que mira quien lee el informe, así que tiene que mostrar el entorno como está hoy y no como empezó. Vale en Mermaid o a mano y fotografiado.
Comprobación
- Cada fila de la matriz tiene "Obtenido", fecha y un fichero de evidencia en el repositorio.
- Ninguna fila bloqueada tiene
closednisucceededtras la corrección. - Las dos capturas de tcpdump muestran el SYN en la entrada y nada en la salida, y en el log está la línea que lo explica.
procedimiento.mdexiste y, si hubo hallazgo,hallazgos.mdymatriz-reglas.mdcitan la misma petición.
Para practicar Guarda en ut3/ matriz-pruebas.md, la carpeta evidencias/, hallazgos.md, procedimiento.md y el diagrama.
Sesión 19 · Práctica evaluable
La sesión empieza con diez minutos de aclaración del enunciado y el resto es para montar el informe con lo que ya está en ut3/: la práctica no pide nada que no haya salido de una hoja de la unidad, y al lado de cada punto va de dónde sale. El informe es el documento que se le daría a quien tiene que aprobar que esta red pase a producción, así que tiene que entenderse sin haber estado en el laboratorio: el diagrama dice cómo es la red, la matriz de reglas qué se permite y por qué, la matriz de pruebas que eso es verdad, y el hallazgo y el procedimiento, cómo se mantiene así cuando alguien pide un cambio.
Entrega un informe (máximo 6 páginas) sobre el entorno dev con los dos clientes:
- Diagrama de zonas con los dos clientes, subredes, gateways y máquinas (A3.5, paso 5).
- Matriz de reglas completa con la justificación de cada regla:
matriz-reglas.md, que empieza en el paso 6 de la A3.3 y completan el paso 5 de la A3.4 y los pasos 3 y 4 de la A3.5. - Matriz de pruebas ejecutada con evidencias, mínimo 8 filas (A3.5, pasos 1 y 2).
- Un hallazgo real y cómo lo corregiste (A3.5, paso 3). Si de verdad no ha habido ninguno, qué prueba adicional harías para buscarlo.
- El procedimiento para solicitar una regla nueva:
procedimiento.md(A3.5, paso 3).
Checklist antes de entregar:
- Ninguna regla usa IPs sueltas en lugar de aliases (las reglas de las A3.2 a A3.4 se escriben todas con aliases).
- Ningún escaneo desde Internet devuelve
closeden puertos no publicados; todo lo no publicado esfiltered(A3.2, paso 6). - La consola del firewall solo responde desde MGMT (A3.1, paso 3).
- El certificado del proxy tiene SAN y lo firma la CA del curso (A3.2, pasos 2 y 5).
- Las evidencias llevan fecha y máquina de origen visibles, con
date; hostname(A3.5, paso 1).
| Criterio (RA1 d) | De dónde sale | Peso |
|---|---|---|
| Capas de seguridad desplegadas según exposición (DMZ externa, DMZ interna y zona interna) | A3.1 a A3.3 y el diagrama de la A3.5 | 30 % |
| Pruebas de seguridad y aislamiento ejecutadas y documentadas | A3.5, pasos 1 y 2 | 30 % |
| Separación de clientes demostrada | A3.4, pasos 3 y 4 | 20 % |
| Matriz de reglas justificada y procedimiento | A3.3, paso 6; A3.4, paso 5; A3.5, pasos 3 y 4 | 20 % |
Cuando hayas entregado, destruye desde el nodo, con --purge, lo que ya no hace falta: router-dev (100), apagada desde el 20 de noviembre por si había que deshacer el relevo, y los dos clientes (180 y 181), que solo servían para esta unidad. Son 1,5 GB de memoria que quedan libres para lo que viene. Desde hoy el .1 de dev es solo el cortafuegos.
Lo que viene después no es una unidad nueva
Esta entrega cierra la unidad y con ella la primera evaluación. El 11 de diciembre hay examen: una prueba teórico-práctica en el laboratorio sobre la UT1, la UT2 y la UT3, que pesa el 60 % de la nota de la evaluación. Entra todo lo que se ha montado a mano hasta hoy: hipervisor y plantilla cloud-init, VPC con SDN y direccionamiento, DHCP y DNS propios, cortafuegos por zonas, publicación con proxy inverso y TLS, separación de clientes y pruebas de aislamiento. Repasa con las tres unidades y con las prácticas evaluables ya entregadas. La UT5, infraestructura como código, no empieza hasta el 16 de diciembre.
Errores frecuentes en el laboratorio
Las interfaces de OPNsense no corresponden a los bridges esperados. Síntoma: se asigna 10.10.1.1 a DMZEXT y web01 no hace ping al gateway. Causa: vtnet1 no está en devfront. Diagnóstico: en Interfaces → Assignments, comparar la MAC de cada vtnet con la que muestra Proxmox en el hardware de la VM. Se corrige reasignando, sin reinstalar.
La regla existe, pero está en la interfaz equivocada. La regla "permitir srv_web → srv_app:28080" está en la pestaña DMZINT porque el destino está ahí. Las reglas se evalúan a la entrada: va en DMZEXT. En el log aparece la denegación por defecto en la interfaz DMZEXT, que es la pista.
Port forward sin regla de filtro. El Destination NAT se creó con "Manual" en "Filter rule association": el DNAT traduce, pero la interfaz WAN bloquea el paquete traducido. nmap desde el aula muestra 443 filtered. Solución: "Register rule", o una regla manual en WAN con destino srv_web:443 (destino traducido, no IP WAN).
Los cambios no se aplican. Se ha guardado pero no se ha pulsado Apply. O sí, pero la conexión que se está probando ya tenía estado y sigue funcionando (o sigue bloqueada) hasta que expira. Hay que borrar el estado en Diagnostics → States.
El router Debian no reenvía nada aunque nftables lo permite. sysctl net.ipv4.ip_forward devuelve 0. Sin eso, el kernel descarta lo que no es para él antes de llegar al hook forward.
Todo pasa en el router Debian, incluso lo que debería bloquearse. Hay otra herramienta manipulando netfilter: Docker instalado en la misma VM ha creado sus propias cadenas, o iptables-legacy tiene reglas de una prueba anterior. nft list ruleset muestra todas las tablas, incluidas las que no ha puesto la configuración del router. Un router no debe llevar Docker.
db01 rechaza a app01 aunque el firewall lo permite. nc dice "Connection refused": el paquete llega. PostgreSQL escucha solo en localhost (listen_addresses en postgresql.conf) o pg_hba.conf no incluye 10.10.2.0/24. El firewall no tiene la culpa; el estado closed de nmap ya lo decía.
/cabeceras/ devuelve 502 aunque docker ps enseña whoami en 0.0.0.0:28090->28090/tcp. whoami se arrancó publicando el 28090 pero sin su opción --port, así que dentro del contenedor sigue escuchando en su 80 de fábrica y en el 28090 no contesta nadie. Desde web01, nc -zv 10.10.2.10 28090 da "Connection refused"; en app01, curl localhost:28090 se corta con Empty reply from server o Connection reset by peer, y docker logs dice en qué puerto arrancó. Se borra el contenedor y se vuelve a crear con --port 28090 detrás del nombre de la imagen.
nmap dice que el host está caído y no escanea. El firewall bloquea ICMP y nmap concluye que no hay nadie. -Pn.
Las VM de los clientes A y B se ven entre sí. Las dos NIC están en el bridge sin tag, o el bridge no es VLAN aware, o el tag se puso en el firewall y no en las VM. bridge vlan show en el host de Proxmox muestra qué puerto lleva qué VLAN.
Certificado rechazado por el navegador aunque lo firma la CA propia. Falta el SAN; desde 2017 Chrome y Firefox ignoran el CN. Hay que regenerarlo con subjectAltName.
nginx responde 403 donde tenía que estar la página de bienvenida. El bloque server tiene root /var/www/html pero no index index.nginx-debian.html: nginx busca index.html, que el paquete de Debian no trae, y como no tiene permitido listar el directorio, responde 403. Se añade la línea index.
El log del firewall no muestra la denegación buscada. "Log packets matched by the default deny rule" está desactivado, o la regla de Block creada no tiene log marcado. Hay que activarlo y repetir la prueba; el log no es retroactivo.
Las VM se quedan sin IP y sin DNS a mitad del relevo. Se apagó router-dev antes de que OPNsense tuviera configurado el DHCP y el DNS de las cuatro zonas. El orden de los pasos 4 y 5 de la A3.1 no es un capricho: primero se prepara el firewall, después se retira el router. Mientras tanto, cada VM sigue teniendo su concesión de 12 horas, así que hay margen para volver a levantar router-dev y rehacer el relevo con calma.
Dos máquinas con la misma .1. Ocurre si se activan las interfaces internas del firewall con router-dev todavía en marcha, o si alguna subnet del SDN conserva el gateway que se le puso al crearla. El síntoma es que el ping al .1 responde unas veces sí y otras no, o que el ARP del .1 cambia de MAC. Se comprueba con ip neigh en una VM de la zona y se arregla dejando un solo .1.
Tras el relevo, las VM no resuelven los nombres del laboratorio. dig db01.dev.lab desde web01 devuelve NXDOMAIN aunque los nombres de Internet resuelven. El 53 del cortafuegos lo atiende Unbound, que no conoce las reservas de dnsmasq: falta el reenvío del dominio lab a dnsmasq, dnsmasq no escucha en el puerto al que se reenvía, o Unbound tira la respuesta porque lleva una dirección privada (su protección contra el DNS rebinding) y hay que añadir lab a sus dominios privados (Private Domains). El reparto entre los dos está en El relevo de router-dev.
Después del relevo, las VM no renuevan su concesión. networkctl renew no consigue respuesta y en Live View aparecen, bloqueados por la denegación por defecto, los paquetes de la VM al puerto 67 del cortafuegos. A dnsmasq le falta "DHCP register firewall rules", la opción que crea las reglas automáticas del DHCP en cada interfaz.
ssh al puesto de administración avisa de que la clave del host ha cambiado. Pasa tras el qm set 105 --nameserver de la A3.1: cloud-init regenera las claves del host al cambiar su configuración. No es un ataque: se borra la entrada vieja con ssh-keygen -R <IP de aula de admin01> en el puesto y se vuelve a entrar.
Los enlaces para ampliar y los apartados que van más allá de lo que se hace en clase están en Para ampliar.
UT4 · Nube pública: consola, CLI y SDK
En el centro, todo se montó primero a mano sobre Proxmox: el hipervisor, la VPC con sus subredes, OPNsense, la DMZ y el proxy inverso. Después, el entorno pre se levantó sin tocar la consola, con OpenTofu llamando a la API de Proxmox (una API es una interfaz a la que un programa le pide por HTTP que cree o liste recursos; la de Proxmox ya se había llamado a mano con curl y un token). Una empresa rara vez tiene todo eso en un armario propio: lo alquila a un proveedor de nube pública, que ofrece esas mismas piezas por horas y expuestas por API. Esta unidad trata de cómo se trabaja con esa infraestructura alquilada, y lo que cambia respecto al laboratorio cabe en dos ideas. La primera: la consola web, la CLI (la herramienta de línea de comandos del proveedor) y el SDK (la librería para hacer lo mismo desde código) son tres formas de llamar a la misma API, y lo que se aprende en una vale en las otras. La segunda: cada llamada lleva una identidad y puede costar dinero, así que quien tenga unas credenciales puede gastar a cargo de la empresa.
Por eso la unidad avanza en el orden en que se gana autonomía sin perder el control: entrar con una identidad propia y saber dónde se está (bloque 1), dejar la consola a mano y el gasto vigilado (bloque 2), pasar a la CLI sin claves permanentes (bloque 3), manejar varios entornos con perfiles (bloque 4) y hacer lo mismo desde código sin escribir una sola credencial (bloque 5). Conviene llegar a la empresa con la infraestructura como código reciente y salir de ella con perfiles de CLI funcionando y credenciales bien gestionadas.
Por qué se hace en la empresa. La nube pública cuesta dinero desde el primer minuto y necesita una cuenta real, así que esta unidad no se cursa en el centro: se hace durante la formación en empresa, sobre la cuenta de la empresa, y la plataforma la decide el tutor. Puede ser AWS, Azure, Google Cloud o alguna alternativa europea (OVHcloud, Hetzner, Scaleway). Los apuntes desarrollan AWS, que es el más extendido, y dan Azure y Google Cloud como correspondencia, en tablas o en pestañas; las alternativas europeas tienen sus propias CLI y librerías, pero los conceptos son los mismos. Lo que sigue es la guía de referencia que conviene llevar leída el primer día y la lista de evidencias que hay que entregar al terminar.
Cómo se trabaja. Se trabaja con la cuenta de la empresa y al lado de recursos de los que responde su equipo, así que cada hoja pide en su "Antes de empezar" una autorización concreta del tutor. Ninguna de las cinco actividades crea infraestructura: leen, configuran la propia sesión o, como mucho, crean una alerta de presupuesto. Si el tutor encarga crear algo aparte, se aplica la regla de la empresa: se destruye el mismo día. El tutor marca cuándo se hace cada actividad, pero el orden de las hojas no es arbitrario: la A4.2 parte de la identidad de la A4.1, y la A4.3, la A4.4 y la A4.5 se encadenan, porque el script de la última usa los perfiles de las dos anteriores. Cada una se documenta en la ficha de evidencias, que firma el tutor. Las capturas van sin datos sensibles: se tapan los números de cuenta completos, las claves, las IP públicas de producción y los correos de terceros. La razón es que la evidencia sale de la empresa y acaba en el aula virtual: un número de cuenta o una IP de producción le ahorran a un atacante el trabajo de averiguarlos, y una clave visible le da acceso directo. Por eso, en la práctica evaluable, una evidencia con credenciales visibles invalida la actividad.
Mantenimiento también está en la empresa estas semanas
La UT5 (logs, accesos y rendimiento) y la UT6 (copias de seguridad) de Mantenimiento se cursan en la empresa en las mismas semanas, y también piden evidencias anonimizadas. Conviene acordar con el tutor un mismo sistema para las tres unidades: la cuenta y la región que se identifican aquí suelen ser las de los servicios que allí se revisan, y si las copias de seguridad van a un almacenamiento de la nube, lo que se ve aquí sobre regiones, permisos y coste de descarga es lo que se aplica allí.
Bloque 1 · Acceso a la plataforma (CE 2a)
El primer día en la empresa, la consola de la nube es un catálogo de cientos de servicios con nombres propios, y antes de tocar nada hay que saber tres cosas: qué se está mirando, quién se es y dónde se está. Este bloque las responde en ese orden. Primero, el mapa: qué alquila un proveedor de nube, cómo reparte su infraestructura en regiones y zonas, y a qué pieza de Proxmox corresponde cada servicio, que es lo que convierte el catálogo en algo conocido (la tabla de correspondencias vuelve a usarse en la actividad de cierre). Después, la identidad: la cuenta todopoderosa que no se usa, las piezas con que se reparten los permisos, el segundo factor y las credenciales temporales, y cómo agrupa sus cuentas una empresa. Por último, las etiquetas, que dicen de quién es cada recurso. Va primero porque todo lo demás depende de ello: sin identidad no se entra, y sin saber en qué cuenta y en qué región se está, cada orden de los bloques siguientes puede ir al sitio equivocado. La hoja A4.1 lo aplica: entrar con el segundo factor y anotar la cuenta, la región y las etiquetas obligatorias.
Qué es una nube pública y qué se alquila
El problema. Todo lo montado en el centro tenía un techo físico: el Proxmox del puesto tenía la memoria que tenía, y cada VM nueva había que encajarla en su presupuesto de memoria. Una empresa con servidores propios vive lo mismo a otra escala: compra para el pico de uso, espera semanas a que llegue el hardware y paga el centro de datos aunque esté medio vacío.
Qué es y de dónde sale. Un proveedor de nube pública resuelve eso alquilando por horas (en muchos servicios, por segundos) la misma infraestructura que se construyó en el centro: máquinas virtuales, redes privadas, discos, balanceadores y DNS, y además bases de datos gestionadas y decenas de servicios que en el centro no hay (colas, almacenamiento de objetos, funciones sin servidor). La idea de alquilar servidores por horas y crearlos por API la popularizó Amazon en 2006, con sus servicios de almacenamiento y de máquinas virtuales, y Microsoft y Google la siguieron en los años siguientes. Se paga por uso, se crea y se destruye por API, y cualquier cosa que se hace desde la consola web se puede hacer desde la línea de comandos o desde código.
Cómo se trabaja con ella: tres puertas a la misma API. La consola, la CLI y un script con el SDK no son tres sistemas distintos, sino tres clientes de la misma API. Cada petición llega con unas credenciales, y antes de hacer nada la API comprueba si esa identidad tiene permiso para lo que pide:
flowchart TB
C["<b>Consola web</b><br><small>para mirar y para el primer día</small>"]:::pieza
L["<b>CLI</b><br><small>aws · az · gcloud</small>"]:::pieza
S["<b>Script con el SDK</b><br><small>boto3 · azure-mgmt · google-cloud</small>"]:::pieza
API["<b>API del proveedor</b><br><small>recibe la petición y sus credenciales</small>"]:::act
IAM{"<b>¿Esa identidad tiene permiso?</b>"}:::dato
R(["<b>Se lista, se crea o se borra</b><br><small>y, si toca, se factura</small>"]):::ok
D(["<b>AccessDenied</b><br><small>la petición no hace nada</small>"]):::riesgo
C --> API
L --> API
S --> API
API --> IAM
IAM -- sí --> R
IAM -- no --> D
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxLas tres puertas llevan a la misma API y en las tres decide la identidad. Es lo que pasaba con Proxmox: la consola web, pvesh, curl y OpenTofu acababan en el mismo sitio.
Para qué se usa en el curso. La consola es para mirar y para el primer día; la CLI y el SDK son con lo que se trabaja, porque lo que se hace con ellos se puede repetir, guardar en un fichero y revisar antes de lanzarlo, como el código de OpenTofu de iac-lab. Las hojas recorren las tres puertas en ese orden. Lo que las tres comparten es la identidad que acompaña a cada petición, y por eso, después del mapa de regiones y servicios, el bloque se dedica a ella.
Regiones y zonas de disponibilidad
El problema que resuelven. Un centro de datos puede quedarse sin corriente, inundarse o perder su conexión, y entonces cae a la vez todo lo que vive en él. Además, dónde están físicamente los datos no es indiferente: la distancia añade latencia, y la ley condiciona dónde se pueden guardar los datos personales (el RGPD, el reglamento europeo de protección de datos, pone condiciones a su traslado fuera del Espacio Económico Europeo). Los proveedores lo resuelven repartiendo su infraestructura en dos niveles.
Cómo se reparte. Una región es un conjunto de centros de datos en una zona geográfica, con nombre propio y su propio catálogo de servicios y de precios. Dentro de cada región hay varias zonas de disponibilidad (AZ, availability zones), cada una con uno o varios centros de datos separados físicamente de los de las otras zonas (a kilómetros de distancia, con alimentación y red independientes) pero unidos a ellos por enlaces de baja latencia. Un desastre en una AZ no debería afectar a las otras de la misma región; un desastre regional sí afecta a todas. Por eso un servicio que tiene que aguantar la caída de un centro de datos reparte sus máquinas entre dos o tres AZ, igual que en un clúster de Proxmox se repartirían entre nodos. Algunas de las regiones europeas que más se usan desde España:
| Proveedor | Región | Dónde está | Notas |
|---|---|---|---|
| AWS | eu-west-1 |
Irlanda (Dublín) | La primera región europea de AWS y de las que más servicios tienen. Tres AZ: eu-west-1a, 1b, 1c. |
| AWS | eu-south-2 |
España (Aragón) | Abierta en 2022. Útil por latencia y residencia de datos; algunos servicios llegan más tarde que a Irlanda. |
| AWS | eu-central-1 |
Alemania (Fráncfort) | Muy usada por empresas con requisitos de datos en la UE. |
| Azure | westeurope |
Países Bajos | Una de las regiones europeas de Azure con más servicios. |
| Azure | spaincentral |
Madrid | Abierta en 2024. |
| Google Cloud | europe-southwest1 |
Madrid | Zonas europe-southwest1-a, -b, -c. |
| Google Cloud | europe-west1 |
Bélgica | Región europea clásica de GCP. |
Dos consecuencias prácticas. La primera: casi todos los recursos son regionales. Una VPC de AWS vive en una región, y una subred, en una AZ concreta dentro de esa VPC. Si la consola de AWS se abre en us-east-1, no aparece nada de lo creado en eu-west-1. La segunda: los precios varían por región, a veces un 10 o un 20 %, y el tráfico entre regiones se paga. La región se elige por cercanía a los usuarios, por disponibilidad de los servicios necesarios y por dónde tiene que residir el dato, y se fija como región por defecto desde el primer día: es el dato que anota la A4.1 y el que llevan por defecto la consola y los perfiles de la CLI.
flowchart TD
R["<b>Región eu-west-1</b><br><small>Irlanda</small>"]:::infra
AZA["<b>AZ eu-west-1a</b>"]:::infra
AZB["<b>AZ eu-west-1b</b>"]:::infra
AZC["<b>AZ eu-west-1c</b>"]:::infra
VPC["<b>VPC 10.20.0.0/16</b><br><small>es regional: cruza las tres AZ</small>"]:::pieza
S1["<b>Subred pública</b><br><small>10.20.1.0/24 · en 1a</small>"]:::pieza
S2["<b>Subred privada</b><br><small>10.20.11.0/24 · en 1a</small>"]:::pieza
S3["<b>Subred privada</b><br><small>10.20.12.0/24 · en 1b</small>"]:::pieza
IGW["<b>Internet Gateway</b><br><small>sin coste por hora</small>"]:::ok
NAT["<b>NAT Gateway</b><br><small>se paga por hora y por GB</small>"]:::riesgo
R --> AZA & AZB & AZC
R --> VPC
VPC --> S1 & S2 & S3
S1 --> IGW
S2 --> NAT
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxLa subred vive en una zona; la VPC, en la región entera. En rojo lo que sigue cobrando aunque no pase tráfico.
La traducción a lo hecho en el centro es directa: la VPC es un entorno del laboratorio (dev, con su /16 repartido en VNets del SDN), la subred pública es front, la DMZ externa, las subredes privadas son back y data, el Internet Gateway es la interfaz WAN de OPNsense y el NAT Gateway es su NAT de salida. La diferencia es que en la nube cada una de esas piezas tiene precio, y el NAT Gateway en particular tiene uno que sorprende, como se ve en Los errores caros típicos.
Correspondencia con lo que ya sabes
Para qué sirve esta tabla. La correspondencia de la red ya se dio al presentar la VPC (Qué es una VPC); esta la extiende a todo lo que se ha montado en el curso, para que cada servicio de la consola se pueda traducir a algo conocido. Se lee por filas: la primera columna es lo que se hizo en el centro, y las otras tres, cómo se llama en cada proveedor. Es también la base de la actividad de cierre, que compara la nube de la empresa con la VPC del centro.
| Concepto del curso (Proxmox) | AWS | Azure | Google Cloud |
|---|---|---|---|
| Hipervisor / VM | EC2 (instancia) | Virtual Machines | Compute Engine |
| Plantilla de VM / cloud-init | AMI (imagen de máquina) + user data | Imagen + custom data | Imagen + startup script / metadata |
| Disco de la VM | EBS (volumen) | Managed Disk | Persistent Disk |
| Snapshot / backup | EBS Snapshot, AWS Backup | Snapshot, Azure Backup | Snapshot |
| VPC (zona y VNets del SDN) | VPC | Virtual Network (VNet) | VPC (global, subredes regionales) |
| Subred / zona | Subnet en una AZ | Subnet (la VNet abarca la región) | Subnet regional |
| OPNsense: reglas por interfaz | Security Groups (por instancia, con estado) y NACL (listas de control de acceso de red, por subred, sin estado) | Network Security Groups (con estado) | Firewall rules (a nivel de VPC, con etiquetas de red) |
| OPNsense: NAT de salida | NAT Gateway | NAT Gateway | Cloud NAT |
| OPNsense: WAN | Internet Gateway + Elastic IP | Public IP | External IP |
| Proxy inverso / balanceador | ALB (balanceador de aplicación) y NLB (balanceador de red) | Application Gateway, Load Balancer | Cloud Load Balancing |
| DNS interno | Route 53 (zonas privadas) | Azure DNS (zonas privadas) | Cloud DNS |
| Usuarios y permisos | IAM (users, roles, policies) e IAM Identity Center | Entra ID + RBAC | IAM + service accounts |
| Token de API de Proxmox | Claves de acceso de un user (AKIA...) |
Secreto de un service principal | Clave JSON de una service account |
| Estructura de cuentas | Organizations: root, OUs, cuentas | Management groups, suscripciones, resource groups | Organization, folders, proyectos |
| Consola integrada | CloudShell | Azure Cloud Shell | Cloud Shell |
| CLI | aws |
az |
gcloud |
| SDK Python | boto3 |
azure-identity, azure-mgmt-* |
google-cloud-* |
| SDK Node | @aws-sdk/client-* |
@azure/identity, @azure/arm-* |
@google-cloud/* |
| Contenedores gestionados | ECS (con Fargate), EKS | Container Apps, AKS | Cloud Run, GKE |
| Registro de imágenes | ECR | Azure Container Registry | Artifact Registry |
| Almacenamiento de objetos | S3 | Blob Storage | Cloud Storage |
| Monitorización (Prometheus y Grafana) | CloudWatch | Azure Monitor | Cloud Monitoring |
La fila de contenedores gestionados es solo un mapa: en este módulo no se despliega nada en ECS, AKS ni Cloud Run, pero conviene saber que ECS/Container Apps/Cloud Run son la opción "dame un contenedor y olvídate del clúster" y que EKS/AKS/GKE son Kubernetes gestionado (el plano de control lo lleva el proveedor, los nodos siguen siendo VM propias o gestionadas).
Identidad y estructura de cuentas
El problema. En el laboratorio había una sola persona por Proxmox, y aun así se separó root@pam de admin@pve, y OpenTofu recibió su propio usuario, terraform@pve, con los permisos justos. En la nube de una empresa llaman a la misma API decenas de personas, programas y pipelines, sobre recursos que cuestan dinero, y cada petición tiene que responder a tres preguntas: quién la hace, qué puede hacer y en qué cuenta. Casi todos los errores de los bloques siguientes ("no veo nada", "acceso denegado", "dice que soy otra persona") se explican por una de las tres, y la A4.1 pide identificarlas por escrito. El apartado las recorre en orden: la identidad que no se usa, las piezas con que se reparten los permisos, cómo se demuestra la identidad sin claves permanentes y cómo se agrupan las cuentas.
El usuario raíz y por qué no se usa a diario
Qué es. Toda cuenta de nube nace con una identidad todopoderosa: el usuario raíz en AWS (el correo con el que se creó la cuenta), el administrador global del tenant en Entra ID (Entra ID es el directorio de identidades de la empresa en Azure, y el tenant, la instancia de ese directorio que pertenece a una organización) y, en Google Cloud, el superadministrador de Google Workspace o Cloud Identity, el directorio del que cuelga la organización. Esa identidad puede cerrar la cuenta, cambiar los datos de pago y borrar cualquier cosa, y los permisos que se reparten dentro de la cuenta no la limitan.
Por qué no se usa a diario. Es el root@pam de Proxmox a escala de empresa, y vale la misma regla que en el laboratorio, donde se creó admin@pve para el trabajo diario y root se reservó para lo que solo él puede hacer (Usuarios y permisos): un descuido o una contraseña robada con esa identidad no tienen límite. Ninguna empresa seria la usa a diario: la protege con MFA (autenticación multifactor, un segundo paso además de la contraseña) con llave física, guarda la contraseña en una caja fuerte y registra cada uso. A quien llega a la empresa se le da un usuario propio o una identidad federada (su cuenta corporativa, en la que la nube confía) con permisos limitados, nunca la raíz ni una cuenta compartida.
Usuarios, roles y políticas
El problema. Para dar a cada persona o programa los permisos justos, y poder quitárselos sin tocar a los demás, hay que separar tres cosas: quién es, qué credencial presenta y qué se le permite. En Proxmox ya estaban separadas: el usuario terraform@pve de la A5.1 tenía su propio token (la credencial) y tres permisos, cada uno un rol sobre una ruta (PVEVMAdmin sobre /vms). Los proveedores de nube resuelven lo mismo con tres piezas: identidades de persona con credenciales de larga duración, identidades sin credenciales permanentes que se asumen durante un rato y devuelven credenciales temporales, y documentos que dicen quién puede hacer qué sobre qué recurso. El ejemplo va con nombres de AWS, que es el más extendido; en las pestañas del final del apartado están los equivalentes.
Las tres piezas en AWS. IAM (Identity and Access Management) es el servicio de AWS que decide quién puede hacer qué. Los users son identidades con credenciales de larga duración: contraseña de consola y, opcionalmente, un par de claves de acceso, un identificador que empieza por AKIA y su secreto. Los roles son identidades sin credenciales permanentes que se asumen durante un rato: una instancia EC2 asume un rol para leer de S3, una persona asume un rol de administrador en otra cuenta, Jenkins asume un rol para desplegar. Al asumir un rol se reciben credenciales temporales (clave, secreto y token de sesión) con una vida de entre 15 minutos y 12 horas. Las emite STS (Security Token Service, el servicio de AWS que fabrica credenciales temporales), y su clave empieza por ASIA en lugar de AKIA, así que una clave permanente se distingue de una temporal a simple vista. Las policies son documentos JSON que dicen quién puede hacer qué sobre qué recurso, y se adjuntan a users, a grupos o a roles.
flowchart TB
U["<b>User</b><br><small>credenciales de larga duración<br>AKIA… y su secreto</small>"]:::riesgo
R["<b>Role</b><br><small>sin credenciales permanentes<br>se asume durante un rato</small>"]:::ok
TMP["<b>Credenciales temporales</b><br><small>clave + secreto + token de sesión<br>de 15 min a 12 h</small>"]:::ok
POL["<b>Policy</b><br><small>JSON: quién, qué acción, sobre qué recurso</small>"]:::dato
QUIEN["<b>Se adjunta a</b><br><small>users, grupos o roles</small>"]:::pieza
U -. "puede asumir" .-> R
R --> TMP
POL --> QUIEN
QUIEN -.-> U
QUIEN -.-> R
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxLa diferencia que importa: el user lleva una llave que caduca cuando alguien se acuerda; el role entrega llaves que caducan solas.
Cómo se lee una política. Una política mínima para alguien que solo necesita mirar la red y las instancias en Irlanda tiene esta pinta:
{
"Version": "2012-10-17",
"Statement": [
{
"Sid": "SoloLecturaRedYComputo",
"Effect": "Allow",
"Action": [
"ec2:DescribeVpcs",
"ec2:DescribeSubnets",
"ec2:DescribeSecurityGroups",
"ec2:DescribeInstances",
"ec2:DescribeRegions"
],
"Resource": "*",
"Condition": {
"StringEquals": { "aws:RequestedRegion": "eu-west-1" }
}
}
]
}
Conviene fijarse en tres detalles, porque explican la mayoría de los accesos denegados de las actividades siguientes:
- Lo que no está permitido, está prohibido. El efecto por defecto es denegar: todo lo que no está en un
Allowexplícito está prohibido, y unDenyexplícito gana siempre. UnAccessDeniedno significa que algo esté roto, sino que nadie ha concedido ese permiso. - Las acciones se llaman como las órdenes. Se nombran como
servicio:Operación, con el mismo nombre que usa la CLI (aws ec2 describe-vpcsesec2:DescribeVpcs). El mensaje de error dice qué acción faltaba, y con ese nombre se le pide al tutor el permiso exacto. - La condición limita la región. Con esta política, la misma orden lanzada contra otra región devuelve
AccessDeniedaunque la acción esté en la lista.
Las políticas gestionadas por AWS como ReadOnlyAccess o AdministratorAccess sirven para empezar; en producción se escriben políticas propias con el mínimo necesario, que es el mínimo privilegio que se aplicó a las credenciales de Jenkins.
Cada proveedor le pone otro nombre a esas piezas y las organiza a su manera:
Los users llevan credenciales de larga duración, los roles se asumen y devuelven credenciales temporales, y las policies son los documentos JSON de arriba, adjuntos a users, a grupos o a roles. La estructura de cuentas la gestiona Organizations.
Lo que hoy usan las empresas para las personas no son users con clave, sino IAM Identity Center (el antiguo AWS SSO, inicio de sesión único): se entra con la identidad corporativa (Entra ID, Google Workspace, Okta) y se reciben credenciales temporales para cada cuenta y conjunto de permisos. Es lo que aws configure sso configura en la máquina local.
Azure separa dos mundos. Entra ID (antes Azure Active Directory) es el directorio: usuarios, grupos, aplicaciones, MFA, acceso condicional. Azure RBAC (control de acceso basado en roles) es la autorización sobre los recursos: una asignación de rol une una identidad (usuario, grupo, service principal, que es la identidad de una aplicación, o identidad administrada), un rol (Reader, Contributor, Owner, Network Contributor, o uno personalizado) y un ámbito (management group, suscripción, resource group o recurso concreto). Los permisos se heredan hacia abajo: Reader en la suscripción permite ver todos los resource groups de esa suscripción. Es el mismo modelo que los permisos de Proxmox, un rol sobre una ruta con herencia hacia los hijos, a escala de empresa. El equivalente al rol de AWS para máquinas y servicios es la identidad administrada (managed identity): una VM o una Container App recibe una identidad sin secretos que puede acceder a Key Vault (el almacén de secretos) o a Storage (el de ficheros).
En GCP el IAM funciona por bindings entre un principal (usuario de Google Workspace, grupo, service account) y un rol sobre un recurso, con herencia desde la organización a las carpetas y de estas a los proyectos. Hay roles básicos (Viewer, Editor, Owner, demasiado anchos para producción), roles predefinidos por servicio (roles/compute.viewer, roles/compute.networkViewer) y roles personalizados. Las service accounts son identidades para cargas de trabajo; una VM de Compute Engine arranca con una service account adjunta y obtiene tokens del servidor de metadatos sin fichero de clave alguno. Las claves JSON de service account descargadas son el equivalente a las claves AKIA de AWS: un secreto de larga duración que hay que evitar.
MFA, SSO y credenciales temporales
El problema. Una contraseña sola se roba, se adivina o se reutiliza, y una clave de acceso guardada en un fichero vale para siempre en manos de quien la copie. Para entrar en la consola, la respuesta es el segundo factor; para la CLI y el SDK, que no pueden pedir un código en cada orden, es no guardar claves permanentes y trabajar con credenciales que caducan solas.
Cómo encajan las piezas. Los tres proveedores empujan hacia el mismo esquema. La persona se autentica con MFA (un código TOTP, que genera una app como Google Authenticator y cambia cada treinta segundos, una llave física FIDO2 o una passkey del móvil) a través del proveedor de identidad de la empresa, que es el sistema donde están las cuentas corporativas (Entra ID, Google Workspace u otro). Eso es el SSO (single sign-on, inicio de sesión único): una sola autenticación sirve para la consola de la nube y para el resto de aplicaciones de la empresa. De ahí salen credenciales temporales para la consola y para la CLI, y en el portátil no queda ninguna clave permanente:
flowchart LR
P["<b>Persona</b>"]:::act
MFA["<b>MFA</b><br><small>TOTP, llave FIDO2 o passkey</small>"]:::pieza
IDP["<b>Proveedor de identidad</b><br><small>el de la empresa</small>"]:::pieza
TMP["<b>Credenciales temporales</b><br><small>para la consola y para la CLI</small>"]:::ok
NADA(["<b>Ninguna clave permanente<br>en el portátil</b>"]):::ok
P --> MFA --> IDP --> TMP --> NADA
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxEs el esquema al que empujan los tres proveedores. Si en la empresa se entrega un AKIA… por correo, algo va mal.
En la máquina de trabajo eso se traduce en estas órdenes, que no piden ninguna clave permanente y que la A4.3 usa para autenticarse:
# AWS con IAM Identity Center: abre el navegador para autenticarse y guarda un token de sesión
aws configure sso # solo la primera vez, crea el perfil
aws sso login --profile empresa-dev
# en una máquina sin navegador, las dos admiten --use-device-code
# Azure: abre el navegador contra Entra ID; --use-device-code si la VM no tiene navegador
az login
az login --use-device-code
# Google Cloud: dos logins distintos, uno para gcloud y otro para el SDK
gcloud auth login # identidad que usa la CLI
gcloud auth application-default login # identidad que usan las librerías (ADC)
Los dos logins de Google Cloud. La distinción de GCP entre gcloud auth login y gcloud auth application-default login confunde a todo el mundo la primera vez: la primera guarda una credencial que usa gcloud, y la segunda guarda un fichero en ~/.config/gcloud/application_default_credentials.json, que es lo que buscan las librerías cliente (las ADC, Application Default Credentials). Si un script de Python falla con DefaultCredentialsError ("Your default credentials were not found" en las versiones actuales de la librería, "Could not automatically determine credentials" en las antiguas), es porque se ejecutó el primero y no el segundo.
Lo que queda en el disco. Lo que dejan estos logins en el directorio personal (~/.aws/sso/cache/, ~/.azure/, ~/.config/gcloud/) son tokens que caducan o que la empresa puede revocar desde su proveedor de identidad, no claves permanentes. Aun así dan acceso mientras valen, así que esos directorios no se copian a otra máquina, no se suben a ningún repositorio y no salen en ninguna captura.
Claves de acceso de larga duración
Un par de claves de AWS (AKIA...) o una clave JSON de service account de GCP no caduca y no pide MFA. Si acaba en un repositorio público, en menos de una hora habrá alguien minando criptomoneda a cargo de la empresa (hay bots escaneando GitHub para eso). Si el tutor entrega una, conviene preguntar si de verdad no hay alternativa con SSO o roles, guardarla fuera del proyecto y borrarla al terminar. Nunca en un fichero del repositorio, nunca en una variable de entorno de un Dockerfile. En el laboratorio ya se usó una clave de este tipo: la credencial de MinIO para el estado de OpenTofu iba en AWS_ACCESS_KEY_ID y AWS_SECRET_ACCESS_KEY (Backend remoto). Contra una cuenta real de AWS, la misma clave da acceso a recursos que cuestan dinero.
Cómo se organizan las cuentas
El problema. Si toda la empresa trabajara en una sola cuenta, un error en desarrollo podría borrar producción, la factura no diría qué proyecto gasta qué y cualquier permiso amplio valdría para todo. Es el mismo razonamiento que separó dev, pre y pro en el laboratorio, llevado a la administración. Por eso ninguna empresa mediana trabaja con una sola cuenta: la unidad de aislamiento (facturación, límites y radio de explosión de un error) es la cuenta en AWS, la suscripción en Azure y el proyecto en GCP, y encima hay una jerarquía para agrupar y aplicar políticas:
flowchart TD
subgraph AWS["AWS"]
ORG["<b>Organization</b><br><small>management account</small>"]:::act
OU1["<b>OU Producción</b>"]:::pieza
OU2["<b>OU Desarrollo</b>"]:::pieza
C1["<b>Cuenta prod-web</b>"]:::dato
C2["<b>Cuenta prod-datos</b>"]:::dato
C3["<b>Cuenta dev</b>"]:::dato
C4["<b>Cuenta sandbox-alumnos</b>"]:::dato
ORG --> OU1 & OU2
OU1 --> C1 & C2
OU2 --> C3 & C4
end
subgraph AZ["Azure"]
TEN["<b>Tenant Entra ID</b>"]:::act
MG["<b>Management group raíz</b>"]:::pieza
MG1["<b>MG Producción</b>"]:::pieza
MG2["<b>MG Desarrollo</b>"]:::pieza
SUB["<b>Suscripción dev</b>"]:::dato
RG1["<b>rg-web-dev</b>"]:::dato
RG2["<b>rg-red-dev</b>"]:::dato
TEN --> MG --> MG1 & MG2
MG2 --> SUB --> RG1 & RG2
end
subgraph GCP["Google Cloud"]
GORG["<b>Organization</b><br><small>empresa.example</small>"]:::act
F1["<b>Folder Producción</b>"]:::pieza
F2["<b>Folder Desarrollo</b>"]:::pieza
P1["<b>Proyecto web-dev</b>"]:::dato
P2["<b>Proyecto sandbox-alumnos</b>"]:::dato
GORG --> F1 & F2
F2 --> P1 & P2
end
AWS ~~~ AZ ~~~ GCP
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxLos tres hacen lo mismo con nombres distintos: una raíz que factura, una capa de agrupación para aplicar políticas y una unidad aislada donde vive cada cosa.
Las políticas que bajan por la jerarquía. En AWS, Organizations permite aplicar políticas de control de servicio (service control policies) a una OU entera (unidad organizativa, una carpeta de cuentas): por ejemplo, "en la OU de desarrollo nadie puede crear recursos fuera de eu-west-1 ni instancias mayores de t3.large" (un tamaño de VM de 2 vCPU y 8 GB). En Azure, Azure Policy se asigna a un management group, a una suscripción o a un resource group, y los bloqueos de recurso (locks), que impiden borrar o modificar lo que protegen, se ponen en una suscripción, en un resource group o en un recurso concreto, nunca en un management group. El resource group es una capa más que agrupa recursos con el mismo ciclo de vida: al borrar el grupo se va todo lo que contiene, muy útil para limpiar prácticas. En GCP, las políticas de organización se aplican a la organización, a las carpetas y a los proyectos. Estas políticas explican los accesos denegados que ningún permiso del usuario explica: si la OU prohíbe una región, ni el administrador de la cuenta puede crear nada en ella.
Para qué se usa en el curso. Lo más probable es recibir acceso a una cuenta, suscripción o proyecto de desarrollo o sandbox (un entorno de pruebas aislado), y lo primero que hay que anotar es su identificador: el número de cuenta de 12 dígitos de AWS, el GUID de suscripción de Azure (un identificador de 32 caracteres hexadecimales separados por guiones) o el ID de proyecto de GCP. Todos los comandos y scripts de esta unidad giran alrededor de ese identificador, y es el dato que la A4.1 pide anotar, tapado en parte. Cada consola lo enseña en un sitio, junto a la identidad con la que se ha entrado: en AWS, el menú de la cuenta (arriba a la derecha) muestra el número de cuenta y el usuario o rol; en Azure, el icono de usuario muestra el usuario y el directorio (el tenant), y la página Subscriptions, las suscripciones con su ID; en GCP, el selector de proyecto de la barra superior. Es lo primero que se mira cuando algo no cuadra.
Etiquetado
El problema. En una cuenta compartida por varios equipos, con cientos de recursos creados por personas, por pipelines y por OpenTofu, nadie sabe de memoria de quién es cada máquina: qué proyecto la paga, a quién preguntar antes de apagarla o si alguien la olvidó tras una prueba.
Qué son. Las etiquetas (tags en AWS y Azure, labels en GCP) son pares clave/valor que se ponen a cada recurso. No cambian su comportamiento, pero permiten filtrar, facturar por proyecto y saber a quién preguntar antes de borrar algo. El mínimo habitual es proyecto, entorno (dev, pre, prod), propietario (normalmente un correo) y a veces coste (centro de coste) y caduca (fecha).
Por qué se sigue la convención de la empresa al pie de la letra. Muchas organizaciones tienen políticas que impiden crear recursos sin las etiquetas obligatorias, o scripts que borran de madrugada lo que no lleva propietario. Además, la vista de costes por etiqueta, la de la A4.2, solo funciona si todo el mundo escribe la misma clave de la misma forma: en AWS, donde las claves distinguen mayúsculas, Propietario y propietario son dos etiquetas distintas. Cada proveedor pone también sus límites de formato: en GCP los valores solo admiten minúsculas, números, guiones y guiones bajos, así que un correo se escribe de otra manera (alumno-empresa-example, por ejemplo).
Para qué se usa en el curso. Lo que se crea para practicar se etiqueta con algo reconocible (propietario=alumno-fp, caduca=2027-06-09) para que el tutor sepa qué puede borrar sin preguntar, y la política de etiquetas es el tercer dato que anota la A4.1.
A4.1 Acceso a la plataforma (CE 2a)
Objetivo Entrar en la consola del proveedor con tu usuario y MFA activo, y saber decir en qué cuenta, suscripción o proyecto, en qué región y con qué política de etiquetas trabajas. Son las tres coordenadas de todo lo que harás en la unidad: con otra cuenta o en otra región, las órdenes de la CLI y el script de la A4.5 irán a otro sitio, y lo que se cree sin las etiquetas obligatorias puede ser rechazado o borrado.
Antes de empezar
- Autorización del tutor para usar la cuenta de la empresa con el usuario que te haya creado, nunca el usuario raíz ni una cuenta compartida.
- Un móvil o una llave física para el segundo factor, del tipo que admita la empresa (app TOTP o passkey).
- Leído Identidad y estructura de cuentas, en particular MFA, SSO y credenciales temporales y Cómo se organizan las cuentas, y los apartados Regiones y zonas de disponibilidad y Etiquetado.
Pasos
Vas de lo que te protege a lo que te sitúa. Primero aseguras tu acceso, porque nada de lo demás debería hacerse con un usuario que solo tiene contraseña; después averiguas en qué cuenta estás y qué hay por encima de ella, luego en qué región están los recursos y, al final, cómo se marca de quién es cada cosa. Cada paso deja un dato para la Entrega y para el documento de cierre.
-
Protege tu acceso antes de nada. Entra por primera vez con tu usuario y activa el segundo factor antes de hacer nada más. Un usuario con solo contraseña es justo lo que buscan los ataques, y en la nube da acceso a recursos que cuestan dinero; cómo encaja el segundo factor con el SSO de la empresa está en MFA, SSO y credenciales temporales.
Pista: con SSO, el segundo factor se activa en el proveedor de identidad de la empresa, no en la nube. En Azure se registra en
https://mysignins.microsoft.com/security-info. -
Sitúate en la estructura de cuentas. Identifica la cuenta, suscripción o proyecto en que trabajas, con su identificador, y localiza dónde se ve la jerarquía que la agrupa (Organizations, management groups o carpetas), aunque no tengas permiso para tocarla: la captura de un acceso denegado también sirve. El identificador es el que usarán todas tus órdenes, y la jerarquía te dice qué políticas te llegan desde arriba, como se explica en Cómo se organizan las cuentas.
-
Encuentra la región de trabajo. Averigua en qué región crea la empresa sus recursos y comprueba que ahí hay máquinas o redes. Casi todo es regional, así que mirar en otra región es no ver nada (Regiones y zonas de disponibilidad), y es la región que llevarán por defecto tu consola y tus perfiles de la CLI.
Pista: la consola de AWS solo enseña la región del selector de arriba a la derecha: si no ves nada, casi siempre es eso.
-
Conoce la política de etiquetas. Pregunta al tutor por la política de etiquetas (cuáles son obligatorias y con qué formato) y comprueba en un recurso cualquiera que las lleva. Es lo que tendrá que llevar todo lo que crees, y la etiqueta de propietario es la que te dejará ver tus costes en la A4.2 (Etiquetado).
Comprobación Al cerrar sesión y volver a entrar te pide el segundo factor, y eres capaz de decir de memoria cuenta, región y las etiquetas obligatorias.
Entrega Captura de la consola con el usuario, la cuenta o proyecto y la región visibles, y un párrafo con el identificador (parcialmente tapado), la región y las etiquetas obligatorias. Todo va a la carpeta o el repositorio de evidencias, y la fila A4.1 de la ficha de evidencias la firma el tutor.
Si te sobra tiempo Busca en la consola qué políticas o roles tiene asignados tu usuario: te servirá para explicar los AccessDenied de las actividades siguientes.
Bloque 2 · Configuración de la interfaz (CE 2b)
Con la identidad clara aparecen dos riesgos nuevos. El primero parece de comodidad y acaba en errores: sin configurar, la consola abre donde le parece y cada entrada empieza buscando lo mismo. El segundo es de dinero: en la nube un descuido no avisa, se cobra, y la factura llega a fin de mes. Este bloque deja resueltas las dos cosas antes de que la unidad pase a la CLI. Primero, la consola: qué se ajusta el primer día y por qué, y el terminal que trae dentro, con la CLI ya instalada. Después, el coste: el presupuesto con alerta que avisa antes que la factura, las piezas que cobran aunque nadie las use y la regla de la empresa para lo que se cree. La hoja A4.2 deja la consola configurada, la alerta puesta y anotado el coste de partida, que la actividad de cierre compara con el del final de la estancia.
Consola web y shells integrados
El problema. La consola de un proveedor grande es una aplicación web con un panel para cada uno de sus cientos de servicios. Sin configurar, abre con la página de inicio genérica, en el idioma del navegador y, en AWS, en la última región que se visitó. Entrar en la región equivocada es la causa más común de "no veo nada", y buscar cada día los mismos servicios es tiempo perdido. Por eso el primer día se ajusta lo que pide el CE 2b, y cada ajuste tiene su razón:
- El idioma: inglés, salvo que la empresa trabaje en otro. La documentación, los mensajes de error y los foros están en inglés, y las traducciones de la consola cambian los nombres de los menús, así que un error traducido no se encuentra en ningún buscador.
- La región por defecto: la de la empresa, la que se anotó en la A4.1. En AWS se fija en la configuración de la consola (Unified Settings, en el icono del engranaje, donde también está el idioma) y vale para ese usuario en cualquier navegador. En Azure el portal no tiene región por defecto: se elige al crear cada recurso, y las listas enseñan los de todas las regiones. En Google Cloud la región por defecto es un dato del proyecto, compartido por todo el equipo, que la consola usa para rellenar los formularios: se consulta, pero no se cambia sin el tutor. La región por defecto personal, en los tres, se fija en la CLI (bloque 4).
- Los favoritos: los servicios a los que se vuelve en esta unidad, que son red, cómputo, identidad y facturación: VPC, EC2, IAM y Billing en AWS; Virtual networks, Virtual machines y Cost Management en Azure; VPC network, Compute Engine, IAM y Billing en GCP. El tema, a gusto de cada uno.
- La moneda en que se muestran los costes es un ajuste de la cuenta de facturación de la empresa. Se mira, porque la A4.2 pide anotarla, pero no se cambia: afecta a toda la empresa.
La vista que identifica al usuario (cuenta, usuario o rol, directorio) es la misma que se localizó en la A4.1, como se explica al final de Cómo se organizan las cuentas, y conviene tenerla a mano: es lo primero que se mira cuando algo no cuadra.
El terminal que trae la consola. Los tres tienen un terminal dentro de la consola, ya autenticado con la identidad con la que se abrió y con la CLI instalada. Se abre desde el icono de terminal de la barra superior, y es la forma más rápida de probar la CLI sin instalar nada:
| Shell integrado | Qué trae | Qué persiste |
|---|---|---|
| AWS CloudShell | Linux con aws, python3, git y docker |
1 GB de directorio personal, uno por región (al cambiar de región se cambia de CloudShell) |
| Azure Cloud Shell | Bash o PowerShell con az, terraform y kubectl; también en shell.azure.com |
El directorio personal, en un storage account que pide la primera vez; en sesión efímera, nada |
| Google Cloud Shell | Una VM pequeña con gcloud, kubectl, docker y editores |
5 GB de directorio personal |
Para qué se usa en el curso. El shell integrado sirve para el primer contacto con la CLI (es el "Si te sobra tiempo" de la A4.2) y para consultas puntuales. Para las hojas A4.3 a A4.5, el criterio habitual es instalar la CLI en el equipo de trabajo, donde está el código: los perfiles que crean la A4.3 y la A4.4 son los que usa el script de la A4.5, porque el SDK lee las credenciales de la CLI de esa misma máquina, y ahí es también donde se lanzaría OpenTofu, como en el puesto de administración del laboratorio. Si el tutor prefiere que no se instale nada, se acuerda con él dónde se hacen las tres; lo que no conviene es repartirlas entre dos sitios, porque obliga a repetir la autenticación y los perfiles.
Presupuestos y costes
El problema. En Proxmox una VM olvidada solo ocupa disco del puesto; en la nube cuesta dinero cada hora, y la factura llega a fin de mes, cuando el olvido lleva semanas sumando.
Cómo se resuelve. En dos capas: un presupuesto con alerta, que avisa cuando el gasto se acerca a una cifra, y saber qué piezas cobran aunque nadie las use, que son las que más sorprenden en la factura. Las dos se apoyan en el Etiquetado del bloque 1, que dice de quién es cada recurso y permite ver el gasto por propietario.
Para qué se usa en el curso. La alarma de gasto la deja puesta la A4.2. Los errores caros y la regla de destruir lo creado valen para lo que el tutor encargue aparte, porque ninguna de las cinco actividades de la unidad crea infraestructura: solo leen.
Free tier, presupuestos y alertas
El nivel gratuito no cuenta. Los tres proveedores tienen algún tipo de nivel gratuito para cuentas nuevas, pero nada de eso aplica aquí: la cuenta de la empresa es una cuenta de pago, así que cada recurso creado tiene coste desde el minuto uno. Qué regala cada proveedor a una cuenta nueva está en Para ampliar.
El presupuesto y su alerta. Un presupuesto es una cifra mensual que el proveedor compara con el gasto real y, si se le pide, con el previsto para final de mes; la alerta es el correo que manda cuando se supera un porcentaje de esa cifra. Por defecto no detiene nada: solo avisa. Y avisa con retraso, porque los datos de gasto llegan con horas de demora, así que es una red de seguridad para el olvido de un día, no para el de un minuto. Se configura antes de crear nada, porque su valor está en el olvido que todavía no se ha cometido. En AWS es Billing > Budgets (un presupuesto mensual de, digamos, 20 en la moneda de la cuenta, con aviso al 80 %); en Azure es Cost Management > Budgets sobre la suscripción o el resource group; en GCP es Facturación > Presupuestos y alertas.
La vista de costes. Además de la alerta, se mira la factura antes y después de cada práctica en la vista de costes de cada proveedor (Cost Explorer en AWS, Cost analysis en Azure, Informes de facturación en GCP), agrupada por servicio y filtrada por etiqueta. En AWS hay una trampa: una etiqueta solo aparece en Cost Explorer si alguien la ha activado como etiqueta de asignación de costes (cost allocation tag), y en una organización eso solo puede hacerlo la cuenta de gestión. Si el filtro por propietario no ofrece nada, casi siempre es eso.
Los errores caros típicos
Lo que cobra aunque nadie lo use. La mayoría de los sustos no vienen de una máquina encendida a propósito, sino de piezas que se cobran por existir, no por usarse, y que siguen ahí cuando la prueba ya terminó. Las habituales, con por qué duelen y cómo se evitan:
| Error | Por qué duele | Cómo se evita |
|---|---|---|
| NAT Gateway olvidado | Se cobra por hora aunque no pase tráfico (del orden de 30 a 35 € al mes en AWS) más cada GB procesado. Es la sorpresa más habitual en la factura de una VPC de pruebas. | Si solo hace falta salida a Internet desde una VM para instalar paquetes, sirve una IP pública temporal o una instancia NAT pequeña, y el gateway se destruye al terminar. |
| IP públicas reservadas | AWS cobra todas las IPv4 públicas por hora desde febrero de 2024 (0,005 dólares la hora, unos 3,6 dólares al mes cada una); Azure y GCP también cobran las IP públicas, y una IP estática reservada se paga aunque no esté asociada a nada. | Conviene liberar las Elastic IP (las IP públicas fijas de AWS) y las IP estáticas sin uso. La factura dice cuántas hay. |
| Snapshots y discos huérfanos | Al borrar una VM el disco puede quedarse (en AWS depende de DeleteOnTermination; en Azure, el disco administrado sobrevive a la VM si no se marcó para borrarse con ella). Los snapshots se cobran por GB al mes para siempre. |
Después de borrar, conviene listar los volúmenes y snapshots sin asociar y borrarlos. |
| Egress (tráfico saliente) | El tráfico que entra es gratis; el que sale a Internet o a otra región se paga por GB (AWS regala los primeros 100 GB al mes por cuenta). Descargar 500 GB de backups "para probar" se nota. | Los datos se mueven dentro de la misma región. Para pruebas, ficheros pequeños. |
| Instancias grandes "un momento" | Una máquina de 16 vCPU y 64 GB cuesta por hora unas 75 veces lo que una t3.micro (2 vCPU y 1 GB), y se olvida igual de fácil. |
Se crea siempre el tamaño mínimo que sirva y se deja una alarma en el móvil para apagarla. |
| Balanceadores y bases de datos gestionadas | Se cobran por hora desde que se crean, con datos o sin ellos. | No se crean en esta unidad salvo que el tutor lo pida. |
Regla de la empresa
Lo que se crea para practicar, si el tutor encarga crear algo, se destruye el mismo día. Antes de cerrar sesión se listan instancias, discos, IP, NAT y snapshots con la CLI y se compara con lo que había por la mañana: es la única forma de saber hoy que no queda nada, porque la factura tarda horas en reflejarlo. El coste se anota para el paso 4 de la actividad de cierre: es una evidencia tan válida como una captura.
A4.2 Configuración de la interfaz (CE 2b)
Objetivo Dejar la consola configurada para trabajar (idioma, región, favoritos) y tener una alerta de presupuesto que avise antes que la factura. Al terminar, la consola abre con lo que usas a mano y, si algún día se te olvida apagar algo, te enterarás por un correo y no por la factura de fin de mes.
Antes de empezar
- A4.1 hecha: entras con MFA y sabes en qué cuenta o suscripción estás.
- Autorización del tutor para crear un presupuesto sobre tu cuenta, suscripción o resource group; si no te lo puede dar, acuerda con él la etiqueta de propietario por la que vas a filtrar los costes.
- Leídos Consola web y shells integrados y Free tier, presupuestos y alertas.
Pasos
Primero haces que la consola trabaje para ti, después pones la red de seguridad del gasto y al final tomas la medida de partida. La alerta va antes de que el tutor te encargue crear nada, porque su valor está en el olvido que todavía no has cometido, y el coste de hoy es la línea base con la que compararás al cerrar la unidad.
-
Deja la consola a tu medida. Ponla en inglés (salvo que la empresa trabaje en otro idioma), con la región de la empresa por defecto y con los servicios de red, cómputo, identidad y facturación en favoritos: los de cada proveedor están en Consola web y shells integrados, con la razón de cada ajuste. Son los cuatro sitios a los que vuelves en toda la unidad, y la región por defecto es la que evita el "no veo nada".
Pista: en AWS, idioma y región por defecto están juntos en Unified Settings. En Google Cloud la región por defecto es del proyecto y la comparte todo el equipo: no la cambies.
-
Pon la alarma del gasto. Crea sobre tu cuenta, suscripción o resource group una alerta de presupuesto mensual (por ejemplo, 20 €) que avise a tu correo al 80 %, desde el menú de Free tier, presupuestos y alertas. Es la red de seguridad de todo lo que el tutor te encargue crear: si olvidas algo encendido, te avisa antes de que el gasto llegue al límite.
Pista: si no tienes permiso para crearla, la evidencia es la vista de costes del mes en curso (Cost Explorer, Cost analysis o Informes) filtrada por tu etiqueta de propietario. En AWS, si el filtro no ofrece la etiqueta, falta activarla como etiqueta de asignación de costes.
-
Toma la medida de partida. Anota el coste del mes hasta hoy y su moneda, que no se cambia porque es un ajuste de la cuenta de la empresa. Lo compararás con el del final de la estancia en la actividad de cierre, y la diferencia es lo que ha costado tu trabajo en la unidad.
Comprobación Al entrar, la consola abre en la región de la empresa (en AWS; en Azure y Google Cloud la consola no guarda una región tuya), los favoritos aparecen en la barra y el presupuesto figura en la lista de presupuestos con el umbral del 80 % (o la consulta de costes filtrada por tu etiqueta devuelve resultados).
Entrega Capturas de las preferencias y de la alerta de presupuesto (o de la consulta de costes), sin datos sensibles, en la carpeta de evidencias. Fila A4.2 de la ficha.
Si te sobra tiempo Abre el shell integrado y lanza aws sts get-caller-identity, az account show o gcloud auth list: ya está autenticado con la identidad de la consola.
Bloque 3 · Instalación de la CLI (CE 2c)
Con la consola se mira, pero no se trabaja: lo que se hace a clics no se puede repetir igual, ni guardar en un fichero, ni revisar antes de lanzarlo. La CLI resuelve eso, como qm y pvesh lo resolvieron frente a la consola web de Proxmox. A cambio, trae un problema que la consola no tenía: necesita credenciales guardadas en la máquina donde se ejecuta, y si son claves permanentes, quien copie el fichero se lleva el acceso. El bloque va en el orden en que se pone en marcha: qué es la CLI y qué forma tienen sus órdenes, cómo se instala la versión correcta, cómo se autentica sin claves permanentes y, al final, cómo se comprueba con qué identidad se está hablando. Es el grueso de la unidad, porque los dos bloques siguientes se apoyan en lo que deja montado. La hoja A4.3 hace ese recorrido y deja la CLI lista para los perfiles del bloque 4.
La CLI a fondo
Qué es. La CLI es un programa que traduce cada orden en una o varias llamadas a la API del proveedor, con las credenciales que tenga configuradas, y enseña la respuesta. Es la segunda de las tres puertas, y hace lo que pvesh y curl hacían con la API de Proxmox. Este apartado cubre lo que evalúa el CE 2c: instalarla, autenticarse sin claves permanentes y comprobar la identidad; los perfiles y el filtrado de las respuestas, que evalúa el CE 2d, van en el bloque 4.
La forma de las órdenes. Las tres CLI siguen el mismo patrón: la herramienta, el servicio, el recurso y la acción, y después las opciones (aws ec2 describe-vpcs, az network vnet list, gcloud compute networks list; AWS junta la acción y el recurso en una sola palabra). Esas tres órdenes listan las redes, y son las que usa la A4.3 para comprobar que la identidad puede leerlas. Las tres CLI guardan su configuración en el directorio personal, aceptan variables de entorno que la sobrescriben y pueden devolver JSON para filtrarlo. Lo que cambia es la ortografía, y sabiendo la forma, la orden concreta se encuentra en la ayuda de cada nivel (aws ec2 help, az network vnet -h, gcloud compute networks --help).
Instalación
Por qué el instalador oficial. Las CLI publican versiones nuevas con mucha frecuencia y los paquetes de las distribuciones van por detrás. Con AWS la diferencia importa: según la distribución, apt install awscli instala la v1 (Debian 11, Ubuntu 22.04), que no tiene aws configure sso, o una v2 con meses o años de retraso (Debian 12 y 13). El instalador oficial instala la última versión y se actualiza de la misma forma. En Azure y Google Cloud el camino oficial es el repositorio de paquetes del propio proveedor, que sí sigue el ritmo de cada versión:
La CLI v2 se distribuye como binario, no por pip. En Linux x86_64:
curl "https://awscli.amazonaws.com/awscli-exe-linux-x86_64.zip" -o awscliv2.zip
unzip awscliv2.zip
sudo ./aws/install
aws --version # aws-cli/2.x.y Python/3.x ...
En macOS hay un .pkg y en Windows un .msi; en ARM (Raspberry, Mac con Apple Silicon bajo Linux) el zip es awscli-exe-linux-aarch64.zip. Para actualizar se repite con sudo ./aws/install --update. Documentación: https://docs.aws.amazon.com/cli/latest/userguide/getting-started-install.html.
En Debian y Ubuntu, el script oficial añade el repositorio de Microsoft e instala el paquete azure-cli:
Si se prefiere no ejecutar un script con sudo sin leerlo (buena costumbre), la misma página documenta los pasos manuales: clave GPG, fichero en /etc/apt/sources.list.d/, apt install azure-cli. Documentación: https://learn.microsoft.com/cli/azure/install-azure-cli-linux.
En Debian y Ubuntu se añade el repositorio de Google y se instala google-cloud-cli:
sudo apt-get install -y apt-transport-https ca-certificates gnupg curl
curl https://packages.cloud.google.com/apt/doc/apt-key.gpg | sudo gpg --dearmor -o /usr/share/keyrings/cloud.google.gpg
echo "deb [signed-by=/usr/share/keyrings/cloud.google.gpg] https://packages.cloud.google.com/apt cloud-sdk main" | sudo tee /etc/apt/sources.list.d/google-cloud-sdk.list
sudo apt-get update && sudo apt-get install -y google-cloud-cli
gcloud version
Hay componentes opcionales (gcloud components list): kubectl, el emulador de Pub/Sub, etc. Con la instalación por apt los componentes se instalan también por apt (google-cloud-cli-gke-gcloud-auth-plugin, por ejemplo). Documentación: https://cloud.google.com/sdk/docs/install.
Autenticación y "quién soy"
Por qué se comprueba la identidad. Una CLI puede tener a mano varias credenciales a la vez (una sesión SSO, un perfil, unas variables de entorno olvidadas) y usa la que le toque según un orden que no siempre es el que se cree. Por eso, después de autenticarse, la primera orden es la que dice con qué identidad se está hablando con la API: si la salida no es la esperada, todo lo que venga después irá al sitio equivocado. Es también la evidencia que pide la A4.3. En AWS la respuesta la da la propia API, a través de STS (el servicio de credenciales temporales de Usuarios, roles y políticas); en Azure y en Google Cloud la dan los datos de sesión que guarda la CLI, y lo que confirma que valen es la primera orden que lee algo de verdad, que es el paso 4 de la A4.3.
aws configure sso
# SSO session name: empresa
# SSO start URL: https://empresa.awsapps.com/start
# SSO region: eu-west-1
# ... elige cuenta y permission set, región por defecto eu-west-1, formato json, nombre de perfil empresa-dev
aws sso login --profile empresa-dev
aws sts get-caller-identity --profile empresa-dev
{
"UserId": "AROAEXAMPLEID:alumno@empresa.example",
"Account": "123456789012",
"Arn": "arn:aws:sts::123456789012:assumed-role/AWSReservedSSO_DevReadOnly_abc123/alumno@empresa.example"
}
El Arn (Amazon Resource Name, el identificador único de cualquier recurso o identidad en AWS) indica que se está usando un rol asumido vía SSO (AWSReservedSSO_..., el rol que IAM Identity Center crea en cada cuenta para cada conjunto de permisos o permission set) y no un user con claves. Si la empresa entrega claves de acceso en lugar de SSO, aws configure --profile empresa-dev las pide y las guarda en ~/.aws/credentials, y entonces el Arn tiene la forma arn:aws:iam::<cuenta>:user/<nombre>.
Desde la versión 2.22, aws configure sso y aws sso login esperan un navegador en la misma máquina. En una VM sin navegador se les añade --use-device-code, que da una dirección y un código para autorizar el acceso desde el navegador de otro equipo.
az login # abre el navegador
az account show # tenant y suscripción activa
az account list -o table # todas las suscripciones a las que se tiene acceso
az account set --subscription "Desarrollo"
az ad signed-in-user show --query "{nombre:displayName, upn:userPrincipalName}"
az account show devuelve el id de la suscripción (el GUID), el tenantId y el usuario, con su tipo: user para una persona, servicePrincipal para una aplicación. Si hay acceso a varias suscripciones, az login pide elegir una (desde la versión 2.61; las anteriores dejaban activa la primera de la lista) y el resto de órdenes van contra la que esté activa; cambiarla es az account set.
gcloud init # asistente: cuenta, proyecto, región y zona por defecto
gcloud auth list # cuentas autenticadas y cuál está activa
gcloud config list # proyecto, región, zona de la configuración activa
gcloud config set project sandbox-alumnos-2027
gcloud auth application-default login # para el SDK
gcloud auth list marca con un asterisco la cuenta activa; una service account se reconoce porque su dirección termina en .gserviceaccount.com. gcloud config list muestra la configuración activa (proyecto, cuenta, región y zona por defecto).
A4.3 Instalación de la CLI (CE 2c)
Objetivo Tener la CLI del proveedor instalada donde diga la empresa, autenticada sin claves de larga duración y con la identidad comprobada. Es la base de las dos hojas siguientes: los perfiles de la A4.4 parten de esta autenticación y el script de la A4.5 usa sus credenciales, así que lo que quede mal aquí falla allí.
Antes de empezar
- Autorización del tutor sobre dónde instalarla (tu portátil, una VM de la empresa o el shell integrado) y sobre el mecanismo de autenticación que usa la empresa. Si te ofrece un par de claves de acceso, pregúntale antes si hay alternativa con SSO o roles. Lo práctico es hacer esta hoja y las dos siguientes en la misma máquina, por lo que explica el final de Consola web y shells integrados.
- Permisos de administrador en la máquina donde instales.
- Leídos La CLI a fondo, con Instalación y Autenticación y "quién soy".
Pasos
Sigues el orden de cualquier herramienta que habla con una API: primero que el programa funcione, después que tenga credenciales, luego que sean las que crees y, solo entonces, una operación real. Así, si el último paso falla, sabes que el problema está en los permisos y no en la instalación ni en la identidad.
-
Instala la versión buena. Usa el instalador oficial de Instalación y comprueba qué versión te queda; en el shell integrado la CLI ya viene instalada. La versión importa: la autenticación por SSO de los pasos siguientes necesita una versión reciente, y la que trae tu distribución puede no tenerla.
Pista: según la distribución,
apt install awsclida la v1, que no tieneaws configure sso, o una v2 antigua. -
Autentícate sin claves permanentes. Entra con el mecanismo de la empresa, sin claves de larga duración, y comprueba con qué identidad hablas con la API, como en Autenticación y "quién soy". La comprobación no es un trámite: si la identidad no es la que esperas, todo lo que hagas después irá a otro sitio.
Pista: el perfil se llama
empresa-dev, porque la A4.4 y la A4.5 lo usan por ese nombre. En una máquina sin navegador, añade--use-device-code.Pista: en una VM sin navegador,
az login --use-device-code.Pista: la configuración se llama
empresa-dev, porque la A4.4 la usa por ese nombre. Créala antes degcloud init, ogcloud initrellenará ladefault. -
Identifica qué credencial tienes. Escribe en una línea qué tipo de credencial muestra la salida de identidad: rol asumido por SSO, usuario con claves, cuenta de persona o service account. Es la prueba de lo que pide el CE 2c, que trabajas sin claves de larga duración, y saber leerla te servirá cada vez que una orden diga que eres otra persona (Usuarios, roles y políticas).
Pista: en AWS lo dice el
Arn; en Azure, el campouser.typedeaz account show; en GCP, la cuenta activa degcloud auth list. -
Haz una lectura de verdad. Lista las redes con la orden de tu proveedor del principio de La CLI a fondo, para ver si tu identidad puede leerlas. Hasta aquí has comprobado quién eres; esta orden comprueba qué puedes hacer, y un
AccessDeniedque sabes explicar con cómo se lee una política vale tanto como un listado.
Comprobación El comando de versión devuelve una versión reciente (AWS 2.x), el de identidad devuelve tu usuario o rol en la cuenta de la empresa, y el listado de redes devuelve algo o un AccessDenied que sabes explicar.
Entrega Salida de aws --version y aws sts get-caller-identity, o az version y az account show, o gcloud version y gcloud auth list, en texto (no captura), con el comentario de una línea sobre el tipo de credencial. Fila A4.3 de la ficha.
Si te sobra tiempo Mira qué ha dejado la autenticación en ~/.aws, ~/.azure o ~/.config/gcloud y comprueba que no hay ningún fichero con una clave permanente.
Bloque 4 · Gestión de perfiles (CE 2d)
Con la CLI autenticada contra un entorno se trabaja bien hasta que hay dos: desarrollo y preproducción, dos regiones o dos suscripciones. Entonces cada orden tiene que decir, además de qué hace, contra qué entorno lo hace, y el error típico deja de ser una orden mal escrita para ser una orden correcta lanzada contra el entorno equivocado. Los perfiles resuelven eso: agrupan con un nombre la cuenta, la región y las credenciales de cada entorno. El bloque va en dos partes. Primero, cómo se definen los perfiles, dónde se guardan y las dos formas de elegir uno, que se diferencian en su alcance; después, cómo se recorta la respuesta de la CLI para que varias pantallas de JSON quepan en una tabla, que es lo que hace legibles las evidencias. La hoja A4.4 crea el segundo perfil, cambia entre los dos de las dos formas y deja listo empresa-pre, que la A4.5 usa junto a empresa-dev.
Perfiles y ficheros de configuración
Qué es un perfil. Un perfil (AWS), un directorio de configuración de az con su login, su suscripción activa y sus valores por defecto (Azure) o una configuration (GCP) agrupan con un nombre la región, el proyecto y las credenciales de un entorno, y lo normal es tener uno por entorno: empresa-dev, empresa-pre, o uno por región cuando se trabaja en dos. Es la misma idea que los directorios envs/dev y envs/pre de iac-lab: lo que cambia de un entorno a otro, separado y con nombre. Crearlos, elegirlos y borrarlos es el núcleo del CE 2d.
Cómo se elige. En los tres proveedores hay dos mecanismos, y lo que los distingue es su alcance. Una opción en la orden (--profile en AWS, --configuration en GCP) vale solo para esa orden; una variable de entorno (AWS_PROFILE, AZURE_CONFIG_DIR, CLOUDSDK_ACTIVE_CONFIG_NAME) vale para todo lo que se lance desde ese shell hasta que se quite. az no tiene una opción para elegir perfil, y en su lugar la variable se escribe delante de la orden, que la limita a esa orden. La variable exportada es lo que usan los scripts y los pipelines para elegir entorno, y por eso es también lo que se queda olvidado:
flowchart TB
O{"<b>¿La orden lleva la opción?</b><br><small>--profile · --configuration</small>"}:::dato
V{"<b>¿Hay una variable exportada?</b><br><small>AWS_PROFILE · AZURE_CONFIG_DIR<br>CLOUDSDK_ACTIVE_CONFIG_NAME</small>"}:::dato
P1(["<b>Ese perfil, solo para esa orden</b>"]):::ok
P2(["<b>El de la variable, para todo el shell</b><br><small>hasta que se quita</small>"]):::riesgo
P3(["<b>El perfil por defecto o el activo</b><br><small>el que dicen los ficheros</small>"]):::pieza
O -- sí --> P1
O -- no --> V
V -- sí --> P2
V -- no --> P3
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxLa opción manda sobre la variable, y la variable sobre los ficheros. La del medio es la peligrosa: vale para todo lo que se lance desde ese shell y no se ve.
Las pestañas muestran cómo es cada uno por dentro, con sus ficheros y sus órdenes:
Dos ficheros. ~/.aws/config guarda todo lo que no es secreto (región, formato de salida, sesiones SSO, roles a asumir) y ~/.aws/credentials guarda claves de acceso si las hay. Con SSO el segundo no existe y el token temporal se cachea en ~/.aws/sso/cache/.
# ~/.aws/config
[sso-session empresa]
sso_start_url = https://empresa.awsapps.com/start
sso_region = eu-west-1
sso_registration_scopes = sso:account:access
[profile empresa-dev]
sso_session = empresa
sso_account_id = 123456789012
sso_role_name = DevReadOnly
region = eu-west-1
output = json
[profile empresa-pre]
sso_session = empresa
sso_account_id = 210987654321
sso_role_name = PreReadOnly
region = eu-south-2
output = table
Para asumir un rol en otra cuenta usando las credenciales de un perfil existente hay un tercer mecanismo, role_arn con source_profile; ninguna actividad lo usa y su formato está en Para ampliar.
aws configure list-profiles
aws configure list --profile empresa-pre # de dónde sale cada valor
aws ec2 describe-vpcs --profile empresa-dev --output table
aws ec2 describe-vpcs --profile empresa-pre
export AWS_PROFILE=empresa-dev # y ya no hace falta --profile
aws configure set region eu-west-1 --profile empresa-dev
Borrar un perfil es editar el fichero a mano; no hay subcomando. Variables de entorno que mandan sobre los ficheros: AWS_PROFILE, AWS_REGION (y la antigua AWS_DEFAULT_REGION), AWS_ACCESS_KEY_ID, AWS_SECRET_ACCESS_KEY, AWS_SESSION_TOKEN, y AWS_CONFIG_FILE, que cambia el fichero entero. Unas claves exportadas en AWS_ACCESS_KEY_ID y AWS_SECRET_ACCESS_KEY y olvidadas en el shell pasan por delante de AWS_PROFILE y del perfil por defecto, y ese es un clásico de "por qué me dice que soy otro".
az guarda todo en ~/.azure/: azureProfile.json con las suscripciones y cuál está activa, el caché de tokens de la librería de autenticación de Microsoft y config (formato INI) con las opciones por defecto. El concepto de "perfil" se reparte entre la suscripción activa y esa configuración:
az account list -o table # suscripciones disponibles
az account set --subscription "Desarrollo" # cambia el contexto
az account show --query "{sub:name, id:id, tenant:tenantId}" -o table
az config set core.output=table # formato por defecto
az config set defaults.location=spaincentral # región por defecto para crear recursos
az config set defaults.group=rg-red-dev # resource group por defecto
az config get # ver todo
az config unset defaults.group
Para tener dos "perfiles" separados de verdad, cada uno con su login, su suscripción activa y su región por defecto, se usa AZURE_CONFIG_DIR: la variable apunta a otro directorio y az mantiene ahí su propio login y configuración. Es el mecanismo de la A4.4, donde ~/.azure hace de perfil de dev y ~/.azure-pre de perfil de pre, y funciona igual con una sola suscripción que con dos.
export AZURE_CONFIG_DIR=~/.azure-pre
az login # sesión independiente, guardada en ~/.azure-pre
az config set defaults.location=westeurope # la región por defecto de este perfil
unset AZURE_CONFIG_DIR # vuelta a ~/.azure
AZURE_CONFIG_DIR=~/.azure-pre az network vnet list -o table # pre solo para esta orden
Otras variables útiles: AZURE_DEFAULTS_LOCATION, AZURE_DEFAULTS_GROUP, AZURE_CORE_OUTPUT. Cualquier opción de az config se puede expresar como variable AZURE_<SECCION>_<CLAVE> en mayúsculas.
gcloud tiene el concepto más limpio: las configurations son conjuntos con nombre de propiedades (cuenta, proyecto, región, zona) que se guardan en ~/.config/gcloud/configurations/config_<nombre> y se activan de forma exclusiva.
gcloud config configurations list
gcloud config configurations create empresa-dev
gcloud config set account alumno@empresa.example
gcloud config set project sandbox-alumnos-2027
gcloud config set compute/region europe-southwest1
gcloud config set compute/zone europe-southwest1-a
gcloud config configurations create empresa-pre
gcloud config set project pre-web-2027
gcloud config set compute/region europe-west1
gcloud config configurations activate empresa-dev
gcloud compute networks list
gcloud compute networks list --configuration=empresa-pre # sin cambiar la activa
gcloud config configurations delete <nombre> # no borra la activa
La configuración activa se apunta en ~/.config/gcloud/active_config. Variables: CLOUDSDK_ACTIVE_CONFIG_NAME selecciona una configuración, y cualquier propiedad se puede sobrescribir con CLOUDSDK_<SECCION>_<PROPIEDAD> (CLOUDSDK_CORE_PROJECT, CLOUDSDK_COMPUTE_ZONE). También --project en cualquier comando.
Formatos de salida y filtrado
El problema. El JSON completo de describe-instances de una cuenta con veinte máquinas ocupa varias pantallas, y lo que se busca suele ser una columna: el identificador, el estado o la IP. Buscar a ojo en ese JSON es la forma más segura de equivocarse, y pegarlo en una evidencia la hace ilegible.
Cómo se resuelve. Las tres CLI permiten elegir el formato de salida (JSON, tabla o texto) y quedarse con los campos que importan, ya sea pidiendo al servidor que filtre o recortando la respuesta en el propio cliente. Con lo primero viajan menos datos por la red; lo segundo vale para cualquier campo.
Para qué se usa en el curso. Las salidas de la A4.4 se entregan en texto, y con una tabla de tres o cuatro columnas se ve de un vistazo que los dos perfiles apuntan a entornos distintos.
--output acepta json (por defecto), table, text y yaml. --query aplica una expresión JMESPath (un lenguaje de consulta para JSON, como una ruta con filtros) sobre el JSON antes de formatearlo.
aws ec2 describe-vpcs --output table
aws ec2 describe-vpcs --query "Vpcs[].{Id:VpcId, Cidr:CidrBlock, Default:IsDefault}" --output table
# instancias: id, tipo, estado, IP privada y la etiqueta Name
aws ec2 describe-instances \
--query "Reservations[].Instances[].{Id:InstanceId, Tipo:InstanceType, Estado:State.Name, IP:PrivateIpAddress, Nombre:Tags[?Key=='Name']|[0].Value}" \
--output table
# solo las que están encendidas, con filtro en el servidor (más barato que filtrar en cliente)
aws ec2 describe-instances --filters "Name=instance-state-name,Values=running" \
--query "Reservations[].Instances[].InstanceId" --output text
--filters filtra en el servidor (menos datos por la red) y --query en el cliente. Para scripts, --output text con --query devuelve columnas separadas por tabulador, cómodo para while read.
-o (o --output) acepta json, jsonc, table, tsv, yaml y none. --query usa JMESPath igual que AWS, así que la sintaxis se traslada.
az network vnet list -o table
az network vnet list --query "[].{Nombre:name, RG:resourceGroup, Rango:addressSpace.addressPrefixes[0]}" -o table
# máquinas con su estado (necesita -d para que traiga el powerState)
az vm list -d --query "[].{Nombre:name, RG:resourceGroup, Estado:powerState, IP:privateIps}" -o table
# solo las de un resource group
az vm list -g rg-web-dev -o table
tsv es el formato para scripts: sin comillas ni cabeceras.
--format acepta json, yaml, table(...), value(...), csv(...) y más; --filter selecciona los elementos con una sintaxis propia, distinta de JMESPath.
gcloud compute networks list
gcloud compute networks list --format="table(name, x_gcloud_subnet_mode, x_gcloud_bgp_routing_mode)"
gcloud compute networks subnets list --filter="region:europe-southwest1" --format="table(name, region.basename(), ipCidrRange)"
# máquinas: nombre, zona, tipo, estado, IP interna
gcloud compute instances list \
--format="table(name, zone.basename(), machineType.basename(), status, networkInterfaces[0].networkIP)"
gcloud compute instances list --filter="status=RUNNING" --format="value(name)"
gcloud compute instances list --format=json | jq '.[].name'
value(...) es el equivalente de --output text de AWS. --format=json con jq (el filtro de JSON de línea de comandos) es lo que hace todo el mundo cuando las proyecciones de gcloud se vuelven crípticas.
A4.4 Gestión de perfiles (CE 2d)
Objetivo Tener dos perfiles o configuraciones que apunten a entornos distintos, saltar entre ellos con el mecanismo nativo y con la variable de entorno, y saber qué ficheros hay debajo. Importa porque el error más caro con la CLI no es una orden mal escrita, sino una orden correcta lanzada contra el entorno equivocado, y eso solo se evita sabiendo en cada momento qué perfil manda.
Antes de empezar
- A4.3 hecha: la CLI autenticada con
empresa-devy la identidad comprobada. - Autorización del tutor para acceder a un segundo entorno (dev y pre, dos regiones o dos suscripciones). Si solo tienes uno, el segundo perfil apunta al mismo con otra región por defecto.
- Leídos Perfiles y ficheros de configuración y Formatos de salida y filtrado.
Pasos
Vas de lo más acotado a lo más amplio. Creas el segundo perfil, cambias de entorno primero con la opción de la orden, que solo afecta a esa orden, y después con la variable de entorno, que afecta a todo el shell; luego miras los ficheros donde vive todo eso y terminas creando y borrando un perfil de usar y tirar. Así conoces el alcance de cada mecanismo antes de la A4.5, cuyo script cambia de entorno solo con la variable.
-
Crea el segundo perfil. Da de alta el perfil o la configuración
empresa-pre, apuntando al otro entorno. Con un solo perfil no hay nada que elegir: este es el que demuestra que sabes separar entornos, y el que usa la A4.5 junto aempresa-dev.Pista: otra vez
aws configure sso, reutilizando la sesión SSO deempresa-dev.Pista:
azno tiene perfiles con nombre: pre es el directorio~/.azure-pre, con su propioaz loginy sudefaults.location.Pista: la configuración nueva nace vacía y activa; al terminar de rellenarla, vuelve a activar
empresa-dev. -
Cambia de entorno para una sola orden. Lista las redes con cada perfil usando el mecanismo nativo, que es una opción de la propia orden, sin cambiar el perfil activo. Es la forma más segura de tocar otro entorno: el cambio dura lo que dura la orden y no deja nada cambiado, como se ve en el esquema de Perfiles y ficheros de configuración.
Pista:
azno tiene esa opción. Su mecanismo nativo es ponerAZURE_CONFIG_DIR=~/.azure-predelante de la orden. -
Cambia de entorno para toda la sesión. Repite el cambio con la variable de entorno, sin opciones en la orden, y muestra de dónde sale cada valor mientras está exportada. Es como eligen entorno los scripts y los pipelines, y justo lo que hará la A4.5. Quítala al terminar: olvidada en el shell, manda sobre el perfil por defecto, y todo lo que lances después sin opción irá a ese entorno sin avisar.
Pista: lo que en AWS dice
aws configure list, en Azure lo diceaz config gety en GCP,gcloud config list. -
Mira lo que hay debajo. Muestra los ficheros de configuración que hay debajo de los dos perfiles, sin ningún secreto. Cuando una orden no hace lo que esperas, el fichero es la fuente de verdad, y saber cuáles guardan secretos es lo que evita que acaben en una evidencia o en un repositorio.
Pista: en AWS,
~/.aws/configy nunca~/.aws/credentials. -
Crea y borra un perfil de usar y tirar. Practica el borrado con
empresa-tmp: créalo, comprueba que aparece en el listado, bórralo y vuelve a listar. Borrar también es gestionar perfiles, y cada CLI lo hace de una forma distinta: con uno de prueba lo aprendes sin arriesgar los buenos.empresa-presigue vivo para la A4.5.Pista: no hay subcomando para borrar: el bloque se quita de
~/.aws/configa mano.Pista: el perfil es un directorio,
~/.azure-tmp, y se borra con él.Pista: créala con
--no-activate, porquegcloudno deja borrar la configuración activa.
Comprobación Los dos perfiles apuntan a entornos distintos (listados de redes distintos o, si comparten cuenta, región por defecto distinta), aws configure list o su equivalente muestra de dónde sale cada valor con la variable exportada, y tras borrar el perfil de prueba el listado vuelve a ser el de antes de crearlo, con el perfil de pre dentro.
Entrega Los comandos y sus salidas en texto: los listados de cada perfil de los pasos 2 y 3, el fichero ~/.aws/config o las dos salidas de az config get, o la de gcloud config configurations list, y el borrado del paso 5. Fila A4.4 de la ficha.
Si te sobra tiempo Exporta a la vez AWS_PROFILE y una AWS_REGION distinta de la del perfil y comprueba con aws configure list cuál gana.
Bloque 5 · SDK (CE 2e)
La CLI cubre el trabajo a mano y los scripts cortos de shell, pero cuando la lógica crece (cruzar datos de varios servicios, tratar errores, generar un informe) hace falta un lenguaje de programación. Y entonces vuelve el problema de las credenciales en su peor versión: lo más fácil es escribir la clave en el código, y el código acaba en un repositorio. El bloque lo resuelve en orden. Primero, de dónde saca un programa sus credenciales sin que nadie las escriba, que es la cadena de credenciales por defecto; después, el ejemplo en Python o en Node que se apoya en ella; y al final, las buenas prácticas que protegen el repositorio, con el repaso de gitleaks. La hoja A4.5 lo junta en un script que lista redes y máquinas sin una sola credencial dentro y que funciona con los dos perfiles del bloque 4 cambiando solo una variable de entorno.
Librerías cliente (SDK)
Qué es. El último paso es hacer desde código lo que ya se hace desde la CLI. Un SDK (software development kit) es la librería del proveedor que hace desde un lenguaje de programación las mismas llamadas a la API que la CLI: boto3 en Python para AWS, los paquetes azure-* para Azure, los google-cloud-* para Google Cloud, y sus equivalentes en Node. Es la tercera de las tres puertas. Lo que importa aquí no es la librería concreta, sino de dónde saca el programa sus credenciales sin que nadie las escriba en él. En AWS la relación con la CLI es directa: la CLI está construida sobre la misma base que boto3 (la librería botocore), y por eso las dos leen los mismos ficheros de ~/.aws.
Qué evalúa el CE 2e. Que la librería se instale con el gestor de dependencias del proyecto, nada de pip install suelto sin dejar rastro en requirements.txt, porque otra persona o un pipeline tienen que poder reproducir el mismo entorno; que el script no lleve credenciales dentro; y que se entienda de dónde las saca.
La cadena de credenciales por defecto
El problema. Un script con la clave escrita dentro funciona, pero solo con esa clave, solo contra su entorno y solo hasta que alguien sube el fichero a un repositorio. Lo que se quiere es lo contrario: un script sin ninguna credencial que funcione igual en el portátil (con la sesión de la CLI), en una VM de la nube (con la identidad de la propia máquina) y en un pipeline de Jenkins (con variables de entorno que inyecta el propio Jenkins).
Cómo funciona. Los tres SDK buscan credenciales en un orden fijo y se quedan con la primera que encuentran. Conocer ese orden es lo que permite escribir ese script, y explica también los errores raros:
flowchart TD
A["<b>Script con el SDK</b>"]:::act
B{"<b>¿Variables de entorno?</b><br><small>AWS_ACCESS_KEY_ID · AZURE_CLIENT_ID<br>GOOGLE_APPLICATION_CREDENTIALS</small>"}:::dato
C{"<b>¿Perfil o sesión de la CLI?</b><br><small>~/.aws · az login · ADC de gcloud</small>"}:::dato
D{"<b>¿Identidad de la máquina?</b><br><small>rol de instancia · managed identity<br>service account del metadata server</small>"}:::dato
Z(["<b>Usa esas credenciales</b>"]):::ok
E(["<b>no credentials found</b>"]):::riesgo
A --> B
B -- sí --> Z
B -- no --> C
C -- sí --> Z
C -- no --> D
D -- sí --> Z
D -- no --> E
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxEl SDK prueba en este orden y se queda con lo primero que encuentra (Azure mira la identidad de la máquina antes que la sesión de az login). Por eso una variable de entorno olvidada manda sobre el perfil que se creía en uso.
Dónde se resuelve en el portátil. Donde se ejecuta el script de la A4.5, la cadena se resuelve casi siempre en el escalón del medio: boto3 usa el perfil de ~/.aws/config que indique AWS_PROFILE (incluido el de SSO), DefaultAzureCredential usa la sesión que dejó az login (antes prueba la identidad de la máquina, que en un portátil no existe, y sigue), y las Application Default Credentials de Google usan el fichero que escribe gcloud auth application-default login. Ese fichero es uno solo para todas las configuraciones de gcloud: el script cambia de proyecto con la variable de entorno, pero la identidad con que llama es siempre la del último application-default login. Los otros dos escalones entran cuando el mismo script corre en otro sitio: variables de entorno inyectadas por un pipeline, o la identidad de la propia máquina cuando se ejecuta dentro de la nube. El orden completo de los tres proveedores, escalón a escalón, está en Para ampliar.
La consecuencia práctica. El script que se escribe en la empresa no debe tener ni aws_access_key_id= ni credential=ClientSecretCredential(...) ni from_service_account_file(...). Cualquiera de las tres ata el script a una credencial concreta, escrita en el código o guardada en un fichero de clave, y además se salta la cadena, así que el script deja de obedecer a la variable de entorno con la que se elige el perfil. Tiene que apoyarse en la cadena.
Python
Instalar con el gestor de dependencias. Un entorno virtual por proyecto y las dependencias apuntadas en un fichero, para que cualquiera reproduzca el mismo entorno con una orden. De las tres líneas pip install, se usa solo la del proveedor del proyecto:
python3 -m venv .venv
source .venv/bin/activate
pip install boto3 # AWS
pip install azure-identity azure-mgmt-network azure-mgmt-compute # Azure
pip install google-cloud-compute # GCP
pip freeze > requirements.txt
Lo que se entrega es requirements.txt (o pyproject.toml si el proyecto usa uv o Poetry, otros gestores de dependencias de Python), y .venv/ va en .gitignore, porque se reconstruye entero a partir de ese fichero. Los tres ejemplos siguientes hacen lo mismo con la librería de cada proveedor: listar las redes y las máquinas apoyándose en la cadena.
# listar_aws.py: VPC e instancias con boto3 usando el perfil de la CLI
import boto3
ses = boto3.Session() # perfil y región salen de AWS_PROFILE
ec2 = ses.client("ec2")
print("VPC:")
for vpc in ec2.describe_vpcs()["Vpcs"]:
print(f" {vpc['VpcId']} {vpc['CidrBlock']} default={vpc['IsDefault']}")
print("Instancias:")
paginador = ec2.get_paginator("describe_instances")
for pagina in paginador.paginate():
for r in pagina["Reservations"]:
for i in r["Instances"]:
nombre = next((t["Value"] for t in i.get("Tags", []) if t["Key"] == "Name"), "-")
print(f" {i['InstanceId']} {i['InstanceType']} {i['State']['Name']} "
f"{i.get('PrivateIpAddress', '-')} {nombre}")
boto3.Session() sin argumentos recorre la cadena por defecto: con AWS_PROFILE exportado usa ese perfil y su región, y el mismo script vale en una EC2 con rol. Un profile_name o un region_name escritos en el código ganan a la variable, y con el segundo perfil el script seguiría consultando la región del primero. El paginador importa: muchos listados de la API se devuelven por páginas, y un bucle que solo lee la primera se deja elementos fuera sin dar ningún error. Con el paginador se recorren todas, sean una o cien.
# listar_azure.py: VNets y VMs con DefaultAzureCredential
import os
from azure.identity import DefaultAzureCredential
from azure.mgmt.network import NetworkManagementClient
from azure.mgmt.compute import ComputeManagementClient
sub = os.environ["AZURE_SUBSCRIPTION_ID"] # el GUID que devuelve az account show
cred = DefaultAzureCredential()
red = NetworkManagementClient(cred, sub)
print("VNets:")
for vnet in red.virtual_networks.list_all():
rg = vnet.id.split("/")[4]
print(f" {vnet.name} rg={rg} {vnet.location} {vnet.address_space.address_prefixes}")
comp = ComputeManagementClient(cred, sub)
print("VMs:")
for vm in comp.virtual_machines.list_all():
rg = vm.id.split("/")[4]
print(f" {vm.name} rg={rg} {vm.location} {vm.hardware_profile.vm_size}")
DefaultAzureCredential encontrará la sesión de az login. El ID de suscripción se pasa por variable de entorno para no fijarlo en el código: export AZURE_SUBSCRIPTION_ID=$(az account show --query id -o tsv).
# listar_gcp.py: redes VPC e instancias con google-cloud-compute (ADC)
import os
from google.cloud import compute_v1
proyecto = os.environ.get("CLOUDSDK_CORE_PROJECT") or os.environ["GOOGLE_CLOUD_PROJECT"]
print("Redes:")
for red in compute_v1.NetworksClient().list(project=proyecto):
modo = "auto" if red.auto_create_subnetworks else "custom"
print(f" {red.name} modo={modo}")
print("Instancias:")
agregado = compute_v1.InstancesClient().aggregated_list(project=proyecto)
for zona, resp in agregado:
for vm in resp.instances:
ip = vm.network_interfaces[0].network_i_p if vm.network_interfaces else "-"
print(f" {vm.name} {zona.split('/')[-1]} {vm.machine_type.split('/')[-1]} {vm.status} {ip}")
aggregated_list recorre todas las zonas de una vez; list necesita la zona. Las credenciales salen de gcloud auth application-default login.
Node.js
Lo mismo en Node. El patrón es idéntico: npm hace de gestor de dependencias y package-lock.json fija las versiones exactas, como requirements.txt en Python. Se instala solo la librería del proveedor del proyecto:
npm init -y
npm install @aws-sdk/client-ec2 # AWS (SDK v3, un paquete por servicio)
npm install @azure/identity @azure/arm-network @azure/arm-compute
npm install @google-cloud/compute
package.json y package-lock.json son los entregables; node_modules/ va al .gitignore. Un ejemplo con AWS, que es el que más se ve en las empresas:
// listar-aws.mjs
import { EC2Client, DescribeVpcsCommand, paginateDescribeInstances } from "@aws-sdk/client-ec2";
const ec2 = new EC2Client({}); // credenciales y región: cadena por defecto (AWS_PROFILE, SSO, rol...)
const { Vpcs } = await ec2.send(new DescribeVpcsCommand({}));
console.log("VPC:");
for (const v of Vpcs) console.log(` ${v.VpcId} ${v.CidrBlock}`);
console.log("Instancias:");
for await (const page of paginateDescribeInstances({ client: ec2 }, {})) {
for (const r of page.Reservations ?? []) {
for (const i of r.Instances ?? []) {
const nombre = i.Tags?.find(t => t.Key === "Name")?.Value ?? "-";
console.log(` ${i.InstanceId} ${i.InstanceType} ${i.State.Name} ${i.PrivateIpAddress ?? "-"} ${nombre}`);
}
}
}
Se ejecuta con AWS_PROFILE=empresa-dev node listar-aws.mjs. Para Azure el patrón es new NetworkManagementClient(new DefaultAzureCredential(), subscriptionId) y luego for await (const v of client.virtualNetworks.listAll()); para GCP, new NetworksClient().list({ project }).
Por qué el SDK y no solo la CLI
Con la CLI y jq se llega lejos, y para tareas puntuales es lo correcto. El SDK entra cuando la lógica crece (cruzar instancias con snapshots huérfanos, calcular costes por etiqueta, generar un informe), cuando hay que manejar errores y reintentos con criterio, o cuando el código forma parte de una aplicación. Los providers de OpenTofu, como bpg/proxmox, son eso mismo: programas que llaman a la API del proveedor, como un script con el SDK, con la lógica de qué crear, cambiar o destruir por encima.
Buenas prácticas mínimas
Por qué una lista. Lo que sigue es la lista corta de lo que el tutor va a dar por supuesto y de lo que más se penaliza en la evaluación, donde una evidencia con credenciales visibles invalida su actividad. Casi todo ha salido ya en la unidad; aquí está junto, cada punto con su porqué, para repasarlo antes de cada sesión en la empresa.
- MFA en todo usuario, sin excepciones: con el segundo factor, una contraseña robada no basta para entrar. Permisos por rol y por grupo, nunca asignados a personas concretas: cuando alguien cambia de equipo se le cambia de grupo y ya está, sin buscar sus permisos uno a uno.
- Nada expuesto desde
0.0.0.0/0salvo el balanceador o el proxy inverso, y en ese caso solo los puertos 80 y 443, el mismo criterio que en el OPNsense del laboratorio, donde desde fuera solo se publicaba el proxy. El SSH (22) y el escritorio remoto de Windows (3389) se abren a la IP de la oficina, a una VPN o se sustituyen por Session Manager en AWS, Azure Bastion o el reenvío de puertos de Identity-Aware Proxy en Google Cloud, tres servicios que abren una sesión en la VM a través del proveedor sin exponer el puerto. Las consolas suelen avisar cuando se crea una regla abierta al mundo; conviene hacerles caso. - Etiquetar todo y destruir lo que se crea para practicar el mismo día: lo que no tiene dueño no lo borra nadie. Comprobar la factura al día siguiente, porque el gasto llega con horas de retraso.
- Nunca subir credenciales a Git: el repositorio se escanea con
gitleaksy lleva el hook de pre-commit, como eniac-lab(repaso a continuación). - Ficheros que nunca van al repositorio:
.env,*.pem, los JSON de service account,~/.aws/credentialsyterraform.tfstate, que guarda en claro todo lo que el provider leyó, contraseñas incluidas. Van al.gitignoreantes del primer commit, porque lo que entra en un commit ya no se borra borrando el fichero.
Repaso
gitleaks y el framework pre-commit se explican en .gitignore y pre-commit y se montan en la A5.8. En el repositorio nuevo de la empresa basta con copiar de allí .pre-commit-config.yaml dejando solo el bloque de gitleaks y ejecutar pre-commit install; gitleaks git -v (gitleaks detect -v en versiones antiguas) escanea el historial entero. Si en la máquina de la empresa no se puede instalar pre-commit, el hook se escribe a mano: un .git/hooks/pre-commit ejecutable con la línea gitleaks git --pre-commit --staged --redact.
Lo que cambia en la empresa es la consecuencia de un hallazgo. Si gitleaks encuentra algo que ya se subió, no basta con borrarlo en el siguiente commit: sigue en el historial. La clave hay que revocarla en el proveedor en ese momento y avisar al tutor, en el mismo orden que con el token de Proxmox (Cuando gitleaks encuentra algo): primero se revoca y después se limpia, porque limpiar sin revocar deja la clave válida en cualquier copia del repositorio que ya exista.
A4.5 SDK (CE 2e)
Objetivo Un script en el lenguaje del proyecto de la empresa que liste las VPC/VNets y las máquinas sin una sola credencial dentro, y que funcione con dos perfiles cambiando solo la variable de entorno. Es la prueba de que has entendido la cadena de credenciales: el mismo fichero, sin tocar una línea, valdría en tu equipo, en un pipeline o en una máquina de la nube.
Antes de empezar
- A4.4 hecha:
empresa-devyempresa-prefuncionando. - Autorización del tutor sobre el lenguaje (Python o Node; si el proyecto usa otro, decide el tutor) y sobre el repositorio privado donde vas a guardar el código.
- Python 3 o Node en la misma máquina donde tienes la CLI, porque el SDK reutiliza sus credenciales, y
gitleaksinstalado en ella o autorización del tutor para instalarlo. - Leídos La cadena de credenciales por defecto, Python o Node.js, y Buenas prácticas mínimas con su repaso de
gitleaks.
Pasos
Preparas el repositorio antes de escribir una línea, escribes el script apoyado en la cadena, lo pruebas con los dos perfiles y lo escaneas antes de subirlo. El .gitignore va primero porque lo que entra en un commit ya no se borra borrando el fichero, y el escaneo va al final porque gitleaks git solo ve lo que ya está en el historial.
-
Prepara el repositorio. Crea el repositorio
listar-nubee instala en él solo la librería de tu proveedor con el gestor de dependencias, de modo que quede enrequirements.txtopackage.json. Antes del primer commit, su.gitignoredeja fuera.venv/onode_modules/y lo que según Buenas prácticas mínimas nunca va al repositorio. Las dos cosas son lo primero que mira el CE 2e: que otra persona pueda reproducir tu entorno y que no se cuele nada que no debe.Pista: los JSON de service account se bloquean por nombre y no con
*.json, que dejaría fuerapackage.jsonypackage-lock.json. -
Escribe el script sin credenciales. Parte del ejemplo de tu proveedor en Python o Node.js, sin perfil, región ni credencial en el código. No es solo por seguridad: lo que escribas en el código pasa por delante de la cadena de credenciales, y el script dejaría de obedecer a la variable con la que cambias de perfil.
-
Pruébalo con los dos perfiles. Ejecútalo con cada perfil cambiando solo variables de entorno y guarda las dos salidas. Compáralas con lo que da la CLI con el mismo perfil: si coinciden, el script ve lo mismo que la CLI, que es justo lo que promete la cadena.
Pista: basta
AWS_PROFILEdelante de la orden, como en la A4.4.Pista:
DefaultAzureCredentialllama aaz, así que respetaAZURE_CONFIG_DIR.AZURE_SUBSCRIPTION_IDcambia con el perfil: sácalo deaz account showen cada uno.Pista: el SDK no usa el login de
gcloud: antes hace faltagcloud auth application-default login. El proyecto va enCLOUDSDK_CORE_PROJECT. -
Escanéalo antes de subirlo. Haz commit y escanea el repositorio con
gitleaksantes de subirlo, guardando la salida. Es la última barrera antes de que el código salga de tu máquina, y la salida limpia es la evidencia de que el script cumple lo que promete: ni una credencial dentro, tampoco en el historial.Pista:
gitleaks gitrevisa el historial, no la carpeta: lo que no está en un commit no lo ve. Si encuentra una clave, borrarla no basta: revócala en el proveedor y avisa al tutor.
Comprobación Las dos salidas del script coinciden con las de la CLI para cada perfil, grep -rIiE "AKIA|secret|password" . --include='*.py' --include='*.mjs' --include='*.js' --exclude-dir=.venv --exclude-dir=node_modules no devuelve nada y gitleaks termina sin fugas (no leaks found).
Entrega requirements.txt o package.json (con package-lock.json), el script, su salida con cada perfil y la salida de gitleaks git sobre el repositorio donde lo has guardado. Fila A4.5 de la ficha.
Si te sobra tiempo Monta el hook de pre-commit como en la A5.8 (repaso en Buenas prácticas mínimas), intenta hacer commit de un fichero con una clave falsa (AKIA y 16 caracteres) y guarda el rechazo.
Actividad de cierre
Objetivo Un documento de dos páginas que explique cómo está organizada la nube de la empresa y en qué se diferencia de la VPC de Proxmox del centro. Es lo que demuestra que no solo has seguido pasos, sino que entiendes el sistema: cada apartado sale de algo que anotaste en las hojas y lo compara con algo que montaste tú en el centro.
Antes de empezar
- Las cinco actividades hechas, porque el documento se apoya en lo que anotaste en ellas.
- Autorización del tutor sobre qué se puede contar por escrito: nombres de cuentas, rangos de red y nombres de máquinas pueden ser información interna.
- Releída la tabla de Correspondencia con lo que ya sabes y tus apuntes de la VPC del centro.
Pasos
Recorres la nube de la empresa en el mismo orden que la unidad: primero dónde está todo, luego la red, luego quién puede hacer qué, luego cuánto cuesta y, al final, la comparación. Los cuatro primeros pasos no se escriben de memoria, sino a partir de tus evidencias (la cuenta, la región y las etiquetas de la A4.1, el coste de la A4.2, la identidad de la A4.3 y los listados de la A4.4), y por eso el último es el único que es tuyo del todo: lo que has entendido al comparar.
- La estructura. Describe las cuentas, suscripciones o proyectos y cómo se agrupan (OUs, management groups, carpetas), qué regiones usa la empresa y por qué. Es el marco de todo lo demás: cada red, cada permiso y cada coste viven en una cuenta y en una región.
- La red. Describe las redes y subredes, qué es público y qué privado, cómo se sale a Internet y qué hace de cortafuegos, y compáralo pieza a pieza con la VPC del centro (bridge, DMZ, OPNsense, NAT), con la tabla de Correspondencia con lo que ya sabes. Es donde más se nota lo que montaste en el centro: las piezas son las mismas, con otro nombre y con precio.
- Identidad y permisos. Describe con qué mecanismo se entra (SSO, MFA), cómo se reparten los permisos (roles, grupos, políticas) y qué tienes tú. Es lo que más cambia de una empresa a otra, y lo que explica cada
AccessDeniedque te hayas encontrado. - Etiquetas y costes. Describe la política de etiquetas y de costes: etiquetas obligatorias, presupuestos, quién revisa la factura y qué te ha costado a ti la unidad (la vista de costes de la A4.2 antes y después). Un número concreto aquí vale más que cualquier descripción general.
- Las diferencias. Cierra con las diferencias: interesa especialmente lo que no esperabas, qué hace la empresa que en el centro no se hizo y qué se hizo en el centro que en la nube ya viene dado. Es la parte que muestra si sabes por qué existe cada pieza, y no solo cómo se llama.
Comprobación Cabe en dos páginas, cada apartado de los cuatro primeros pasos tiene al menos un dato concreto sacado de tus evidencias, y no contiene identificadores completos, claves ni IP públicas de producción.
Entrega El documento (PDF) en la carpeta de evidencias, junto con la ficha firmada. Fila "Cierre" de la ficha.
Si te sobra tiempo Añade un diagrama de la red de la empresa con la misma notación que el de regiones y zonas de esta unidad.
Práctica evaluable
La práctica evaluable de esta unidad es el conjunto de las cinco actividades más el documento de cierre, entregados a través de la ficha de evidencias firmada por el tutor de empresa. No pide nada que no salga ya de un paso de las hojas. No hay defensa en el centro: el profesor evalúa con la ficha, las evidencias adjuntas y el documento.
Entregables (en un repositorio privado o en la carpeta que indique el profesor):
- Ficha de evidencias firmada (PDF o foto legible), con la fila de cada actividad, que se rellena en su Entrega.
- Captura y párrafo de cuenta, región y etiquetas (de la A4.1, pasos 2 a 4), sin datos sensibles.
- Capturas de las preferencias y del presupuesto o la consulta de costes (de la A4.2, pasos 1 y 2), sin datos sensibles.
- Salidas de versión e identidad con el comentario sobre el tipo de credencial (de la A4.3, pasos 1 a 3), en texto.
- Listados de cada perfil, ficheros de configuración y borrado del perfil de prueba (de la A4.4, pasos 2 a 5), en texto.
- Script, fichero de dependencias, salida con cada perfil y salida de gitleaks (de la A4.5, pasos 1 a 4).
- Documento de cierre de dos páginas (de la actividad de cierre, pasos 1 a 5).
Ficha de evidencias
| Actividad | CE | Fecha | Evidencia adjunta | Observaciones del tutor | Firma |
|---|---|---|---|---|---|
| A4.1 Acceso | 2a | ||||
| A4.2 Interfaz | 2b | ||||
| A4.3 CLI | 2c | ||||
| A4.4 Perfiles | 2d | ||||
| A4.5 SDK | 2e | ||||
| Cierre | (todos) |
Criterios de evaluación y pesos
| Criterio | Peso |
|---|---|
| A4.1 Acceso a la consola: MFA activo, identificación correcta de cuenta, región y política de etiquetas (CE 2a) | 15 % |
| A4.2 Configuración de la interfaz y alerta de presupuesto (CE 2b) | 10 % |
| A4.3 CLI instalada y autenticada sin credenciales de larga duración, identidad verificada (CE 2c) | 20 % |
| A4.4 Dos perfiles funcionando, cambio por mecanismo nativo y por variable de entorno, ficheros de configuración mostrados y un perfil de prueba creado y borrado (CE 2d) | 20 % |
| A4.5 SDK instalado con el gestor de dependencias, script sin credenciales, funciona con dos perfiles, gitleaks limpio (CE 2e) | 20 % |
| Documento de cierre: organización de la nube de la empresa y comparación razonada con la VPC del centro | 15 % |
Una evidencia con credenciales visibles (aunque estén revocadas) invalida la actividad correspondiente.
Errores frecuentes en el laboratorio
"No veo nada de lo que creé". La sesión está abierta en otra región. Lo dicen el selector de región de la consola o aws configure get region, az config get defaults.location y gcloud config get compute/region. En AWS, aws ec2 describe-instances --region eu-south-2 comprueba una región concreta.
Unable to locate credentials / Please run 'az login' / DefaultCredentialsError. La cadena no ha encontrado nada. Conviene comprobar aws sts get-caller-identity, az account show o gcloud auth list; si la CLI funciona pero el SDK no, en GCP falta gcloud auth application-default login (el error dice "Your default credentials were not found" o, en versiones antiguas, "Could not automatically determine credentials"), y en AWS hay que revisar que el script use el mismo perfil que la CLI (AWS_PROFILE).
El token SSO ha caducado (The SSO session associated with this profile has expired). La sesión del portal de IAM Identity Center dura lo que haya configurado la empresa, ocho horas si no ha cambiado el valor por defecto. aws sso login --profile empresa-dev y a seguir. Lo mismo con az login cuando el token de Entra ID expira (suele avisar con AADSTS700082).
AccessDenied / AuthorizationFailed / 403 Forbidden en una operación concreta. El rol no tiene ese permiso; el mensaje suele decir qué acción (ec2:RunInstances) y sobre qué recurso. La solución no es pedir AdministratorAccess: se anota la acción exacta y se pide al tutor el permiso mínimo. En AWS, si la política tiene condición de región y la sesión está en otra, el error es el mismo.
aws dice que soy otra persona. Hay una AWS_ACCESS_KEY_ID o un AWS_PROFILE exportados en el shell (env | grep AWS) o un [default] olvidado en ~/.aws/credentials. aws configure list dice de dónde sale cada valor.
az va contra la suscripción equivocada. Está activa otra suscripción: la que se eligió en el selector de az login o, en versiones anteriores a la 2.61, la primera de la lista (az account list -o table y az account set --subscription <id>). O hay un AZURE_CONFIG_DIR exportado y olvidado (env | grep AZURE).
El script de Python lista menos máquinas que la consola. Casi siempre se está mirando otra región o una sola zona: el script de AWS usa la región del perfil, y en GCP list necesita una zona, mientras que aggregated_list las recorre todas. Si no es eso, el bucle no recorre todas las páginas del listado: en AWS se usa el paginador, y en Azure list_all ya pagina.
La factura sube aunque "no hay nada". Conviene listar NAT gateways, IP públicas reservadas, discos sin asociar y snapshots; casi siempre es uno de esos. En AWS, Cost Explorer filtrado por servicio lo dice en un minuto.
La CLI instalada por pip o apt es antigua. apt install awscli instala la v1 en Debian 11 y Ubuntu 22.04, que no tiene configure sso, y una v2 con meses o años de retraso en Debian 12 y 13. Hay que usar el instalador oficial de la v2. pip install azure-cli funciona pero es lento de actualizar; el repositorio de Microsoft es lo recomendado.
Cloud Shell "pierde" los ficheros. En AWS CloudShell solo persiste el directorio personal y por región; en Azure con sesión efímera no persiste nada. Conviene subir el trabajo a un repositorio antes de cerrar.
Los enlaces para ampliar y los apartados que van más allá de lo que se hace en la empresa están en Para ampliar.
UT5 · Infraestructura como código
En la UT2 la VPC se montó dos veces: primero a mano en la consola de Proxmox, y después con un script bash, el de la A2.6, que repetía los mismos pasos. El script fue un avance, pero tiene un defecto de fondo: describe cómo llegar, no dónde hay que estar. Para no crear las cosas dos veces tiene que preguntar antes de cada orden si ya existen, no sabe cambiar una VM que ya está creada, y si alguien toca una a mano, no se entera.
En esta unidad cambia el enfoque: se escribe en ficheros de texto el estado deseado (tres VM con estas CPU, estas IP, en estos puentes) y una herramienta calcula y aplica la diferencia. El objetivo es que cualquiera del grupo, con un git clone y unas pocas órdenes, levante el entorno pre completo con el servicio funcionando, y que un script diga si está bien. Para eso se encadenan cuatro piezas, y la unidad las construye en ese orden: OpenTofu crea las máquinas en Proxmox, Ansible las configura, un script de pruebas comprueba que el servicio responde y tres escáneres revisan que el código no deje nada expuesto. Es la primera de las tres unidades que entran en el examen de la segunda evaluación, el 24 de marzo de 2027. El entorno pre que nace aquí no es de un día: Mantenimiento lo actualiza en febrero y lo da de baja en marzo con el mismo repositorio, el mismo estado remoto y el mismo token, así que al terminar la práctica evaluable no se destruye ni se borra su estado.
Sesión 21 · IaC: conceptos y primer despliegue
El script de la A2.6 crea un entorno y lo destruye sin fallar aunque se ejecute dos veces, pero lo consigue a fuerza de comprobar a mano, orden por orden, si cada cosa existe ya, y eso no se arregla añadiéndole más comprobaciones: hace falta otra forma de describir la infraestructura. Esta sesión la presenta y la pone a funcionar sobre una VM de usar y tirar. La teoría empieza por el cambio de enfoque, que es lo que justifica todo lo demás: qué es describir la infraestructura en ficheros, en qué se diferencia una herramienta declarativa de un script y por qué la idempotencia es la propiedad que se exige a todo el código de la unidad. Sigue con OpenTofu: dónde se instala, cómo se organiza un proyecto, qué hace cada paso del ciclo init, plan, apply, cómo se lee un plan antes de decir que sí y cuál es el proyecto más pequeño que crea una VM. La hoja A5.1 crea en Proxmox el usuario con el que OpenTofu trabajará hasta marzo, recorre el ciclo entero sobre una VM de prueba y deja publicado el repositorio iac-lab, donde vivirá todo el código de la unidad.
Infraestructura como código
El problema. Lo que se monta a mano no sale igual dos veces, y un script repite pasos sin saber qué hay al otro lado. Cuantas más máquinas y más entornos, más casos hay que prever en el script, y más fácil es que lo que existe y lo que el script cree que existe dejen de coincidir.
Qué es y de dónde sale. La infraestructura como código (IaC) es describir la infraestructura (máquinas, redes, discos, reglas de cortafuegos, registros DNS) en ficheros de texto que una herramienta aplica automáticamente. La idea creció con la nube: cuando crear un servidor pasó a ser una llamada a una API, y no una compra y una instalación, escribir esas llamadas en ficheros fue el paso natural. Los ficheros van a un repositorio Git como cualquier otro código: se revisan en un pull request (la petición de revisión de cambios de GitLab o GitHub), se versionan, se prueban y se pueden volver a aplicar en otro sitio.
Qué aporta frente a la consola. Cuatro cosas concretas:
- Reproducible: dev, pre y pro, los tres entornos del laboratorio, salen iguales porque nacen del mismo código con distintos valores.
- Rápido: un entorno completo (tres VM, red, configuración del servicio) tarda minutos, y el tiempo lo pone la máquina, no una persona.
- Auditable: el historial de Git dice quién cambió qué y cuándo, y el plan dice qué va a pasar antes de que pase.
- Recuperable: si se pierde el entorno (un nodo Proxmox que muere, alguien que borra la VM equivocada), se vuelve a aplicar el código.
Declarativo frente a imperativo
Dos formas de escribirlo. Un script dice qué hacer; un fichero declarativo dice cómo tiene que quedar. La diferencia se ve sobre todo en lo que pasa la segunda vez:
| Declarativo | Imperativo | |
|---|---|---|
| Qué se escribe | El estado final deseado ("quiero 3 VM así") | Los pasos ("crea VM, luego disco, luego red") |
| Quién calcula los cambios | La herramienta, comparando lo deseado con lo que existe | Quien escribe el script, que tiene que prever todos los casos |
| Segunda ejecución | No hace nada si ya está como se pidió | Repite los pasos, con lo que eso implique |
| Ejemplos | Terraform/OpenTofu, CloudFormation, Bicep, manifiestos de Kubernetes | Scripts bash, Ansible (parcialmente) |
Dónde cae Ansible. Ansible está en la columna imperativa "parcialmente" porque un playbook es una lista ordenada de tareas (imperativo), pero cada tarea es declarativa: state: present no dice "instala", dice "que esté instalado", y el módulo comprueba antes de actuar. El resultado es que un playbook bien escrito se comporta como declarativo aunque se lea como una receta.
La propiedad que se exige: idempotencia. Lo que se busca en las dos columnas es la idempotencia: aplicar el código dos veces deja el mismo resultado que una. La A2.6 ya la exigía a sus scripts, y la conseguía a mano, con una comprobación delante de cada orden; una herramienta declarativa la trae de serie, porque antes de actuar compara lo pedido con lo que hay. Es lo que permite ejecutar el código sin miedo, meterlo en un pipeline que corre en cada commit y usarlo para reparar un entorno que alguien ha tocado a mano. Cuando una hoja de esta unidad pide "ejecútalo dos veces y captura la segunda", es esto lo que se comprueba.
Herramientas
Dos herramientas, dos trabajos. Crear una máquina y dejarla útil son trabajos distintos, y en el curso los hacen dos herramientas. Terraform  , de HashiCorp, y su bifurcación libre OpenTofu aprovisionan: crean, cambian y destruyen infraestructura (VM, redes, DNS, recursos de nube) llamando a la API de cada plataforma a través de providers (el complemento que sabe hablar con cada una: Proxmox, AWS, Cloudflare), y se escriben en HCL, su propio lenguaje de configuración. Ansible
 , de Red Hat, configura lo que hay dentro de las máquinas (paquetes, ficheros, servicios) por SSH, sin agente, en YAML. Una crea la máquina y la otra la deja útil.
El patrón del curso, que es también el más habitual en empresas medianas: OpenTofu crea las VM en Proxmox con cloud-init (la configuración del primer arranque, la misma que ya usa la plantilla 9000); Ansible instala PostgreSQL y Docker y despliega el servicio; un script de pruebas comprueba que todo responde.
Lo que se encuentra en otras empresas. Las alternativas hacen el trabajo de OpenTofu con otro lenguaje o para un solo proveedor:
| Herramienta | En qué se diferencia de OpenTofu | Dónde se encuentra |
|---|---|---|
| Pulumi | Mismo modelo, pero el código se escribe en Python, TypeScript o Go | Equipos de desarrollo que no quieren aprender otro lenguaje; en operaciones se ve menos |
| CloudFormation (AWS) y Bicep (Azure) | Lenguajes propios de cada nube, que solo sirven en ella | Empresas que trabajan con un solo proveedor de nube |
Terraform y OpenTofu sirven en todas las nubes y también en Proxmox, que es lo que hay en el laboratorio: son la herramienta de referencia del sector y la del curso.
Por qué existen Terraform y OpenTofu
Dos nombres para la misma herramienta. Terraform nació en 2014 con licencia libre. En 2023 HashiCorp la cambió por otra que prohíbe usar el código para ofrecer un producto que compita con ella, y OpenTofu es la bifurcación que continuó desde la última versión libre, hoy alojada en la Linux Foundation. En el laboratorio del curso se usa OpenTofu por eso, y en una empresa aparecen las dos.
Qué cambia en la práctica. Casi nada: el lenguaje, los providers y los ficheros son los mismos. Donde un tutorial diga terraform plan aquí se escribe tofu plan, y los providers se descargan de registry.opentofu.org en lugar de registry.terraform.io. Los ficheros conservan los nombres de Terraform (terraform.tfvars, terraform.tfstate, el bloque terraform {}), y por eso aparecen así en todo el curso.
Cómo se llegó a la bifurcación y en qué se han separado las dos herramientas desde entonces está en Para ampliar.
OpenTofu: instalación y primer proyecto
Dónde se instala. OpenTofu se instala en el puesto de administración (10.10.0.50), y toda la unidad se trabaja desde ahí: es la máquina que llega a la vez a la API de Proxmox por la red del aula y a las zonas del laboratorio. Es también donde están la clave SSH que OpenTofu meterá en cada VM y la copia de trabajo del repositorio.
Cómo. El script oficial añade el repositorio APT de OpenTofu e instala el paquete, así que después se actualiza con apt como cualquier otro:
# OpenTofu en Debian/Ubuntu (instala el repositorio APT oficial)
curl -fsSL https://get.opentofu.org/install-opentofu.sh | sh -s -- --install-method deb
tofu version
En macOS brew install opentofu; en Windows, winget install OpenTofu.Tofu. Si en la empresa se usa Terraform, terraform version y el resto de esta unidad se lee igual.
Estructura de un proyecto
Un directorio con ficheros .tf. Un proyecto (en la jerga, un módulo raíz) es un directorio con ficheros .tf. OpenTofu los lee todos y los junta, así que el reparto en ficheros es para las personas; los nombres son una convención, pero es la convención que todo el mundo espera:
| Fichero | Contenido | En el curso |
|---|---|---|
providers.tf |
Qué providers se usan, de dónde se descargan, con qué versión y cómo se conectan | El provider bpg/proxmox y el token de terraform@pve, desde la A5.1 |
variables.tf |
Variables de entrada con tipo, descripción, valor por defecto y validaciones | La traducción de la tabla de requisitos del servicio, en la A5.2 |
main.tf |
Recursos y llamadas a módulos | Una VM de prueba en la A5.1; las tres de pre desde la A5.3 |
outputs.tf |
Valores que se exportan (IP, ID) para otros módulos, para Ansible o para leerlos por pantalla | Las IP de las que sale el inventario de Ansible en la A5.5 |
terraform.tfvars |
Valores de las variables para este entorno. No se sube si contiene secretos (y mejor que no los contenga) | Los valores de pre, sin secretos: se sube |
.terraform.lock.hcl |
Versiones exactas y huellas de los providers descargados. Este sí se sube | Garantiza que todo el que use el repositorio trabaja con el mismo provider |
Lo que no se sube. tofu init crea además un directorio .terraform/ con los providers descargados, binarios de decenas de megas que se regeneran con otro init, y apply escribe el estado en terraform.tfstate. Ninguno de los dos va al repositorio, y tampoco un plan guardado (plan.bin): el estado y el plan llevan dentro valores sensibles, como explica validation y sensitive. Por eso el .gitignore de la A5.1 se escribe antes del primer commit.
El ciclo init, plan, apply
Tres versiones de la misma infraestructura. OpenTofu trabaja comparando tres cosas: lo que dice el código, que es lo que se quiere; lo que apuntó en el estado la última vez que aplicó, es decir, qué creó y con qué identificador real; y lo que existe ahora en la plataforma, que pregunta a su API. De esa comparación sale el plan, la lista de operaciones que dejarían la realidad como dice el código. Si alguien ha tocado una VM a mano, la diferencia aparece en el plan (a eso se le llama deriva), y aplicarlo la corrige. El estado se ve a fondo en la sesión 24, el 13 de enero, cuando se lleva a un almacén compartido.
El bucle de trabajo. Cada cambio pasa por las mismas órdenes, en este orden:
flowchart TB
A["<b>tofu init</b><br><small>descarga el provider</small>"]:::act
B["<b>tofu fmt · validate</b>"]:::act
C["<b>tofu plan -out=plan.bin</b>"]:::act
D{"<b>Leer el plan</b>"}:::dato
E["<b>tofu apply plan.bin</b>"]:::act
F["<b>terraform.tfstate</b><br><small>actualizado</small>"]:::dato
G["<b>tofu destroy</b>"]:::riesgo
A --> B --> C --> D
D -- correcto --> E
D -- sorpresa --> B
E --> F --> C
E -.-> G
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxEl bucle es el trabajo diario. La flecha de «sorpresa» es la importante: si el plan no dice lo esperado, se vuelve al código, no se aplica.
tofu init: descarga los providers al directorio.terraform/, escribe el fichero de bloqueo y configura el backend, el sitio donde se guarda el estado (un fichero local si no se dice otra cosa). Hay que repetirlo al cambiar de backend o al añadir un provider o un módulo.tofu fmtytofu validate: formato canónico y comprobación sintáctica y de tipos, sin hablar con Proxmox. Son los dos primeros pasos de cualquier pipeline de IaC.tofu plan: lee el estado, consulta a la API qué existe de verdad (a eso se le llama refresh), compara con el código y muestra qué crearía, cambiaría o destruiría. Siempre se lee antes de aplicar. Con-out=plan.binel plan se guarda yapplyejecuta exactamente eso, no un plan recalculado.tofu apply: aplica el plan, llamando a la API de la plataforma, y apunta en el estado lo que ha creado. Sin fichero de plan lo recalcula y pide confirmación; con-auto-approveno la pide (solo en scripts y en CI).tofu destroy: elimina todo lo que gestiona el estado. En las pruebas del laboratorio se usa a diario; en producción, y en elpredel curso, está protegido por permisos y porprevent_destroy.
Cómo leer un plan
Por qué leerlo siempre. El plan es el único momento en el que se puede parar una destrucción antes de que ocurra, y lo que hace el apply es exactamente lo que el plan anuncia. Resume cada recurso con un símbolo, y hay que saber leerlos antes de escribir yes:
| Símbolo | Significado | Qué hacer |
|---|---|---|
+ create |
Recurso nuevo | Normal en el primer apply |
~ update in-place |
Cambia atributos sin recrear (memoria, nombre) | Normal; leer qué atributo |
- destroy |
Se elimina | Solo si se ha pedido |
-/+ replace |
Se destruye y se crea de nuevo | Peligro: se pierde el disco y su contenido |
<= read |
Un data (bloque de solo lectura) que se consulta en apply |
Inofensivo |
La línea que más disgustos da. La línea # forces replacement junto a un atributo significa que el provider no sabe cambiar ese atributo en caliente (por ejemplo el nodo donde vive la VM o su vm_id) y va a resolverlo destruyendo la VM y creando otra. Para una VM web sin estado es molesto; para db01 es perder la base de datos.
El resumen final. Las últimas líneas cuentan lo que va a pasar: Plan: 1 to add, 0 to change, 1 to destroy cuando se esperaba 0 to destroy es motivo suficiente para parar y volver al código.
Dos protecciones. El bloque lifecycle { prevent_destroy = true } en los recursos con datos, que hace fallar el plan en lugar de destruir (lo llevan las VM de pre desde la A5.3), y tofu plan -detailed-exitcode en CI, que devuelve 2 cuando hay cambios y permite exigir revisión humana.
El proyecto mínimo
Lo más pequeño que crea algo. El proyecto más pequeño que crea algo en Proxmox tiene tres ficheros y un solo recurso con los valores escritos a mano. Es el que copia la A5.1:
# providers.tf
terraform {
required_providers {
proxmox = { source = "bpg/proxmox", version = "~> 0.60" }
}
}
provider "proxmox" {
endpoint = var.pve_endpoint
api_token = var.pve_token # llega por TF_VAR_pve_token, nunca en un fichero
insecure = true # certificado autofirmado del laboratorio
}
# variables.tf
variable "pve_endpoint" {
type = string
}
variable "pve_token" {
type = string
sensitive = true
}
# main.tf
resource "proxmox_virtual_environment_vm" "prueba" {
name = "prueba01"
node_name = "pve"
vm_id = 150 # primera de la franja de pruebas de dev (150 a 199)
clone { vm_id = 9000 } # la plantilla cloud-init
cpu { cores = 1 }
memory { dedicated = 1024 }
network_device { bridge = "devfront" }
agent { enabled = true } # qemu-guest-agent, para leer la IP
initialization {
ip_config {
ipv4 {
address = "10.10.1.200/24"
gateway = "10.10.1.1"
}
}
user_account {
username = "ops"
keys = [file("~/.ssh/id_ed25519.pub")]
}
}
}
Qué hace cada bloque.
terraform { required_providers }dice qué provider hace falta y de dónde se descarga:bpg/proxmox, del registro de OpenTofu.~> 0.60admite cualquier versión 0.x a partir de la 0.60; la que se descarga en el primerinitqueda escrita en.terraform.lock.hcl, y es la que se usa hasta que alguien pida otra contofu init -upgrade.provider "proxmox"dice cómo conectarse.endpointes la URL de la API del nodo, la misma que la de la consola web (https://<IP del nodo>:8006/), yinsecure = trueacepta su certificado, que firma una CA creada por el propio Proxmox al instalarse y que el puesto no conoce; en producción se instala esa CA en el puesto en lugar de desactivar la comprobación.- Los dos bloques
variableson las entradas del proyecto.pve_endpointtoma su valor deterraform.tfvars, ypve_token, de la variable de entornoTF_VAR_pve_token: OpenTofu toma como valor de una variablenombrecualquier variable de entornoTF_VAR_nombre, y así el token pasa de la terminal al provider sin escribirse en ningún fichero. resource "proxmox_virtual_environment_vm" "prueba"es la VM. El tipo de recurso lo define el provider y el nombre local lo pone quien escribe el código; juntos forman su dirección,proxmox_virtual_environment_vm.prueba, que es como la nombran el plan y el estado. Dentro,node_namees el nombre del nodo en la consola (el que se le dio al instalarlo,pveen estos apuntes),clonedice de qué plantilla sale,agenthace que el provider espere a que el agente QEMU de la VM le diga sus direcciones, einitializationson los datos de cloud-init que la VM aplicará en su primer arranque, los mismos que se ponían a mano con--ipconfig0y--sshkeysal clonar la plantilla.
Los valores escritos a mano. El vm_id no es opcional en la práctica: sin él Proxmox da el primer ID libre, que cae en la franja de gestión de dev, y el laboratorio reserva de la 150 a la 199 para las pruebas. La 10.10.1.200 es del rango libre de front. La clave que mete initialization es la del puesto de administración, que es desde donde se entra después.
A5.1 Primer despliegue (sesión 21)
Objetivo Desde el puesto de administración, una VM clonada de la plantilla 9000 aparece en Proxmox creada por OpenTofu, un segundo plan dice No changes y destroy la elimina. Ese segundo plan es lo que importa: demuestra que OpenTofu sabe lo que ha creado y no lo repite, que es lo que el script de la A2.6 tenía que comprobar a mano. De paso nacen dos cosas que se usan hasta marzo, en esta asignatura y en Mantenimiento: el usuario terraform@pve con su token y el repositorio iac-lab en Gitea.
Antes de empezar El puesto de administración (VM 105, 10.10.0.50, de la A2.4) encendido; entras en él desde tu puesto con ssh ops@<IP de aula de admin01>. La consola del nodo (Shell en la interfaz web, o SSH como root), Proxmox en https://192.168.1.50:8006/ (o la IP de tu nodo en la red del aula) y la plantilla cloud-init 9000. La Gitea de mon01 en http://gitea.lab:23001 con el usuario ops, la de la A2.6 de Mantenimiento. Se ha explicado qué es IaC y la idempotencia, el ciclo init, plan, apply y el proyecto mínimo.
Pasos
Vas en el orden en que cada pieza necesita a la anterior. Primero, la identidad con la que OpenTofu entrará en Proxmox, porque sin ella no puede hacer nada. Después, el proyecto, con el .gitignore puesto antes del primer commit para que ningún fichero con secretos llegue nunca al historial. Luego, el ciclo entero sobre una VM de usar y tirar, que es donde se ve la idempotencia. Y al final, la publicación del repositorio, que es el que usan las hojas siguientes.
-
Dale a OpenTofu su propia identidad en Proxmox. Crea en el nodo el usuario
terraform@pvecon un tokentofusin separación de privilegios y tres permisos:PVEVMAdminsobre/vms,PVEDatastoreUsersobre/storage/local-lvmyPVESDNUsersobre/sdn/zones/lab. Son los justos para clonar y configurar VM, reservar espacio para sus discos enlocal-lvmy conectarlas a las VNets de la zona, y nada más: es el criterio del usuario de prácticas de la A2.6, pero este se queda hasta marzo. En el puesto de administración, exporta el token enTF_VAR_pve_token, nunca en un fichero, y comprueba que la API de Proxmox responde con él.Pista: todo sale de
pveum(user add,acl modifyyuser token addcon--privsep 0). El secreto se ve una sola vez: guárdalo en el gestor de contraseñas. El valor completo esterraform@pve!tofu=<secreto>, y elcurlde prueba está en Errores frecuentes. -
Prepara el proyecto y cierra la puerta a los secretos. Instala OpenTofu en el puesto y crea el repositorio
~/iac-labcon el proyecto mínimo tal cual, unterraform.tfvarscon elpve_endpointde tu nodo y, antes del primer commit, un.gitignoreque deje fuera.terraform/,*.tfstate,*.tfstate.*yplan.bin. El orden importa: lo que entra en un commit se queda en el historial aunque se borre después, y el estado y el plan guardado van a llevar datos que no pueden salir del puesto, como cuenta Estructura de un proyecto.Pista: el proyecto lee
~/.ssh/id_ed25519.pub; si el puesto no tiene ese par de claves, genéralo antes. -
Recorre el ciclo y demuestra que no se repite. Con un plan guardado en
plan.bin, crea la VM, entra por SSH enprueba01(ID 150), repite elplany destruye la VM. El segundo plan es la prueba de la idempotencia: OpenTofu compara el código con su estado y con lo que hay en Proxmox, y no encuentra nada que hacer. Guarda la salida de los dos planes y cuenta en el primero cuántos atributos lleva la VM, aunque tú solo hayas escrito una docena: el resto lo rellena el provider. -
Publica
iac-laben Gitea. Crea en la Gitea demon01el repositorio privadoiac-labdeopsy sube el primer commit. Desde hoy es la fuente de verdad del entornopre, y las hojas siguientes trabajan sobre él.Pista: el remoto es
http://gitea.lab:23001/ops/iac-lab.git, y el repositorio vacío se crea antes, desde la web o con unPOSTa/api/v1/user/repos.
Comprobación El segundo plan termina en No changes. Your infrastructure matches the configuration., tras destroy la VM 150 no aparece en Proxmox y git status no muestra .terraform/ ni ningún tfstate. Si plan o apply fallan con 401 authentication failure o con Permission check failed, revisa el token y sus permisos (paso 1) en Errores frecuentes.
Para practicar Deja en iac-lab de Gitea los .tf, el tfvars sin el token y el .gitignore, y guarda la salida de los dos plan en ut5/a51/ de entregas-5166. Desde hoy cada hoja termina con git add, git commit y git push de iac-lab, del que parte la práctica evaluable, y sus salidas van a ut5/ de entregas-5166.
Si te sobra tiempo Cambia dedicated a 2048 con la VM creada y mira si el plan marca ~ o -/+. Prueba tofu graph | dot -Tsvg > graph.svg si tienes graphviz instalado.
Sesión 22 · Requisitos y variables
El proyecto mínimo de la A5.1 funciona, pero con los valores escritos dentro del recurso: un 1024 aquí, un devfront allá, sin que conste de dónde sale ninguno y sin nada que impida escribir un 512 o una IP sin prefijo hasta que el apply falle o, peor, hasta que la VM nazca mal. Antes de crear las tres VM del servicio hay que poner orden en los números, y de eso va esta sesión, que no crea máquinas: primero se escribe qué necesita el servicio y de dónde sale cada dato, y después cada fila se convierte en una variable con tipo, descripción y validación, de modo que un terraform.tfvars mal escrito falle en plan, en segundos y con un mensaje propio. La sintaxis de validation y sensitive se ve hoy, antes que el resto del lenguaje, porque la hoja A5.2 la necesita.
El almacén S3, de paso. La hoja empieza montando MinIO en mon01: un servidor libre de almacenamiento de objetos que habla S3, el protocolo del servicio de almacenamiento de Amazon, que se ha convertido en el estándar para guardar ficheros por HTTP. Guarda los ficheros (objetos) en contenedores con nombre, los buckets, y da a cada programa su propia credencial. Hoy no se usa. Desde el 13 de enero guarda el estado de OpenTofu (bucket tfstate, credencial tofu), y desde el 11 de febrero, las copias de seguridad de Mantenimiento (bucket backups, credencial restic). Se monta ahora porque esas dos sesiones van justas de tiempo. La receta completa está en el laboratorio, y por qué el estado se guarda en un almacén así, en Backend remoto: s3 contra MinIO.
De los requisitos al código
Por qué empezar por los requisitos. Las variables describen lo que el servicio necesita, y ese dato existe antes que el código: antes de escribir una línea de HCL hay que saber qué pide el servicio y de dónde sale cada número. Para la aplicación del curso (web + API + PostgreSQL):
| Recurso | Requisito | Origen del dato |
|---|---|---|
| Cómputo | 2 vCPU la app, 1 vCPU el proxy, 2 vCPU la BD | Pruebas de carga previas / recomendación del fabricante |
| Memoria | 2 GB app, 1 GB proxy, 2 GB BD | Idem |
| Almacenamiento | 20 GB SO + 50 GB datos en disco aparte para la BD | Volumen de datos esperado × 3 |
| Red | Subredes front/back/data de la VPC; puertos 443, 28080, 5432 | Diseño de la VPC y del cortafuegos |
| Disponibilidad | Dos instancias de app tras el proxy | Acuerdo de servicio |
| Backup | Snapshot diario de la BD | Política de la empresa |
Para qué sirve la columna del origen. Cuando dentro de seis meses alguien pregunte por qué la BD tiene 2 GB de memoria, la respuesta tiene que estar en el README, y tiene que decir de dónde salió: de una prueba de carga, de la recomendación del fabricante o de una política de la empresa. Un número sin origen no se puede defender, y tampoco cambiar con criterio. La A5.2 copia esta tabla al README de iac-lab, que es el primer punto de la práctica evaluable.
Cada fila, una variable. Cada fila acaba siendo una variable en el código, con tipo, descripción y una validación que impida valores absurdos. Un memory = 512 para PostgreSQL debería fallar en tofu plan, no a las tres de la mañana en producción. Cómo se escribe esa validación es el apartado siguiente.
Lo que el laboratorio no cumple, por escrito. El laboratorio no cumple la tabla entera, y el README lo dice en vez de esconderlo: en pre cada VM lleva 1 GB y un solo disco de 20 GB, porque es lo que el nodo da a ese entorno; hay una sola instancia de app, y las copias de la BD las hace la asignatura de Mantenimiento. Esas filas se dejan como requisito documentado, con la diferencia y su motivo al lado.
validation y sensitive
El problema. Un tipo dice qué forma tiene un valor (un número, un texto, un mapa de objetos), pero no si tiene sentido: memory = 512 es un número perfectamente válido. Las validaciones añaden esa segunda comprobación, con un mensaje escrito para quien se equivoque. Esta es la variable vms de la A5.2, con dos validaciones, y la del token:
variable "vms" {
type = map(object({
vmid = number
cores = number
memory = number
disk = number
bridge = string
ip = string
}))
description = "VM a crear, con sus requisitos"
validation {
condition = alltrue([for v in values(var.vms) : v.memory >= 1024])
error_message = "Ninguna VM puede tener menos de 1024 MB."
}
validation {
condition = alltrue([for v in values(var.vms) : can(cidrhost(v.ip, 0))])
error_message = "ip debe ser una dirección con prefijo, por ejemplo 10.10.1.10/24."
}
}
variable "pve_token" {
type = string
sensitive = true
}
Cómo se lee. vms es un mapa de objetos: una entrada por VM, con su nombre como clave y seis campos. Cada bloque validation lleva una condition, una expresión que tiene que dar true, y el error_message que se enseña cuando da false. La primera recorre las VM con una expresión for y exige que todas (alltrue) tengan al menos 1024 MB. La segunda usa un truco habitual: cidrhost() falla si la IP no lleva prefijo, y can() convierte ese fallo en false. Para comprobar que un valor está en una lista, como pide la tercera validación de la A5.2 si se hace sobre bridge, está contains(lista, valor). El tipo map(object(...)) se explica con el resto de tipos del lenguaje en la sesión 23, el 8 de enero.
Cuándo se comprueban. Las validaciones se evalúan en plan, antes de pedir nada a Proxmox, así que un tfvars mal escrito falla en segundos y con un mensaje propio, en lugar de con un error genérico del provider a mitad de un apply.
Qué hace sensitive y qué no. sensitive = true hace que el valor aparezca como (sensitive value) en el plan y en los outputs. No lo cifra: si el valor acaba en un atributo de un recurso o en un output, se guarda en claro en el estado, y un plan guardado con -out lleva sin cifrar los valores de todas las variables. Es una protección contra terminales y logs de CI, no contra quien pueda leer el tfstate o el plan.bin; por eso los dos están en el .gitignore desde la A5.1.
A5.2 Requisitos y variables (sesión 22)
Objetivo Un variables.tf con tipos, descripciones y validaciones que rechaza con tu propio mensaje un tfvars mal escrito, y MinIO en marcha en la 10.10.0.30 con sus dos buckets, listo para la A5.4. Al terminar, las tres VM de pre están descritas con valores que tienen origen y que no pueden salir absurdos, listas para que la A5.3 las cree, y el estado ya tiene dónde vivir.
Antes de empezar El proyecto iac-lab de A5.1 en el puesto de administración (sin VM creadas), con TF_VAR_pve_token exportado como en el paso 1 de la A5.1: sin él, tofu plan se para a pedirlo. Para el paso 1, SSH a mon01 (10.10.0.20) como ops, saltando desde el puesto de administración: entra en él con ssh -A, que le presta la clave de tu puesto sin copiarla. Si el profesor monta MinIO para toda el aula, el paso 1 se reduce a lo que dice la receta para ese caso. Se ha explicado cómo pasar de los requisitos a variables; la sintaxis está en validation y sensitive.
Pasos
Empiezas por MinIO porque no depende de nada de lo demás, se hace en otra máquina y tiene esperas (la descarga de la imagen), y conviene dejarlo comprobado hoy. Después vas de lo general a lo concreto: primero qué necesita el servicio y de dónde sale cada número, luego las variables que lo traducen, después los valores de pre y al final la prueba de que las validaciones rechazan lo que deben.
-
Preparación: el almacén S3 del laboratorio. Monta MinIO en
mon01, como un servicio más de su pila, con la receta de Cómo se monta MinIO: segunda dirección10.10.0.30, serviciominio, bucketstfstateybackupsy credencialestofuyrestic. Hoy no se usa: guardará el estado remoto desde la A5.4 y, desde el 11 de febrero, las copias de Mantenimiento, cada uso con su propia credencial para poder revocar una sin tocar la otra. Comprueba desde el puesto de administración que responde, porque es desde ahí desde donde lo usará OpenTofu.Pista: la receta se copia tal cual; lo único tuyo son las tres contraseñas, y las de
tofuyresticvan al gestor de contraseñas antes de seguir. -
Escribe qué necesita el servicio y de dónde sale. Copia la tabla de requisitos del apartado "De los requisitos al código" a un
README.mden la raíz deiac-laby rellénala para el servicio del curso (web + API + PostgreSQL). Cada fila lleva su origen del dato; si no lo sabes, escribe de dónde lo sacarías. Debajo, en dos o tres líneas, las diferencias del laboratorio con su motivo, como las cuenta el apartado. De esta tabla salen las variables del paso siguiente, y es el primer punto de la práctica evaluable. -
Traduce las filas a variables que se defiendan solas. Escribe un
variables.tfconvmsypve_token, de validation y sensitive, ypve_endpoint, de la A5.1, las tres condescription. Cada fila de cómputo, memoria, almacenamiento y red de tu tabla tiene su campo envms, y el bloque lleva una tercera validación tuya, sobre el disco o sobrebridge, con su propioerror_message. La descripción es lo que lee quien use el proyecto sin haber estado en clase; el mensaje de error, lo que lee quien se equivoque.Pista: para
bridge,contains()contra la lista de las seis VNets de dev y pre. -
Da los valores de pre. Escribe
terraform.tfvarscon las tres VM del servicio en el entornopre: ID 210, 220 y 230, puentesprefront,prebackypredata, IP10.20.1.10/24,10.20.2.10/24y10.20.3.10/24, 1024 MB y 20 GB cada una, y las vCPU de tu tabla. Son los de la ficha de pre del laboratorio, y los usan después las dos asignaturas. Sin recursos aún,main.tfqueda vacío: borra el recursopruebade la A5.1. -
Comprueba que las validaciones rechazan lo que deben. Pasa
fmt,validateyplan, y guarda la salida. Prueba después la validación con unmalo.tfvars, copia del tuyo conmemory = 512endb01, y guarda también la salida de ese plan: tiene que fallar con tu mensaje, no con un error del provider, y es la evidencia de que la validación funciona.Pista: otro fichero de valores se le pasa al plan con
-var-file=.
Comprobación tofu validate sale con Success!, el plan correcto no da errores y el plan con malo.tfvars falla en segundos mostrando tu error_message, no un error genérico del provider. El $M ls lab del paso 1 lista tfstate y backups, y el curl de salud responde 200.
Para practicar Deja en iac-lab el README.md con la tabla, variables.tf y terraform.tfvars, y en ut5/a52/ de entregas-5166, malo.tfvars, las dos salidas de plan y la del $M ls lab del paso 1.
Si te sobra tiempo Abre tofu console y prueba cidrhost(var.vms["db01"].ip, 1) y { for k, v in var.vms : k => v.memory } contra tus variables.
Sesión 23 · VM con OpenTofu
La A5.2 dejó descritas las tres VM de pre en variables, pero el único recurso que se sabe escribir es el de la A5.1: una VM con sus valores dentro. Copiarlo tres veces funcionaría hasta el primer cambio, y además las VM nacerían en una red a la que el puesto de administración no llega, porque pre está aislado de gestión desde la A2.5. Esta sesión resuelve las dos cosas. La teoría empieza por el lenguaje HCL: los tipos, las expresiones y for_each, que convierte un mapa de VM en tantos recursos como entradas tenga; sigue con el recurso completo del provider bpg/proxmox, que es el de la A5.1 con los valores sacados de las variables, y termina con el camino mínimo de gestión a pre. La hoja A5.3 abre primero ese camino, para que las VM sean accesibles en cuanto nazcan, y después las crea, comprueba que están protegidas y lee el plan de un cambio de memoria que no recrea nada. Para leer el plan del paso 4 de la A5.3 sirve la tabla de símbolos de Cómo leer un plan.
El lenguaje HCL
Para qué hace falta un lenguaje. Con tres VM y dos entornos, copiar el bloque de la A5.1 multiplica los sitios donde equivocarse. HCL (HashiCorp Configuration Language), el lenguaje que HashiCorp creó para sus herramientas, es declarativo pero tiene lo justo para no repetirse: tipos, variables, expresiones, bucles y funciones. No hace falta memorizarlo entero: con los tipos de bloque, los tipos de dato, for_each y media docena de funciones se escribe casi todo un proyecto.
Bloques y atributos. Un fichero .tf es una serie de bloques tipo "etiqueta" "etiqueta" { atributo = expresión }. Los tipos de bloque de uso habitual, con lo que hace cada uno:
terraform { # ajustes del propio proyecto: versiones y backend
required_version = ">= 1.9"
required_providers {
proxmox = { source = "bpg/proxmox", version = "~> 0.60" }
}
}
provider "proxmox" { ... } # cómo conectar con la API
variable "memory" { # entrada
type = number
description = "RAM en MB"
default = 2048
}
locals { # valores calculados, para no repetir
gateway = cidrhost(var.cidr, 1)
}
data "proxmox_virtual_environment_nodes" "all" {} # lectura, no crea nada
resource "proxmox_virtual_environment_vm" "web" { ... } # lo que se crea
module "vm" { source = "./modules/vm" ... } # llamada a un módulo
output "ip" { value = local.ip } # salida
Tipos y expresiones
Por qué tipar. Un tipo dice qué forma tiene un valor, y OpenTofu lo comprueba antes de hacer nada: si vms espera un número en memory y el tfvars trae "1024 MB", el plan se para ahí. Los tipos primitivos son string, number y bool. Los compuestos: list(T), set(T), map(T) (claves string) y object({ campo = T, ... }), que se pueden anidar. Un map(object({...})) es el tipo más frecuente: un diccionario de máquinas con sus atributos, como la variable vms de la A5.2.
Expresiones. Las expresiones admiten referencias (var.x, local.y, resource_type.name.attr, module.m.output), operadores, condicionales cond ? a : b, interpolación en cadenas "${var.env}-web", y bucles for, que recorren una lista o un mapa y construyen otro. La segunda línea es la que usa el output ips de la A5.3:
[for k, v in var.vms : k if v.bridge == "prefront"] # lista de nombres del front
{ for k, v in var.vms : k => v.ip } # mapa nombre => IP
count frente a for_each
El problema. Con el mapa vms hecho, falta que un solo bloque resource cree una VM por entrada. HCL tiene dos formas de crear varios recursos con un bloque, y no son intercambiables.
count, por posición. count = 3 crea vm[0], vm[1], vm[2] indexadas por posición; si se borra la del medio, la tercera pasa a ser vm[1] y OpenTofu la destruye y la recrea porque para él es otra.
for_each, por clave. for_each = var.vms crea vm["web01"], vm["app01"], indexadas por clave: borrar app01 del mapa solo toca app01. Dentro del bloque se accede con each.key (el nombre, web01) y each.value (el objeto con sus campos, each.value.memory).
El criterio. count para "n copias idénticas" o para activar o desactivar un recurso (count = var.enabled ? 1 : 0); for_each para todo lo demás, y por eso es el del curso.
flowchart TB
subgraph C["count · indexado por posición"]
direction LR
C1["<b>vm[0]</b><br><small>web01</small>"]:::pieza
C2["<b>vm[1]</b><br><small>app01 · se borra</small>"]:::riesgo
C3["<b>vm[2]</b><br><small>db01</small>"]:::pieza
R1["<b>db01 pasa a ser vm[1]</b><br><small>para OpenTofu es otro recurso:<br>lo destruye y lo vuelve a crear</small>"]:::riesgo
C1 --- C2 --- C3 --> R1
end
subgraph F["for_each · indexado por clave"]
direction LR
F1["<b>vm[#quot;web01#quot;]</b>"]:::pieza
F2["<b>vm[#quot;app01#quot;]</b><br><small>se borra</small>"]:::act
F3["<b>vm[#quot;db01#quot;]</b>"]:::pieza
R2(["<b>Solo se toca app01</b><br><small>los demás ni se enteran</small>"]):::ok
F1 --- F2 --- F3 --> R2
end
C ~~~ F
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxcount solo para «n copias idénticas» o para activar y desactivar un recurso. Para todo lo demás, for_each.
locals y funciones útiles
Calcular una vez. locals guarda valores calculados una vez y usados varias, para no repetir la misma expresión en cinco sitios.
Las funciones. HCL trae de serie funciones para redes, cadenas, ficheros y colecciones. Estas salen en casi todos los proyectos:
| Función | Ejemplo | Resultado |
|---|---|---|
cidrhost(prefix, n) |
cidrhost("10.10.1.0/24", 1) |
10.10.1.1 (la puerta de enlace) |
cidrsubnet(prefix, bits, n) |
cidrsubnet("10.10.0.0/16", 8, 2) |
10.10.2.0/24 (subred n de la VPC) |
cidrnetmask(prefix) |
cidrnetmask("10.10.1.0/24") |
255.255.255.0 |
contains(list, value) |
contains(["prefront", "preback"], "preback") |
true |
lookup(map, key, default) |
lookup(var.sizes, "db", 2048) |
valor o 2048 si no existe |
file(path) |
file("~/.ssh/id_ed25519.pub") |
contenido del fichero |
templatefile(path, vars) |
templatefile("ci.tftpl", { user = "ops" }) |
fichero renderizado (cloud-init) |
format, join, split |
format("%s-%02d", "web", 3) |
web-03 |
merge(a, b) |
merge(local.defaults, each.value) |
objeto con valores por defecto sobreescritos |
try(expr, default) |
try(each.value.disk, 20) |
20 si el campo no existe |
De la tabla, el curso usa tres: cidrhost, que da la puerta de enlace de cada VM (la .1 de su subred) y sirve para validar que una IP lleva prefijo; file, que lee la clave pública que cloud-init mete en cada VM, y contains, en la tercera validación de la A5.2 si se hace sobre bridge. tofu console abre una consola donde probar cualquiera de estas expresiones contra las variables del proyecto antes de meterlas en el código.
El grafo de dependencias
Quién va primero. OpenTofu no ejecuta los bloques en el orden del fichero. Construye un grafo dirigido: cada referencia (proxmox_virtual_environment_vm.db.ipv4_addresses dentro de otro recurso) es una arista, y los recursos sin dependencias entre sí se crean en paralelo (10 a la vez por defecto, -parallelism=n). Por eso las tres VM del laboratorio se crean a la vez y por eso el orden de destrucción es el inverso.
Cuando la dependencia no se ve. Si un recurso necesita que otro exista aunque no use ninguno de sus atributos, el grafo no lo sabe, y hay que declararlo con depends_on = [recurso]. tofu graph | dot -Tsvg > graph.svg dibuja el grafo.
flowchart LR
N["<b>Red</b><br><small>no depende de nada</small>"]:::infra
W["<b>web01</b>"]:::pieza
A["<b>app01</b>"]:::pieza
D["<b>db01</b>"]:::pieza
P["<b>Se crean en paralelo</b><br><small>10 a la vez · -parallelism=n</small>"]:::ok
REF["<b>Una referencia es una arista</b><br><small>db.ipv4_addresses dentro de otro recurso</small>"]:::dato
DEP["<b>depends_on</b><br><small>para la dependencia que no se ve en el código</small>"]:::act
N --> W & A & D --> P
REF -.-> P
DEP -.-> P
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxOpenTofu ordena por las referencias, no por el fichero: lo que no depende de nada se crea en paralelo, y al destruir recorre el grafo al revés.
Provider Proxmox y una VM completa
De una VM a tres. Con el lenguaje visto, toca crear máquinas de verdad: un proyecto completo que clona tres veces la plantilla cloud-init 9000 en el entorno pre, base de las actividades A5.3 y A5.4. El recurso es el de la A5.1 con tres cambios: los valores salen de la variable vms a través de for_each, un bloque disk fija el tamaño del disco y un bloque lifecycle impide destruir las VM.
Qué hace el provider por debajo. Hay dos providers para Proxmox con uso real: Telmate/proxmox, el histórico, y bpg/proxmox, más completo y mantenido, que es el que se usa aquí. Por debajo, el provider hace por la API lo mismo que se hacía a mano con qm: clona la plantilla, le pone CPU, memoria, disco y red, y le rellena los datos de cloud-init que la VM aplicará en su primer arranque. Con agent activado, además, espera a que el agente QEMU de la VM le diga sus direcciones antes de dar la VM por creada.
El ejemplo del curso, completo. Conviene fijarse en cuatro cosas: el token entra por variable y no por fichero, for_each sobre el mapa vms hace que un solo bloque resource cree las tres VM, el bloque initialization es lo que cloud-init aplica en el primer arranque (IP, puerta de enlace, usuario y clave SSH), y lifecycle impide que un plan destruya las VM:
# providers.tf
terraform {
required_providers {
proxmox = { source = "bpg/proxmox", version = "~> 0.60" }
}
}
provider "proxmox" {
endpoint = var.pve_endpoint
api_token = var.pve_token # usuario!token=uuid, nunca en el código
insecure = true # certificado autofirmado del laboratorio
}
# variables.tf
variable "pve_endpoint" {
type = string
}
variable "pve_token" {
type = string
sensitive = true
}
variable "vms" {
type = map(object({ vmid = number, cores = number, memory = number, disk = number, bridge = string, ip = string }))
}
# main.tf
resource "proxmox_virtual_environment_vm" "vm" {
for_each = var.vms
name = each.key
node_name = "pve"
vm_id = each.value.vmid # 210, 220, 230: la convención de IDs del laboratorio
clone { vm_id = 9000 } # la plantilla cloud-init
cpu { cores = each.value.cores }
memory { dedicated = each.value.memory }
disk {
datastore_id = "local-lvm"
interface = "scsi0"
size = each.value.disk
}
network_device { bridge = each.value.bridge }
agent { enabled = true } # qemu-guest-agent, para leer la IP
initialization {
ip_config {
ipv4 {
address = each.value.ip
gateway = cidrhost(each.value.ip, 1)
}
}
user_account {
username = "ops"
keys = [file("~/.ssh/id_ed25519.pub")]
}
}
lifecycle {
prevent_destroy = true # pre no se destruye sin aprobación
}
}
# outputs.tf
output "ips" { value = { for k, v in var.vms : k => v.ip } }
# terraform.tfvars (pre)
pve_endpoint = "https://192.168.1.50:8006/"
vms = {
web01 = { vmid = 210, cores = 1, memory = 1024, disk = 20, bridge = "prefront", ip = "10.20.1.10/24" }
app01 = { vmid = 220, cores = 2, memory = 1024, disk = 20, bridge = "preback", ip = "10.20.2.10/24" }
db01 = { vmid = 230, cores = 2, memory = 1024, disk = 20, bridge = "predata", ip = "10.20.3.10/24" }
}
El token. Va en la variable de entorno TF_VAR_pve_token, como en la A5.1, y no en ningún fichero. Es el token tofu de terraform@pve que se crea en la A5.1, con tres permisos: PVEVMAdmin sobre /vms, PVEDatastoreUser sobre /storage/local-lvm y PVESDNUser sobre /sdn/zones/lab, que es el que deja conectar una VM a una VNet. El token se crea sin separación de privilegios (--privsep 0) para que herede los permisos del usuario.
Los valores. Los del tfvars son los que caben en el nodo, no los de la tabla de requisitos: 1 GB y 20 GB por VM, con la diferencia escrita en el README. Los puentes son las VNets de pre en el SDN (prefront, preback, predata; el porqué de esos nombres, en Una VNet por zona, una subred por VNet). El ejemplo despliega pre porque las VM de dev ya existen, creadas a mano, y aplicar el código contra ellas chocaría.
La protección. prevent_destroy hace fallar cualquier plan que quiera destruir una de estas VM, por error o a propósito. Lo que se quiere proteger de verdad es db01, que guarda la base de datos, pero el bloque lifecycle es del recurso entero y no admite variables, así que con for_each protege las tres, que es lo que conviene en pre. Mantenimiento depende de él hasta que lo da de baja, el 11 de marzo, y para hacerlo quita el bloque en una rama del repositorio, que queda como evidencia de la aprobación.
La sintaxis exacta del provider cambia entre versiones
Los nombres de bloques y atributos de bpg/proxmox (por ejemplo initialization, ip_config, user_account) han cambiado varias veces entre versiones 0.x, y seguirán haciéndolo. El ejemplo de arriba se escribió para la serie 0.6x, pero version = "~> 0.60" admite cualquier 0.x a partir de la 0.60: la versión que se usa de verdad es la que tofu init dejó escrita en .terraform.lock.hcl. Antes de copiar nada conviene abrir la página del recurso en https://registry.opentofu.org/providers/bpg/proxmox/latest/docs para esa versión, y no subirla (tofu init -upgrade) sin leer el changelog.
Cómo llega el puesto de administración a pre
El problema: pre está aislado a propósito. Desde la A2.5, nada de dev alcanza pre: router-pre tiene un blackhole para 10.10.0.0/16 y ningún router conoce la red del otro entorno. OpenTofu no lo nota, porque habla con la API de Proxmox por la red del aula y no con las VM. Pero entrar por SSH en ellas, y después configurarlas con Ansible, exige llegar desde el puesto de administración. Es lo que se dejó previsto al aislar los entornos: cuando haga falta unir dos, se añade la ruta concreta, en un solo sentido y filtrada.
El camino mínimo, en tres piezas. Se abre solo lo imprescindible, y en un solo sentido:
router-prerecibe una sexta tarjeta, endevmgmt, con la10.10.0.2, una dirección del rango.2a.9que el laboratorio reserva para servicios de red. Dentro de la VM esens23. Como10.10.0.0/24queda conectada a esa tarjeta, es una ruta más específica que el blackhole de10.10.0.0/16y gana (un router elige siempre la ruta de prefijo más largo):router-preya puede contestar a gestión.- En
router-pre, tres reglas nftables en la cadenaforward: lo establecido y relacionado pasa, lo que entra porens23pasa, y nada nuevo sale deprehaciaens23.preresponde a gestión, pero no puede iniciar nada contra ella. - En el puesto de administración, una ruta a
10.20.0.0/16por la10.10.0.2, en la misma unidadruta-lab.servicede la A2.4.
Las tres reglas. Van en la tabla inet fw, la de los hosts del curso, en una cadena enganchada a forward, que es la que ve el tráfico que el router pasa de una red a otra:
table inet fw {
chain forward {
type filter hook forward priority filter; policy accept;
ct state established,related accept
iifname "ens23" accept
oifname "ens23" drop
}
}
La primera regla deja pasar las respuestas de cualquier conexión ya aceptada, la segunda todo lo que llega desde gestión, y la tercera tira cualquier conexión nueva que pre intente abrir hacia gestión. La política accept mantiene lo que ya funcionaba: la salida de pre a Internet por el NAT y el tráfico entre sus zonas. Para que sobrevivan a un reinicio se guardan en /etc/nftables.conf junto a la tabla de NAT de la A2.5, porque es el fichero que carga nftables.service al arrancar.
Repaso
nftables se explica a fondo en la sesión 17 de Mantenimiento (1 de diciembre), y en router-pre ya hace el NAT de salida desde la A2.5. Aquí solo se añade la tabla inet fw, la de los hosts del curso, con una cadena forward de tres reglas.
Qué entra en pre y cómo. Lo que llega a pre se empuja siempre desde gestión: ficheros con Ansible e imágenes con docker save por SSH, porque pre no puede abrir conexiones hacia gestión. pre sale a Internet por el NAT de router-pre, como desde la A2.5. En las hojas, las máquinas de pre se escriben con su IP (10.20.x.10): los nombres <host>.pre.lab solo los resuelve router-pre.
A5.3 VM completas (sesión 23)
Objetivo El puesto de administración llega a pre, y web01, app01 y db01 corren en ese entorno, accesibles por SSH desde el puesto y protegidas con prevent_destroy, con un cambio de memoria que el plan resuelve con ~ sobre un solo recurso. Es el entorno pre que usan las dos asignaturas hasta marzo, y distinguir en un plan lo que cambia en caliente de lo que se recrea es lo que evita perder db01 el día que alguien toque el atributo equivocado.
Antes de empezar iac-lab con el variables.tf y el tfvars de A5.2 y TF_VAR_pve_token exportado en el puesto de administración. pre como quedó en la A2.5: las VNets prefront, preback y predata, con su subred sin puerta de enlace y sin rango DHCP, y router-pre (ID 200) encendido como .1, DHCP y DNS del entorno, accesible por su IP del aula. La web01 de pre (ID 210) de la A2.5 ya no existe: en qm list no hay ninguna VM entre la 210 y la 239. Se despliega pre porque las VM de dev ya existen, creadas a mano, y las tres nuevas caben en el presupuesto de memoria sin apagar nada de dev. Se ha explicado el recurso VM del provider, cómo llega el puesto de administración a pre, for_each y cómo leer un plan.
Pasos
Primero abres el camino de gestión a pre: OpenTofu no lo necesita para crear las VM, porque habla con la API de Proxmox, pero tú sí para entrar en ellas en cuanto nazcan. Después las creas, compruebas que la protección funciona antes de que nadie dependa de ella, y terminas leyendo el plan de un cambio pequeño, que es lo que más vas a hacer en el resto de la unidad.
-
El camino de gestión a pre. Abre el paso del puesto de administración a
precon los tres cambios de Cómo llega el puesto de administración a pre, de forma que sobrevivan a un reinicio: la tarjeta derouter-preendevmgmt, sus tres reglas deforwardy la ruta del puesto. Que sobrevivan importa porquerouter-prey el puesto se reinician durante el curso, y Mantenimiento entra enprepor este mismo camino en febrero. Guarda elip rderouter-pre, donde se ve por qué gana la ruta de gestión al blackhole, y comprueba que10.20.1.1responde desde el puesto.Pista: la tarjeta se añade desde el nodo con
qm set 200 --net5 ... --ipconfig5 ..., y cloud-init no la configura hasta que reinicias la VM. Al guardar las reglas en/etc/nftables.conf, conserva la tabla de NAT de la A2.5; la ruta es una segunda líneaExecStart=enruta-lab.service. -
Crea las tres VM desde un plan guardado. Escribe
main.tfyoutputs.tfcon el ejemplo de Provider Proxmox y una VM completa y despliega las tres VM a partir de un plan guardado, que tiene que resumirse enPlan: 3 to add, 0 to change, 0 to destroy: aplicar el fichero del plan garantiza que se crea exactamente lo que has leído. Comprueba sus direcciones contofu output ipsy entra por SSH en las tres desde el puesto de administración; si entras, cloud-init ha hecho su trabajo y el camino del paso 1 funciona. -
Comprueba que pre está protegido.
tofu plan -destroytiene que fallar sin tocar nada. Guarda la salida. Es la prueba de que elprevent_destroyestá donde debe antes de que otra asignatura empiece a depender depre. -
Lee el plan de un cambio pequeño. Sube la memoria de
app01a 1536 enterraform.tfvarsy guarda la salida completa del plan, sin aplicar: el nodo no tiene RAM para ello. Léelo con la tabla de Cómo leer un plan: qué símbolo lleva, cuántos recursos toca y si alguno se recrea. Devuelve la memoria a 1024 y comprueba que el plan no deja nada pendiente.
Comprobación ping -c1 10.20.1.1 responde desde el puesto de administración. El plan -destroy del paso 3 falla con Instance cannot be destroyed. El plan del paso 4 lleva exactamente un recurso con ~ update in-place, Plan: 0 to add, 1 to change, 0 to destroy, y ninguna línea # forces replacement; con la memoria devuelta a 1024, tofu plan dice No changes.
Para practicar Deja main.tf y outputs.tf en iac-lab y, en ut5/a53/ de entregas-5166, el ip r de router-pre y las salidas de los pasos 3 y 4. No destruyas las VM: la A5.4 sigue sobre ellas.
Si te sobra tiempo Cambia node_name o datastore_id solo en el plan (sin aplicar), localiza la línea # forces replacement y fíjate en que prevent_destroy para el plan antes de destruir nada.
Sesión 24 · Módulos y estado
Con las tres VM de pre vivas, el proyecto funciona, pero tiene dos debilidades que se notarán en cuanto lo use alguien más. La primera es el código: está en la raíz del repositorio y sirve para un solo entorno, así que describir dev sería copiarlo entero. La segunda es el estado: es un fichero en el disco del puesto de administración, y si se pierde OpenTofu olvida qué VM son suyas, si dos personas aplican a la vez se pisan, y nadie más puede usarlo. En esta sesión el repositorio adopta la forma que tendrá hasta marzo: un módulo vm, un directorio por entorno (envs/dev, envs/pre) y el estado en MinIO con bloqueo. La teoría empieza por los módulos y la estructura por entornos, y sigue con el estado: qué contiene, cómo se guarda en un backend remoto y cómo se mueve un recurso al módulo con moved o state mv sin que el plan quiera destruirlo. La hoja A5.4 recorre exactamente ese camino, sin recrear ninguna VM, sobre el MinIO que quedó montado en la A5.2. Ese estado compartido es el que usa Mantenimiento el 11 de marzo para dar de baja pre.
Módulos, entornos y estructura del repositorio
El problema: copiar y pegar. Con un proyecto que ya funciona, el siguiente problema es no repetirlo: tres VM en dev, otras tres en pre, otras en pro, cada una con los mismos cuarenta atributos. Un cambio en la forma de crear una VM (otro disco, otra opción del agente) habría que hacerlo en todas las copias, y alguna se quedaría atrás. Aquí la VM se empaqueta en un módulo y los entornos se separan de forma que un error en dev no pueda tocar pro.
Qué es un módulo. Un directorio con ficheros .tf que recibe variables y devuelve outputs, como una función. Cualquier proyecto es ya un módulo (el raíz); un módulo hijo se llama con module "app" { source = "./modules/vm" ... }, pasándole sus variables, y se accede a sus salidas con module.app.ip. Sirve para que el equipo de plataforma publique "así se hace una VM aquí" y los demás solo pasen nombre, tamaño y red.
Qué declara un módulo y qué no. Dos reglas de diseño: un módulo hace una cosa (una VM, una subred, un bucket) y no configura su propio provider, que hereda del raíz con su endpoint y su token. Lo que sí tiene que hacer es decir qué provider usa: si no lo declara, OpenTofu supone que su proxmox es hashicorp/proxmox, que no existe, y tofu init falla al buscarlo. Basta este bloque, sin versión, porque la versión ya la fija el raíz:
# al principio de modules/vm/main.tf
terraform {
required_providers {
proxmox = { source = "bpg/proxmox" }
}
}
Un directorio por entorno. Para los entornos hay dos caminos. Los workspaces (tofu workspace new pre) mantienen varios estados para el mismo código y exponen terraform.workspace como variable; sirven cuando la única diferencia entre entornos son valores. El directorio por entorno (envs/dev, envs/pre, envs/pro), cada uno con su backend, su tfvars y sus llamadas a los módulos comunes, es lo que prefiere la mayoría de los equipos, y lo que se usa aquí: se ve de un vistazo qué hay en cada entorno, un error en dev no puede tocar el estado de pro, los permisos del backend se dan por directorio y el pipeline solo tiene que hacer cd envs/pre. Los workspaces comparten backend y credenciales, y es fácil aplicar en el workspace equivocado.
flowchart LR
R["<b>iac-lab</b><br><small>el repositorio</small>"]:::dato
M["<b>modules/</b><br><small>lo reutilizable</small>"]:::pieza
E["<b>envs/</b><br><small>lo que cambia por entorno</small>"]:::pieza
A["<b>ansible/</b>"]:::pieza
T["<b>test.sh</b>"]:::pieza
P["<b>.pre-commit-config.yaml</b>"]:::pieza
M1["<b>vm/</b><br><small>main.tf · variables.tf · outputs.tf</small>"]:::infra
M2["<b>network/</b>"]:::infra
E1["<b>dev/</b><br><small>backend.tf · main.tf · terraform.tfvars</small>"]:::infra
E2["<b>pre/</b><br><small>backend.tf · main.tf · terraform.tfvars</small>"]:::infra
A1["<b>inventory.ini · group_vars/ · files/ · site.yml</b>"]:::infra
R --> M & E & A & T & P
M --> M1 & M2
E --> E1 & E2
A --> A1
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxLa separación que importa es modules/ frente a envs/: el módulo no sabe en qué entorno vive, y el entorno solo aporta sus valores.
El módulo vm del curso. Expone como mínimo name, vmid, cores, memory, disk, bridge, ip como variables y ip y vm_id como outputs. Dentro tiene un solo recurso, sin for_each: sabe crear una VM, y quien lo llama decide cuántas. envs/pre/main.tf lo llama con for_each = var.vms y pasa a cada variable del módulo el campo de each.value del mismo nombre. Los módulos se pueden versionar aparte y referenciar por Git (source = "git::https://gitea.lab/iac/modules.git//vm?ref=v1.2.0"), que es como se hace cuando varios repositorios los comparten.
El estado a fondo
Qué problema resuelve. En el código la VM se llama vm["web01"], y en Proxmox es la VM 210. Algo tiene que guardar que son la misma, y ese algo es el estado, la pieza que hace que OpenTofu sea declarativo y también la que más disgustos da cuando se trabaja en equipo. terraform.tfstate es un JSON con la correspondencia entre cada bloque resource del código y el objeto real: su ID en Proxmox, todos sus atributos tal como el provider los leyó la última vez (también los que no escribió nadie, como los de la A5.1), las dependencias y la versión del provider. Sin estado OpenTofu no sabe que vm["web01"] es el VMID 210 y en el siguiente apply intentaría crear otra.
Por qué es delicado. Al guardar todos los atributos, guarda también los que no deberían salir de ahí:
El estado es un fichero con secretos dentro
Como guarda todos los atributos tal como el provider los leyó, guarda también las contraseñas de cloud-init, los tokens y cualquier valor que un recurso devuelva. Nunca va al repositorio, ni siquiera «temporalmente para probar»: el historial de Git no se olvida.
flowchart LR
COD["<b>Código</b><br><small>resource vm[#quot;web01#quot;]</small>"]:::dato
EST["<b>terraform.tfstate</b><br><small>web01 → VMID 210<br>+ todos sus atributos</small>"]:::dato
REAL["<b>Lo que existe en Proxmox</b><br><small>la VM 210 de verdad</small>"]:::pieza
SIN["<b>Sin estado</b><br><small>no sabe que web01 ya existe:<br>en el siguiente apply crea otra</small>"]:::riesgo
COD <--> EST <--> REAL
EST -. "si se pierde" .-> SIN
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxEl estado es lo que convierte el código en declarativo: sin él no hay forma de saber qué bloque corresponde a qué máquina.
Las reglas que salen de ahí.
- Nunca editarlo a mano. Para moverlo o limpiarlo están los subcomandos
tofu state. - En equipo, guardarlo en un backend remoto con bloqueo, no en Git. Dos personas aplicando a la vez sobre el mismo estado lo corrompen.
- Protegerlo como un secreto: permisos en el bucket, cifrado, sin copias en el portátil.
.gitignorecon*.tfstate,*.tfstate.*y.terraform/. Si el estado ha entrado en el repositorio alguna vez, tratarlo como un secreto filtrado.
Backend remoto: s3 contra MinIO
Por qué no basta el fichero local. Un estado en el disco del puesto de administración sirve para una persona y un día. Se pierde con el disco, no lo ve nadie más y no impide que dos personas apliquen a la vez, que es la forma más rápida de corromperlo. El backend es el sitio donde OpenTofu guarda el estado: el local, que es el de por defecto, lo deja en un fichero junto al código; uno remoto lo guarda en un servidor compartido y, si lo admite, lo bloquea mientras alguien aplica.
Por qué S3. El backend s3 guarda el estado como un objeto dentro de un bucket de cualquier almacén que hable S3, el protocolo del servicio de almacenamiento de Amazon. En el laboratorio ese almacén es MinIO, en la subred de gestión, en la 10.10.0.30, como un contenedor más de la pila de mon01; lo monta el primer paso de la hoja A5.2, casi un mes antes de que haga falta, y en él se guarda el estado de los dos entornos del repositorio.
Cómo se configura. El bloque va en envs/pre/backend.tf. Usa el mismo protocolo que AWS S3, así que solo hay que apuntarlo a MinIO y desactivar las comprobaciones que son de AWS:
terraform {
backend "s3" {
bucket = "tfstate"
key = "envs/pre/terraform.tfstate"
region = "main"
endpoints = { s3 = "http://10.10.0.30:29000" }
use_path_style = true
skip_credentials_validation = true
skip_region_validation = true
skip_requesting_account_id = true
skip_metadata_api_check = true
use_lockfile = true
}
}
Lo que no es obvio del bloque.
bucketykeydicen dónde se guarda: el buckettfstatede la A5.2 y la ruta del objeto dentro de él. Cada entorno lleva su propiakey(envs/pre/...,envs/dev/...), y por eso los dos estados no se tocan.endpointsyuse_path_styleapuntan a MinIO. AWS pone el nombre del bucket delante del nombre del servidor (tfstate.s3.amazonaws.com); MinIO lo espera en la ruta (10.10.0.30:29000/tfstate).regiony los cuatroskip_*existen porque el backend está pensado para AWS, que valida la región, la cuenta y las credenciales contra servicios suyos que MinIO no tiene: las comprobaciones se desactivan y la región queda como un nombre de relleno.
Las credenciales, fuera del bloque. Van en AWS_ACCESS_KEY_ID y AWS_SECRET_ACCESS_KEY (o en -backend-config= en init), nunca en el bloque, que se sube a Git. Con MinIO, la clave de acceso es el nombre del usuario (tofu) y el secreto, su contraseña. Llevar un estado local a un backend nuevo es un init: OpenTofu ve que el backend ha cambiado y, con -migrate-state, copia el estado al sitio nuevo.
El bloqueo. use_lockfile = true implementa el bloqueo con un fichero .tflock junto al estado; requiere una versión reciente de MinIO. Mientras alguien aplica, ese fichero existe, y un segundo apply simultáneo falla con Error acquiring the state lock en lugar de pisar el estado. Si alguien pierde la conexión con el bloqueo tomado, tofu force-unlock ID lo libera, solo después de comprobar que nadie está aplicando de verdad.
OpenTofu puede además cifrar el estado antes de subirlo, y hay otros backends para cuando no se tiene un almacén S3 a mano; las dos cosas, en Para ampliar.
Manipular el estado
Cuándo hace falta. El estado relaciona direcciones del código con objetos reales, y hay cambios que mueven la dirección sin tocar el objeto. Al llevar el recurso a un módulo, proxmox_virtual_environment_vm.vm["db01"] pasa a llamarse module.vm["db01"].proxmox_virtual_environment_vm.this, y para OpenTofu son dos recursos distintos: uno que ya no está en el código, y que por tanto hay que destruir, y otro nuevo, que hay que crear. Con prevent_destroy el plan se para; sin él, recrearía las tres VM. Lo que falta es decirle que es el mismo objeto con otra dirección, y para eso, y para otras operaciones sobre el estado, hay órdenes que lo tocan sin editarlo a mano:
tofu state list # qué recursos gestiona
tofu state show 'module.vm["db01"].proxmox_virtual_environment_vm.this'
tofu state mv 'proxmox_virtual_environment_vm.vm["db01"]' 'module.vm["db01"].proxmox_virtual_environment_vm.this'
tofu state rm 'proxmox_virtual_environment_vm.vm["tmp"]' # olvida el recurso, no lo destruye
tofu import 'proxmox_virtual_environment_vm.legacy' pve/110 # adopta una VM que ya existía (web01 de dev)
state mv o moved. state mv es lo que salva al extraer un recurso a un módulo (actividad A5.4): cambia la dirección en el estado en el momento, desde una terminal, y no deja rastro en el código. Esto mismo se puede escribir en el código con un bloque moved { from = ... to = ... }, que queda versionado y se aplica en el siguiente plan de cualquiera que use el repositorio; es preferible al comando en proyectos de equipo. El plan lo anuncia como un movimiento, sin crear ni destruir nada, y el estado guarda la dirección nueva con el siguiente apply.
Adoptar lo que ya existe. import adopta un recurso creado a mano: OpenTofu lo lee y lo mete en el estado, y el siguiente plan muestra la diferencia entre lo que hay y lo que dice el código. El formato del ID (nodo/vmid en el caso de bpg) lo dice la documentación de cada recurso. En el curso no se importa dev: sus VM se crearon a mano y han cambiado desde entonces (la red por DHCP, el segundo disco de db01), y el primer plan tras importarlas querría dejarlas como dice el código. Por eso envs/dev se escribe en la A5.4 pero no se aplica. Hay también un bloque import que además escribe el HCL del recurso adoptado; está en Para ampliar.
A5.4 Módulos y estado (sesión 24)
Objetivo El repositorio queda con modules/vm, envs/pre y envs/dev, el estado en MinIO con bloqueo, y las tres VM de A5.3 siguen vivas sin haberse recreado. Es la forma que tendrá iac-lab hasta marzo, y del estado remoto que dejas hoy sale el inventario de Ansible en la A5.5.
Antes de empezar Las VM de A5.3 desplegadas y su terraform.tfstate local, en iac-lab del puesto de administración. MinIO en marcha en la 10.10.0.30, con los buckets tfstate y backups y el secreto de la credencial tofu a mano: se montó en el paso 1 de la A5.2, y si no está, móntalo con ese paso antes de la sesión. El puesto de administración está en la subred de gestión y alcanza el 29000 de MinIO: el curl de salud de ese paso tiene que dar 200. Se han explicado módulos y entornos, el backend remoto y cómo mover recursos en el estado.
Pasos
Primero cambias la forma del código (el módulo y el directorio de pre) y después arreglas el estado para que reconozca las VM en su dirección nueva: mientras el plan quiera destruir algo, el estado no se mueve de sitio. Solo con el estado correcto lo llevas a MinIO, compruebas que el bloqueo protege de verdad y, al final, describes dev con el mismo módulo, que es la prueba de que el código sirve para más de un entorno.
-
Empaqueta la VM en un módulo y lleva pre a su directorio. Extrae la VM a un módulo,
modules/vm, y pasa el proyecto aenvs/pre/. El módulo tiene un soloresource "proxmox_virtual_environment_vm" "this"sinfor_each, las variablesname,vmid,cores,memory,disk,bridgeeip, ellifecyclede la A5.3 y los outputsipyvm_id; no lleva bloqueprovider, pero sí surequired_providers, como cuenta Módulos, entornos y estructura del repositorio. Aenvs/pre/vanproviders.tf,variables.tf,outputs.tfy el tfvars, con unmain.tfnuevo que llama al módulo confor_each = var.vms; el de la raíz se borra. Así el módulo solo sabe crear una VM, yenvs/presolo dice cuáles.Pista: la llamada lleva
source = "../../modules/vm",name = each.keyy cada campo deeach.valueen la variable del mismo nombre. -
Mueve las VM al módulo sin recrearlas. Con el
terraform.tfstatede la A5.3 copiado aenvs/pre/, dile a OpenTofu dónde ha ido a parar cada una, hasta que el plan digaNo changeso solo anuncie los movimientos. Sin esto, el plan querría destruir las tres VM y crearlas otra vez con la dirección del módulo, yprevent_destroylo pararía. Guarda esa salida y, si has usado bloquesmoved, aplica el plan: el estado no guarda las direcciones nuevas hasta elapply, y eseapplyno toca ninguna VM.Pista: un bloque
movedpor VM, deproxmox_virtual_environment_vm.vm["web01"]amodule.vm["web01"].proxmox_virtual_environment_vm.this, o elstate mvequivalente de Manipular el estado. -
Lleva el estado a MinIO. Pon el estado de
preen MinIO con unenvs/pre/backend.tfcon el bloque de Backend remoto: s3 contra MinIO y la credencialtofude la A5.2 exportada enAWS_ACCESS_KEY_IDyAWS_SECRET_ACCESS_KEY. Guarda la salida detofu state listantes y después de borrar elterraform.tfstatelocal y su.backup: las dos veces tiene que listar las tres VM, y la segunda demuestra que lo que lee OpenTofu ya está en MinIO y no en el disco del puesto.Pista: la clave de acceso es el propio nombre de la credencial,
tofu. El cambio de backend se hace contofu init -migrate-state. -
Comprueba que el bloqueo protege. Lanza
tofu applya la vez desde dos terminales, captura el error de la segunda y respondenoen la primera. Es lo que pasaría si dos personas aplicaran a la vez sobrepre: la segunda se encuentra el bloqueo en lugar de pisar el estado. -
Describe dev con el mismo módulo, sin aplicarlo. Crea
envs/dev/copiandopre, con su propiakeyen el backend,envs/dev/terraform.tfstate, y el tfvars de dev:vmid110, 120 y 130, puentesdevfront,devbackydevdata, IP10.10.1.10/24,10.10.2.10/24y10.10.3.10/24y la memoria de la tabla del laboratorio (1024, 2048 y 2048). Inicialízalo y pasa el plan sin aplicar: esas VM ya existen, creadas a mano, y unapplychocaría con ellas. Lo que demuestra el paso es que otro entorno se describe cambiando solo los valores y lakeydel estado.
Comprobación git status no muestra ningún tfstate; tofu state list en envs/pre responde desde MinIO; el plan del paso 2 no destruyó nada; el error de bloqueo está capturado.
Para practicar Deja modules/ y envs/ en iac-lab y las salidas de los pasos 2, 3 y 4 en ut5/a54/ de entregas-5166. No borres el estado remoto: con él da de baja pre Mantenimiento, el 11 de marzo.
Si te sobra tiempo Añade una variable env al módulo y úsala en el nombre ("${var.env}-${var.name}"); mira en el plan qué atributos fuerza a recrear un cambio de nombre en bpg/proxmox.
Sesión 25 · Ansible
Las VM de pre existen, arrancan y aceptan SSH, pero están vacías: son clones limpios de la plantilla. Falta lo que las convierte en el servicio, PostgreSQL en db01 y la API en app01, y falta hacerlo como se ha hecho todo en la unidad: descrito en ficheros, repetible y sin cambios si se ejecuta dos veces. OpenTofu no es la herramienta para eso: su terreno es lo que la API de Proxmox sabe crear, y dentro de la máquina solo puede intervenir en el primer arranque, a través de cloud-init. Para configurar una máquina que ya existe, y volver a hacerlo cada vez que algo cambie, está Ansible. La teoría lo recorre en el orden en que se usa: a qué máquinas (el inventario, a mano y generado con jq desde los outputs de OpenTofu para no escribirlo dos veces), qué se les hace (los comandos ad hoc y el playbook del curso con handlers), por qué la segunda pasada no cambia nada y cómo se organiza en roles cuando crece; Vault y ansible-lint cierran el apartado, y ansible-lint lo usa la hoja A5.5 en su último paso. Al acabar, PostgreSQL corre en db01 y el servicio del curso en app01 de pre, y la segunda pasada del playbook termina con changed=0.
Ansible
Qué es y de dónde sale. Ansible es una herramienta de gestión de configuración: deja las máquinas como se le describe (paquetes instalados, ficheros con un contenido, servicios arrancados). Nació en 2012 y desde 2015 es de Red Hat. Su rasgo distintivo es que no instala agente: necesita SSH y un intérprete de Python en el destino, cosa que cualquier imagen cloud de Debian o Ubuntu trae.
Cómo trabaja. Desde la máquina de control (en esta unidad, el puesto de administración) se conecta a cada host, copia un pequeño programa Python (el módulo, que en Ansible es cada acción: instalar un paquete, copiar un fichero), lo ejecuta y recoge el resultado en JSON, que dice si ha cambiado algo. La palabra coincide, pero un módulo de Ansible no tiene nada que ver con un módulo de OpenTofu.
Instalación. En Debian se instala con el paquete de la distribución, sudo apt install ansible ansible-lint, que trae ansible-core y las colecciones de la comunidad (paquetes de módulos, como community.docker y community.postgresql) que usa el playbook del curso; ansible --version debe indicar core 2.18 o superior. En otros sistemas, pipx install ansible (pipx instala herramientas Python cada una en su entorno aislado).
Inventario
A qué máquinas. El inventario lista los hosts y los agrupa. Las jugadas del playbook se dirigen a grupos y no a máquinas sueltas, así que añadir una segunda máquina de aplicación sería añadir una línea al grupo app. En INI, que es el formato que usa el curso:
# inventory.ini
[web]
web01 ansible_host=10.20.1.10
[app]
app01 ansible_host=10.20.2.10
[db]
db01 ansible_host=10.20.3.10
[servicio:children]
web
app
db
[all:vars]
ansible_user=ops
ansible_python_interpreter=/usr/bin/python3
Cada línea de host lleva el nombre con el que Ansible lo llama y, en ansible_host, la IP a la que se conecta. [servicio:children] es un grupo de grupos, y [all:vars] pone variables a todos: el usuario con el que entra (ops, el que crea cloud-init) y el Python que usa en el destino. El mismo inventario se puede escribir en YAML, el formato que prefiere ansible-lint; el curso se queda con INI porque es el que genera gen-inventory.sh, y la versión YAML está en Para ampliar. ansible-inventory -i inventory.ini --graph dibuja los grupos y sirve para comprobar que la agrupación es la correcta.
Inventario generado desde los outputs de OpenTofu
El problema. Escribir el inventario a mano duplica lo que ya está en tfvars, y se desincroniza a la primera: una IP cambiada en un sitio y no en el otro, y Ansible configura la máquina equivocada. Quien sabe qué máquinas existen y con qué IP es OpenTofu, así que el inventario se saca de sus outputs.
Cómo. tofu output -json devuelve todos los outputs en JSON (entre ellos ips, el mapa de nombre a IP de la A5.3), y con jq (el filtro de JSON de la línea de comandos) se convierte en inventario en cinco líneas:
#!/usr/bin/env bash
# gen-inventory.sh: genera ansible/inventory.ini desde los outputs de envs/pre
set -euo pipefail
cd "$(dirname "$0")/envs/${ENV:-pre}"
tofu output -json ips | jq -r '
to_entries
| map(. + { group: (.key | sub("[0-9]+$"; "")) })
| group_by(.group)
| map("[\(.[0].group)]\n" + (map("\(.key) ansible_host=\(.value | split("/")[0])") | join("\n")))
| join("\n\n")' > ../../ansible/inventory.ini
printf '\n[all:vars]\nansible_user=ops\n' >> ../../ansible/inventory.ini
El filtro convierte el mapa en una lista de parejas, agrupa por el nombre sin el número final (web01 va al grupo web, db01 a db), escribe cada grupo con su cabecera y quita el /24 de la IP. Como tofu output lee el estado, y el estado está en MinIO desde la A5.4, el script necesita las mismas credenciales que tofu plan. En proyectos más grandes se usa el plugin de inventario cloud.terraform.terraform_state, que lee el estado directamente; el script se entiende entero.
Comandos ad hoc y playbooks
Órdenes sueltas, para comprobar. Un comando ad hoc ejecuta un módulo en un grupo sin escribir playbook. Sirve para comprobar y para arreglar cosas puntuales:
ansible -i inventory.ini all -m ping # conectividad y Python
ansible -i inventory.ini db -m setup -a 'filter=ansible_memtotal_mb'
ansible -i inventory.ini app -b -m apt -a 'name=docker.io,docker-compose state=present update_cache=true'
El módulo ping no es el ping de red: comprueba que Ansible entra por SSH y encuentra Python. setup recoge los facts, los datos que Ansible averigua de cada máquina (memoria, CPU, discos, red), y -b (become) ejecuta como root, con sudo. La tercera orden es la que instala Docker en app01 en la A5.5.
El playbook: lo que se quiere, en orden. Un playbook es un fichero YAML con una o más jugadas (plays), cada una con un grupo de hosts y una lista de tareas, y cada tarea llama a un módulo con sus parámetros. El del curso tiene dos: la primera deja PostgreSQL en db01 con la base servicio y el usuario app, abierto solo a la subred de app01; la segunda deja el servicio en app01, con el compose en /opt/servicio apuntando a esa base. web01 no tiene jugada: en pre se queda como clon limpio, sin nginx ni certificado. Conviene fijarse en que cada tarea tiene nombre, usa el nombre completo del módulo y describe un estado (present, directory), no una acción, y en que lo que va entre dobles llaves ({{ pg_conf }}) es una plantilla de Ansible (Jinja2) que se sustituye por el valor de la variable:
# site.yml
- name: PostgreSQL en db01
hosts: db
become: true
vars:
pg_conf: /etc/postgresql/17/main
tasks:
- name: Instalar PostgreSQL y lo que necesitan los módulos
ansible.builtin.apt:
name: [postgresql, python3-psycopg2, acl]
state: present
update_cache: true
- name: Escuchar en la red
ansible.builtin.lineinfile:
path: "{{ pg_conf }}/postgresql.conf"
regexp: "^#?listen_addresses"
line: "listen_addresses = '*'"
notify: Reiniciar PostgreSQL
- name: Admitir solo a la subred de app
ansible.builtin.lineinfile:
path: "{{ pg_conf }}/pg_hba.conf"
line: "host servicio app 10.20.2.0/24 scram-sha-256"
notify: Reiniciar PostgreSQL
- name: Crear el usuario de la aplicación
become: true
become_user: postgres
community.postgresql.postgresql_user:
name: app
password: "{{ db_password }}"
no_log: true
- name: Crear la base del servicio
become: true
become_user: postgres
community.postgresql.postgresql_db:
name: servicio
owner: app
handlers:
- name: Reiniciar PostgreSQL
ansible.builtin.service:
name: postgresql
state: restarted
- name: El servicio en app01
hosts: app
become: true
vars:
app_dir: /opt/servicio
tasks:
- name: Instalar Docker y el plugin compose
ansible.builtin.apt:
name: [docker.io, docker-compose]
state: present
update_cache: true
- name: Crear el directorio del servicio
ansible.builtin.file:
path: "{{ app_dir }}"
state: directory
mode: "0755"
- name: Crear la red obs que el compose declara externa
community.docker.docker_network:
name: obs
- name: Copiar el fichero compose
ansible.builtin.copy:
src: files/compose.yml
dest: "{{ app_dir }}/compose.yml"
mode: "0644"
notify: Reiniciar el servicio
- name: Escribir el .env de pre
ansible.builtin.copy:
dest: "{{ app_dir }}/.env"
content: |
APP_IMAGE={{ app_image }}
DB_HOST={{ db_host }}
DB_NAME=servicio
DB_USER=app
DB_PASSWORD={{ db_password }}
mode: "0600"
no_log: true
notify: Reiniciar el servicio
- name: Levantar el servicio
community.docker.docker_compose_v2:
project_src: "{{ app_dir }}"
state: present
handlers:
- name: Reiniciar el servicio
community.docker.docker_compose_v2:
project_src: "{{ app_dir }}"
state: restarted
Y las variables que usan las dos jugadas, en group_vars/all.yml junto al playbook:
# group_vars/all.yml
app_image: app:1.4.2 # la imagen que corre en app01 de dev: docker image ls app
db_host: 10.20.3.10
# La contraseña del usuario app la genera Ansible la primera vez y la guarda en
# ansible/secretos/db-pre, que está en .gitignore: nunca entra en el repositorio
db_password: "{{ lookup('ansible.builtin.password', 'secretos/db-pre', length=24, chars=['ascii_letters', 'digits']) }}"
Las decisiones del playbook.
- El orden. Las jugadas se ejecutan en orden, y los handlers al final de cada una: PostgreSQL ya escucha en la red cuando arranca la API, que crea su esquema al conectarse.
- Quién ejecuta las tareas de la base.
become: trueejecuta como root; las tareas de la base, además, como el usuariopostgres(become_user), que es el que puede entrar sin contraseña. El paqueteacles lo que Ansible necesita para cambiar a un usuario sin privilegios. - La contraseña. El
lookupdepasswordla genera la primera vez, la guarda enansible/secretos/db-prey la lee de ahí en las pasadas siguientes, así que es siempre la misma y nunca entra en Git. Si ese fichero se pierde, la pasada siguiente genera otra y cambia la contraseña de la base, así que quien ejecute el playbook desde otra máquina tiene que reconstruirlo antes a partir del.envdeapp01.no_log: trueevita que la contraseña salga por pantalla. - El
.env. Lleva las cuatro variables con las que la API encuentra su base (si el.envdeapp01en dev tiene alguna más, se añade aquí con el mismo nombre) y una quinta,APP_IMAGE, que el compose depreusa en su líneaimage:.
La imagen, aparte. La imagen del servicio no la lleva el playbook. Como el laboratorio todavía no tiene registry, llega a pre desde app01 de dev por una tubería, docker save en un lado y docker load en el otro, y el playbook la encuentra ya cargada. Qué imagen arranca lo decide app_image: para desplegar otra versión basta con cargarla y ejecutar el playbook con -e app_image=....
Ejecutarlo. ansible-playbook -i inventory.ini site.yml. La primera vez casi todo sale changed; la segunda todo ok y el resumen final tiene changed=0 en cada host. Si en la segunda pasada algo sigue en changed, esa tarea no es idempotente y hay que arreglarla: casi siempre es un command o shell sin creates: o changed_when:.
Módulos idempotentes y handlers
Por qué la segunda pasada no cambia nada. Cada módulo compara el estado pedido con el real antes de tocar nada: apt consulta dpkg, copy compara el hash del fichero, service pregunta a systemd, user lee /etc/passwd. Si ya está como se pide, no hace nada y lo informa como ok. command y shell no pueden saber nada de eso, así que siempre informan changed; se usan solo cuando no hay módulo, con creates: /ruta (no ejecutar si existe) o changed_when: false (es una consulta).
Handlers: reiniciar solo si hace falta. Los handlers son tareas que solo se ejecutan si alguna tarea con notify ha cambiado algo, y una sola vez al final de la jugada aunque las notifiquen cinco tareas. Es lo que hace que un cambio en postgresql.conf reinicie PostgreSQL una vez, y que una pasada sin cambios no reinicie nada.
Nombres completos y colecciones. Los nombres completos de los módulos (ansible.builtin.apt en lugar de apt) son obligatorios para ansible-lint y evitan ambigüedades con colecciones instaladas. Las colecciones que no vienen con ansible-core las trae el paquete ansible de Debian; con pipx se instalan con ansible-galaxy collection install community.docker o, mejor, con un requirements.yml en el repositorio.
Roles, variables y group_vars
Cuando el playbook crece. Cuando el playbook pasa de veinte tareas, se parte en roles: directorios con estructura fija que Ansible carga solo, y que se pueden reutilizar en otros playbooks. ansible-galaxy role init roles/docker crea el esqueleto:
roles/docker/
tasks/main.yml # las tareas
handlers/main.yml # los handlers
defaults/main.yml # variables con la prioridad más baja (el usuario las sobreescribe)
vars/main.yml # variables internas del rol
templates/ # ficheros Jinja2 (.j2), plantillas con variables, para el módulo template
files/ # ficheros que se copian tal cual
meta/main.yml # dependencias de otros roles
Y site.yml queda en - hosts: app, roles: [docker, app_compose]. En la práctica evaluable el playbook puede ir con roles o sin ellos; partirlo es el «Si te sobra tiempo» de la A5.5.
Dónde van las variables y cuál gana. Las variables por grupo van en group_vars/app.yml y group_vars/db.yml, y las de todos en group_vars/all.yml; por host, en host_vars/db01.yml. Si la misma variable está en dos sitios, gana la de más precedencia, que va de defaults del rol (la más baja) a -e en la línea de comandos (la más alta), pasando por group_vars, host_vars y vars del play. Por eso un -e app_image=... manda sobre el valor de group_vars/all.yml. Cuando una variable no toma el valor esperado, ansible-inventory --host db01 muestra lo que Ansible ha resuelto para ese host.
Ansible Vault
El problema. Las contraseñas de la base de datos o las claves del registro de contenedores no pueden ir en claro en group_vars. El playbook del curso lo evita generando la contraseña fuera del repositorio; cuando un secreto sí tiene que viajar con el código, Ansible Vault cifra ficheros o valores sueltos con AES-256 y una contraseña:
ansible-vault create group_vars/db/vault.yml # abre el editor, guarda cifrado
ansible-vault encrypt_string 'S3cr3t0' --name 'db_password' # un solo valor, para pegar en YAML
ansible-playbook site.yml --ask-vault-pass # o --vault-password-file ~/.vault_pass
Qué se sube y qué no. El fichero cifrado sí se sube a Git (empieza por $ANSIBLE_VAULT;1.1;AES256 y gitleaks lo reconoce como cifrado). La contraseña del vault se pasa por entorno o por fichero fuera del repositorio; en un pipeline la inyecta el orquestador como credencial.
ansible-lint, --check y --diff
Revisar antes de ejecutar. ansible-lint (el paquete ansible-lint de Debian) revisa sintaxis, nombres completos de módulos, tareas sin name, permisos sin especificar en copy, y tiene un perfil production más exigente. Va en el pipeline junto a tofu validate, y la hoja A5.5 lo pasa en su último paso.
Ensayar sin tocar. ansible-playbook --check ejecuta en modo simulación: cada módulo dice qué cambiaría sin cambiarlo (los que no lo soportan se saltan), y --diff muestra el diff de cada fichero que copy, template o lineinfile van a tocar. --check --diff juntos son el equivalente al tofu plan de Ansible, y --limit db01 restringe a un host durante la depuración.
A5.5 Ansible (sesión 25)
Objetivo PostgreSQL corre en db01 y el servicio del curso en app01 de pre, desplegados por un playbook cuyo inventario sale de tofu output, y la segunda pasada termina con changed=0. Con eso pre deja de ser tres máquinas vacías y pasa a ser el servicio, desplegado desde el repositorio.
Antes de empezar Las VM de envs/pre levantadas y accesibles por SSH desde el puesto de administración, con las credenciales de la cuenta tofu de MinIO exportadas como en el paso 3 de la A5.4, porque gen-inventory.sh lee el estado remoto. Entra hoy en el puesto con ssh -A ops@<IP de aula de admin01>: el -A le presta la clave de tu puesto para llegar a app01 de dev (10.10.2.10), de donde salen el compose del servicio y su imagen. Se han explicado inventario, playbooks y módulos idempotentes, el inventario generado desde los outputs y el playbook del curso.
Pasos
Vas de fuera adentro: primero a qué máquinas (el inventario, sacado del estado), después qué se les hace (el compose, el playbook y sus variables), luego lo que el playbook da por hecho y no hace él (Docker y la imagen en app01) y al final el despliegue, la segunda pasada que demuestra la idempotencia y la revisión con ansible-lint.
-
Saca el inventario del estado. Instala Ansible, ansible-lint y
jqcon los paquetes de Debian (Ansible core 2.18 o superior), generaansible/inventory.inicon elgen-inventory.shde Inventario generado desde los outputs de OpenTofu, copiado a la raíz del repositorio, y comprueba que los tres hosts responden al móduloping. Si responden, Ansible entra por SSH y encuentra Python en las tres, y todo lo que sigue tiene por dónde llegar.Pista: el script escribe en
ansible/y no crea la carpeta. Lo que añadas a[all:vars]va en el script y no eninventory.ini, que se regenera en cada ejecución. -
Prepara lo que el playbook va a desplegar. Prepara
ansible/: enfiles/compose.yml, el compose que corre enapp01de dev (/opt/servicio/compose.yml, solo con el servicioappdesde noviembre), sin bloquebuild:y conimage: ${APP_IMAGE}, porque enpreno se construye nada: la imagen llega hecha y el.envdice cuál;site.ymlygroup_vars/all.yml, los de Comandos ad hoc y playbooks, con la etiqueta de la imagen deapp01de dev enapp_image. Añadeansible/secretos/al.gitignoreantes de la primera ejecución: ahí deja el playbook la contraseña de la base, y la crea la primera vez que se ejecuta. -
Lleva Docker y la imagen a app01 de pre. Docker, con el comando ad hoc del apartado; la imagen, desde
app01de dev, con la etiqueta deapp_imagey sin pasar por ningún registry. Va antes del playbook porque el playbook levanta el servicio con una imagen que tiene que estar ya cargada, y para cargarla hace falta Docker.Pista: es una tubería entre dos
sshlanzada desde el puesto:ssh ops@10.10.2.10 docker save app:<versión> | ssh ops@10.20.2.10 sudo docker load. -
Despliega el servicio. Ejecuta el playbook, guarda la salida y comprueba que el servicio corre en
app01de pre y responde enhttp://10.20.2.10:28080/health. La salida de esta primera pasada es la que compararás con la del paso siguiente. -
Demuestra que es idempotente. Ejecútalo otra vez y guarda la salida completa: el resumen tiene que llevar
changed=0enapp01y endb01. Es lo que permite volver a lanzarlo sin miedo, y lo que comprueba eltest.shde la A5.6 cada vez que se ejecuta en modo completo. -
Pasa ansible-lint hasta que salga limpio. Pasa
ansible-lintaansible/site.ymly corrige lo que marque hasta que salga limpio. Es la revisión estática de ansible-lint, que encuentra lo que una ejecución correcta no enseña: tareas sin nombre, permisos sin especificar, módulos sin su nombre completo.
Comprobación La segunda pasada del paso 5 termina en changed=0 unreachable=0 failed=0 para los dos hosts; ansible-lint no devuelve hallazgos; curl http://10.20.2.10:28080/health responde y nc -zv 10.20.3.10 5432 conecta.
Para practicar Deja gen-inventory.sh y ansible/ en iac-lab, sin ansible/secretos/, y las salidas de las dos ejecuciones en ut5/a55/ de entregas-5166. Las VM se quedan levantadas con el servicio: las usan la A5.6 y Mantenimiento, que lo actualiza el 11 de febrero.
Si te sobra tiempo Cambia una línea de files/compose.yml (por ejemplo una etiqueta), ejecuta de nuevo y comprueba que solo cambia Copiar el fichero compose y que el handler reinicia el servicio. Después parte la segunda jugada en dos roles con ansible-galaxy role init roles/docker y roles/app_compose, y mueve app_dir a group_vars/app.yml.
Sesión 26 · Pruebas del despliegue
Al terminar la A5.5, pre funciona, y lo dicen un curl y un resumen con changed=0 que ha mirado una persona. Eso no basta para lo que viene. La práctica evaluable pide demostrar que el despliegue funciona y que las máquinas son como se pidieron. Además, desde el 26 de febrero quien despliega en pre es un pipeline, el de integración continua de la UT6, y un pipeline no lee salidas: solo distingue un 0 de cualquier otro número.
Esta sesión convierte el despliegue en algo que se puede afirmar o negar con un código de salida: un test.sh que aplica, configura, lanza smoke tests, compara la máquina con los requisitos y comprueba la idempotencia, y que con SOLO_PRUEBAS=1 se limita a probar lo que hay. La teoría empieza por los niveles de prueba del IaC, del más barato al más caro, para situar qué cubre el script y qué no, y sigue con el script parte a parte. La hoja A5.6 lo pone en marcha y lo rompe dos veces a propósito, para ver que falla y que, al fallar, nombra la causa correcta.
Pruebas del despliegue
El problema. Un despliegue que no se prueba no está terminado: OpenTofu puede acabar sin error con una VM que no arranca, y Ansible puede decir ok con un servicio que no responde, porque cada herramienta solo responde de su parte. Aquí se monta la cadena que va del apply a un código de salida 0 o distinto de 0.
flowchart TB
T["<b>tofu apply</b>"]:::act
O["<b>tofu output -json</b>"]:::dato
I["<b>gen-inventory.sh</b><br><small>del estado al inventario</small>"]:::act
A["<b>ansible-playbook site.yml</b>"]:::act
S["<b>Smoke tests</b><br><small>curl, nc</small>"]:::pieza
C["<b>Chequeo de configuración</b><br><small>vCPU y RAM</small>"]:::pieza
R{"<b>¿exit 0?</b>"}:::dato
OK(["<b>Despliegue válido</b>"]):::ok
KO(["<b>Fallo: revisar y repetir</b>"]):::riesgo
T --> O --> I --> A --> S --> C --> R
R -- sí --> OK
R -- no --> KO
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxEl inventario sale del estado, no se escribe a mano: así no hay forma de que Ansible configure una máquina que ya no existe.
Probar por niveles. Probar infraestructura es probar por niveles, del más barato al más caro. Cada nivel atrapa un tipo de error distinto y ninguno sustituye a los demás. En el nivel de servicio aparece la prueba de humo (smoke test): la comprobación mínima y rápida de que lo esencial responde, sin entrar en detalle; si falla, no tiene sentido seguir probando nada más.
| Nivel | Qué se prueba | Cómo | Cuándo |
|---|---|---|---|
| Estático | Sintaxis, formato, buenas prácticas | tofu fmt -check, tofu validate, ansible-lint, checkov |
En cada commit, en segundos, sin credenciales |
| Plan | Que el plan sea el esperado y nada se destruya por sorpresa | Leer tofu plan; tofu plan -detailed-exitcode en CI (0 sin cambios, 2 con cambios, 1 error) |
Antes de cada apply |
| Unitario | Que un módulo produce los recursos que debe con unas entradas dadas | tofu test para módulos y Molecule para roles de Ansible; en el curso no se piden, y cómo son está en Para ampliar |
Al cambiar el módulo o el rol |
| Servicio | Que lo desplegado funciona de verdad | Smoke test: curl -f http://10.20.2.10:28080/health contra lo que el playbook ha desplegado, nc -zv a los puertos que deben escuchar |
Después de cada apply |
| Configuración | Que la máquina es como se pidió | ansible -m setup y comparar ansible_processor_vcpus, ansible_memtotal_mb, tamaño de disco con los requisitos |
Después de cada apply |
| Idempotencia | Segunda ejecución sin cambios | tofu plan = "No changes"; ansible-playbook con changed=0 |
Después de cada apply |
Dónde está cada nivel en la unidad. El estático ya se ha usado (tofu validate desde la A5.2, ansible-lint en la A5.5); el de plan es la lectura de la A5.3; el unitario queda para ampliar, y los tres últimos son los que encadena test.sh. El estático se amplía en la sesión siguiente, el 22 de enero, con escáneres de seguridad como checkov.
test.sh
Qué encadena. El script que pide la actividad A5.6 y la práctica encadena los niveles Servicio, Configuración e Idempotencia, precedidos del despliegue. Lo importante es la disciplina de set -euo pipefail (para en el primer comando que falle, en variables sin definir y en tuberías rotas) y que cada comprobación salga con un mensaje claro: la función fail escribe la causa y termina con código 1, así que el código de salida dice si falla y el mensaje dice por qué:
#!/usr/bin/env bash
# test.sh: despliega pre y comprueba que está como se pidió.
# SOLO_PRUEBAS=1 ./test.sh pre se salta el despliegue y la idempotencia.
set -euo pipefail
ENV="${1:-pre}"
cd "$(dirname "$0")"
fail() { echo "FALLO: $*" >&2; exit 1; }
if [ -z "${SOLO_PRUEBAS:-}" ]; then
echo "== Despliegue"
( cd "envs/$ENV" && tofu apply -auto-approve -input=false )
./gen-inventory.sh
ansible-playbook -i ansible/inventory.ini ansible/site.yml
fi
echo "== Smoke tests"
for h in 10.20.1.10 10.20.2.10 10.20.3.10; do
nc -zv -w 3 "$h" 22 || fail "la VM $h no responde por SSH"
done
nc -zv -w 3 10.20.3.10 5432 || fail "PostgreSQL no escucha en db01"
curl -fsS --max-time 5 http://10.20.2.10:28080/health >/dev/null || fail "el servicio no responde en /health"
echo "== Configuración contra requisitos"
vcpus=$(ansible -i ansible/inventory.ini db01 -m setup -a 'filter=ansible_processor_vcpus' \
| grep -o '"ansible_processor_vcpus": [0-9]*' | grep -o '[0-9]*$')
[ "$vcpus" -ge 2 ] || fail "db01 tiene $vcpus vCPU, se pedían 2"
mem=$(ansible -i ansible/inventory.ini db01 -m setup -a 'filter=ansible_memtotal_mb' \
| grep -o '"ansible_memtotal_mb": [0-9]*' | grep -o '[0-9]*$')
[ "$mem" -ge 900 ] || fail "db01 tiene $mem MB, se pedían 1024"
if [ -z "${SOLO_PRUEBAS:-}" ]; then
echo "== Idempotencia"
( cd "envs/$ENV" && tofu plan -detailed-exitcode -input=false >/dev/null ) || fail "el plan no está limpio"
ansible-playbook -i ansible/inventory.ini ansible/site.yml > /tmp/segunda.log
if grep -q 'changed=[1-9]' /tmp/segunda.log; then
fail "la segunda pasada de Ansible ha cambiado algo"
fi
fi
echo "OK: despliegue $ENV válido"
Las decisiones del script.
- Los smoke tests prueban lo que de verdad hay en
pre, ni más ni menos: el servicio del curso enapp01, que es lo que la API contesta en/health, y PostgreSQL endb01, que tiene que escuchar en el 5432. Deweb01, que enprese queda como clon limpio de la plantilla, se comprueba lo quetofu applypromete: que la máquina existe, ha arrancado y admite SSH. Si algún día el playbook configura también un nginx enweb01, su comprobación se añade aquí, y no al revés: un smoke test contra algo que nadie despliega falla siempre y acaba enseñando a ignorar los fallos. Las IP son las depre, el único entorno que se despliega desde código. - La configuración se mira desde dentro. Las vCPU y la memoria salen de los facts de
setup, que es lo que la máquina ve de sí misma, y no del tfvars: así se detecta una VM que no tiene lo que el código dice. El umbral de memoria es 900 y no 1024 porque el kernel reserva parte yansible_memtotal_mbdevuelve lo que ve el SO. - La idempotencia se mira en las dos herramientas.
tofu plan -detailed-exitcodedevuelve 0 si no hay nada que hacer y 2 si lo hay, y el script lo trata como fallo. La segunda pasada de Ansible se da por buena solo si ningún host tienechangeddistinto de 0: buscarchanged=0no basta, porque lo encontraría en un host aunque el otro hubiera cambiado algo. SOLO_PRUEBAS=1existe por una razón práctica: el playbook repara lo que encuentra roto. Si alguien para el servicio y se lanza el script completo, el playbook lo vuelve a levantar antes de los smoke tests y el script daOK. Para ver que las pruebas detectan un servicio caído hay que saltarse el despliegue. Por eso la A5.6 rompe dos cosas, una en cada modo.
A5.6 Pruebas del despliegue (sesión 26)
Objetivo Un test.sh que despliega, configura y comprueba el entorno pre, y que devuelve 0 cuando todo está bien y distinto de 0 cuando algo falla, demostrado con las dos salidas. Es el criterio c de la práctica evaluable.
Antes de empezar El repositorio tal como quedó en A5.5 (envs, playbook, gen-inventory.sh) con el servicio corriendo en pre. En el puesto de administración, TF_VAR_pve_token y las credenciales de la cuenta tofu de MinIO exportadas (AWS_ACCESS_KEY_ID y AWS_SECRET_ACCESS_KEY, como en la A5.4), y curl y nc (paquete netcat-openbsd) instalados. Se han explicado los niveles de prueba y el script test.sh.
Pasos
Primero instalas el script y lo ves pasar con todo en orden, que es la referencia. Después lo rompes dos veces, cada vez en un nivel distinto y en el modo que le corresponde: la configuración, en modo completo, porque el fallo está en el código y hay que aplicarlo para que exista; el servicio, con SOLO_PRUEBAS=1, porque en modo completo el playbook lo repararía antes de probarlo. Al final lo pasas completo una vez más para dejar pre como estaba.
-
Instala el script con tus requisitos. Copia a la raíz del repositorio el test.sh del apartado, con los smoke tests tal cual, y ajusta los umbrales de «Configuración contra requisitos» a las vCPU y los MB de
db01de tu tfvars, si no son 2 y 1024. Los umbrales son tus requisitos convertidos en comprobación: si no coinciden con el tfvars, el script aprobaría o fallaría por una razón equivocada. -
Comprueba que pasa con todo en orden. Pasa
./test.sh precon todo en orden y guarda la salida completa y el código de salida. Es la referencia con la que vas a comparar los dos fallos siguientes. -
Rompe la configuración. Baja a 1 los
coresdedb01enenvs/pre/terraform.tfvars, pasa el script completo y guarda la salida y el código de salida. El script aplica el cambio, así que la VM se queda de verdad con una vCPU, y es la comprobación de configuración la que tiene que detectarlo. -
Rompe el servicio sin dejar que el playbook lo arregle. Devuelve a 2 los
coresdedb01en el tfvars, sin aplicar, y rompe ahora el servicio: paraappenapp01de pre y pasa el script conSOLO_PRUEBAS=1. Guarda la salida y el código de salida. En modo completo, el playbook levantaría el servicio antes de los smoke tests y el script daríaOK. -
Déjalo todo en verde. Pasa
./test.sh precompleto una última vez, para que devuelva la vCPU adb01, vuelva a levantar el servicio y quede en verde, que es como tiene que quedarsepre.
Comprobación Las ejecuciones de los pasos 2 y 5 terminan con OK: despliegue pre válido y $? igual a 0. Las de los pasos 3 y 4 terminan con una línea FALLO: ... que nombra la causa correcta (vCPU de db01, servicio sin responder en /health) y $? distinto de 0. Ninguna ejecución se queda colgada: si curl o nc tardan, revisa los --max-time y -w.
Para practicar Deja test.sh en iac-lab y, en ut5/a56/ de entregas-5166, las tres salidas (correcta, vCPU baja, servicio parado) con su código de salida.
Si te sobra tiempo Añade una comprobación de disco (ansible_devices en -m setup) o escribe un tests/vm.tftest.hcl para modules/vm con command = plan, como el de Para ampliar.
Sesión 27 · Escaneo de seguridad
Después de la A5.6 el repositorio despliega pre y lo demuestra con un código de salida, pero esas pruebas miran si funciona, no si es seguro: un token escrito en un fichero, un puerto abierto a cualquiera o una versión sin fijar pasan todas las pruebas de test.sh. Esos fallos están en el código antes de estar en la máquina, y se buscan leyendo el código con herramientas que conocen los errores típicos: los escáneres. La teoría empieza por los errores que más se repiten en infraestructura como código, sigue con los tres escáneres del curso y cómo decide cada uno qué es un hallazgo, y termina con cómo se lee un hallazgo y cómo se acepta uno con su justificación. La hoja A5.7 solo diagnostica: pasa los escáneres, comprueba qué son capaces de ver y deja la lista completa de hallazgos tabulada por severidad, con la corrección prevista de cada uno. Corregirlos es el trabajo de la sesión siguiente, el 27 de enero, que es también cuando se ve a fondo qué hacer con lo que encuentra gitleaks.
Seguridad del IaC
Por qué el código de infraestructura es especial. En el código de una aplicación, un fallo suele quedarse en un error de funcionamiento; en el de infraestructura es una VM con SSH abierto a todo Internet o un token de administrador publicado en GitHub, y se repite en cada entorno que sale del mismo código. Los errores que más se repiten:
- Secretos en claro (tokens de API, contraseñas de BD) en tfvars, en
group_varso en el propio HCL, subidos a Git. Una vez en el historial, están ahí aunque se borren en el siguiente commit. - Puertos abiertos a
0.0.0.0/0, usuarios con permisos de administrador donde bastabaPVEVMUser, discos y buckets sin cifrar. - Versiones de provider y de módulos sin fijar, imágenes base sin actualizar desde hace un año.
- Estado de Terraform en el repositorio, con todo lo anterior dentro.
Por qué un escáner. Son errores con forma reconocible: una línea con 0.0.0.0/0, un recurso sin cifrado, un valor con aspecto de token. Un programa los busca en segundos en cada commit, siempre con el mismo criterio, que es justo lo que una revisión a ojo no garantiza.
Escáneres
Tres herramientas, cada una con su foco. En el laboratorio se pasan las tres:
| Herramienta | Qué revisa | Instalación | Comando |
|---|---|---|---|
| checkov | Terraform, Ansible, Docker, Kubernetes, Helm, con cientos de reglas de configuración | pipx install checkov |
checkov -d . |
| trivy config | Misma familia de reglas, en el mismo programa que el escáner de imágenes trivy image |
ya está en el puesto de administración | trivy config . |
| gitleaks | Secretos en el árbol de trabajo y en todo el historial de Git, por patrones y entropía | sudo apt install gitleaks |
gitleaks detect -v (o gitleaks git en versiones recientes) |
Repaso: Trivy
Trivy se explica a fondo en la sesión 25 de Mantenimiento (21 de enero), y su A4.6 lo instala en el puesto de administración. Aquí solo cambia el modo: trivy image busca vulnerabilidades conocidas en los paquetes de una imagen; trivy config lee ficheros de configuración (HCL, YAML de Ansible, Dockerfile) y avisa de malas prácticas con su propio catálogo de reglas, sin consultar la base de vulnerabilidades.
Cómo decide cada uno. checkov y trivy config llevan un catálogo de reglas: cada regla describe una mala configuración concreta (un puerto abierto al mundo, una versión sin fijar), tiene un identificador y una severidad, y el escáner busca en el código los recursos que la cumplen. gitleaks busca secretos de dos formas: con una expresión regular por cada formato conocido (los tokens de GitHub, las claves de AWS) y con una regla genérica que busca palabras como token o password seguidas de una cadena con aspecto aleatorio, lo que mide con la entropía (cuanto más impredecible es una cadena, más entropía tiene). De ahí sale su límite: cada escáner ve lo que alguna de sus reglas describe, y nada más. Por eso la A5.7 no se queda con un «sin hallazgos» y comprueba con fallos puestos a propósito qué ve de verdad cada herramienta.
Por qué tres. En mucha documentación aparece un cuarto, tfsec, específico de Terraform: el proyecto está archivado y sus reglas se integraron en trivy, así que no hace falta pasarlo. checkov y trivy se solapan bastante; se pasan los dos porque las reglas no son idénticas y porque en una empresa pedirán uno u otro. gitleaks es de otra categoría: no mira la calidad del código, mira si se ha filtrado algo, y es el único que revisa commits antiguos. Hoy solo se ejecuta.
Cómo leer un hallazgo y cómo suprimirlo
Las partes de un hallazgo. Un hallazgo de checkov tiene este aspecto:
Check: CKV_TF_1: "Ensure Terraform module sources use a commit hash"
FAILED for resource: module.vm
File: /envs/dev/main.tf:12-18
Guide: https://docs.prismacloud.io/...
Id de la regla, qué comprueba, recurso y fichero con líneas, y un enlace con la explicación. La severidad (baja, media, alta o crítica) la da trivy en cada hallazgo; checkov solo la muestra con una cuenta en la plataforma de su fabricante, y sin ella se toma la de la regla equivalente de trivy.
Corregir o aceptar, por escrito. Cada hallazgo se trata como una incidencia: se corrige, o se documenta por escrito por qué se acepta el riesgo. La supresión va en el código, junto al recurso, con la justificación en la misma línea para que quien lea el fichero la vea:
resource "proxmox_virtual_environment_vm" "vm" {
#checkov:skip=CKV_TF_1: módulo local del mismo repositorio, no aplica el hash
#trivy:ignore:AVD-XXX-0001 laboratorio sin TLS válido; en pro el endpoint tiene certificado
...
}
Una supresión sin justificación no vale; en la práctica evaluable cuenta como hallazgo sin corregir. Los hallazgos de gitleaks tienen su propio tratamiento, el de Cuando gitleaks encuentra algo, que se aplica en la sesión siguiente.
A5.7 Escaneo de seguridad (sesión 27)
Objetivo Tabla completa de hallazgos de checkov, trivy y gitleaks sobre el repositorio, cada uno clasificado, con su riesgo escrito y con la corrección prevista lista para aplicarla en la A5.8. Es el «antes» del informe de seguridad de la práctica evaluable y el plan de trabajo de la sesión siguiente.
Antes de empezar El repositorio de A5.6 con todo en commit. Se han explicado los escáneres y cómo leer y suprimir un hallazgo.
Pasos
Primero dejas que los escáneres hablen, cada uno en su fichero, sin interpretar nada. Después pones orden (cuántos hallazgos, de qué severidad y de qué tipo), lees a fondo los más graves para entender qué riesgo hay detrás y comparas las dos herramientas que se solapan. Antes de convertirlo todo en un plan, compruebas con fallos puestos a propósito qué ven de verdad, porque si una herramienta no ve un tipo de fallo, su informe limpio no dice nada sobre ese fallo.
-
Pasa los tres escáneres y guarda lo que dicen. Instala checkov y gitleaks en el puesto de administración y pasa los tres escáneres desde la raíz del repositorio, cada uno a su fichero:
informe/antes-checkov.txt,informe/antes-trivy.txteinforme/antes-gitleaks.txt. Son el «antes» del informe de seguridad, y se quedan como están. Trivy ya está en el puesto: lo instaló la A4.6 de Mantenimiento, el 21 de enero.Pista: checkov se instala con
pipx; si luego la terminal no lo encuentra,pipx ensurepathy vuelve a entrar. La orden de cada escáner está en Escáneres. -
Pon orden en los hallazgos. Cuenta los hallazgos de cada herramienta por severidad y reparte los altos y críticos entre las cuatro categorías de Seguridad del IaC, más una tuya, con nombre, si alguno no encaja. Agrupados se ve qué tipo de error domina en tu repositorio.
Pista: checkov sin cuenta en su plataforma no da la severidad: usa la de la regla equivalente de trivy, o media si trivy no la tiene.
-
Entiende los tres más graves. De los tres hallazgos más graves (o de todos, si hay menos), lee el enlace
Guidey escribe con tus palabras qué comprueba la regla y, en una frase tuya, qué podría pasar en este laboratorio si no se corrige. Esa frase es la columna de riesgo de la tabla del paso 6. -
Compara checkov y trivy. Con un hallazgo que vean checkov y trivy y otro que vea solo uno de los dos, escribe en dos líneas si en una empresa te quedarías con las dos herramientas o con una, y por qué.
-
Comprueba qué ven de verdad los escáneres. Sin hacer commit, mete en ficheros que ya estén en Git dos fallos:
mode: "0777"en una tareacopydel playbook y, en un.tf, un token falso con el formato de Proxmox (terraform@pve!tofu=y un uuid inventado). Pasa otra vez las tres herramientas, apunta qué herramienta ve cada fallo y si alguno no lo ve ninguna, y deja el árbol de trabajo limpio. Un fallo que no ve ninguna dice qué no puede garantizar el informe.Pista: para que gitleaks mire el árbol de trabajo y no el historial,
gitleaks detect --no-git(ogitleaks dir ., según la versión). -
Convierte los hallazgos en un plan de trabajo. Escribe
informe/hallazgos.mdcon una fila por hallazgo alto o crítico y estas columnas: id, severidad, fichero y línea, descripción, categoría (la del paso 2), riesgo en una frase (el del paso 3 en los que leíste a fondo), decisión (corregir o aceptar) y corrección prevista: qué fichero, qué línea y qué pondrás en ella o, si lo aceptas, la línea de supresión completa con el motivo ya redactado. No apliques nada todavía: eso es la A5.8.
Comprobación La tabla cubre todos los hallazgos de severidad alta o crítica de los tres informes y ninguna fila tiene la columna de corrección prevista vacía. Para cada fallo del paso 5 está anotado qué herramienta lo ve, o que no lo ve ninguna, y git status vuelve a estar limpio.
Para practicar Deja en informe/ de iac-lab los tres antes-*.txt, hallazgos.md y tus notas de los pasos 4 y 5. La columna de corrección prevista es tu plan de trabajo en la A5.8 y el arranque del punto 5 de la práctica evaluable.
Si te sobra tiempo Pasa checkov --compact --framework ansible -d ansible/ y compara el recuento con el de la pasada general del paso 1. Mira si .terraform.lock.hcl está en el repositorio y qué versiones del provider fija por hash.
Sesión 28 · Corrección de hallazgos
La A5.7 dejó una tabla con una corrección prevista para cada hallazgo, y casi todas se aplican editando la línea que dice. Los secretos no: si un token llegó a un commit, borrarlo del fichero no lo saca del historial, y cualquier clon del repositorio lo conserva. Y aunque hoy quede todo limpio, nada impide que el próximo commit vuelva a meter uno. La teoría responde a esas tres cosas en orden: dónde puede vivir un secreto sin entrar en el repositorio, qué se hace cuando uno se ha escapado (incluido enseñar a gitleaks a reconocer el token de Proxmox, para el que no trae regla propia) y cómo se bloquea un commit con un secreto antes de que exista, con el .gitignore y pre-commit. La hoja A5.8 aplica las correcciones de la A5.7, limpia el historial si hace falta, instala esa barrera, demuestra que funciona y vuelve a escanear. Al acabar, el repositorio pasa checkov, trivy y gitleaks sin hallazgos altos ni críticos sin justificar, el token de Proxmox no está en ningún fichero ni en el historial y pre-commit bloquea un commit que lo contenga.
Secretos, gitleaks y pre-commit
El problema. Git guarda cada versión de cada fichero, y cada clon del repositorio lleva el historial entero. Un secreto que entra en un commit se queda ahí aunque el commit siguiente lo borre, y se copia a cada máquina que clone el repositorio. Por eso con los secretos importa más impedir que entren que saber sacarlos. Este apartado es el de referencia de gitleaks y pre-commit en las dos asignaturas: dónde puede vivir un secreto, qué se hace cuando uno se escapa al repositorio y cómo se impide que vuelva a pasar.
Gestión de secretos
Dónde puede vivir un secreto. Cuatro sitios, del más simple al más serio, y todos se usan:
| Dónde vive el secreto | Qué es | Cuándo se usa | Cómo lo leen OpenTofu y Ansible |
|---|---|---|---|
| Variable de entorno | export TF_VAR_pve_token=... en la sesión, o un .env fuera de Git que se carga con source |
Un puesto de trabajo; no sirve para compartir | TF_VAR_nombre; lookup('ansible.builtin.env', 'NOMBRE') |
| Ansible Vault | Un fichero o un valor cifrado con una contraseña, que sí se sube | Secretos de Ansible en un equipo pequeño | Solo Ansible, con --ask-vault-pass o un fichero de contraseña |
| sops con age | Un YAML o JSON con los valores cifrados campo a campo y las claves legibles, que se sube y se descifra con la clave privada de cada persona | Equipos pequeños que quieren el secreto versionado con el código y sin servidor | Provider carlpett/sops; colección community.sops |
| HashiCorp Vault u OpenBao | Un servidor de secretos con autenticación, políticas, rotación y auditoría (OpenBao es su bifurcación libre, por la misma razón que OpenTofu) | Empresas grandes; montarlo bien es un proyecto en sí | Provider vault; colección community.hashi_vault |
Los del curso. En el laboratorio, el token de Proxmox va en variable de entorno y la contraseña de la base de pre la genera Ansible fuera del repositorio. Cómo se trabaja con sops y age orden a orden está en Para ampliar.
Cuando gitleaks encuentra algo
Dos casos que se tratan distinto. Un falso positivo (un valor de ejemplo, un hash que parece un token) se suprime con un fichero .gitleaksignore con la huella del hallazgo (commit:fichero:regla:línea), y la justificación va al informe como cualquier otra supresión. Un secreto real nunca se suprime: se rota primero (se revoca el token en Proxmox y se crea otro) y, si el repositorio no es público, se reescribe después el historial con git filter-repo (la herramienta que reescribe todos los commits para quitar el fichero o la línea). Si es público, se da por quemado aunque se reescriba.
Por qué en ese orden. Reescribir sin rotar deja el secreto válido en cualquier copia del repositorio que ya exista: en el clon de un compañero, en el workspace de un pipeline. Rotar primero hace que esas copias lleven un secreto que ya no abre nada.
Lo que gitleaks no reconoce, se le enseña. gitleaks no trae una regla propia para los tokens de Proxmox, y su regla genérica no reconoce con fiabilidad el formato usuario@realm!nombre=secreto. Un historial «sin hallazgos» no demuestra entonces que el token no esté. Se le enseña con una regla propia en .gitleaks.toml, en la raíz del repositorio, que gitleaks lee solo (también desde el hook de pre-commit) y que conserva todas las reglas de serie:
# .gitleaks.toml, en la raíz de iac-lab
[extend]
useDefault = true
[[rules]]
id = "proxmox-api-token"
description = "Token de API de Proxmox (usuario@realm!nombre=uuid)"
regex = '''[\w.-]+@[\w.-]+![\w.-]+=[0-9a-f]{8}-[0-9a-f]{4}-[0-9a-f]{4}-[0-9a-f]{4}-[0-9a-f]{12}'''
La expresión pide lo que lleva cualquier token de Proxmox: usuario, @, realm, !, nombre del token, = y un uuid, que es la forma del secreto.
.gitignore y pre-commit
Primera barrera: que el fichero no llegue a Git. El .gitignore mínimo de un repositorio de IaC:
.terraform/
*.tfstate
*.tfstate.*
*.tfplan
plan.bin
# los tfvars de ejemplo sí se suben
*.tfvars
!*.example.tfvars
.env
*.pem
.vault_pass
Los comentarios van en su propia línea: en un .gitignore, un # a mitad de línea forma parte del patrón y lo estropea. En iac-lab la línea *.tfvars no sirve tal cual: los tfvars con valores no sensibles (tamaños, nombres, IP internas) pueden subirse, y en envs/ de hecho deben subirse porque son la definición del entorno. La regla se cambia a **/secrets*.tfvars en ese caso, y los secretos van en ficheros con ese nombre o en variables de entorno.
Segunda barrera: que el commit no llegue a existir. Git ejecuta antes de cada commit el script .git/hooks/pre-commit, si existe, y si termina con error no crea el commit. pre-commit es un programa que gestiona esos hooks: lee la lista de comprobaciones de .pre-commit-config.yaml, descarga cada una en la versión que dice rev y las ejecuta sobre los ficheros que van a entrar en el commit. Así, para que nada de esto dependa de acordarse, los escáneres se ejecutan antes de cada commit:
# .pre-commit-config.yaml
repos:
- repo: https://github.com/antonbabenko/pre-commit-terraform
rev: v1.99.0
hooks:
- id: terraform_fmt
- id: terraform_validate
- id: terraform_checkov
- repo: https://github.com/gitleaks/gitleaks
rev: v8.24.0
hooks:
- id: gitleaks
pipx install pre-commit, pre-commit install en el repositorio, y a partir de ahí un commit con un token dentro no llega a existir. Los hooks no viajan con el repositorio, porque .git/hooks no se versiona: cada clon necesita su pre-commit install, y por eso conviene pasar gitleaks también en el pipeline. Los hooks de pre-commit-terraform llaman al binario terraform por defecto; con PCT_TFPATH=tofu en el entorno usan OpenTofu. Las etiquetas rev de arriba son las de un momento concreto; pre-commit autoupdate las sube.
A5.8 Corrección de hallazgos (sesión 28)
Objetivo El repositorio pasa checkov, trivy y gitleaks sin hallazgos altos ni críticos sin justificar, no tiene secretos en el historial y pre-commit bloquea un commit con un token. Con eso se cierra el informe de seguridad de la práctica evaluable.
Antes de empezar La tabla de hallazgos de A5.7. Se han explicado dónde viven los secretos, qué hacer cuando gitleaks encuentra algo y .gitignore y pre-commit.
Pasos
Vas de lo que ya está decidido a lo que evita que se repita. Primero aplicas las correcciones que la A5.7 dejó escritas. Después te ocupas del único hallazgo que no se arregla editando un fichero, un secreto en el historial, y para buscarlo bien antes enseñas a gitleaks a reconocer el token de Proxmox. Luego pones la barrera de pre-commit y la pruebas con un token falso, y al final vuelves a escanear para tener el «después» del informe.
-
Aplica el plan de la A5.7. Corrige los hallazgos altos y críticos como dice la columna de corrección prevista de la A5.7. Los que aceptes llevan su supresión junto al recurso, con la justificación en la misma línea, y esa justificación también en el informe.
-
Busca el token en el historial y, si está, trátalo como un secreto real. Antes de buscar, añade al repositorio la regla para tokens de Proxmox de Cuando gitleaks encuentra algo: sin ella, un historial limpio no demuestra nada. Si con ella gitleaks encuentra el token en algún commit, trátalo como un secreto real, en el orden del apartado: revócalo, crea otro como en el paso 1 de la A5.1, expórtalo y reescribe el historial, hasta que
gitleaks detectno encuentre nada.Pista: el token nuevo se sigue llamando
tofu, que es el nombre con el que lo usan las dos asignaturas, y su secreto sustituye al anterior en el gestor de contraseñas. -
Pon la barrera antes de cada commit. Instala pre-commit con
pipx, monta en el repositorio el.pre-commit-config.yamlde .gitignore y pre-commit y haz que sus hooks pasen limpios sobre todos los ficheros, no solo sobre los del próximo commit: un hook que falla con lo que ya hay obliga a saltárselo en cada commit, y entonces no protege nada.Pista: los hooks de pre-commit-terraform llaman a
terraformsalvo que exportesPCT_TFPATH=tofu;pre-commit run --all-fileslos pasa sobre todo el repositorio. -
Demuestra que la barrera funciona. Intenta hacer commit de un
prueba.tfcon la líneaapi_token = "terraform@pve!tofu=12345678-1234-1234-1234-123456789abc", captura el rechazo de gitleaks y borra el fichero. Lleva el mismo formato que describe la regla del paso 2. -
Vuelve a escanear para el informe. Vuelve a pasar los tres escáneres a
informe/despues-*.txt. Junto a losantes-*de la A5.7, son la prueba de lo que ha cambiado.
Comprobación Los ficheros despues-* no contienen hallazgos de severidad alta o crítica que no estén en la tabla como aceptados y suprimidos con motivo; gitleaks detect sale sin hallazgos en todo el historial; la captura del paso 4 muestra el commit bloqueado.
Para practicar Deja en iac-lab los informe/despues-*.txt, .pre-commit-config.yaml, .gitleaks.toml y las supresiones en el código, y la captura del paso 4 en ut5/a58/ de entregas-5166. Este informe es el punto 5 de la práctica evaluable.
Si te sobra tiempo Cifra con ansible-vault encrypt_string la contraseña que Ansible guardó en ansible/secretos/db-pre y ponla en group_vars/all.yml en lugar del lookup, o prueba sops con age sobre un secrets.yaml, y comprueba que gitleaks lo da por limpio.
Sesión 29 · Práctica evaluable
La sesión empieza con diez minutos de aclaración del enunciado y el resto es trabajo sobre tu repositorio. Todo lo que se pide lo has construido en las hojas A5.1 a A5.8; aquí lo cierras, lo documentas en el README y lo entregas. Repásalo como lo leería alguien que no ha estado en clase: con el README, esa persona tiene que poder desplegar, probar y destruir sin preguntarte nada. Cada punto de la lista dice de qué hoja sale, para que sepas dónde mirar si algo falta. Ten a mano la lista de errores frecuentes del final de la página. Al entregar no destruyas pre ni borres su estado: Mantenimiento lo actualiza en febrero y lo da de baja en marzo con este mismo repositorio.
Entrega el repositorio iac-lab, publicado en Gitea, con:
README.md: la tabla de requisitos con el origen del dato y las diferencias del laboratorio (de la A5.2, paso 2), y tres apartados cortos: cómo desplegar, cómo probar y cómo destruir.- Código OpenTofu modular:
modules/vmy los entornosdevypreen directorios (de la A5.4, pasos 1 y 5), backend remoto con bloqueo (de la A5.4, pasos 3 y 4), versiones de provider fijadas y sin secretos en ningún fichero ni en el historial (de la A5.8, pasos 1 y 2), y las VM depreconprevent_destroy(de la A5.3, pasos 2 y 3). - Playbook Ansible, con roles o sin ellos, pero con nombres completos de módulo y handlers, que deja PostgreSQL en
db01y el servicio enapp01, e inventario generado desde los outputs (de la A5.5, pasos 1, 4 y 5). test.shcon smoke tests y comprobación de configuración, que devuelve 0 o distinto de 0 (de la A5.6).- Informe de seguridad: hallazgos, correcciones y justificaciones, con el antes y el después de los escáneres (de la A5.7 y la A5.8).
Checklist antes de entregar:
-
tofu fmt -check,tofu validateyansible-lintlimpios (de la A5.5, paso 6, y de la A5.8, paso 3) - Segundo
tofu planconNo changes(de la A5.4, paso 2) y segunda pasada del playbook conchanged=0(de la A5.5, paso 5) -
gitleaks detectsin hallazgos en todo el historial (de la A5.8, paso 2) -
.gitignorecon tfstate,.terraform/yansible/secretos/(de la A5.1, paso 2, y de la A5.5, paso 2) -
test.shprobado fallando y acertando (de la A5.6, pasos 2 a 5)
| Criterio | RA3 | Sale de | Peso |
|---|---|---|---|
| Requisitos recogidos y trasladados a variables | a | A5.2 | 20 % |
| Código de despliegue funcional, modular e idempotente | b | A5.3, A5.4 y A5.5 | 30 % |
| Ejecución con pruebas de servicio y chequeo de configuración | c | A5.6 | 25 % |
| Seguridad verificada: escaneo, correcciones, sin secretos | d | A5.7 y A5.8 | 25 % |
Errores frecuentes en el laboratorio
Error: 401 authentication failureen el primerplan. Proxmox no reconoce el token: el formato no esusuario@realm!nombre=uuid, o el secreto no es el quepveummostró al crearlo. Se comprueba concurl -k -H "Authorization: PVEAPIToken=$TF_VAR_pve_token" https://192.168.1.50:8006/api2/json/version. Si elcurlresponde pero elplano elapplyfallan con403oPermission check failed, el token entra pero no tiene permisos: creado con separación de privilegios y sin ACL propia, o le falta alguno de los tres. Se comprueba en Datacenter > Permissions.Permission check failed (/sdn/zones/lab/devfront, SDN.Use)en elapply. Al usuario le falta el tercer permiso de la A5.1,PVESDNUsersobre/sdn/zones/lab, que es el que deja conectar una VM a una VNet.pveum user permissions terraform@pvelista lo que tiene.Error: x509: certificate signed by unknown authority. El certificado de Proxmox es autofirmado y faltainsecure = trueen el provider (o, mejor en pro, la CA en el sistema).- El apply se queda minutos en
Still creating...y acaba en timeout. Casi siempreagent { enabled = true }con una plantilla que no tieneqemu-guest-agentinstalado: el provider espera a que el agente informe de la IP. Se instala el agente en la plantilla 9000 o se quita el bloque. - La VM arranca pero no tiene la IP que se le dio. cloud-init no ha corrido porque la plantilla no tenía el disco cloud-init (
ide2) o el clon lo ha perdido;qm config 210en el nodo (o el ID de la VM afectada) muestra si existe. Si en cambio tiene IP pero repetida con la de otro clon, la plantilla llegó a arrancar antes de convertirse y los clones comparten su/etc/machine-id(ver la regla "La plantilla no se arranca nunca" de cloud-init). ssharouter-preavisa de que la clave del host ha cambiado después del paso 1 de la A5.3. La tarjeta nueva (--ipconfig5) cambia la configuración de cloud-init de la VM, y cloud-init regenera entonces las claves del host, como le pasó al puesto de administración en la A3.1. No es un ataque: se borra la entrada vieja conssh-keygen -R <IP de aula de router-pre>en la máquina desde la que se entra y se vuelve a entrar.- El
initdeenvs/prefalla porque no encuentra el providerhashicorp/proxmox. Al módulovmle falta surequired_providers: sin él, OpenTofu supone que elproxmoxdel módulo eshashicorp/proxmox, que no existe. Se añade el bloque de Módulos, entornos y estructura del repositorio y se repite elinit. Error acquiring the state locksin que nadie esté aplicando. Un apply anterior murió con el bloqueo puesto (Ctrl+C, portátil cerrado).tofu force-unlock IDcon el ID que muestra el error, tras comprobarlo con el resto del grupo.- El plan falla con
Instance cannot be destroyeddespués de mover el recurso al módulo (sinprevent_destroy, querría destruir y crear las tres VM). Faltatofu state mvo el bloquemoved. No se quita la protección para seguir: son las mismas VM con otra dirección en el estado. Plan: 0 to add, 1 to changecada vez que se ejecuta el plan, sin haber tocado nada. Un atributo que el provider lee distinto de como se escribió (mayúsculas en una MAC, tamaño de disco en G en vez de GB, orden de una lista). Se pone en el código el valor que devuelve el provider, o se añade alifecycle { ignore_changes = [...] }con una justificación.- Ansible:
Permission denied (publickey). La clave que cloud-init instaló no es la que usa el agente SSH local, o el usuario no esops.ssh -v ops@10.20.2.10lo dice;ansible_ssh_private_key_file=~/.ssh/id_ed25519en[all:vars]lo arregla, añadido engen-inventory.shy no en el inventario, que se regenera. - Ansible:
/usr/bin/python3: not found. Imagen mínima sin Python;ansible -m raw -a 'apt-get install -y python3'una vez, o meter el paquete en la plantilla. ssh ops@10.20.x.10se queda sin respuesta desde el puesto de administración. Falta un trozo del camino de gestión apredel paso 1 de la A5.3:ip route get 10.20.1.10en el puesto tiene que salir por la10.10.0.2, y enrouter-preip rtiene que mostrar10.10.0.0/24 dev ens23ynft list rulesetlas tres reglas deforward.- El servicio de
app01enpreno arranca ydocker compose psmuestrapull access denied for app. La imagen no está cargada: se repite la tuberíadocker save | docker loaddel paso 3 de la A5.5 con la etiqueta que diceapp_image(sudo grep APP_IMAGE /opt/servicio/.envenapp01muestra cuál espera). - La segunda pasada del playbook sigue diciendo
changed=1. Una tareacommandsincreatesochanged_when, o uncopyde un fichero que otra tarea modifica después. El módulodebugy--difflocalizan cuál. - gitleaks encuentra el token en un commit de hace tres semanas aunque ya no está en el fichero. Está en el historial. Se rota el token en Proxmox primero y se reescribe el historial después.
- El commit de
prueba.tfdel paso 4 de la A5.8 entra sin rechazo. O falta en la raíz del repositorio el.gitleaks.tomlcon la regla del token de Proxmox, o pre-commit no está instalado en ese clon: sigitleaks detect --no-git(ogitleaks dir .) encuentra el token enprueba.tf, la regla funciona y lo que falta es elpre-commit install. Después se deshace ese commit, si no se ha subido, congit reset --hard HEAD~1: el token es falso, pero el historial no tiene por qué llevarlo.
Los enlaces para ampliar y los apartados que van más allá de lo que se hace en clase están en Para ampliar.
UT6 · Orquestador de integración continua
En la UT5 quedó un repositorio con el que se levanta el servicio del curso de principio a fin: tofu apply crea las máquinas en Proxmox, Ansible las configura y test.sh comprueba que responde. Todo eso se lanzaba a mano desde el puesto de administración, con claves y tokens personales, y solo cuando alguien se acordaba de hacerlo. Esta unidad quita a la persona de en medio: un orquestador de integración continua vigila el repositorio, ejecuta las pruebas, construye la imagen, la sube a un registry y, cuando se le pide, la lleva a pre y la despliega con el mismo playbook de Ansible y el mismo test.sh.
La unidad sigue el orden en que se monta un sistema así, y cada sesión resuelve lo que la anterior deja pendiente. Primero se decide qué se quiere automatizar y con qué herramienta. Después se instala Jenkins de forma que no sea el punto débil del laboratorio, porque va a guardar las credenciales de todo lo demás, y se le dan máquinas donde ejecutar, porque el controlador no ejecuta nada. Con eso se engancha al repositorio para que cada push lo dispare solo, se escribe el pipeline en dos tandas, primero construir y probar y después empaquetar y decidir cuándo, y se prueba por todos los caminos que acaban mal. Lo último es la credencial más delicada, la que entra en pre para desplegar. La práctica evaluable, el 10 de marzo, lo junta todo.
Sesión 30 · CI y elección del orquestador
El test.sh de la UT5 demuestra que un despliegue funciona, pero solo cuando alguien lo lanza, desde su puesto y con sus credenciales. Antes de instalar ningún orquestador hay que resolver dos cosas, y en este orden. La primera, qué se quiere automatizar exactamente: integración, entrega y despliegue continuos no son sinónimos, y un pipeline aporta cosas que un script no tiene; de eso trata el primer apartado. La segunda, con qué herramienta: el segundo compara los cuatro orquestadores más extendidos con los criterios del módulo y cuenta cómo están hechos los dos que se prueban hoy. La hoja ejecuta el mismo hola mundo en Jenkins y en Gitea Actions y termina con una justificación escrita de cuál usar para el servicio del curso.
Integración continua, entrega continua y despliegue continuo
Antes de tocar Jenkins hay que ponerse de acuerdo en las palabras, porque en las ofertas de trabajo y en los blogs se usan como sinónimos y no lo son. Este apartado deja claro qué se automatiza en cada escalón, qué piezas intervienen y qué gana un pipeline frente a un script como test.sh; sin eso, la comparativa del apartado siguiente no se puede leer con criterio.
flowchart LR
PUSH["<b>push</b>"]:::act
B["<b>build + test</b>"]:::pieza
PKG["<b>package</b><br><small>imagen al registry</small>"]:::pieza
DEP["<b>deploy</b>"]:::pieza
CI(["<b>Integración continua</b><br><small>hasta aquí, automático</small>"]):::ok
CD(["<b>Entrega continua</b><br><small>listo para desplegar · alguien pulsa el botón</small>"]):::ok
DC(["<b>Despliegue continuo</b><br><small>nadie pulsa nada</small>"]):::ok
PUSH --> B --> PKG --> DEP
B -.-> CI
PKG -.-> CD
DEP -.-> DC
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxLos tres escalones son el mismo pipeline: lo que cambia es hasta dónde llega sin intervención humana.
El problema que resuelve la integración continua. Cuando cada persona trabaja por su cuenta durante semanas y el código se junta al final, aparecen a la vez los conflictos de todos y nadie sabe qué cambio rompió qué. Integración continua (CI) es lo contrario: integrar el trabajo de todos los desarrolladores varias veces al día en un repositorio común y comprobar automáticamente, en cada integración, que el proyecto se construye, pasa las pruebas y se empaqueta. Si se integra cada pocas horas y una máquina ejecuta las pruebas en cada integración, el error aparece a los diez minutos de haberlo cometido y lo arregla quien lo acaba de escribir. La práctica se generalizó a finales de los años noventa con las metodologías ágiles, y la idea no ha cambiado desde entonces.
Dos escalones más. Sobre esa base se construyen otros dos, y lo que distingue a los tres es quién decide que un cambio llega a producción:
| Escalón | Qué añade | Quién decide el paso a producción |
|---|---|---|
| Integración continua | Build, pruebas y empaquetado automáticos en cada cambio | Nadie despliega todavía |
| Entrega continua (continuous delivery, CD) | El artefacto validado se despliega automáticamente en entornos de prueba y queda listo para producción | Una persona pulsa un botón |
| Despliegue continuo (continuous deployment) | Cada cambio que pasa todas las pruebas llega a producción sin intervención | Nadie; el pipeline entero es la aprobación |
Hasta dónde llega el curso. En el módulo se llega hasta la entrega continua: el pipeline despliega en pre cuando se le pide con un parámetro, y el paso a producción sigue siendo una decisión humana. El despliegue continuo exige una batería de pruebas tan completa y un equipo tan acostumbrado a ella que no se improvisa, y con un solo entorno de pruebas no tendría sentido.
Las piezas
Qué hace falta para montarlo. Un sistema de integración continua tiene cinco piezas, y la unidad monta una o dos por sesión:
- Repositorio Git con el código del servicio y, en el mismo repositorio, la definición del pipeline. Que el pipeline viva con el código importa: se versiona, se revisa en un merge request (la petición de fusionar una rama, pull request en GitHub) y cada rama lleva el suyo. En el curso es
servicio, en la Gitea del laboratorio. - Orquestador (Jenkins, GitLab CI, GitHub Actions, Gitea Actions): recibe el aviso de cambio, decide qué ejecutar, dónde y con qué credenciales, y guarda resultados, logs e informes. El aviso suele ser un webhook: una petición HTTP que el servidor Git manda al orquestador cada vez que pasa algo, por ejemplo un push.
- Agentes o runners: las máquinas o contenedores donde se ejecutan realmente las tareas. El orquestador solo coordina; si ejecutase él mismo las tareas, cualquier
shde cualquier pipeline correría con los permisos del orquestador entero. - Registry de imágenes y almacén de artefactos. El registry es el servidor de imágenes de contenedor, del que se descargan con
docker pully al que se suben condocker push. Ahí queda lo que produce el pipeline (imágenes, paquetes, informes), identificado por el commit que lo generó. - Entornos de destino: el entorno
preque se creó en la UT5.
flowchart TB
DEV["<b>Desarrollador</b>"]:::act
REPO["<b>Repositorio Git</b><br><small>Gitea / GitLab</small>"]:::dato
CTRL["<b>Orquestador</b><br><small>Jenkins controller · reparte, no ejecuta</small>"]:::act
AG1["<b>Agente docker</b><br><small>agent01</small>"]:::pieza
AG2["<b>Agente deploy</b><br><small>agent01</small>"]:::pieza
REG[("<b>Registry</b><br><small>registry.lab:5000</small>")]:::dato
ENV["<b>Entorno pre</b><br><small>VPC de Proxmox</small>"]:::infra
DEV -->|git push| REPO
REPO -->|webhook| CTRL
CTRL -->|asigna tareas| AG1
CTRL -->|asigna tareas| AG2
AG1 -->|push imagen| REG
AG2 -->|imagen + ansible| ENV
CTRL -->|estado, logs, informes| DEV
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxEl círculo se cierra en el desarrollador: lo que hace útil un pipeline no es que despliegue, es que devuelva el resultado a quien escribió el cambio.
Qué aporta un pipeline frente a un script
La pregunta es legítima. El test.sh ya encadena tofu apply, ansible-playbook y un curl, y con un script un poco más largo y un cron se cubriría lo mismo. Se cubriría solo en el camino feliz. Un pipeline es la cadena de etapas que atraviesa cada cambio (checkout, build, test, package, deploy), donde cada etapa produce salidas (artefactos, informes) y puede detener la cadena si falla, y el orquestador le añade lo que un script no tiene:
- Aislamiento por etapa: cada etapa puede correr en un agente distinto, con una imagen distinta, sin heredar el estado de la anterior salvo lo que se le pasa explícitamente.
- Historial: cada ejecución queda numerada, con su commit, su log, quién la lanzó, cuánto tardó y qué produjo. Cuando algo falla en producción, se puede ir a la ejecución #142 y ver qué se probó.
- Estados con significado: un script devuelve 0 o distinto de 0. Un pipeline distingue entre "todo bien", "todo se ejecutó pero hay pruebas rojas", "se rompió a mitad" y "alguien lo canceló", y reacciona distinto en cada caso.
- Credenciales gestionadas: el script tiene el token en una variable de entorno o, peor, en el propio fichero. El orquestador lo guarda cifrado, lo inyecta solo en la etapa que lo necesita y lo enmascara en el log.
- Condiciones y paralelismo: "esto solo en
main", "esto solo si cambióDockerfile", "lint (el análisis estático del código, sin ejecutarlo) y test a la vez". En bash se puede, pero cada condición es unifmás que nadie prueba. - Disparo automático desde el repositorio y límites (tiempo máximo, no concurrencia) que evitan que dos despliegues pisen el mismo entorno.
Para qué en el curso. El pipeline del servicio acaba teniendo todas esas ventajas: la unidad las monta una o dos por sesión, del 10 al 24 de febrero.
Elegir el orquestador
No se elige por costumbre. Jenkins no es la única opción, y en una empresa el orquestador se elige con criterios, porque cambiarlo después obliga a reescribir todos los pipelines. Aquí se comparan los cuatro más extendidos con los criterios que pide el módulo, para poder defender la elección delante de quien pregunte y para reconocer los otros tres al cambiar de empresa.
| Jenkins | GitLab CI | GitHub Actions | Gitea Actions | |
|---|---|---|---|---|
| Instalación | Servidor propio (paquete Java o contenedor) | Incluido en GitLab (autoalojado o SaaS, el servicio alojado por el proveedor) | Servicio de GitHub; runners propios opcionales | Incluido en Gitea desde 1.19; runner act_runner |
| Integración con el entorno | Más de 1800 plugins: Git, Docker, Ansible, cualquier registry | Integrado con su repositorio y su registry; components y templates | Marketplace de acciones | Reutiliza acciones de GitHub (con matices) |
| Registro de ejecuciones | Historial por job con log, archiveArtifacts e informes por plugin |
Log por job, artifacts: e informes JUnit nativos |
Log por job y upload-artifact |
Igual que Actions, con soporte parcial |
| Control de variables y límites | Parámetros, credenciales, throttling, cuotas por agente, timeouts | Variables por proyecto/grupo, límites por runner, timeout, resource_group |
Secretos, concurrencia, matrices, timeout-minutes |
Secretos, concurrencia, matrices |
| Coste de mantenimiento | Alto: actualizaciones del núcleo y de plugins, backups, agentes | Medio: va con GitLab, pero GitLab en sí es pesado | Bajo si es SaaS; medio con runners propios | Bajo |
| Comunidad y documentación | Enorme y veterana; mucho material antiguo que ya no aplica | Muy buena, documentación oficial excelente | La mayor en proyectos abiertos | Pequeña pero creciente |
| Punto fuerte | Flexibilidad, cualquier tecnología, control total | Todo en una herramienta | Sencillez, ecosistema de acciones | Ligero, autoalojado, sintaxis conocida |
| Punto débil | Mantenimiento de plugins, curva de entrada | Ligado a GitLab | Menos control fino; coste de minutos en SaaS | Menos maduro, menos control fino |
Los nombres de fichero, el modelo de runners y la forma de guardar secretos de cada uno están en Para ampliar, por si hay que reconocerlos al cambiar de herramienta.
Los criterios. Los de selección del módulo (CE 4a) son cuatro: que pueda controlar las variables del pipeline (parámetros, secretos, entorno), aplicar limitaciones (tiempo máximo, concurrencia, agentes permitidos, quién puede lanzar qué), integrarse con las tecnologías del entorno (Git, Docker, Ansible, registry) y registrar cada ejecución con su log y sus artefactos. A esos cuatro criterios técnicos conviene sumar dos de organización, que en una empresa pesan igual: quién lo va a mantener (un Jenkins sin dueño se convierte en un museo de plugins sin parchear) y dónde está el código (con el código ya en GitLab, montar un Jenkins aparte necesita una justificación).
La elección del curso. En el módulo se usa Jenkins por su flexibilidad y porque obliga a entender cada pieza: en GitLab CI el runner, los secretos y el webhook vienen hechos y no se ve cómo funcionan; en Jenkins se montan uno a uno y, cuando fallan, se sabe dónde mirar. Todo lo aprendido se traslada a GitLab CI cambiando la sintaxis; en Para ampliar está el mismo pipeline escrito en .gitlab-ci.yml, como lectura opcional.
Jenkins y Gitea Actions por dentro
Por qué estos dos. Son los dos extremos de la tabla: Jenkins, un servidor aparte que lo hace todo con plugins, y Gitea Actions, integrado en la forja que el laboratorio ya tiene desde noviembre. Montar el mismo hola mundo en los dos enseña más diferencias que cualquier tabla, y es lo que hace la hoja.
Jenkins: un servidor que ejecuta jobs. Jenkins es una aplicación web escrita en Java. Nació en 2011 como continuación libre de Hudson, un servidor de integración continua de mediados de los años 2000, y de esa edad le vienen tanto la comunidad enorme como el material antiguo. Lo que se le pide se da de alta como un job (un proyecto): el de tipo Pipeline lleva dentro, o lee del repositorio, un script que dice qué etapas ejecutar. Casi todo lo que sabe hacer viene de plugins. La primera vez que arranca pide una contraseña inicial de administrador, que deja escrita en un fichero de su directorio de datos, y ofrece instalar los plugins recomendados, porque sin ellos no sabría ni crear un job de tipo Pipeline.
Gitea Actions: el pipeline vive en el repositorio. Gitea Actions reutiliza la sintaxis de GitHub Actions. El pipeline es un workflow: un fichero YAML dentro de .gitea/workflows/ del propio repositorio, que dice con qué eventos se dispara (on: push), qué trabajos tiene (jobs) y, en cada uno, dónde corre (runs-on) y qué pasos ejecuta (steps, cada uno con su run:). Gitea no ejecuta nada: los trabajos los recoge un runner, act_runner, un programa aparte que se registra en Gitea con un token de registro y anuncia unas etiquetas. Cada etiqueta dice dónde se ejecuta un trabajo: debian:docker://debian:13-slim significa que los trabajos con runs-on: debian corren en un contenedor de esa imagen. Por eso el runner necesita acceso al Docker de su máquina.
Qué se compara. El hola mundo deja ver cuatro cosas: dónde se define el pipeline (en el job o en el repositorio), quién lo ejecuta y dónde, cuántos pasos de configuración hacen falta hasta ver el primer echo y qué queda registrado de cada ejecución. Son la materia prima de la tabla de la hoja.
A6.1 Elección del orquestador (sesión 30)
Objetivo Al terminar has ejecutado el mismo «hola mundo» en Jenkins y en Gitea Actions y tienes, escrita con lo que has visto, la justificación de cuál usarías para el servicio del curso. Elegir y justificar el orquestador es el primer criterio de la unidad, y la tabla y la justificación de hoy van tal cual a la práctica evaluable.
Antes de empezar El nodo, la plantilla 9000 y el puesto de administración accesibles, y tu Gitea de mon01 (http://gitea.lab:23001, la de la A2.6 de Mantenimiento) con tu usuario. Se han explicado integración, entrega y despliegue continuos, la comparativa de orquestadores y cómo están hechos Jenkins y Gitea Actions.
Pasos
Primero preparas la máquina que alojará Jenkins el resto del curso. Después montas el mismo hola mundo en los dos orquestadores, cada uno con la instalación mínima que lo hace funcionar, porque hoy interesa ver cómo es cada herramienta por dentro, no protegerla. Al final pasas lo que has visto a una tabla y decides. La comparación solo vale si cada casilla sale de algo que has hecho, así que apunta mientras trabajas.
-
Prepara
jenkins01. Creajenkins01, la VM 101 de la tabla del laboratorio (devmgmt, 10.10.0.10, 2 GB), con Docker y compose, y da de alta en OPNsense sus nombresjenkins.labyjenkins01.lab. Es la máquina de Jenkins para todo el curso: hoy aloja la demo y, desde el 5 de febrero, el Jenkins definitivo.Pista: la IP y el DNS (
--nameserver 10.10.0.1 --searchdomain lab) van en elqm set; los nombres, en Services → Dnsmasq DNS & DHCP → Hosts. Docker, con el script deget.docker.com, como en la A1.3. -
Haz el hola mundo en Jenkins. Levanta en
~/demoun Jenkins de usar y tirar, sin TLS ni roles, con la imagenjenkins/jenkins:lts-jdk21y el 8080 publicado (solo en esta demo). Ábrelo desde tu puesto por un túnel, como los de Nombres DNS y acceso, completa el asistente del primer arranque y crea un job Pipeline que hagaecho 'hola desde Jenkins'. Fíjate en todo lo que te pide antes de dejarte ejecutar nada: es una de las columnas de tu tabla.Pista: la contraseña inicial está en
/var/jenkins_home/secrets/initialAdminPassworddel contenedor, y el desplegable try sample Pipeline del job trae un «Hello World». En tu puesto, el túnel puede escuchar en cualquier puerto libre de la franja del curso; el 8080 suele estar ocupado. -
Haz lo mismo en Gitea Actions. En un repositorio de prueba
hola-cide tu Gitea, con Actions activado, escribe un workflow que haga el mismoecho, y pon su runner en~/runnerdejenkins01. Levanta el runner antes de escribir el workflow, para que baje su imagen mientras tanto.Pista: el runner es
gitea/act_runner:0.2.11con el socket de Docker y las variablesGITEA_INSTANCE_URL,GITEA_RUNNER_REGISTRATION_TOKEN(de la página de runners del repositorio) yGITEA_RUNNER_LABELS(debian:docker://debian:13-slim). El workflow va en.gitea/workflows/conruns-on: debian. -
Compara las dos ejecuciones. Lanza los dos y apunta, del log de cada ejecución, dónde ha corrido, qué tardó y cuántos pasos de configuración hicieron falta hasta ver el
echo. Son los datos en bruto de la tabla del paso siguiente. -
Pásalo a una tabla. Compara Jenkins y Gitea Actions con los criterios de Elegir el orquestador (control de variables, limitaciones, integración, registro, mantenimiento, comunidad), con lo que acabas de ver y la tabla de la teoría.
-
Decide y justifícalo. Escribe en media página cuál usarías para el servicio del curso, apoyándote en las casillas de tu tabla que más pesan para un servicio como este.
Comprobación Las dos ejecuciones en verde con el echo visible en el log, y una tabla donde cada casilla diga algo que hayas comprobado, no copiado.
Para practicar Guarda en A6.1 de entregas-5166 la tabla, la justificación y una captura de la ejecución en cada orquestador.
Si te sobra tiempo Añade una segunda etapa que falle (sh 'exit 1') en los dos y compara cómo lo muestra cada uno.
Sesión 31 · Instalación segura y plugins
El Jenkins de la demo de la A6.1 servía para ver la herramienta, no para trabajar con ella: hablaba HTTP en claro, tenía un único administrador creado a mano, podía ejecutar tareas en su propio proceso y sus plugins eran los que trajo el asistente, sin versión conocida. Y este Jenkins va a guardar las credenciales de Gitea, del registry y de pre, así que será la máquina más atractiva del laboratorio para un atacante. Esta sesión lo instala para quedarse, por capas: dónde corre y quién lo publica, con qué certificado, quién puede hacer qué, qué se le prohíbe al controlador y cómo queda todo escrito en un YAML. Los plugins van en la misma sesión porque son el mismo trabajo visto dos veces: la imagen que se construye para arrancar Jenkins es la que los lleva dentro. Al acabar, la instalación entera (compose, Dockerfile, plugins.txt, YAML de configuración y README) está en el repositorio jenkins-config.
Instalar y asegurar Jenkins
Este apartado deja Jenkins instalado en un contenedor, accesible por HTTPS con un certificado de la CA del curso, con usuarios y roles, y con su configuración en un YAML versionado. El orden importa porque cada capa protege a la siguiente: sin TLS las contraseñas viajan en claro, sin roles cualquiera administra, y sin el YAML nadie sabe reconstruirlo cuando se rompa. El compose.yml, el nginx.conf, los comandos de openssl y el casc/jenkins.yaml están enteros porque la hoja A6.2 los copia.
flowchart TB
NAV["<b>Navegador del puesto</b><br><small>https://jenkins.lab:28443, por el túnel</small>"]:::act
NG["<b>nginx</b><br><small>el único puerto publicado, el 443 · termina TLS</small>"]:::pieza
JK["<b>jenkins</b><br><small>HTTP en el 8080, solo dentro del compose</small>"]:::pieza
CASC["<b>casc/jenkins.yaml</b><br><small>la configuración, en Git</small>"]:::dato
SEC["<b>.env y secrets/</b><br><small>contraseñas y claves, fuera de Git</small>"]:::riesgo
HOME[("<b>jenkins_home</b><br><small>jobs, historial y credenciales cifradas</small>")]:::infra
NAV -->|HTTPS| NG -->|HTTP| JK
CASC --> JK
SEC --> JK
JK --- HOME
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxLo que define a Jenkins está en Git y se puede reconstruir; lo que lo hace único, el volumen y los secretos, se guarda aparte.
Despliegue en contenedor
Qué es Jenkins por dentro. Jenkins es una aplicación Java que escucha en el puerto 8080 por HTTP. La imagen oficial jenkins/jenkins:lts-jdk21 (LTS es la línea de soporte largo, la que se usa en producción; jdk21, que trae Java 21) contiene el controlador, Java y Git, y ni un solo plugin. Todo su estado (configuración, jobs, credenciales cifradas, historial) vive en un directorio, /var/jenkins_home, y ese directorio, guardado en un volumen, es lo único que hay que conservar.
Por qué en contenedor. Por lo mismo que el servicio del curso: la versión queda escrita en un fichero, la instalación se repite idéntica en cualquier máquina con Docker y el estado queda separado del programa, en el volumen. Actualizar Jenkins es cambiar la imagen; volver atrás, volver a la anterior.
Quién termina TLS. En el curso, Jenkins no habla HTTPS: delante va un proxy inverso, nginx, que recibe las conexiones cifradas y se las pasa en HTTP por la red interna del compose. Es el mismo esquema que el nginx de web01 delante de la API en la UT3, y el que se ve en las empresas, porque tiene dos ventajas: nginx usa el certificado en PEM (el formato de texto habitual para certificados y claves), el mismo que serviría para cualquier otro servicio, y cambiar el certificado no obliga a tocar Jenkins.
# compose.yml
services:
jenkins:
image: jenkins/jenkins:lts-jdk21
volumes:
- jenkins_home:/var/jenkins_home
- ./casc:/var/jenkins_home/casc:ro
- ./secrets:/run/secrets:ro # claves que lee JCasC
env_file: .env # contraseñas de los usuarios, fuera del repositorio
environment:
JAVA_OPTS: "-Djenkins.install.runSetupWizard=false"
CASC_JENKINS_CONFIG: /var/jenkins_home/casc/jenkins.yaml
# sin ports: solo nginx llega a él por la red interna del compose
nginx:
image: nginx:1.27
ports: ["443:443"]
volumes:
- ./nginx.conf:/etc/nginx/conf.d/default.conf:ro
- ./certs:/etc/nginx/certs:ro
depends_on: [jenkins]
volumes:
jenkins_home:
Las decisiones del compose.
jenkinsno publica ningún puerto: solo nginx llega a él, por la red interna del compose, comojenkins:8080. Desde fuera, lo único abierto es el 443.runSetupWizard=false, enJAVA_OPTS, apaga el asistente del primer arranque, el de la demo de la A6.1, con su contraseña inicial y su instalación de plugins a mano. Aquí los usuarios los crea el YAML y los plugins vienen en la imagen.CASC_JENKINS_CONFIGdice dónde está ese YAML, que llega de solo lectura desde la carpetacasc/.- Ningún secreto está en un fichero del repositorio: las contraseñas de los usuarios llegan como variables de entorno desde
.env, y las claves, como ficheros de la carpetasecrets/montados en/run/secrets, que es donde los busca el plugin que lee el YAML.
# nginx.conf
server {
listen 443 ssl;
server_name jenkins.lab;
ssl_certificate /etc/nginx/certs/jenkins.crt;
ssl_certificate_key /etc/nginx/certs/jenkins.key;
location / {
proxy_pass http://jenkins:8080;
proxy_http_version 1.1;
proxy_set_header Host $host;
proxy_set_header X-Real-IP $remote_addr;
proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
proxy_set_header X-Forwarded-Proto https;
proxy_set_header X-Forwarded-Host $host;
# agentes inbound y cliente de línea de órdenes por WebSocket
proxy_set_header Upgrade $http_upgrade;
proxy_set_header Connection "upgrade";
proxy_read_timeout 90s;
client_max_body_size 50m;
}
}
Las decisiones del nginx.conf.
proxy_passlleva todas las peticiones al contenedor de Jenkins por su nombre en la red del compose.- Las cabeceras
X-Forwarded-*le cuentan a Jenkins cómo le ha llegado de verdad la petición: por HTTPS y a qué nombre. Sin ellas, Jenkins cree que le hablan por HTTP ajenkins:8080, genera sus enlaces con esa dirección y muestra el aviso "It appears that your reverse proxy set up is broken". La otra condición es configurar en Jenkins su URL pública,https://jenkins.lab/, que en el curso la pone el YAML. UpgradeyConnectiondejan pasar WebSocket, la conexión permanente que usan los agentes que llaman ellos al controlador y el cliente de línea de órdenes de Jenkins.client_max_body_sizesube el límite de 1 MB que nginx pone por defecto a lo que se le envía, para poder subir ficheros grandes, como un plugin a mano.
La misma configuración sirve para Gitea. Cambiando server_name, el certificado y el destino del proxy_pass, este nginx.conf publica otro servicio con su nombre. Así se publica Gitea el 12 de febrero, cuando se muda a su máquina definitiva.
La alternativa: que Jenkins sirva HTTPS. Jenkins también sabe hacerlo él mismo, cargando un keystore Java (un fichero con el certificado y la clave en el formato que entiende Java) y publicando el 8443. Se usa cuando no hay ningún proxy delante; el compose y los comandos de esa variante están en Para ampliar.
Dónde vive. Jenkins vive en la subred de gestión de la VPC (en el laboratorio del curso, 10.10.0.0/24, en la VM jenkins01 con la 10.10.0.10 y el nombre jenkins.lab), nunca en la DMZ externa: contiene credenciales de todo lo demás y no lo necesita nadie de fuera.
Certificados
De dónde sale el certificado. Para que el navegador ponga el candado, el certificado de jenkins.lab tiene que estar firmado por una CA en la que confíe. Una CA pública no sirve: Let's Encrypt solo firma nombres de dominios públicos, y jenkins.lab no lo es. En el laboratorio tampoco se crea ninguna CA nueva: se usa la CA del curso, la que se montó con openssl ca en la A3.2 y vive en ~/ca/ del puesto de administración, con su ca.cnf y su registro de certificados emitidos. En una empresa, ese papel lo hace la CA corporativa.
Quién tiene que confiar en ella. Su ca.crt se instala en los navegadores del aula y en el almacén del sistema de cada máquina que va a hablar con Jenkins, Gitea y el registry (/usr/local/share/ca-certificates/lab-ca.crt y update-ca-certificates en Debian/Ubuntu). ca.key no sale nunca del puesto: quien la tenga puede firmar un certificado para cualquier nombre del laboratorio.
Cómo se emite. Emitir un certificado para jenkins.lab son dos comandos, desde ~/ca/: la petición con la clave nueva y la firma de la CA (openssl ca pide confirmar dos veces):
openssl req -new -newkey rsa:2048 -nodes -keyout jenkins.key -out jenkins.csr \
-subj "/CN=jenkins.lab" -addext "subjectAltName=DNS:jenkins.lab"
openssl ca -config ca.cnf -extensions server_cert -notext -in jenkins.csr -out jenkins.crt
Los demás certificados de la unidad. Los de gitea.lab y del registry salen de los mismos dos comandos cambiando el nombre. -extensions client_cert en lugar de server_cert da un certificado de cliente, el que sirve para que un cliente demuestre quién es. Jenkins usa uno así desde el 10 de febrero, para dar órdenes al Docker de su agente.
subjectAltName obligatorio
Sin el subjectAltName los navegadores actuales rechazan el certificado aunque el CN sea correcto; es el error más repetido en esta sesión.
Usuarios y permisos
El problema: administrar Jenkins es tenerlo todo. Quien administra Jenkins puede ejecutar código con los permisos del propio Jenkins y, por tanto, leer todas las credenciales que guarda. Por eso los permisos se reparten por papeles, los administradores son muy pocos y se cierran las puertas que dan ese poder sin pedirlo.
- Quién reparte los permisos. Manage Jenkins → Security → Authorization: Matrix-based security o el plugin Role-based Authorization Strategy. La matriz vale para tres usuarios; en cuanto hay carpetas y equipos, los roles se gestionan mejor, y es lo que usa el curso.
- Los papeles. Administrador (pocos, dos personas como máximo), desarrollador (construir y ver), lector (solo ver) y cuentas de servicio (solo lo que su tarea necesita, por ejemplo un rol que solo puede lanzar un job concreto desde el webhook). El YAML del curso crea los tres primeros:
admin,devylector. - De dónde salen los usuarios. Locales, declarados en el YAML, solo en el laboratorio; en una empresa se autentica contra el directorio corporativo, como se cuenta en Para ampliar.
- Sin registro abierto. Nadie puede darse de alta solo: el YAML lo cierra con
allowsSignup: false. - Protección CSRF, contra la falsificación de peticiones desde otro sitio: que una web ajena use el navegador de la persona, ya autenticado, para lanzar acciones en Jenkins. Jenkins mete en sus formularios un valor ligado a la sesión, el crumb, y rechaza las peticiones que no lo devuelven. Viene activada, y hay tutoriales antiguos que enseñan a desactivarla para que funcione un
curl: no se desactiva, se pasa el crumb o se usa un token de API. - La script console, en Manage Jenkins → Script Console, ejecuta Groovy (el lenguaje de script de la plataforma Java, el mismo en que se escriben los
Jenkinsfile) sin restricción y con los permisos del proceso de Jenkins. Quien tieneOverall/Administertiene eso, y por eso hay que dar tan pocos.
Hardening del controlador
El controlador es lo que más hay que proteger, porque guarda las credenciales cifradas y la clave que las descifra. Las medidas van dirigidas a que nada ajeno se ejecute en él y a que se pueda reconstruir:
- Número de ejecutores en el controlador: 0. Nada se ejecuta en el controlador, todo en agentes. Un pipeline que corre en el controlador puede leer
/var/jenkins_home/secrets/master.keyy descifrar todas las credenciales. - El agente no manda en el controlador. Un agente comprometido no puede pedirle al controlador que le lea o le escriba ficheros: es la protección Agent → Controller, que en las versiones actuales de Jenkins viene siempre activada y ya no se puede desactivar. No hay nada que configurar, pero conviene saber que existe, porque en los tutoriales antiguos aparece como una casilla que había que marcar.
- Actualizaciones y copias: la LTS del controlador, los plugins revisados cada mes y una copia de
jenkins_homecon sus dos ficheros de claves. Cómo se hace cada cosa está en Para ampliar. - Configuration as Code (plugin JCasC): la configuración de Jenkins en un YAML versionado, que Jenkins lee y aplica al arrancar. Es la diferencia entre un Jenkins que se reconstruye en cinco minutos y uno que nadie se atreve a tocar.
El YAML siguiente es una configuración completa para el laboratorio. Conviene fijarse en tres bloques: securityRealm y authorizationStrategy (los tres usuarios, quién entra y qué puede hacer), nodes (el agente agent01) y credentials (la clave SSH del agente, leída de un fichero en vez de escrita). Los dos últimos se añaden el 10 de febrero, cuando se monta el agente: hasta entonces el fichero va sin ellos.
# casc/jenkins.yaml
jenkins:
systemMessage: "Jenkins de la asignatura. Configurado por JCasC, no toques nada a mano."
numExecutors: 0
mode: EXCLUSIVE
securityRealm:
local:
allowsSignup: false
users:
- id: admin
password: ${ADMIN_PASSWORD}
- id: dev
password: ${DEV_PASSWORD}
- id: lector
password: ${LECTOR_PASSWORD}
authorizationStrategy:
roleBased:
roles:
global:
- name: admin
permissions: ["Overall/Administer"]
entries:
- user: admin
- name: dev
permissions: ["Overall/Read", "Job/Read", "Job/Build", "Job/Cancel", "Job/Workspace"]
entries:
- user: dev
- name: lector
permissions: ["Overall/Read", "Job/Read"]
entries:
- group: authenticated
crumbIssuer:
standard:
excludeClientIPFromCrumb: false
nodes:
- permanent:
name: agent01
labelString: "docker deploy"
remoteFS: /home/jenkins
numExecutors: 2
launcher:
ssh:
host: 10.10.0.12
port: 22
credentialsId: agent-ssh
sshHostKeyVerificationStrategy:
manuallyProvidedKeyVerificationStrategy:
key: "ssh-ed25519 AAAAC3Nza... agent01"
unclassified:
location:
url: https://jenkins.lab/
adminAddress: ops@lab
credentials:
system:
domainCredentials:
- credentials:
- basicSSHUserPrivateKey:
scope: SYSTEM
id: agent-ssh
username: jenkins
privateKeySource:
directEntry:
privateKey: ${AGENT_SSH_KEY}
Cómo llegan los secretos al YAML. Los valores entre ${...} los resuelve JCasC al arrancar: las contraseñas, de las variables de entorno del contenedor (el .env que carga env_file), y ${AGENT_SSH_KEY}, del fichero /run/secrets/AGENT_SSH_KEY que monta la carpeta secrets/. Así el YAML se puede subir al repositorio jenkins-config sin un solo secreto dentro. El rol lector se asigna al grupo authenticated, que son todos los usuarios que han entrado, así que dev y admin también leen; admin tiene además todo lo demás.
Para empezar desde un Jenkins hecho a mano. El plugin admite exportar la configuración actual (Manage Jenkins → Configuration as Code → View Configuration) y pasarla a YAML, aunque la exportación arrastra mucho ruido que conviene limpiar.
Plugins
El problema: un Jenkins recién instalado no sabe hacer casi nada. No sabe clonar un repositorio, hablar con Docker, leer un informe de pruebas ni repartir permisos por roles: cada capacidad la aporta un plugin, y el catálogo pasa de 1800. Hay que decidir cuáles hacen falta para el módulo e instalarlos de forma que el Jenkins se reconstruya siempre igual.
Por qué en la imagen y no a mano. Desde Manage Jenkins → Plugins se instalan con un clic, pero entonces cada Jenkins tiene los suyos, con la versión que hubiera ese día, y nadie sabe reconstruirlo igual. La alternativa es una imagen propia que los deja preinstalados desde una lista, plugins.txt, con una línea id:version por plugin:
FROM jenkins/jenkins:lts-jdk21
COPY plugins.txt /usr/share/jenkins/ref/plugins.txt
RUN jenkins-plugin-cli --plugin-file /usr/share/jenkins/ref/plugins.txt
# la CA del curso, para que el controlador confíe en gitea.lab y en el registry
USER root
COPY ca.crt /usr/local/share/ca-certificates/lab-ca.crt
RUN update-ca-certificates && \
keytool -importcert -noprompt -cacerts -storepass changeit -alias lab-ca \
-file /usr/local/share/ca-certificates/lab-ca.crt
USER jenkins
Qué hace cada parte. jenkins-plugin-cli, que viene en la imagen oficial, lee la lista y descarga cada plugin con sus dependencias mientras se construye la imagen. Las líneas que siguen al comentario meten la CA del curso en el almacén del sistema del contenedor (lo usa git) y en el de Java (lo usa Jenkins, que no mira el del sistema), para que el controlador confíe en los certificados que firma. ca.crt es público y se sube al repositorio con el resto. Esa confianza hace falta desde el 12 de febrero, cuando Gitea pasa a HTTPS al mudarse a gitea01.
Los que necesita el módulo, con su identificador en plugins.txt y la sesión en que se empieza a usar cada uno:
| Plugin | Id | Para qué | Sesión |
|---|---|---|---|
| Git | git |
Clonar repositorios, checkout scm |
33 |
| Gitea | gitea |
Descubrir ramas y merge requests, recibir el webhook de Gitea | 33 |
| Pipeline | workflow-aggregator |
Todo lo que hace falta para un Jenkinsfile, incluido el paso build que lanza otro job |
34 |
| Docker Pipeline | docker-workflow |
agent { docker {...} }, docker.build, docker.withRegistry |
34, 35 |
| Docker | docker-plugin |
Cloud Docker: agentes efímeros en contenedor | 32 |
| SSH Build Agents | ssh-slaves |
Agentes permanentes por SSH | 32 |
| Credentials Binding | credentials-binding |
Usar los secretos con withCredentials |
33 |
| Folders | cloudbees-folder |
Carpetas con credenciales de ámbito propio | 33, 37 |
| Role-based Authorization Strategy | role-strategy |
Permisos por rol | 31 |
| Configuration as Code | configuration-as-code |
Configuración versionada | 31 |
| JUnit | junit |
Publicar informes de pruebas y marcar UNSTABLE | 34 |
| Pipeline Graph View | pipeline-graph-view |
Ver el pipeline por etapas | 34 |
| Timestamper | timestamper |
Hora en cada línea del log | 31 |
| Workspace Cleanup | ws-cleanup |
cleanWs() en el post |
36 |
Un plugin es código de terceros con todos los permisos. La regla es instalar solo lo que se usa y actualizar con criterio, porque un plugin abandonado es una vulnerabilidad. Cada plugin arrastra dependencias (instalar workflow-aggregator mete unos treinta), y cada uno corre dentro del proceso de Jenkins, el que tiene las credenciales. Antes de instalar uno conviene mirar en plugins.jenkins.io la fecha de la última versión y si tiene avisos de seguridad abiertos; si lleva tres años sin tocarse, mejor buscar alternativa. Es la revisión que hace la hoja antes de construir la imagen.
A6.2 Instalación segura y plugins (sesión 31)
Objetivo Al terminar tienes el Jenkins definitivo del curso en https://jenkins.lab, con candado en el navegador, tres roles que solo pueden lo que les toca, ejecutores del controlador a 0 y los plugins de la unidad metidos en una imagen propia con su versión fijada. Todo queda en el repositorio jenkins-config, con un README que permite reconstruirlo: es lo que hace que este Jenkins se pueda tirar y volver a levantar igual durante el resto de la unidad.
Antes de empezar jenkins01 de la A6.1, con Docker y con jenkins.lab dado de alta en OPNsense, y la CA del curso en ~/ca/ del puesto de administración (la de la A3.2). La demo de la A6.1 sobra: tírala con sus volúmenes, ~/demo y ~/runner de jenkins01. Se han explicado cómo se instala y asegura Jenkins y qué plugins hacen falta.
Pasos
Vas de fuera hacia dentro, en el orden de la teoría. Primero el certificado, que es lo que protege todo lo demás. Después revisas los plugins antes de instalar nada, porque una vez dentro de la imagen nadie vuelve a mirarlos. Con eso montas los ficheros de la instalación y la configuración, levantas Jenkins y compruebas con cada usuario que los permisos son los que dice el YAML. Al final lo dejas escrito para que cualquiera pueda reconstruirlo sin ti.
-
Emite el certificado de
jenkins.lab. Emítelo en el puesto de administración con los dos comandos de certificados y llévalo a~/jenkins-config/certs/dejenkins01, conca.crten~/jenkins-config/. Crea tambiéncasc/ysecrets/, esta vacía por ahora.ca.keyno sale nunca del puesto. -
Revisa los plugins antes de instalarlos. Revisa en plugins.jenkins.io tres plugins de la tabla de plugins, entre ellos
docker-plugin, y recoge en una tabla su id, su última versión y la fecha de esta, los avisos de seguridad abiertos y tu veredicto (se queda, se cambia por otro o se quita), justificado en media línea. Es la revisión que, en una empresa, se hace antes de meter código de terceros en la máquina que guarda las credenciales. -
Monta la instalación. En
~/jenkins-configvan elcompose.ymly elnginx.confde despliegue en contenedor, conbuild: .en vez deimage:enjenkins, para que el compose construya tu imagen; elDockerfilede plugins, tal cual; unplugins.txtcon todos los plugins de la tabla del apartado, cada uno con su versión fijada (id:version), y un.gitignorecon.envysecrets/, para que ningún secreto llegue al repositorio. -
Escribe la configuración en YAML.
casc/jenkins.yamllleva el YAML de hardening sin los bloquesnodesycredentials, que son del agente y se añaden el 10 de febrero; las contraseñas de los tres usuarios van en el.env, de donde el YAML las lee como variables. -
Levántalo y prueba los permisos con cada usuario. Levanta Jenkins, entra como
adminenhttps://jenkins.lab:28443por el túnel de Nombres DNS y acceso y crea un job Pipeline vacío. Comprueba sidevylectorpueden lanzarlo, ver su consola y entrar en Manage Jenkins, y que Manage Jenkins → Plugins lista los tuyos con la versión que fijaste: es la prueba de que los roles y la imagen hacen lo que dicen.Pista: construir la imagen descarga los plugins y tarda: aprovecha la espera para empezar el README del paso 6.
-
Déjalo escrito para reconstruirlo. Sube compose,
Dockerfile,plugins.txt,nginx.conf,ca.crtycasc/jenkins.yamlaops/jenkins-configde tu Gitea, todavía enhttp://gitea.lab:23001, con unREADME.mdde instalación: cómo se emiten los certificados y que la CA vive en el puesto de administración, qué roles hay y qué puede hacer cada uno, de dónde salen los plugins, qué variables de entorno hacen falta y los dos comandos para levantarlo.
Comprobación Candado en el navegador sin avisos; lector no puede lanzar nada; Manage Jenkins → Nodes muestra el controlador con 0 ejecutores; Manage Jenkins → Plugins lista todos los de plugins.txt con la versión que fijaste; ni el YAML ni el README contienen ninguna contraseña; y la tabla del paso 2 no deja ningún plugin con aviso de seguridad abierto sin decisión tomada.
Para practicar Guarda en A6.2 la URL de jenkins-config, la tabla de revisión de plugins del paso 2 y dos capturas, https://jenkins.lab con candado y la matriz de roles: lo pide la práctica evaluable.
Si te sobra tiempo Comprueba que el README sirve de verdad: docker compose down -v (borra el volumen) y vuelve a levantarlo siguiendo solo tu README.md, sin abrir estos apuntes; cada vez que tengas que recordar algo que no está escrito, apúntalo en el README y sigue. Y cuenta cuántos plugins lista Manage Jenkins → Plugins → Installed frente a las líneas de tu plugins.txt: la diferencia son dependencias que ha arrastrado el instalador, así que localiza tres y anota de qué plugin tuyo cuelgan.
Sesión 32 · Agentes
El controlador tiene cero ejecutores desde que se instaló, a propósito: nada se ejecuta en la máquina que guarda las credenciales. La consecuencia es que, ahora mismo, Jenkins no puede ejecutar nada. Esta sesión le da dónde. Primero se explica qué es un agente y cómo decide Jenkins en cuál corre cada etapa; después, los dos tipos que se montan en el laboratorio: un agente permanente, agent01, al que Jenkins entra por SSH, y agentes efímeros en contenedor, que exigen abrir el Docker de agent01 a la red sin regalárselo a nadie. La hoja monta los dos en ese orden y lanza un job que pasa por ambos.
Agentes
El controlador coordina; los agentes ejecutan. Un agente es una máquina o un contenedor donde Jenkins ejecuta las tareas. Cada agente tiene un número de ejecutores (cuántas tareas admite a la vez), un directorio de trabajo donde cada job tiene su carpeta (el workspace, donde se clona el código y quedan los ficheros de la ejecución) y una o varias etiquetas. Cuando una etapa pide agent { label 'docker' }, el controlador la encola hasta que un agente con esa etiqueta tenga un ejecutor libre. Las etiquetas describen capacidades (docker, deploy, linux, arm64), no nombres de máquina: así el día que agent01 se sustituye por agent03 no hay que tocar ningún Jenkinsfile.
flowchart LR
ETAPA["<b>agent { label 'docker' }</b><br><small>lo que pide la etapa</small>"]:::dato
CTRL["<b>Controlador</b><br><small>coordina y encola · no ejecuta</small>"]:::act
COLA["<b>Cola</b><br><small>hasta que haya un ejecutor libre</small>"]:::infra
A1["<b>agent01</b><br><small>docker · deploy</small>"]:::pieza
A2["<b>agente efímero</b><br><small>docker · nace y muere con la tarea</small>"]:::pieza
ETAPA --> CTRL --> COLA
COLA --> A1
COLA --> A2
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxLa etiqueta describe una capacidad, no una máquina. Por eso cambiar el hardware no obliga a tocar ningún Jenkinsfile.
Tipos de agente
Cuatro formas de darle agentes a Jenkins, de la más sencilla a la que se ve en empresas grandes. El laboratorio usa dos, la primera y la tercera de la lista; las otras dos conviene reconocerlas:
- Agente permanente por SSH: una VM con Java a la que Jenkins se conecta por SSH con una clave, copia
agent.jary lo arranca. Es el más sencillo de entender y el que se usa para las etapas que necesitan herramientas instaladas en el host (git,ansible, el CLI de Docker). Etiquetas (docker,deploy) para dirigir las tareas. El controlador necesita llegar al puerto 22 del agente. - Agente inbound: la conexión va al revés, el agente llama al controlador con un secreto. Vale para agentes detrás de un NAT o de un cortafuegos que no admite conexiones entrantes, y con
-webSocketpasa por el mismo 443 de nginx sin abrir el puerto 50000:java -jar agent.jar -url https://jenkins.lab/ -name agent02 -secret <secreto> -webSocket -workDir /home/jenkins. La imagenjenkins/inbound-agenthace exactamente eso. - Agente en contenedor (cloud Docker con el plugin
docker-plugin): Jenkins habla con un demonio Docker (por TCP con TLS, o por el socket de una VM dedicada), levanta un contenedor a partir de una plantilla por cada tarea y lo destruye al terminar. Limpio y reproducible: no hay restos de la ejecución anterior. Se configura en Manage Jenkins → Clouds con una plantilla que asocia imagen (jenkins/agento una propia con herramientas) y etiqueta. - Agente efímero en Kubernetes (plugin
kubernetes): lo mismo a escala; cada tarea es un pod (el grupo de contenedores que Kubernetes arranca juntos) con los contenedores que declare elJenkinsfile. Es lo habitual en empresas medianas y grandes; en este módulo no se monta.
agent01, el agente permanente por SSH
Cómo entra Jenkins. El controlador abre una conexión SSH con el usuario jenkins de agent01, copia agent.jar, el programa Java que hace de agente, y lo arranca; desde ese momento le manda las tareas por esa conexión. De ahí salen los requisitos de la máquina: Java para ejecutar agent.jar (el 21, el mismo que el controlador), git para clonar, Docker para las etapas que corren en contenedor y un usuario jenkins cuyo directorio, /home/jenkins, es el directorio de trabajo del agente (el remoteFS del YAML).
Con qué clave. La conexión usa un par de claves propio, que no es el de ninguna persona: la privada la guarda Jenkins como la credencial agent-ssh, leída del fichero secrets/AGENT_SSH_KEY, y la pública está autorizada en el usuario jenkins de agent01.
Cómo sabe que es agent01. Como cualquier cliente SSH, Jenkins tiene que comprobar que la máquina que contesta en 10.10.0.12 es de verdad agent01 y no otra que se hace pasar por ella; si no lo comprobase, quien suplantara esa IP recibiría las tareas de Jenkins, con el código y los secretos que llevan. Por eso el YAML lleva la clave de host de agent01, sacada antes con ssh-keyscan, y Jenkins rechaza la conexión si la máquina presenta otra.
Lo que pesa el grupo docker. El usuario jenkins va en el grupo docker para que las etapas lancen contenedores sin sudo. Conviene saber lo que eso significa: quien maneja Docker puede montar cualquier directorio del host en un contenedor, así que pertenecer a ese grupo equivale a ser root en agent01. Es una de las razones por las que el agente que construye no debería ser el que despliega.
El demonio Docker por la red, con TLS
Para qué hace falta. La cloud Docker crea los agentes efímeros como contenedores en agent01, pero quien los pide es el controlador, desde jenkins01: Jenkins tiene que poder dar órdenes al Docker de otra máquina. Docker se maneja por una API, y de serie solo la ofrece en un socket local, /var/run/docker.sock; para usarla desde fuera hay que publicarla por TCP.
El riesgo. Quien puede dar órdenes a un demonio Docker es root en esa máquina: le basta con arrancar un contenedor que monte la raíz del host. Publicar la API por TCP sin más (en el 2375, el puerto que se usa por convención para hacerlo sin cifrar) sería dar root en agent01 a cualquiera que llegue a la subred de gestión.
La solución: TLS en los dos sentidos. El demonio se publica en el 2376, el puerto que se usa por convención para Docker con TLS, y con verificación de cliente. Presenta un certificado de servidor firmado por la CA del curso, que lleva la IP de agent01 en el SAN porque la cloud se conecta por IP, y solo acepta a los clientes que presentan un certificado de cliente firmado por esa misma CA. Ese certificado de cliente solo lo tiene Jenkins, guardado como credencial: es lo que hace que el Docker de agent01 obedezca a Jenkins y a nadie más.
Cómo se configura. En el fichero de configuración del demonio, /etc/docker/daemon.json:
{
"hosts": ["unix:///var/run/docker.sock", "tcp://0.0.0.0:2376"],
"tlsverify": true,
"tlscacert": "/etc/docker/tls/ca.crt",
"tlscert": "/etc/docker/tls/agent01.crt",
"tlskey": "/etc/docker/tls/agent01.key"
}
hosts mantiene el socket local, que siguen usando las etapas que corren en el propio agent01, y añade el TCP. tlsverify activa el cifrado y, sobre todo, exige al cliente un certificado firmado por la CA de tlscacert: es la línea que cierra la puerta a todo el que no sea Jenkins.
El choque con systemd. Con ese fichero, Docker no arranca a la primera. La unidad de systemd del paquete de Docker lo lanza con la opción -H fd://, y Docker se niega a arrancar si una misma opción le llega a la vez por la línea de órdenes y por daemon.json, que aquí es hosts. Se arregla con un override que deja la orden de arranque sin opciones:
# /etc/systemd/system/docker.service.d/override.conf
[Service]
ExecStart=
ExecStart=/usr/bin/dockerd
La línea ExecStart= vacía borra la orden original y la segunda pone la nueva; después hay que recargar systemd (systemctl daemon-reload) y reiniciar Docker. La ruta es la del Docker que instala el script de get.docker.com, el del curso; con el paquete docker.io de Debian es /usr/sbin/dockerd.
Qué recibe Jenkins. Una credencial de tipo X.509 Client Certificate, docker-tls, con la clave y el certificado de cliente y el ca.crt para comprobar al servidor. Con ella, la cloud Docker de Manage Jenkins → Clouds se conecta a tcp://10.10.0.12:2376. Las instrucciones oficiales están en Protect the Docker daemon socket; allí se crea una CA nueva, y en el laboratorio se usa la del curso.
Elegir el agente desde el Jenkinsfile
Dos maneras de "correr en un contenedor" que se confunden mucho. La cloud Docker crea el agente entero como contenedor. agent { docker { image 'python:3.12' } } del plugin Docker Pipeline hace otra cosa: en un agente normal que tenga el CLI de Docker, lanza docker run con esa imagen, monta el workspace dentro y ejecuta los steps ahí. Lo segundo es lo que usa el pipeline del curso en la etapa de pruebas: la máquina agent01 no tiene Python 3.12 instalado, lo trae la imagen.
Dónde se decide. En el Jenkinsfile se elige con agent { label 'docker' } o agent { docker { image 'python:3.12'; label 'docker' } }. Si el pipeline declara agent none, cada stage tiene que declarar el suyo, y es la forma preferible porque obliga a decidir en cada etapa dónde corre y con qué credenciales. Si el pipeline declara agent { label 'docker' }, todas las etapas heredan ese agente y el workspace se comparte entre ellas sin más; es más cómodo, pero mezcla en la misma máquina la construcción y el despliegue, y por tanto sus credenciales.
A6.3 Agentes (sesión 32)
Objetivo Al terminar, Jenkins tiene dónde ejecutar: un agente permanente, agent01, al que entra por SSH, y una cloud Docker que crea un agente en contenedor para cada tarea y lo borra al acabar. Has lanzado un job con una etapa en cada uno y has visto en el log dónde ha corrido cada una. Sin esto no se podría ejecutar ningún pipeline de la unidad, porque el controlador tiene cero ejecutores.
Antes de empezar El Jenkins de la A6.2 funcionando y su repositorio jenkins-config, y la CA del curso en el puesto de administración, que es la que firma los certificados del paso 4. Se han explicado los tipos de agente y las etiquetas, cómo entra Jenkins en agent01 y cómo se abre el Docker de un agente a la red.
Pasos
Primero el agente permanente, que es el más sencillo: la máquina, la clave con la que Jenkins entra en ella y su alta en el YAML, que es lo que la conecta. Después el efímero, que necesita una pieza más: que el Docker de agent01 acepte órdenes por la red, pero solo de Jenkins. Al final, un job con una etapa en cada uno demuestra dónde cae cada cosa.
-
Prepara
agent01. Creaagent01, la VM 106 de la tabla del laboratorio (devmgmt, 10.10.0.12, 2 GB), con Java 21 (openjdk-21-jre-headless),git, Docker y un usuariojenkinsen el grupodocker, y da de altaagent01.laben OPNsense. Cada pieza tiene su porqué en agent01, el agente permanente: sin Java no arranca el agente, y sin Docker no hay etapas en contenedor ni agentes efímeros. -
Crea la clave con la que entra Jenkins. Crea en el puesto de administración el par de claves con el que el controlador entra en
agent01comojenkins: la pública, autorizada en ese usuario; la privada, en~/jenkins-config/secrets/AGENT_SSH_KEYdejenkins01, y no se queda en el puesto. Apunta la clave de host ed25519 deagent01(ssh-keyscan), que pide el YAML para saber que habla con la máquina buena.Pista: el YAML quiere el tipo y la clave (
ssh-ed25519 AAAA...), sin la IP quessh-keyscanescribe delante. -
Da de alta
agent01en el YAML. Añade aljenkins.yamlel bloquenodesy la credencialagent-sshde hardening, con esa clave de host, y relanza Jenkins:agent01tiene que salir conectado en Manage Jenkins → Nodes, con las etiquetasdocker deployy dos ejecutores. Al estar en el YAML, el agente sobrevive a cualquier reconstrucción de Jenkins. -
Abre el Docker de
agent01a Jenkins, y solo a Jenkins. Publica el demonio Docker deagent01entcp://10.10.0.12:2376con TLS y verificación de cliente, como en El demonio Docker por la red, con TLS; el 2375 sin cifrar no se usa nunca. Con la CA del curso (certificados) emite uno de servidor paraagent01y uno de cliente para Jenkins, que queda enjenkins01comojenkins-cert.pemyjenkins-key.pem, y mete la CA en el almacén del sistema deagent01antes de reiniciar Docker: la usarángity el registry. Comprueba desdejenkins01que el demonio responde con el certificado de cliente y no sin él, que es la prueba de que nadie más puede usarlo.Pista: el de servidor lleva
IP:10.10.0.12en elsubjectAltName, porque la cloud entra por IP. Si Docker no arranca tras el cambio, es el choque con-H fd://que explica el apartado. -
Crea la cloud Docker. Crea en Manage Jenkins → Clouds una cloud Docker con la URI
tcp://10.10.0.12:2376y una credencial X.509 Client Certificatedocker-tlscon la clave y el certificado de cliente yca.crt: Test Connection tiene que devolver la versión del demonio. Añade una plantilla con la imagenjenkins/agenty la etiquetaefimero, que es la que pedirán las etapas que quieran un agente de usar y tirar. -
Comprueba dónde corre cada etapa. Crea un job Pipeline con una etapa en
agent { label 'docker' }y otra enagent { label 'efimero' }, las dos consh 'hostname; cat /etc/os-release'. La etiqueta de cada etapa decide en qué agente cae, y el log de este job es la prueba.
Comprobación En el log, la primera etapa muestra el hostname de agent01 y la segunda uno aleatorio de contenedor; el Test Connection de la cloud devuelve la versión del demonio de agent01 y sin certificado ese puerto no contesta; docker ps en agent01 durante la ejecución muestra el agente efímero y, al terminar, ya no está. Nada se ejecutó en el controlador.
Para practicar Sube a jenkins-config el jenkins.yaml actualizado y guarda en A6.3 la captura del log con los dos hostnames, que pide la práctica evaluable.
Si te sobra tiempo Pasa la cloud al YAML: exporta la configuración (Manage Jenkins → Configuration as Code → View Configuration), copia el bloque clouds y deja la credencial docker-tls fuera, en secrets/. Y levanta un segundo agente con la imagen jenkins/inbound-agent y -webSocket a través de nginx, sin abrir el puerto 50000.
Sesión 33 · Proyecto y credenciales
Jenkins ya está instalado y tiene dónde ejecutar, pero no sabe nada del código: no sabe dónde está el repositorio, no puede leerlo y nadie le avisa cuando cambia. Esta sesión lo engancha, y lo hace contra la dirección definitiva de Gitea. La Gitea de mon01 era provisional; su sitio es gitea01, con HTTPS. Por eso la teoría y la hoja empiezan por la mudanza. Después siguen el orden en que se resuelve el problema: el proyecto que sabe dónde está el código, la credencial con la que lo lee y el webhook que lo dispara con cada push.
Proyectos, credenciales y webhooks
Con Jenkins instalado y un agente conectado, falta engancharlo al repositorio: un proyecto que sepa dónde está el código, una credencial para leerlo y un webhook (el aviso HTTP que el servidor Git envía a Jenkins cuando alguien hace push) para que arranque solo. Esas tres cosas son este apartado, y las credenciales llevan su propia parte porque son lo primero que se intenta robar de un Jenkins. Antes, la mudanza que deja Gitea en la dirección a la que se van a enganchar las tres.
La mudanza de Gitea a gitea01
Por qué se muda hoy. Hasta ahora Gitea era un contenedor más de la pila de mon01, publicado en el 23001 sin cifrar: bastaba para tener remoto y para las incidencias de Mantenimiento. Desde hoy Jenkins va a leer de ella con una credencial y ella va a avisar a Jenkins con cada push, y conviene que las dos cosas se configuren una sola vez, contra la dirección que se queda: https://gitea.lab, en gitea01, una máquina de plataforma de la subred de gestión. En ella se levanta también el registry de imágenes, el 19 de febrero, y por eso registry.lab apunta a su IP desde hoy.
Cómo se lleva una Gitea con todo su historial. Gitea guarda todo (repositorios, usuarios, incidencias, tokens y su base de datos SQLite) en un único directorio, /data, que en mon01 es el volumen monitoring_gitea_data. Mudarla es llevar ese volumen: se para Gitea para que nada cambie mientras se copia, se empaqueta su contenido en un tar, se crea en gitea01 un volumen nuevo y se desempaqueta dentro. Con la misma versión de Gitea en los dos lados, para que la mudanza no sea además una actualización.
Qué cambia en el compose. El servicio gitea de gitea01 es el de la A2.6 de Mantenimiento con estos cambios:
# /opt/gitea/compose.yml, en gitea01 (delante va el nginx de jenkins-config)
services:
gitea:
image: gitea/gitea:1.24 # la misma versión que corre en mon01
environment:
GITEA__server__HTTP_PORT: "23001" # el mismo que en mon01, ahora sin publicar
GITEA__server__ROOT_URL: https://gitea.lab/
GITEA__webhook__ALLOWED_HOST_LIST: jenkins.lab
volumes:
- gitea_data:/data
- ./ca.crt:/etc/ssl/certs/lab-ca.pem:ro
# sin ports: solo nginx llega a él
volumes:
gitea_data:
external: true # el que llega de mon01 en el tar
- Sin puerto publicado. Gitea sigue escuchando en el 23001, como en
mon01, pero ese puerto queda dentro de la red del compose: se publica solo por nginx, en el 443, con un certificado degitea.labde la CA del curso. Delante va el nginx dejenkins-config, conserver_name gitea.labyproxy_pass http://gitea:23001. Elapp.inique llega en el volumen, el fichero de configuración de Gitea, ya dice 23001, y aun asíHTTP_PORTse escribe en el compose: así una instalación desde cero, sin ese fichero, escucha en el mismo puerto. ROOT_URLes la dirección que Gitea escribe en sus enlaces y en las URL de clonado; si se queda la vieja, la web sigue enseñandohttp://gitea.lab:23001en todas partes.- La CA del curso en
/etc/ssl/certs/. Gitea va a llamar ahttps://jenkins.labpara entregar cada webhook, y tiene que confiar en su certificado. Gitea está escrito en Go, que toma como certificados de confianza todos los ficheros de ese directorio, así que basta con dejar ahí elca.crt. ALLOWED_HOST_LIST. Gitea, por defecto, solo entrega webhooks a direcciones públicas de Internet, para que nadie pueda usarlos para llegar a las máquinas de la red interna. Jenkins está en una dirección privada, la 10.10.0.10, así que hay que autorizarlo, y se hace por su nombre: solo él, y no toda la red.external: true. El volumen ya existe, porque lo crea a mano la mudanza; sin esa línea, compose crearía otro vacío con el nombre del proyecto delante.
Lo que apuntaba a la dirección vieja. Una mudanza no termina al arrancar en el sitio nuevo: hay que cambiar todo lo que tenía apuntada la dirección vieja. En el laboratorio son cuatro cosas: el DNS de OPNsense (gitea.lab, y de paso registry.lab, a la 10.10.0.11); la fila 6 de la matriz de reglas, que deja a app01 llegar a Gitea y pasa de la 10.10.0.20 en el 23001 a la 10.10.0.11 en el 443; el receptor de incidencias de mon01, que abre las issues de las alertas de Mantenimiento; y el remoto de cada copia de trabajo de los repositorios. El volumen viejo se guarda una semana, por si algo no se copió bien.
El proyecto
Qué es un proyecto. El proyecto (job) es la unidad de trabajo de Jenkins: lo que se lanza, tiene historial y se configura. Hay tres tipos que importan: freestyle (formulario web, sin código; aquí no se usa), Pipeline (un Jenkinsfile, escrito en el propio job o leído de un repositorio) y Multibranch Pipeline (Jenkins escanea el repositorio, crea un subjob por cada rama que tenga Jenkinsfile y lo borra cuando la rama desaparece; ideal con Git y con merge requests, porque cada uno se prueba en su rama antes de fusionarse). El repositorio del servicio se engancha con un Multibranch, porque así cada rama trae su propio pipeline.
Configuración base del proyecto: repositorio y credencial, ramas a descubrir, disparador (webhook, sondeo, cron), descartar ejecuciones antiguas (sin esto jenkins_home crece sin límite), tiempo máximo, y no permitir ejecuciones concurrentes si comparten recursos (dos despliegues a la vez sobre el mismo entorno dejan una mezcla de los dos).
Tareas dentro del proyecto: cada etapa del pipeline con su nombre, el agente donde corre, el entorno (variables) y las condiciones de ejecución. En Jenkins la etapa es la tarea; en GitLab CI la llaman job y la etapa (stage) agrupa jobs.
Cómo encuentra Jenkins el repositorio. El plugin de Gitea añade a Jenkins una lista de servidores Gitea (Manage Jenkins → System → Gitea Servers). Con la dirección del servidor, el Multibranch usa la API de Gitea para descubrir ramas y merge requests, y el plugin sabe a qué proyecto corresponde cada webhook que llega. El plugin puede además crear los webhooks él solo, pero para eso necesita una cuenta con permiso para administrar el repositorio; en el curso Jenkins solo lee, así que el webhook se crea a mano en Gitea.
Credenciales
El problema. Un pipeline necesita secretos (el token que lee Gitea, la contraseña del registry, la clave que entra en pre), pero el Jenkinsfile vive en el repositorio, a la vista de cualquiera que pueda leerlo. Los secretos no pueden ir ahí: Jenkins los guarda aparte, cifrados en su directorio de datos, y el pipeline solo los nombra por su ID. Están en Manage Jenkins → Credentials, y hay cuatro tipos que cubren casi todo:
| Tipo | Para qué | Cómo se usa en el pipeline |
|---|---|---|
| Username with password | Registry, Gitea/GitLab por HTTPS | usernamePassword(credentialsId:, usernameVariable:, passwordVariable:) |
| Secret text | Tokens de API (Gitea, Telegram) | string(credentialsId:, variable:) |
| SSH Username with private key | Agentes SSH, Git por SSH, Ansible | sshUserPrivateKey(credentialsId:, keyFileVariable:) |
| Secret file | kubeconfig, ficheros .env, certificados cliente |
file(credentialsId:, variable:) |
Dónde vive cada una. Ámbito System (solo el controlador la usa, por ejemplo para conectar con agentes) o Global (los pipelines pueden usarla). Con el plugin Folders cada carpeta tiene su propio almacén: una credencial creada en la carpeta servicio/pre solo existe para los jobs de esa carpeta, y ni los de servicio/dev ni los de servicio/ la ven. Se referencian por ID; nunca se escriben en el Jenkinsfile.
Un token en lugar de la contraseña. Para leer de Gitea, la credencial es de tipo Username with password aunque lo que guarda no sea una contraseña: Gitea acepta un token donde iría la contraseña, y un token se puede limitar (el alcance read:repository deja leer repositorios y nada más) y revocar sin tocar la cuenta. Es la credencial git-ro del curso, del usuario de servicio jenkins de Gitea.
Cómo se usa una. Con withCredentials, que saca el secreto solo durante un bloque:
withCredentials([usernamePassword(credentialsId: 'registry-cred',
usernameVariable: 'REG_USER',
passwordVariable: 'REG_PASS')]) {
sh 'echo "$REG_PASS" | docker login -u "$REG_USER" --password-stdin registry.lab:5000'
}
Dentro del bloque las variables existen en el entorno del sh y Jenkins sustituye su valor por **** en el log; al salir del bloque, dejan de existir.
Comillas simples en el sh que usa secretos
Las comillas simples del sh son deliberadas: la variable la expande el shell. Con comillas dobles la expandiría Groovy antes de pasársela al shell, el secreto viajaría como parte del texto del comando y Jenkins avisa con "Warning: A secret was passed to sh using Groovy String interpolation". El enmascarado protege el log, no el proceso: si el comando imprime el secreto codificado en base64 o lo escribe en un fichero que luego se archiva, se ha filtrado igual.
Webhooks
Avisar en lugar de preguntar. Un webhook es una petición HTTP POST que el servidor Git envía al orquestador cuando pasa algo (push, nueva rama, merge request). La alternativa, sondear el repositorio cada pocos minutos (pollSCM('H/5 * * * *')), funciona pero llega tarde y carga el servidor Git; con Multibranch, además, un escaneo periódico también descubre ramas nuevas.
A dónde llega y cómo se firma. Cada servidor Git tiene su ruta en Jenkins, que la pone el plugin correspondiente, y su forma de demostrar que el aviso es suyo:
| Servidor | URL en Jenkins (con el plugin correspondiente) | Cómo firma |
|---|---|---|
| Gitea | https://jenkins.lab/gitea-webhook/post |
Cabecera X-Gitea-Signature, firma del cuerpo con el secreto del webhook |
| GitLab | https://jenkins.lab/gitlab-webhook/post |
Cabecera X-Gitlab-Token con el secreto configurado |
| GitHub | https://jenkins.lab/github-webhook/ |
Cabecera X-Hub-Signature-256, firma del cuerpo con el secreto |
| Cualquiera (plugin Git) | https://jenkins.lab/git/notifyCommit?url=<repo> |
Sin firma; solo provoca un sondeo |
Las dos condiciones. Hay que configurar el secreto en los dos lados; sin él, cualquiera que llegue a la URL puede disparar pipelines. Y el servidor Git tiene que poder llegar a Jenkins y confiar en la CA que firmó su certificado, o rechazará el POST; en gitea01 eso son la CA montada y la lista ALLOWED_HOST_LIST de la mudanza. Gitea guarda el resultado de cada entrega en la pestaña del webhook, con el código de respuesta y el cuerpo: es el primer sitio donde mirar.
sequenceDiagram
participant D as Desarrollador
participant G as Gitea
participant J as Jenkins
participant A as agent01
participant R as registry.lab
participant E as Entorno pre
D->>G: git push main
G->>J: POST /gitea-webhook/post (firmado)
J->>J: escanea ramas y encola la ejecución 143
J->>A: Checkout + Build & Test (python:3.12)
A-->>J: report.xml
J->>A: Package
A->>R: docker push app 1a2b3c4
J->>A: Deploy: job servicio/pre/despliegue (label deploy)
A->>E: docker load, ansible-playbook, test.sh
E-->>A: HTTP 200
A-->>J: SUCCESS
J-->>D: estado en Jenkins y aviso por Telegram si fallaUn git push dispara todo lo demás. El trabajo lo hace el agente; el controlador solo encola, orquesta y guarda el resultado.
Cuando el servidor Git no llega a Jenkins. Pasa cuando el código está en GitHub o en GitLab.com y Jenkins está en la red de gestión sin IP pública. Opciones, de más a menos recomendable: sondeo (pollSCM) con un intervalo corto; exponer solo la ruta del webhook a través del proxy inverso de la DMZ, restringida a los rangos de IP del proveedor y con la firma verificada; un túnel saliente (Cloudflare Tunnel, ngrok o un ssh -R a un bastión). Lo que no se hace es abrir el 443 de Jenkins entero a Internet por comodidad. En el laboratorio del curso, Gitea y Jenkins están en la misma VPC y el problema no existe.
A6.4 Proyecto y credenciales (sesión 33)
Objetivo Al terminar, Gitea está en su máquina definitiva, gitea01, con HTTPS y todo su historial, y Jenkins tiene un proyecto Multibranch conectado al repositorio del servicio, que lee con una credencial que no sirve para nada más y que arranca solo con cada push. Es la primera vez que un cambio en el código llega a Jenkins sin que nadie pulse nada: desde ahora, todo lo que se añada al pipeline se ejecutará así.
Antes de empezar Jenkins con agent01 conectado, la plantilla 9000 y la CA del curso en el puesto de administración. Los repositorios del curso están en la Gitea que Mantenimiento levantó en mon01 en la A2.6, que hoy se muda a su máquina con todo su historial. Se han explicado la mudanza de Gitea y proyectos, credenciales y webhooks.
Pasos
Empiezas por la mudanza, porque todo lo demás apunta a la dirección definitiva de Gitea: si enganchas Jenkins a la de mon01, habría que rehacerlo después. La mudanza tiene tres tiempos: la máquina con sus datos, los nombres y la red, y las copias de trabajo. Con Gitea ya en su sitio, das a Jenkins permiso para leer y nada más, creas el proyecto y, al final, el webhook, que es lo que hace que todo funcione sin ti.
-
Muda Gitea a
gitea01, con todos sus datos. Montagitea01, la VM 102 de la tabla del laboratorio (devmgmt, 10.10.0.11, 1 GB), con Docker y compose, y lleva a ella la Gitea demon01con su volumen. En/opt/giteava el serviciogiteade la A2.6 de Mantenimiento con los cambios de la mudanza, y delante, el nginx dejenkins-configconserver_name gitea.lab, un certificado degitea.labde la CA del curso yproxy_pass http://gitea:23001.Pista: con Gitea parada, empaqueta con
sudoel contenido de/var/lib/docker/volumes/monitoring_gitea_data/_datay desempaquétalo igual en el volumen nuevo: así se conservan los propietarios de los ficheros, que Gitea necesita. -
Lleva los nombres y la red a la Gitea nueva. Cambia lo que apuntaba a
mon01fuera de los repositorios. En OPNsense,gitea.laba 10.10.0.11 y, ya,registry.laba la misma IP para el registry del 19 de febrero; en la matriz de reglas del laboratorio, la fila de Gitea paraapp01pasa de10.10.0.20:23001a10.10.0.11:443. Enmon01, quitagiteade la pila (su volumen se guarda una semana, por si algo no se copió bien) y apunta el receptor de incidencias ahttps://gitea.lab(GITEA_URL, ensecrets/tickets.env), para que las alertas de Mantenimiento sigan abriendo issues.Pista: el receptor usa
requests, que no lee el almacén del sistema: necesitaREQUESTS_CA_BUNDLEapuntando a unca.crtmontado en su contenedor. -
Cambia el remoto de cada copia de trabajo. Todas apuntan todavía a
http://gitea.lab:23001: pásalas ahttps://gitea.lab/ops/<repositorio>.gity comprueba congit fetchque llega su historial, que es la prueba de que la mudanza no ha perdido nada.Máquina Copias de trabajo app01/opt/servicio(servicio)mon01/opt/monitoringy/opt/alertingjenkins01~/jenkins-configpuesto de administración iac-lab,operacionyentregas-5166Pista: la máquina que aún no confía en la CA del curso falla con
server certificate verification failed; la CA va a su almacén del sistema. -
Da a Jenkins permiso para leer, y nada más. En Gitea, el usuario de servicio
jenkins, colaborador de lectura deops/servicio, con un token de alcanceread:repositoryúnicamente; en Jenkins, el servidorhttps://gitea.lab(Manage Jenkins → System → Gitea Servers) y la carpetaserviciocon la credencialgit-ro(Username with password:jenkinsy el token). Si alguien roba esa credencial, puede leer el código, pero no cambiarlo. -
Crea el proyecto Multibranch. Sube a la raíz de
serviciounJenkinsfilemínimo, una etapa enagent { label 'docker' }concheckout scm, y crea en la carpetaservicioel Multibranch Pipelineci, con origen Gitea,git-ro, descubrimiento de ramas y "Discard old items". El primer escaneo tiene que crear el subjobmain: es la prueba de que Jenkins ve el repositorio con su credencial. -
Haz que el push lo dispare solo. Crea en Gitea el webhook del repositorio hacia
https://jenkins.lab/gitea-webhook/post, de tipo Gitea, con un secreto largo que pongas también en el servidor Gitea de Jenkins. Pruébalo con un commit trivial: la entrega sale con 200 en la pestaña del webhook, y en Jenkins arrancan el escaneo y la ejecución.
Comprobación git fetch funciona contra https://gitea.lab en todas las copias de trabajo de la tabla del paso 3; la ejecución arranca en menos de un minuto tras el push sin pulsar nada; el log muestra el checkout scm en agent01 y en ningún sitio aparece el token.
Para practicar Guarda en A6.4 dos capturas, que pide la práctica evaluable: el aviso del webhook en Gitea con su código de respuesta y la ejecución que disparó el push.
Si te sobra tiempo Crea una rama feature/prueba, haz push y comprueba que aparece como subjob; bórrala y comprueba que desaparece tras el siguiente escaneo.
Sesión 34 · Pipeline I: build y test
Desde que el webhook está enganchado, cada push al repositorio del servicio arranca una ejecución, pero esa ejecución solo clona el código: todavía no comprueba nada. Esta sesión escribe la primera mitad del pipeline del curso, la que convierte cada push en una respuesta: el código se construye, las pruebas pasan o no, y Jenkins dice cuál ha fallado. La teoría presenta el Jenkinsfile entero, porque cada parte se entiende mejor viendo dónde va, y lo explica en el orden en que se lee: dónde corre cada etapa y con qué límites, cómo viaja el código de una etapa a otra, y cómo se ejecutan las pruebas y se convierte su resultado en el color de la ejecución. La hoja escribe solo Checkout y Build & Test.
Pipeline declarativo
Qué es un Jenkinsfile declarativo. Jenkins entiende dos formas de escribir un pipeline, las dos en Groovy. La scripted es código libre; la declarativa, la que se usa en el curso, tiene una estructura fija (pipeline, agent, stages, post...) que Jenkins comprueba antes de ejecutar nada, así que un error de forma se ve antes de empezar y no a mitad de un despliegue. Cuando hace falta algo que solo existe en la forma scripted, se mete en un bloque script { }.
El pipeline del curso. Ya está todo montado; ahora toca escribir lo que Jenkins tiene que hacer con cada cambio. Este es el Jenkinsfile del servicio del curso, en la raíz del repositorio servicio; conviene leerlo entero una vez antes de ir sección a sección. Tres cosas en las que fijarse: cada stage declara su propio agente, ninguna contraseña aparece escrita, y la etapa Deploy solo corre si se pide con un parámetro. Con este fichero y el proyecto Multibranch de la A6.4, cada push a main acaba en una ejecución con Checkout, Build & Test y Package en verde, y Deploy saltada si nadie ha pedido desplegar.
pipeline {
agent none
options {
timeout(time: 30, unit: 'MINUTES')
buildDiscarder(logRotator(numToKeepStr: '20'))
disableConcurrentBuilds()
skipDefaultCheckout()
}
parameters {
choice(name: 'ENV', choices: ['pre'], description: 'Entorno de despliegue')
booleanParam(name: 'RUN_DEPLOY', defaultValue: false)
}
environment {
REGISTRY = 'registry.lab:5000'
IMAGEN = "${REGISTRY}/app"
TG_CHAT = '<chat_id del grupo de Telegram>'
}
stages {
stage('Checkout') {
agent { label 'docker' }
steps {
script { env.TAG = checkout(scm).GIT_COMMIT.take(7) }
stash 'src'
}
}
stage('Build & Test') {
agent { docker { image 'python:3.12'; label 'docker' } }
steps {
unstash 'src'
sh '''
cd api
python -m venv /tmp/venv
/tmp/venv/bin/pip install -q -r requirements.txt
/tmp/venv/bin/pytest --junitxml=../report.xml || true
'''
}
post { always { junit 'report.xml' } }
}
stage('Package') {
when { beforeAgent true; branch 'main' }
agent { label 'docker' }
stages {
stage('Construir') {
steps {
unstash 'src'
script { docker.build("${IMAGEN}:${TAG}", 'api') }
}
}
// Aquí va la etapa 'Escaneo de vulnerabilidades' de la A7.6 de Mantenimiento:
// escanea ${IMAGEN}:${TAG} después de construirla y antes de subirla.
stage('Subir') {
steps {
script {
docker.withRegistry("https://${REGISTRY}", 'registry-cred') {
docker.image("${IMAGEN}:${TAG}").push()
}
}
}
}
}
}
stage('Deploy') {
when { allOf { branch 'main'; expression { params.RUN_DEPLOY } } }
steps {
build job: "/servicio/${params.ENV}/despliegue",
parameters: [string(name: 'TAG', value: env.TAG)]
}
}
}
post {
unsuccessful {
node('docker') {
withCredentials([string(credentialsId: 'telegram-token', variable: 'TG_TOKEN')]) {
sh 'curl -s -o /dev/null "https://api.telegram.org/bot$TG_TOKEN/sendMessage" -d chat_id="$TG_CHAT" -d text="$JOB_NAME #$BUILD_NUMBER no ha acabado en verde: $BUILD_URL"'
}
}
}
always { node('docker') { cleanWs() } }
}
}
Dónde corre cada etapa y con qué límites
pipeline y agent none. Todo Jenkinsfile declarativo empieza con pipeline { }. agent none dice que el pipeline no reserva ningún agente de entrada; cada etapa pide el suyo, como se explicó en Elegir el agente desde el Jenkinsfile. Si hubiera agent any, Jenkins cogería el primer ejecutor libre y, con los del controlador a 0, sería un agente cualquiera.
options. Límites del pipeline entero, y cada uno evita un problema concreto:
timeoutde 30 minutos: una ejecución colgada no bloquea un ejecutor para siempre.buildDiscarderguarda solo las últimas 20 ejecuciones de cada rama, para que el historial no llenejenkins_home.disableConcurrentBuildsencola una ejecución si ya hay otra en marcha, que es obligatorio en cuanto una etapa toca algo compartido, como el entorno donde se despliega.skipDefaultCheckoutapaga el clonado automático de cada etapa, que se explica en el apartado siguiente.
Otras que se usan mucho: timestamps(), que pone la hora en cada línea del log, y retry(2) a nivel de pipeline.
Qué viaja de una etapa a otra
Etapas y pasos. stages agrupa las etapas, que se ejecutan en orden; cada stage tiene un nombre, el que se ve en la vista del pipeline, y sus steps, los pasos que ejecuta.
El checkout implícito, y por qué el curso lo apaga. Cuando el Jenkinsfile sale de un repositorio y una etapa, o el pipeline entero, declara un agente, Jenkins clona ese repositorio en su directorio de trabajo antes de ejecutar nada: es el checkout implícito, y por eso un Jenkinsfile sencillo encuentra el código sin pedirlo. Con un agente por etapa, eso supone clonar otra vez en cada etapa. El pipeline del curso lo apaga con skipDefaultCheckout() y clona una sola vez, en la etapa Checkout, con checkout scm; la configuración del repositorio y su credencial git-ro las aporta el Multibranch. Así todas las etapas trabajan sobre el mismo commit, cuyos siete primeros caracteres quedan en TAG: env.TAG = ... dentro de script deja la variable para todas las etapas siguientes.
stash y unstash. Si las etapas no clonan, el código tiene que llegarles de otra forma. stash 'src' guarda en el controlador, con ese nombre, los ficheros del directorio de trabajo, y unstash 'src' los deja en el directorio de la etapa que lo pide, esté en el agente que esté; como los ficheros viajan por el controlador, el stash no sirve para gigabytes. En el laboratorio hay un solo agente con la etiqueta docker, y las etapas que lo piden caen en el mismo directorio de agent01, así que los ficheros de Checkout seguirían ahí aunque faltase el unstash. El día que haya un segundo agente, que una etapa limpie su directorio o que dos etapas corran a la vez en el mismo agente (cada una en su propio directorio), ya no estarían: el stash hace que el pipeline no dependa de esa casualidad. Para guardar algo con la ejecución y poder descargarlo después hay otro paso, archiveArtifacts.
Las pruebas y el color de la ejecución
Pruebas sin instalar Python en el agente. Build & Test corre en un contenedor python:3.12 lanzado sobre un agente con etiqueta docker: Jenkins arranca el contenedor en agent01, monta dentro el directorio de trabajo y ejecuta ahí los pasos. Las dependencias se instalan en un entorno virtual de /tmp porque el contenedor corre con el usuario de Jenkins, que no puede escribir en el Python del sistema. pip install las descarga en cada ejecución; con un requirements.txt grande se arregla con una imagen propia que ya las lleve.
El informe. pytest (el ejecutor de pruebas de Python) con --junitxml deja el resultado en JUnit, un formato XML de resultados de pruebas que entienden casi todas las herramientas, y el post { always { junit ... } } de la etapa lo publica pase lo que pase. Con él, Jenkins enseña cada prueba, cuál ha fallado y su histórico de una ejecución a otra.
Amarillo o rojo. Un pipeline distingue entre "se ha roto" y "ha funcionado, pero el resultado no es aceptable", y aquí es donde se decide. pytest sale con 1 cuando falla alguna prueba, y un sh que acaba en distinto de 0 corta el pipeline con FAILURE, en rojo. El || true del final le quita esa decisión al sh y se la deja a junit: si el informe trae pruebas rojas, marca la ejecución como UNSTABLE, en amarillo, y el pipeline sigue. Si pip falla o pytest ni siquiera llega a ejecutarse, el sh se corta antes o no hay informe que publicar, y el resultado es FAILURE, que es lo que tiene que ser.
post del pipeline. Qué hacer al terminar según el resultado. unsuccessful (cualquier final que no sea SUCCESS) avisa por Telegram con un curl a la API del bot, y always limpia el workspace con cleanWs(). Van dentro de node('docker') porque, con agent none, el post del pipeline no tiene agente, y sh y cleanWs lo necesitan. Con Slack cambia solo la URL del curl. Las condiciones disponibles son always, success, failure, unstable, aborted, unsuccessful, changed (cambió respecto a la anterior), fixed (pasó de rojo o amarillo a verde), regression y cleanup (la última de todas). Este post se monta el 24 de febrero, al probar el pipeline por los caminos que acaban mal, y ese día se decide también qué hacen las etapas siguientes con una ejecución en amarillo.
Lo que llega en las sesiones siguientes
Estas cuatro piezas del fichero no se escriben hoy: parameters, environment y Package llegan el 19 de febrero, con el registry, y Deploy, el 26, con el despliegue en pre.
parameters. Variables que se rellenan al lanzar el pipeline, a mano o por API: ENV con una lista cerrada, que en el laboratorio tiene un solo valor, pre (en una empresa tendría también pro, cada uno con su carpeta y su credencial), y RUN_DEPLOY como booleano. Se leen con params.ENV. Jenkins descubre los parámetros al ejecutar el Jenkinsfile, así que la primera ejecución tras añadirlos todavía no deja elegirlos; desde la segunda aparece «Build with Parameters». Con string, text, password y choice se cubre casi todo; password no es una credencial, es un campo que no se muestra.
environment. Variables de entorno para todas las etapas: el registry, el nombre de la imagen (IMAGEN) y el chat_id del grupo de Telegram, que no es secreto. Se pueden definir también dentro de un stage, y pueden leer credenciales (TOKEN = credentials('telegram-token')), pero es preferible withCredentials, que acota el secreto a un bloque en lugar de dejarlo en el entorno de todas las etapas. Las variables predefinidas más frecuentes: BUILD_NUMBER, JOB_NAME, BUILD_URL, GIT_COMMIT, GIT_BRANCH, BRANCH_NAME (esta solo en Multibranch), WORKSPACE.
Package. Solo en main, y en dos etapas anidadas que corren en el mismo agente y comparten workspace. Construir hace docker.build con el contexto api/, que es donde vive el api/Dockerfile del repositorio, y etiqueta la imagen con TAG para que sea trazable hasta la línea de código que contiene. Subir inicia sesión en el registry con la credencial registry-cred mediante docker.withRegistry, solo mientras dura el bloque, y sube la imagen. Entre las dos queda marcado el hueco de la etapa de escaneo de Trivy de Mantenimiento, que usa las mismas IMAGEN y TAG. El bloque script { } es necesario porque docker.build es un paso de la sintaxis scripted; el declarativo lo permite dentro de script. El agente necesita el CLI de Docker y acceso al demonio.
Deploy. El when la deja para main y solo si RUN_DEPLOY está marcado, así el mismo pipeline sirve para validar cada push y para desplegar cuando alguien lo decide. La etapa no despliega ella misma: lanza con build job el job despliegue de la carpeta del entorno (servicio/pre), le pasa el TAG y espera su resultado, que pasa a ser el de la etapa. Así la clave que entra en las VM de pre vive en esa carpeta y el Multibranch, que ejecuta el código de cualquier rama, no la ve nunca.
flowchart TD
CO["<b>Checkout</b>"]:::pieza
BT["<b>Build y Test</b>"]:::pieza
PK["<b>Package</b><br><small>solo en main</small>"]:::pieza
W{"<b>¿RUN_DEPLOY?</b>"}:::dato
DP["<b>Deploy</b><br><small>job servicio/pre/despliegue</small>"]:::pieza
F1["<b>FAILURE</b><br><small>pip o pytest no arrancan</small>"]:::riesgo
F2["<b>FAILURE</b><br><small>registry inaccesible, tras 3 reintentos</small>"]:::riesgo
F4["<b>FAILURE</b><br><small>desplegado pero no responde</small>"]:::riesgo
OK1(["<b>Fin sin desplegar</b><br><small>SUCCESS, o UNSTABLE si hubo pruebas rojas</small>"]):::ok
OK2(["<b>Fin con despliegue</b><br><small>SUCCESS, o UNSTABLE si hubo pruebas rojas</small>"]):::ok
P["<b>post unsuccessful</b><br><small>aviso por Telegram</small>"]:::act
C["<b>post always</b><br><small>cleanWs</small>"]:::act
CO --> BT
BT -->|pruebas en verde| PK
BT -.->|pruebas rojas · UNSTABLE y sigue| PK
BT -->|no arrancan| F1
PK -->|push OK| W
PK -->|sin registry| F2
W -->|no| OK1
W -->|sí| DP
DP -->|todo OK| OK2
DP -->|test.sh falla| F4
F1 & F2 & F4 --> P
OK1 & OK2 -.->|si acabó en UNSTABLE| P
OK1 & OK2 --> C
P --> C
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxLos finales del pipeline. Una prueba roja no lo para: lo deja en UNSTABLE y sigue. Lo que se evalúa en la práctica es haber recorrido los caminos rojos, no solo los verdes.
A6.5 Pipeline I: build y test (sesión 34)
Objetivo Al terminar, cada push al repositorio del servicio construye y prueba el código en un contenedor de Python y publica el resultado de las pruebas en Jenkins, con un Jenkinsfile que tiene Checkout y Build & Test y que marca UNSTABLE cuando una prueba falla. Es la integración continua de verdad: desde hoy, un cambio que rompe una prueba se ve a los pocos minutos, con la prueba concreta señalada y sin confundirlo con un pipeline roto.
Antes de empezar El Multibranch de la A6.4 disparándose por webhook, y el repositorio servicio con la API en api/: sus pruebas (pytest), su requirements.txt y su api/Dockerfile. Se han explicado la sintaxis del pipeline declarativo, qué viaja de una etapa a otra y cómo se convierten las pruebas en el color de la ejecución.
Pasos
Escribes la primera mitad del pipeline del curso y la pruebas pieza a pieza. Primero, que funciona y publica el informe. Después, dónde corre cada etapa y qué le llega, que es lo que más se confunde. Luego dejas lista, a mano, la imagen que el pipeline construirá desde el 19 de febrero, para que un fallo del Dockerfile no se confunda entonces con un fallo del pipeline. Y al final compruebas los límites del bloque options y los colores de la ejecución. La tabla del último paso recoge todo y crece cada sesión hasta la evaluable.
-
Escribe
CheckoutyBuild & Test. Sustituye elJenkinsfilemínimo porCheckoutyBuild & Testdel pipeline declarativo, con suagent noney su bloqueoptions, y ciérralo conpost { always { echo "Resultado: ${currentBuild.currentResult}" } }, que te dirá en cada ejecución cómo ha acabado. Comprueba que la pestaña "Test Result" de la ejecución lista las pruebas: es la señal de quejunitha leído el informe. -
Mira dónde corre cada etapa y qué le llega. Que una etapa encuentre el código no prueba que el pipeline esté bien hecho, y este paso lo comprueba. Anota, del log, en qué agente y en qué directorio de trabajo ha corrido cada etapa, y cuántas veces se ha clonado el repositorio en la ejecución. Quita después el
unstash 'src'deBuild & Test, relánzalo, explica en tus notas el resultado con lo que has anotado y con Qué viaja de una etapa a otra, y vuelve a ponerlo. -
Deja lista la imagen del servicio. Deja listo para la etapa
Packageelapi/Dockerfiledel repositorio, el que el servicio comparte con Mantenimiento: base fijada,requirements.txten una capa aparte de la del código, un usuario que no sea root,EXPOSE 28080y unCMDque arranque gunicorn en ese mismo puerto (--bind 0.0.0.0:28080), porqueEXPOSEsolo lo anuncia. Constrúyelo a mano enagent01comoapp:pruebay comprueba que la imagen no corre como root y expone el 28080.Pista: el código ya está en
agent01, en el directorio de trabajo que anotaste en el paso 2.docker image inspectda el usuario y los puertos, dentro deConfig. -
Comprueba los límites del bloque
options. Lanza dos ejecuciones seguidas, sin esperar a que acabe la primera, y mira en la cola qué hacedisableConcurrentBuilds(); cuenta después cuántas ejecuciones guarda el historial conbuildDiscarder. Anota las dos observaciones: son los límites que impiden que dos despliegues se pisen y que el historial crezca sin fin.Pista: con menos de veinte ejecuciones el historial no se recorta; para verlo, baja un momento
numToKeepStra 3 y lanza una más. -
Pon una prueba en rojo y vuelve a verde. Haz fallar una prueba (
assert False) y observa el estado UNSTABLE y la prueba roja en el informe. Añade alpostdel pipeline unfixed { echo 'Vuelve a estar en verde' }y arregla la prueba: la ejecución tiene que salir SUCCESS con ese mensaje en el log. -
Documenta el pipeline. Documenta el pipeline de hoy en una tabla dentro del repositorio del servicio, porque crece en cada sesión hasta la práctica evaluable: etapa, agente, qué hace, qué produce (informe JUnit,
stash, imagen) y en qué estado deja la ejecución si falla.
Comprobación Tres ejecuciones seguidas: verde, amarilla, verde; en la tercera aparece el echo de fixed; el contenedor python:3.12 no queda en docker ps -a de agent01; app:prueba se construye desde api/ con un usuario que no es root y el 28080 expuesto; y tus notas del paso 2 explican, con el agente y el directorio de cada etapa, por qué la ejecución sin unstash ha pasado igual en el laboratorio y cuándo fallaría.
Para practicar Sube a servicio el Jenkinsfile, la tabla de etapas y, si lo has completado, el api/Dockerfile, y guarda en A6.5 una captura del historial con las tres ejecuciones y otra de la ejecución encolada del paso 4.
Si te sobra tiempo Mide cuánto tarda pip install y prueba una imagen propia con las dependencias ya instaladas.
Sesión 35 · Pipeline II: package y ejecución condicional
El pipeline ya prueba cada cambio, pero no produce nada que se pueda desplegar: la imagen del servicio se sigue construyendo a mano. Esta sesión añade la etapa que la construye y la publica, Package, y para eso antes hace falta un sitio donde publicarla: un registry propio, con TLS y contraseña, en gitea01. En cuanto el pipeline empaqueta aparece el segundo problema: lo haría en cada push de cada rama, y llenaría el registry de imágenes que nadie va a desplegar. Por eso la sesión junta las dos mitades: el primer apartado explica el registry y cómo confía Docker en la CA del curso; el segundo, las directivas del declarativo que deciden qué se ejecuta, cuándo y con qué valores.
Package y el registry local
Qué es un registry y por qué uno propio. Un registry es el servidor del que docker pull descarga las imágenes y al que docker push las sube. Docker Hub es el público; las imágenes del servicio no tienen por qué serlo, y el pipeline no debería depender de Internet para guardar lo que produce. Por eso el laboratorio tiene uno propio, y la etapa Package sube ahí cada imagen que construye.
Cómo sabe Docker a qué registry va una imagen. Por el nombre. Si lo que va antes de la primera barra lleva un punto o dos puntos, es el registry: registry.lab:5000/app:1a2b3c4 se sube a registry.lab:5000, al repositorio app, con la etiqueta 1a2b3c4; python:3.12, sin nada delante, viene de Docker Hub. Por eso el pipeline construye la imagen ya con su nombre completo, IMAGEN, y por eso el registry se escribe siempre con su puerto.
Por qué la etiqueta es el commit. TAG son los siete primeros caracteres del commit. Con ellos, dada una imagen se sabe qué código lleva, y dado un commit, qué imagen se construyó con él; una etiqueta como latest no dice nada de eso.
Dónde vive. En el laboratorio, el registry corre en gitea01 (10.10.0.11), la misma VM que sirve Gitea, y registry.lab resuelve a esa IP desde la A6.4: es un servicio de plataforma de la subred de gestión, no del entorno. Su compose.yml se versiona en jenkins-config junto al resto de la instalación, aunque se despliegue en gitea01. registry:2 (el proyecto se llama ahora Distribution y publica también registry:3, compatible en todo lo que se usa aquí) es un contenedor de un solo binario que almacena imágenes en un directorio.
Cómo se protege. Sin TLS, Docker se niega a hablar con un registry salvo que se declare como insecure registry, una mala costumbre que luego alguien copia en producción. Con un certificado de la CA del curso, el compose queda así, con TLS y con autenticación básica mediante un fichero htpasswd (usuario y contraseña cifrada, el mismo formato que usa Apache). El compose, la línea de htpasswd y la comprobación están enteros porque la hoja A6.6 los copia:
# registry/compose.yml
services:
registry:
image: registry:2
ports: ["5000:5000"]
volumes:
- registry_data:/var/lib/registry
- ./certs:/certs:ro
- ./auth:/auth:ro
environment:
REGISTRY_HTTP_TLS_CERTIFICATE: /certs/registry.crt
REGISTRY_HTTP_TLS_KEY: /certs/registry.key
REGISTRY_AUTH: htpasswd
REGISTRY_AUTH_HTPASSWD_REALM: "Registry lab"
REGISTRY_AUTH_HTPASSWD_PATH: /auth/htpasswd
volumes:
registry_data:
# usuario jenkins para el registry (bcrypt, el único formato que acepta)
htpasswd -Bc auth/htpasswd jenkins
# o sin apache2-utils:
docker run --rm --entrypoint htpasswd httpd:2 -Bbn jenkins 'S3creto' > auth/htpasswd
El fichero no guarda la contraseña, sino su resumen con bcrypt, un algoritmo de hash pensado para contraseñas, que es el único formato que acepta el registry.
Cómo confía Docker en la CA. Para que Docker confíe en la CA hay dos caminos. El específico de Docker: copiar ca.crt a /etc/docker/certs.d/registry.lab:5000/ca.crt (el nombre del directorio es exactamente host:puerto), sin reiniciar nada. El del sistema: cp ca.crt /usr/local/share/ca-certificates/lab-ca.crt && update-ca-certificates && systemctl restart docker, que además vale para curl y git. En el laboratorio se usa el segundo, y en agent01 ya está hecho: la A6.3 metió la CA en su almacén antes de reiniciar el demonio. Las VM de pre no descargan del registry, porque desde pre no se llega a gestión: la imagen les llega por SSH, con docker save y docker load.
Cómo se comprueba. curl --cacert ca.crt -u jenkins https://registry.lab:5000/v2/_catalog debe devolver la lista de repositorios, y /v2/app/tags/list las etiquetas que ha subido el pipeline.
Más directivas que hacen falta
Con Package subiendo la imagen, el pipeline hace ya todo lo que sabe hacer en cada push, y eso es demasiado: empaqueta ramas que nadie va a desplegar y no ofrece forma de pedirle un despliegue concreto. Lo que falta son las directivas que deciden qué se ejecuta, cuándo y con qué valores: parameters para que quien lanza elija (presentada con el pipeline completo), when para las condiciones, parallel para ganar tiempo e input para la aprobación manual. La hoja A6.6 usa parameters, when y parallel; input no lo usa ninguna hoja y queda como la forma de poner una aprobación humana delante de un despliegue.
when. Condiciones de ejecución (rama, parámetro, cambio en ficheros). Se pueden combinar con allOf, anyOf y not, y la etapa que no las cumple sale como saltada:
when {
beforeAgent true // evalúa antes de reservar agente
allOf {
branch 'main'
expression { params.RUN_DEPLOY }
not { changeRequest() } // no en merge requests
}
}
// otras: changeset 'infra/**' (solo si cambió algo bajo infra/)
// environment name: 'ENV', value: 'pre'
// tag 'v*'
beforeAgent true importa más de lo que parece: sin él, Jenkins reserva el agente de la etapa y después descubre que no tiene que ejecutarla.
parallel. Etapas simultáneas, cada una con su agente. En el curso, las pruebas y el lint del código con ruff, un analizador de estilo y errores de Python, que no dependen una de otra y así tardan lo que la más lenta. Con failFast true, si una falla se abortan las demás:
stage('Calidad') {
failFast true
parallel {
stage('Test') {
agent { docker { image 'python:3.12'; label 'docker' } }
steps {
unstash 'src'
sh '''
cd api
python -m venv /tmp/venv
/tmp/venv/bin/pip install -q -r requirements.txt
/tmp/venv/bin/pytest --junitxml=../report.xml || true
'''
}
post { always { junit 'report.xml' } }
}
stage('Lint') {
agent { docker { image 'python:3.12'; label 'docker' } }
steps {
unstash 'src'
sh 'python -m venv /tmp/venv && /tmp/venv/bin/pip install -q ruff && /tmp/venv/bin/ruff check api'
}
}
}
}
matrix. Genera una etapa por cada combinación de ejes, por ejemplo para probar contra varias versiones de Python a la vez. El pipeline del curso no la usa; el bloque de ejemplo está en Para ampliar.
input. Pausa el pipeline hasta que alguien con permiso aprueba; es la puerta manual de la entrega continua. Conviene usar la directiva input de la etapa, como en el ejemplo, y no el paso input dentro de steps: la directiva espera antes de reservar el agente de la etapa, así que, con agent none en el pipeline, no ocupa ningún ejecutor mientras nadie contesta. El timeout evita que la ejecución quede abierta para siempre, y beforeInput true hace que el when se evalúe antes de preguntar:
stage('Aprobar pre') {
when { beforeInput true; environment name: 'ENV', value: 'pre' }
options { timeout(time: 1, unit: 'HOURS') }
input { message '¿Desplegar en pre?'; ok 'Adelante'; submitter 'admin' }
steps { echo "Aprobado" }
}
Shared libraries. Cuando hay diez repositorios con el mismo Jenkinsfile cambiando tres líneas, la lógica común se saca a una biblioteca compartida (un repositorio Git con ficheros Groovy en vars/) y cada Jenkinsfile queda en @Library('lab') _ más una llamada a pipelinePython(image: 'python:3.12'). En el módulo no se escriben, pero aparecen en cualquier empresa con más de unos pocos proyectos, y conviene saber que existen porque explican por qué muchos Jenkinsfile reales tienen cinco líneas.
A6.6 Pipeline II: package y ejecución condicional (sesión 35)
Objetivo Al terminar, el pipeline produce algo que se puede desplegar: la imagen del servicio, etiquetada con su commit, en un registry local con TLS y autenticación. Y lo hace solo cuando toca: es un pipeline parametrizado, con Lint en paralelo y Package solo en main, y su tabla de verdad está comprobada ejecución a ejecución. Esa tabla es la prueba de que las condiciones hacen lo que dicen, y es lo que evita que una rama de pruebas acabe desplegada.
Antes de empezar El pipeline de la A6.5 en verde, registry.lab resolviendo a gitea01 (10.10.0.11) desde la A6.4, agent01 confiando en la CA del curso desde la A6.3, y el api/Dockerfile del servicio revisado y construido a mano en la A6.5. Se han explicado el registry local y cómo confía Docker en una CA y las directivas when y parallel.
Pasos
Primero el sitio donde van las imágenes, el registry, y la comprobación de que el agente habla con él; después la etapa que las sube. Con el pipeline ya empaquetando, le pones las condiciones: los parámetros, la etapa en paralelo y, al final, la tabla de verdad, que recorre las cuatro combinaciones de rama y parámetro. La tabla va al final porque es la que comprueba todo lo anterior a la vez.
-
Levanta el registry. Levanta el registry en
/opt/registrydegitea01con elcompose.ymlde Package y el registry local tal cual, su certificado deregistry.labencerts/, emitido como el de la A6.2, y el usuariojenkinsenauth/htpasswd./v2/_catalogtiene que responder al puesto de administración con ese usuario.Pista: guarda la contraseña en tu gestor de contraseñas: la pide la credencial del paso 2.
-
Comprueba que el agente llega y dale la credencial a Jenkins. Comprueba que
agent01llega al registry por TLS sin error de certificado (/v2/da 401: pide usuario), porque esagent01quien va a subir las imágenes, y crea en la carpetaserviciola credencialregistry-cred(Username with password, usuariojenkins). -
Añade la etapa
Package. Añade alJenkinsfileel bloqueenvironmentconREGISTRYeIMAGENy la etapaPackagedel pipeline declarativo tal cual, con sus dos etapas anidadas y el comentario que marca el hueco de la etapa de escaneo de la A7.6 de Mantenimiento. Comprueba que la etiqueta del commit llega al registry. -
Haz que los parámetros se usen de verdad. En un solo cambio, para no encadenar cuatro ejecuciones, añade el bloque
parametersdel pipeline declarativo y haz que los dos parámetros se lean: unechode los dos al principio deCheckouty una etapaDeployprovisional con elwhende la definitiva y un únicoecho "Desplegaría ${IMAGEN}:${TAG} en ${params.ENV}", que se sustituye por el despliegue el 26 de febrero.Pista: la primera ejecución tras añadir
parameterscorre sin poder elegirlos, porque Jenkins aún no los conoce; desde la segunda tienes «Build with Parameters». -
Pasa las pruebas y el lint en paralelo. Convierte
Build & Testen la etapaCalidadde Más directivas que hacen falta, conTestyLinten paralelo yfailFast true, para que el pipeline tarde lo que la más lenta de las dos y no la suma. -
Recorre la tabla de verdad. Ramas
mainyfeature/x, cada una conRUN_DEPLOYmarcado y sin marcar. De cada combinación anota qué etapas se ejecutaron, cuáles salieron NOT_BUILT y con qué etiqueta subió la imagen, si subió, en dos columnas: lo esperado y lo obtenido. Una casilla que no coincide es una condición mal escrita, y se corrige aquí. Añade a la tabla de etapas de la A6.5 la condición que activa cada una y los parámetros que lee.Pista:
feature/xse lanza con "Build with Parameters" sobre el subjob de la rama.
Comprobación curl --cacert ~/ca/ca.crt -u jenkins https://registry.lab:5000/v2/app/tags/list devuelve la etiqueta del commit; en el log la contraseña del registry aparece como ****; en feature/x, Package y Deploy salen como NOT_BUILT y en main Package se ejecuta; y las cuatro casillas de la tabla de verdad coinciden con lo esperado.
Para practicar Sube el compose.yml del registry a jenkins-config, sin el htpasswd, y el Jenkinsfile a servicio. Guarda en A6.6 la salida del curl de tags y la tabla de verdad del paso 6 con sus cuatro números de build: la pide la práctica evaluable.
Si te sobra tiempo Comprueba que failFast hace lo que dice: mete un error de estilo que ruff detecte, push, y anota si Test llegó a terminar o se cortó. Mira también qué añade beforeAgent true: quítalo, vuelve a lanzar en feature/x y busca en el log si Jenkins ha pedido agente para una etapa que no iba a ejecutar. Y pon el nginx de gitea01 delante del registry para que sea él quien termine el TLS, manteniendo el registry.lab:5000 que usa el pipeline.
Sesión 36 · Gestión de errores
Hasta ahora el pipeline se ha visto casi siempre en verde, y un pipeline que solo se ha visto en verde no está probado: nadie sabe qué hace el día que el registry no responde, una prueba falla o alguien cancela a mitad. Esta sesión lo prueba por los caminos que acaban mal, y para eso hacen falta cuatro cosas, en este orden: un vocabulario común para los finales posibles (los estados de una ejecución), las herramientas que deciden qué pasa en cada uno (timeout, retry, catchError y post), un aviso que llegue a alguien cuando el final no es verde, y un plan que diga qué fallos provocar y qué comprobar después de cada uno. La hoja pasa cuatro de los cinco casos del plan; el quinto necesita un despliegue que todavía no existe.
Gestión de errores
Probar los caminos que fallan. Un pipeline se prueba como cualquier programa: hay que recorrer todos los caminos, incluidos los de fallo. El día que el registry no responda o alguien cancele a mitad de un despliegue se verá qué hace de verdad, y es mejor verlo antes, a propósito y con el entorno de pruebas.
flowchart TB
E["<b>Etapa</b>"]:::pieza
T{"<b>¿Responde a tiempo?</b>"}:::act
TO["<b>timeout</b><br><small>corta y no deja el trabajo colgado</small>"]:::riesgo
F{"<b>¿Falló?</b>"}:::act
RE["<b>retry</b><br><small>para fallos transitorios, no para bugs</small>"]:::act
CE["<b>catchError</b><br><small>sigue pero marca el resultado</small>"]:::pieza
POST["<b>post</b><br><small>always · success · failure · cleanup</small>"]:::dato
EST(["<b>Estado conocido</b><br><small>sin contenedores vivos ni workspace sucio</small>"]):::ok
E --> T
T -- no --> TO --> POST
T -- sí --> F
F -- sí --> RE --> CE --> POST
F -- no --> POST
POST --> EST
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxUn pipeline que solo se ha visto en verde no está probado. Lo que se evalúa es que cada camino deje el entorno en un estado del que se pueda volver.
Los cinco finales. Toda ejecución, y cada una de sus etapas, acaba en uno de estos estados, y cada uno significa algo distinto:
| Estado | Qué significa | Cuándo se produce |
|---|---|---|
| SUCCESS | Todo se ejecutó y todo fue bien | Ningún paso devolvió error |
| UNSTABLE | Todo se ejecutó, pero el resultado no es aceptable | junit con pruebas rojas, catchError(buildResult: 'UNSTABLE'), unstable('motivo') |
| FAILURE | Se rompió y no siguió | Un sh devolvió distinto de 0, una excepción, un error('motivo') |
| ABORTED | Alguien o algo lo paró | Cancelación manual, timeout, input rechazado |
| NOT_BUILT | No llegó a ejecutarse | Etapa saltada por su when |
Las herramientas. Para decidir qué pasa en cada caso:
timeoutpor etapa para que nada quede colgado:options { timeout(time: 10, unit: 'MINUTES') }dentro delstage. El del pipeline entero (30 minutos) es la red de seguridad; el de cada etapa avisa antes de dónde está el problema.retry(3)en pasos que fallan por causas externas (red, registry, unaptque no responde). No conviene ponerlo alrededor de un despliegue: si falló a medias, repetirlo sin mirar es peor.catchError(buildResult: 'UNSTABLE', stageResult: 'FAILURE')para seguir aunque una etapa no crítica falle: la etapa queda en rojo, el pipeline en amarillo y las siguientes se ejecutan. Típico para el lint o para publicar una métrica.shtermina el pipeline si el comando devuelve distinto de 0; capturar conreturnStatus: truecuando se quiere decidir (def rc = sh(script: 'bash test.sh', returnStatus: true)), yreturnStdout: truepara leer la salida.- Después de un UNSTABLE, el pipeline sigue ejecutando etapas, y eso incluye empaquetar código con pruebas rojas. Si no debe, se dice:
options { skipStagesAfterUnstable() }para todo el pipeline, o unwhen { expression { currentBuild.currentResult == 'SUCCESS' } }en la etapa que no debe correr. post { unsuccessful }notifica;post { always }limpia y archiva logs. Ypost { aborted }merece su propio bloque cuando una etapa puede quedar a medias.
Dónde va cada una en el curso. El fragmento siguiente es la etapa Package del pipeline con esas herramientas, y es el que copia la hoja A6.7: un timeout para la etapa entera y el retry alrededor de la subida al registry, que es el paso que falla por causas externas. No va alrededor de la construcción: si docker build falla, es por un error del Dockerfile y fallará igual tres veces.
stage('Package') {
when { beforeAgent true; branch 'main' }
agent { label 'docker' }
options { timeout(time: 10, unit: 'MINUTES') }
stages {
stage('Construir') {
steps {
unstash 'src'
script { docker.build("${IMAGEN}:${TAG}", 'api') }
}
}
// Aquí va la etapa 'Escaneo de vulnerabilidades' de la A7.6 de Mantenimiento
stage('Subir') {
steps {
retry(3) {
script {
docker.withRegistry("https://${REGISTRY}", 'registry-cred') {
docker.image("${IMAGEN}:${TAG}").push()
}
}
}
}
}
}
}
La decisión de fondo. Lo importante no es el código, es la decisión que hay detrás: cuando un despliegue falla, ¿se vuelve a la versión anterior o se deja para mirar? En pre se deja y se diagnostica, y volver es desplegar otra vez la etiqueta anterior, que sigue guardada; en producción se vuelve primero y se diagnostica después. Lo que no puede pasar es no saber en qué estado ha quedado el entorno, y por eso un despliegue termina siempre comprobando que el servicio responde: en el curso, con el test.sh de la UT5.
Avisar cuando algo no acaba en verde
Por qué solo cuando no acaba en verde. Un aviso por cada ejecución correcta se silencia en una semana, y con él los que importan. El pipeline avisa en post { unsuccessful }, que cubre cualquier final que no sea SUCCESS: FAILURE, UNSTABLE y ABORTED.
Cómo se manda. Con el bot de Telegram de la A2.5 de Mantenimiento, el que usa Alertmanager, que ya está en un grupo de pruebas. Un bot manda un mensaje con una petición a la API de Telegram, sendMessage, con dos datos: el token, que identifica al bot y permite hablar en su nombre, y el chat_id, que dice a qué grupo va. El token es un secreto, así que va en la credencial telegram-token (Secret text) de la carpeta servicio, y llega al curl con withCredentials; el chat_id no lo es, y va en el bloque environment como TG_CHAT. No hace falta ningún plugin: el curl del post del pipeline declarativo es todo.
Qué lleva el mensaje. El nombre del job, el número de ejecución y su URL, que son las variables predefinidas JOB_NAME, BUILD_NUMBER y BUILD_URL. Con eso, quien lo recibe abre la ejecución que ha fallado con un clic, sin buscarla.
Plan de pruebas del pipeline
Cinco casos, y para cada uno se anota cómo se provocó, el estado final del pipeline, la notificación recibida y el estado del workspace y del agente:
| Caso | Cómo provocarlo | Estado esperado | Qué comprobar |
|---|---|---|---|
| Fallo en test | Un assert False en un test y push |
UNSTABLE | El informe JUnit muestra la prueba roja; Package no se ejecuta (o sí, según lo que se haya decidido con when); hay aviso |
| Fallo en push | Cambiar la contraseña de registry-cred por una mala |
FAILURE tras 3 intentos | El log no muestra la contraseña; el aviso llega; la imagen no está en el registry |
| Timeout | sleep 700 en una etapa con timeout de 10 minutos |
ABORTED | El ejecutor queda libre; cleanWs se ejecutó; el proceso sleep no sigue vivo en el agente (ps aux en agent01) |
| Cancelación manual | Pulsar la X durante Calidad |
ABORTED | El contenedor python:3.12 no queda en docker ps -a; el workspace está limpio |
| Fallo en deploy | Un puerto equivocado en test.sh |
FAILURE | El log dice en qué etapa falló; pre queda con lo que se desplegó y se sabe cómo volver |
El quinto caso necesita la etapa Deploy de verdad, que se escribe el 26 de febrero: allí es uno de los dos caminos del despliegue, el fallo en el smoke test (la prueba mínima de que el servicio responde, aquí el test.sh). El otro es el despliegue correcto.
A6.7 Gestión de errores (sesión 36)
Objetivo Al terminar has visto fallar tu pipeline de cuatro maneras distintas, a propósito, y de cada una tienes una ficha con el estado final, la notificación y cómo quedó el agente; el quinto caso del plan queda preparado para la A6.8. Importa porque un pipeline que solo se ha visto en verde no está probado: estas fichas son el informe de pruebas de la práctica evaluable.
Antes de empezar El pipeline de la A6.6, y el bot de Telegram de la A2.5 de Mantenimiento: su token (el fichero /opt/alerting/secrets/tg_token de mon01) y el chat_id de su grupo. Se han explicado los estados de un pipeline, timeout, retry y catchError, el aviso por Telegram y el plan de pruebas.
Pasos
Primero preparas el pipeline para fallar bien: con el límite de tiempo, el reintento y el aviso, que son los que el plan va a poner a prueba. Después preparas la ficha, para que cada caso deje la misma información y se puedan comparar. Pasas los casos de dos en dos: primero los que acaban en un estado de fallo (prueba roja, push imposible) y después los que acaban parados (tiempo agotado, cancelación), que son los que dejan procesos y contenedores vivos en el agente si algo no está bien. Al final montas el informe, con el hueco del caso que todavía no se puede provocar.
-
Prepara el pipeline para fallar bien. Sustituye
Packagepor el fragmento de gestión de errores, con eltimeouty elretry(3), y copia elpostdel pipeline declarativo, con el aviso por Telegram ycleanWs(). Elchat_idva enTG_CHATy el token del bot, en la credencialtelegram-token(Secret text) de la carpetaservicio. -
Prepara la ficha de cada caso. Cada ficha lleva el número de build, cómo lo has provocado (el commit o el cambio exacto), estado esperado y obtenido, qué dice la notificación y cómo queda
agent01justo después (procesossleepopytest, contenedores endocker ps -a, workspace vacío o no). Si un caso no acaba como esperabas, corrige el pipeline, repítelo hasta que cuadre y anota en la ficha qué cambiaste. -
Provoca los dos fallos. Pasa los casos 1 y 2 del plan de pruebas, fallo en test y fallo en push, y comprueba en cada uno lo que dice su columna «Qué comprobar». En el 1, anota si
Packagese ha ejecutado con pruebas rojas y decide si debe, con las herramientas de gestión de errores: es una decisión que hay que tomar a conciencia, no heredar. En el 2, cuenta los intentos delretryy deja después la credencial buena. -
Provoca las dos paradas. Pasa los casos 3 y 4: el timeout, con el
sleepenPackage, que es la etapa que tiene su propiotimeout, y la cancelación en mitad deCalidad. Comprueba en los dos que el ejecutor queda libre, quecleanWs()se ha ejecutado y que enagent01no quedan ni elsleepni el contenedorpython:3.12. Si elsleepsigue vivo, eltimeoutha parado el step pero no el proceso: anótalo.Pista: para no perder la sesión esperando, baja el
timeoutde esa etapa a 1 minuto con unsleep 90. -
Monta el informe. Junta las fichas, cada una con su captura del historial y el trozo de log que demuestra el estado. El caso 5, fallo en deploy, queda abierto hasta la A6.8, el 26 de febrero, que trae la etapa
Deployde verdad: deja su ficha con el cómo provocarlo y el estado esperado, y hueco para una sexta, la del despliegue correcto.
Comprobación Cada caso acaba en el estado de la tabla del plan (UNSTABLE, FAILURE, ABORTED, ABORTED), la notificación llega en todos los fallos, no queda ningún sleep ni contenedor vivo en agent01, y ninguna ficha tiene la fila de "estado del agente" sin rellenar.
Para practicar Guarda en A6.7 el informe con las cinco fichas, la del quinto caso todavía abierta: la A6.8 cierra ese caso y añade al informe la ficha del despliegue correcto, seis en total. Para la A6.8, ten localizado iac-lab en el puesto de administración, con ansible/inventory.ini subido a Gitea.
Si te sobra tiempo Añade catchError(buildResult: 'UNSTABLE', stageResult: 'FAILURE') a Lint y comprueba que un error de estilo deja el pipeline amarillo sin parar Package.
Sesión 37 · Mínimo privilegio y despliegue
El pipeline ya construye, prueba, empaqueta y falla bien, pero no despliega: la etapa Deploy es todavía un echo. Desplegar en pre exige darle a Jenkins la credencial más delicada del laboratorio, una clave que entra con sudo en las tres máquinas de pre, y por eso la sesión empieza por el criterio antes que por la herramienta. El primer apartado explica el mínimo privilegio: quién tiene cada credencial, con qué alcance y dónde vive, con la tabla que sirve de plantilla del inventario. El segundo, el job que despliega, por qué es un job aparte del pipeline y su Jenkinsfile.deploy, que la hoja copia tal cual. Es el último despliegue en pre: el 9 de marzo, Mantenimiento detiene el servicio de pre para darlo de baja.
Mínimo privilegio
Cada credencial es una puerta. Cada credencial que gestiona Jenkins es un vector de ataque: quien controle el pipeline (por un Jenkinsfile malicioso en una rama, por un plugin vulnerable, por un agente comprometido) tiene lo que tengan las credenciales que ese pipeline puede usar. Cuanto menos tengan, menos daño. El mínimo privilegio es dar a cada usuario, servicio o token solo los permisos que necesita para su tarea y nada más.
flowchart LR
MAL["<b>Una credencial para todo</b><br><small>la cuenta de una persona</small>"]:::riesgo
TODO(["<b>Quien controle el pipeline<br>tiene pre, Gitea y el registry</b>"]):::riesgo
J["<b>Jenkins</b>"]:::pieza
S1["<b>ssh-pre</b><br><small>solo las tres VM de pre</small>"]:::ok
S2["<b>git-ro</b><br><small>solo lectura de dos repositorios</small>"]:::ok
S3["<b>registry-cred</b><br><small>solo la usa la etapa Subir</small>"]:::ok
CAR["<b>Credenciales por carpeta</b><br><small>ssh-pre solo existe en servicio/pre</small>"]:::act
MAL --> TODO
J --> S1 & S2 & S3
J --> CAR
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxUn usuario de servicio por integración, con lo justo. Y nunca la cuenta de una persona: el día que se va, el pipeline deja de funcionar.
Cómo se aplica en el curso:
- Un usuario de servicio por integración (Jenkins con Gitea, con el registry y con las VM de
pre), con solo los permisos que usa. Nunca la cuenta de una persona: cuando esa persona se va, o cambia su contraseña, el pipeline deja de funcionar, y mientras tanto todo lo que hace el pipeline aparece en los logs con su nombre. - Tokens con alcance limitado y caducidad. En Gitea, el usuario
jenkinses colaborador de lectura solo de los repositorios que el pipeline clona (servicioeiac-lab), y su token lleva soloread:repository: esgit-ro. El usuariojenkinsdel registry solo lo usa la etapaSubir;registry:2conhtpasswdno distingue permisos por usuario (quien entra, sube y descarga), así que el límite está en que nadie más tiene esa contraseña y en que el despliegue no la necesita. - Credenciales con ámbito por carpeta:
ssh-pre, la clave que entra en las VM depre, vive enservicio/pre, y no la ven ni los jobs deservicio/devni el Multibranch deservicio, que ejecuta elJenkinsfilede cualquier rama. Es la que más hay que encerrar, porque entra comoops, que tienesudosin contraseña: quien la tenga es root en las tres VM depre. - Secretos siempre por
withCredentials; Jenkins los enmascara en el log. Nuncaecho $TOKEN, niset -xen unshque use secretos, nienvpara "ver qué hay". - Los agentes tampoco tienen más de lo necesario: el agente que construye no debería ser el que tiene acceso a los entornos. Si un
pip installde una dependencia envenenada corre en el agente de build, se lleva lo que haya en esa máquina, y enagent01el usuariojenkinsestá en el grupodocker, que equivale a root. Con dos VM (una con la etiquetadockery otra condeploy) esta separación es real; en el laboratorioagent01lleva las dos etiquetas y es solo nominal. - Revisión periódica: qué credenciales existen, quién las usa, cuándo se rotaron. Sin inventario no hay revisión posible.
El inventario del curso. Estas son todas las credenciales que acaba teniendo el Jenkins del laboratorio, con dónde vive cada una y hasta dónde llega:
| Id | Tipo | Dónde vive | Quién la usa | Alcance del permiso | Rotación |
|---|---|---|---|---|---|
agent-ssh |
SSH key | System | Controlador, para conectar agent01 |
Usuario jenkins en agent01, sin sudo pero en el grupo docker |
Anual |
docker-tls |
Certificado de cliente | Global | Cloud Docker | Demonio Docker de agent01 en el 2376 |
Con su certificado |
git-ro |
Usuario y contraseña | Carpeta servicio |
Multibranch y job despliegue |
Usuario jenkins de Gitea, read:repository sobre servicio e iac-lab |
90 días |
registry-cred |
Usuario y contraseña | Carpeta servicio |
Etapa Subir |
Usuario jenkins del registry |
90 días |
telegram-token |
Secret text | Carpeta servicio |
post { unsuccessful } del pipeline |
Bot que solo escribe en el grupo de pruebas | Anual |
ssh-pre |
SSH key | Carpeta servicio/pre |
Job despliegue |
Usuario ops en las tres VM de pre; la clave no está autorizada en ninguna otra máquina |
Con la vida de pre |
Este inventario es un entregable de la práctica, y dice también qué hay que retirar cuando pre se dé de baja: Mantenimiento retira ssh-pre y la carpeta pre el 11 de marzo.
Desplegar en pre desde Jenkins
Con las credenciales repartidas falta la pieza que usa la más delicada: el despliegue. Este apartado explica qué hace, dónde corre y por qué es un job aparte; el Jenkinsfile.deploy está entero porque la hoja A6.8 lo copia tal cual.
Qué se hace y con qué. Las VM de pre existen desde la A5.3 y el playbook de la A5.5 ya dejó en ellas el servicio, así que desplegar una versión nueva no crea ninguna máquina: es llevar la imagen a app01 de pre, decirle al compose qué imagen usar y comprobar que responde. Son tres herramientas conocidas: docker save | ssh ... docker load para la imagen, porque desde pre no se llega al registry (solo responde a gestión); el playbook de la A5.5, que copia el compose y levanta el servicio; y el test.sh de la A5.6 con SOLO_PRUEBAS=1 como smoke test, que es el modo pensado para cuando el despliegue ya lo ha hecho otro.
Dónde corre. En agent01, por su etiqueta deploy. Le hacen falta tres cosas que hasta hoy solo tenía el puesto de administración: ansible (el paquete de Debian, como en la A5.5), la ruta a 10.20.0.0/16 por router-pre (una unidad ruta-pre.service con la misma ruta que la A5.3 añadió a ruta-lab.service del puesto) y las claves de host de las tres VM en el known_hosts del usuario jenkins. tofu no: el inventario ansible/inventory.ini está en iac-lab desde la A5.5. Y las tres VM de pre tienen que estar encendidas, web01-pre incluida, porque test.sh comprueba que las tres responden por SSH.
Por qué es un job aparte. El Multibranch ejecuta el Jenkinsfile de cualquier rama, y quien pueda subir una rama podría escribir un withCredentials que saque la clave. Por eso la etapa Deploy no despliega: lanza el job despliegue de la carpeta servicio/pre, que lee su Jenkinsfile.deploy de la rama main de iac-lab, y solo ese job ve ssh-pre.
// Jenkinsfile.deploy, en la raíz de iac-lab. Lo ejecuta el job servicio/pre/despliegue.
pipeline {
agent { label 'deploy' }
options {
timeout(time: 15, unit: 'MINUTES')
disableConcurrentBuilds()
}
parameters {
string(name: 'TAG', description: 'Commit corto de la imagen que construyó Package')
}
environment {
IMAGEN = "registry.lab:5000/app:${params.TAG}"
APP_PRE = '10.20.2.10'
}
stages {
stage('Desplegar') {
steps {
withCredentials([sshUserPrivateKey(credentialsId: 'ssh-pre', keyFileVariable: 'KEY')]) {
sh '''
docker save "$IMAGEN" | ssh -i "$KEY" ops@$APP_PRE sudo docker load
mkdir -p ansible/secretos
ssh -i "$KEY" ops@$APP_PRE "sudo sed -n 's/^DB_PASSWORD=//p' /opt/servicio/.env" > ansible/secretos/db-pre
ANSIBLE_PRIVATE_KEY_FILE="$KEY" ansible-playbook -i ansible/inventory.ini ansible/site.yml -e app_image="$IMAGEN"
'''
}
}
}
stage('Smoke test') {
steps {
withCredentials([sshUserPrivateKey(credentialsId: 'ssh-pre', keyFileVariable: 'KEY')]) {
script {
def rc = sh(script: 'ANSIBLE_PRIVATE_KEY_FILE="$KEY" SOLO_PRUEBAS=1 ./test.sh pre', returnStatus: true)
if (rc != 0) {
error("Smoke test fallido (rc=${rc}): ${env.IMAGEN} queda en pre para diagnóstico")
}
}
}
}
}
}
post { always { cleanWs() } }
}
Cómo se lee:
- No hay etapa de checkout: como el agente se declara en el
pipeliney el checkout implícito no está apagado, Jenkins clonaiac-labal empezar, y el job encuentraansible/ytest.shen su directorio. Desplegarlleva la imagen por la tubería. La imagen ya está en el Docker deagent01, que es donde la construyóPackage, así que el job no necesita el registry ni su credencial. Después ejecuta el playbook con-e app_image=..., como prevé el playbook de la A5.5: el.envdeprecambia suAPP_IMAGE, y la tarea que levanta el servicio ve la imagen distinta y recrea el contenedor.- La línea del
.envtiene su razón: la contraseña de la base depreno está eniac-lab(la A5.5 la dejó enansible/secretos/, fuera de Git), y sin ese fichero ellookupdel playbook generaría otra y cambiaría la contraseña de la base en cada despliegue. Se lee del.envque ya tieneapp01sin pasar por el log, y elcleanWs()del final la borra del workspace. ANSIBLE_PRIVATE_KEY_FILEle dice a Ansible qué clave usar: el fichero temporal dondewithCredentialsdejassh-prey que Jenkins borra al salir del bloque.Smoke testejecutatest.shen el modo que no despliega y, conreturnStatus, pone él el mensaje del fallo.
Los dos caminos. Si todo va bien, el pipeline acaba en SUCCESS con la versión nueva en pre. Si falla el smoke test, la versión nueva ya está desplegada y el job lo dice con el error(...): en pre se deja así para diagnosticar, y volver es relanzar despliegue con la etiqueta anterior, que sigue en el Docker de agent01. El resultado del job pasa a la etapa Deploy del pipeline, y de ahí al aviso por Telegram.
A6.8 Mínimo privilegio y despliegue (sesión 37)
Objetivo Al terminar, la etapa Deploy del pipeline despliega en pre con una clave que solo existe en la carpeta pre, y la has recorrido por sus dos caminos: despliegue correcto y fallo en el smoke test. Tienes además el inventario de todas las credenciales de tu Jenkins, con el alcance de cada una. Es el último despliegue en pre, y con él se cierran las evidencias de despliegue de la práctica evaluable.
Antes de empezar El pipeline y el informe de la A6.7, con el quinto caso abierto. El servicio de pre respondiendo en http://10.20.2.10:28080/health, con router-pre y las tres VM de pre encendidas (también web01-pre, que test.sh comprueba por SSH), e iac-lab en Gitea con ansible/ completo (incluido inventory.ini) y test.sh. Es el último despliegue en pre: el 9 de marzo, Mantenimiento detiene el servicio de pre para darlo de baja, así que los dos caminos se cierran hoy y la práctica evaluable del 10 se entrega con estas evidencias. Se han explicado mínimo privilegio y cómo se despliega en pre desde Jenkins.
Pasos
Primero el camino de red y la credencial: agent01 tiene que llegar a pre, y la clave que entra en pre tiene que quedar encerrada en su carpeta antes de que exista nada que la use, comprobado con un job que no puede verla. Después el job que despliega y su enganche con el pipeline. Con todo montado recorres los dos caminos del despliegue, el bueno primero, porque el malo deja una versión desplegada y tienes que saber cuál era la buena. Al final, el inventario de lo que has repartido.
-
Abre a
agent01el camino apre. Dale lo que necesita para desplegar, como dice Desplegar en pre desde Jenkins: la ruta a10.20.0.0/16en una unidadruta-pre.service, las claves de host de las tres VM depreen elknown_hostsdel usuariojenkinsy, al final porque es lo que más descarga,ansible. Mientras se instala, sigue con el paso 2.Pista: la unidad lleva la línea de
ruta-lab.servicede El entorno pre condev ens18, la única tarjeta deagent01.test.shnecesita ademásncycurl. -
Encierra la clave de
preen su carpeta. Crea en el puesto de administración la clave de despliegue y autorízala enopsde las tres VM depre. En Jenkins, crea dentro deserviciolas carpetasdevyprey, solo enservicio/pre, la credencialssh-pre(SSH Username with private key, usuarioops); después borra la privada del puesto, para que solo exista dentro de Jenkins. Comprueba el ámbito con un job Pipelinever-ssh-preenservicio/dev, y su copia enservicio/pre, que entre conssh-preenapp01depre(10.20.2.10) y hagahostname: el dedevtiene que fallar porque no encuentra la credencial, y el depre, devolver el nombre.Pista: el
withCredentialses el deJenkinsfile.deploy, en un agentedeploy; la copia, con New Item → Copy from. -
Crea el job que despliega y engánchalo al pipeline. Son cuatro piezas: el usuario
jenkinsde Gitea, colaborador de lectura también deops/iac-lab, para quegit-rosirva para los dos; elJenkinsfile.deploydel apartado, en la raíz deiac-lab; el job Pipelinedespliegueenservicio/pre, que lo lee demaindeiac-labcongit-ro(Script PathJenkinsfile.deploy), y en elJenkinsfiledel servicio, la etapaDeploydel pipeline declarativo en lugar de la provisional de la A6.6.Pista: lanza
despliegueuna vez con "Build Now" para que registre el parámetroTAG(falla sin tocarpre). Si en la A5.5 pusisteansible_ssh_private_key_fileen[all:vars], quítalo degen-inventory.shy deinventory.ini: gana aANSIBLE_PRIVATE_KEY_FILE, y Ansible buscaría una clave que enagent01no existe. -
Recorre el camino bueno. Camino 1, despliegue correcto: lanza el subjob
mainconRUN_DEPLOYy comprueba desde el puesto de administración que/healthdeapp01depreresponde y que correregistry.lab:5000/appcon la etiqueta del commit. Rellena su ficha, la sexta del informe de la A6.7: estado final, notificación, cómo quedaprey cómo se vuelve de él. -
Recorre el camino malo. Camino 2, fallo en el smoke test, que cierra el quinto caso de la A6.7: cambia en el
test.shdeiac-label puerto de/healtha 28081, donde enpreno escucha nada, súbelo y relanzamainconRUN_DEPLOY. Tiene que acabar en FAILURE conSmoke testen rojo, el mensaje delerror(...), el aviso de Telegram y el servicio respondiendo aún en el 28080. Completa la ficha y devuelve el 28080 atest.shsin relanzar: lo que corre enpreya es la versión buena, y se queda hasta que Mantenimiento lo para el 9 de marzo. -
Haz el inventario de credenciales. La tabla de mínimo privilegio es ya el inventario del curso: cópiala y añade o quita las filas que no coincidan con Manage Jenkins → Credentials. Si alguna credencial sobra, bórrala y anótalo: una credencial que nadie usa es una puerta abierta que nadie vigila.
Comprobación El job de servicio/dev no encuentra ssh-pre y el de servicio/pre devuelve el nombre de app01 de pre; tras el camino 1, el compose de app01 de pre lleva la etiqueta del commit y /health responde; el camino 2 acaba en FAILURE con aviso y con /health respondiendo en el 28080; Deploy sale saltada en los push sin RUN_DEPLOY; y la clave ssh-pre no aparece en ningún log ni queda en el puesto de administración.
Para practicar Sube el Jenkinsfile del servicio con la etapa Deploy definitiva y el Jenkinsfile.deploy de iac-lab, y guarda en A6.8 el informe de pruebas con las seis fichas, el inventario de credenciales y la captura del job de dev que no encuentra ssh-pre.
Sesión 38 · Práctica evaluable
Las hojas A6.1 a A6.8 han montado, entre todas, un sistema de integración continua completo: el orquestador elegido e instalado con seguridad, sus agentes, el enganche con el repositorio, un pipeline que construye, prueba, empaqueta y despliega, probado por los caminos que acaban mal y con cada credencial en su sitio. La evaluable lo junta: diez minutos para aclarar el enunciado y el resto para cerrar y entregar. No hay nada nuevo que construir, y cada entregable dice de qué paso sale. Hoy no se despliega: el 9 de marzo Mantenimiento paró el servicio de pre para darlo de baja, así que el despliegue se entrega con las evidencias del 26 de febrero. El pipeline sigue construyendo y subiendo la imagen con cada push, con Deploy saltada. Repasa cada entregable contra su hoja, termina lo que quedara a medias y pasa la lista de comprobación antes de entregar.
Entrega:
- La elección del orquestador: la tabla comparativa y la justificación (de la A6.1, pasos 5 y 6).
- El repositorio
jenkins-configcon compose,Dockerfile,plugins.txtcon versiones,nginx.conf,casc/jenkins.yamlsin secretos y el README de instalación (de la A6.2, pasos 3 a 6), conagent01en el YAML (de la A6.3, paso 3), y la tabla de revisión de plugins (de la A6.2, paso 2). - El repositorio
serviciocon elJenkinsfilecompleto:Checkout,CalidadconTestyLinten paralelo,Packagesolo enmaincon el hueco del escaneo de Mantenimiento,Deploycon los parámetrosENVyRUN_DEPLOY, timeouts, reintentos y aviso por Telegram (de la A6.5, paso 1; de la A6.6, pasos 3 a 5; de la A6.7, paso 1, y de la A6.8, paso 3), con su tabla de etapas (de la A6.5, paso 6, y de la A6.6, paso 6); y elJenkinsfile.deploydeiac-lab(de la A6.8, paso 3). La etapa de escaneo la evalúa Mantenimiento: aquí no se pide. - El informe de pruebas del pipeline con sus seis fichas: los cinco casos del plan, el quinto cerrado con el fallo en el smoke test, y el despliegue correcto, cada una con estado final, notificación y estado del agente o de
pre(de la A6.7, pasos 2 a 5, y de la A6.8, pasos 4 y 5). - El inventario de credenciales con la justificación de cada alcance, y la captura del job de
devque no encuentrassh-pre(de la A6.8, pasos 2 y 6).
Checklist antes de entregar:
-
https://jenkins.labcon candado, el controlador con 0 ejecutores ylectorsin poder lanzar nada (de la A6.2, pasos 1, 4 y 5) -
plugins.txtcon la versión fijada en cada línea (de la A6.2, paso 3) - El log con los dos hostnames, el de
agent01y el de un agente efímero (de la A6.3, paso 6) - El push a
maindispara el pipeline por webhook, no por sondeo (de la A6.4, paso 6) - Las cuatro combinaciones de la tabla de verdad coinciden con lo esperado (de la A6.6, paso 6)
- Ninguna contraseña, token ni clave en ningún
Jenkinsfile, compose, YAML ni README (de la A6.2, pasos 4 y 6, y de la A6.8, paso 2) - Las seis fichas tienen estado final, notificación y estado del agente o de
pre(de la A6.7, paso 5, y de la A6.8, pasos 4 y 5)
| Criterio | RA4 | Sale de | Peso |
|---|---|---|---|
| Orquestador seleccionado y justificado; instalado con permisos, accesos y certificados | a, b | A6.1 y A6.2 | 20 % |
| Plugins configurados e integrados; proyecto y credenciales de repositorio | c, d | A6.2, A6.3 y A6.4 | 15 % |
| Tareas parametrizadas (agente, condiciones) y pipeline con etapas y scripts | e, f | A6.5, A6.6 y A6.8 | 25 % |
| Pipeline probado en todos los caminos con gestión de errores | g | A6.7 y A6.8 | 25 % |
| Mínimo privilegio aplicado y documentado | h | A6.8 | 15 % |
Errores frecuentes en el laboratorio
- "It appears that your reverse proxy set up is broken": falta
X-Forwarded-ProtooX-Forwarded-Hosten nginx, o la URL de Jenkins en Manage Jenkins → System no coincide con la pública. Los enlaces de los correos salen conhttp://jenkins:8080. - El navegador no acepta el certificado aunque la CA esté importada: el certificado no tiene
subjectAltName, o lo tiene con otro nombre (jenkinsen vez dejenkins.lab).openssl x509 -in jenkins.crt -noout -text | grep -A1 "Subject Alternative". - El agente SSH no conecta: el log del nodo (Manage Jenkins → Nodes →
agent01→ Log) dice por qué. Lo habitual: la clave de host del YAML no es la deagent01, o se pegó con la IP delante, tal como la escribessh-keyscan; Java no está en el agente (el plugin SSH necesita un JRE, el Java de ejecución, 17 o 21 en elPATHdel usuario); o el usuariojenkinsno puede escribir en elremoteFS. - Docker no arranca en
agent01después de publicar el 2376: es el choque entrehostsdedaemon.jsony el-H fd://de la unidad de systemd; falta el override de El demonio Docker por la red, con TLS, o se puso sinsystemctl daemon-reload.journalctl -u dockerlo dice en la primera línea del error. docker: command not founden una etapaagent { docker {...} }: el agente no tiene el CLI de Docker, o el usuariojenkinsno está en el grupodocker. Y en un agente que es a su vez un contenedor, haría falta montar el socket, lo cual le da control total del host: para eso mejor la cloud Docker apuntando a un demonio dedicado.x509: certificate signed by unknown authorityen el push: el demonio Docker del agente no confía en la CA del registry.certs.d/registry.lab:5000/ca.crto CA del sistema más reinicio del demonio. Si escurlogitquien falla, es la CA del sistema, no la de Docker.- Gitea no entrega el webhook y la pestaña dice "can only call allowed HTTP servers": a Gitea le falta
GITEA__webhook__ALLOWED_HOST_LISTconjenkins.lab, porque por defecto solo llama a direcciones públicas. Si el error es de certificado, Gitea no tiene la CA del curso en/etc/ssl/certs/. - El webhook llega pero no se lanza nada: en Gitea, la entrega muestra 200 pero Jenkins no encuentra un job cuyo repositorio coincida con la URL enviada (
https://frente assh://,.gital final, mayúsculas). Con Multibranch, "Scan Multibranch Pipeline Now" y mirar el log del escaneo. - El webhook devuelve 403: CSRF. Con el plugin de Gitea/GitLab la ruta está exenta; si se usa
notifyCommitobuildWithParametersa mano, hace falta el token de disparo o un token de API de usuario. - "A secret was passed to sh using Groovy String interpolation": comillas dobles en un
shcon la variable dewithCredentials. Se cambian a simples y la expande el shell. - Los parámetros no aparecen, o salen vacíos, la primera vez tras añadir
parameters: normal, Jenkins descubre los parámetros al ejecutar elJenkinsfile, así que esa ejecución corre sin poder elegirlos, y falla si algo los necesita, como elTAGdedespliegue. La segunda va bien. - Todo se queda en "Waiting for next available executor": ningún agente con la etiqueta que pide la etapa está conectado, o los ejecutores del controlador están a 0 y la etapa pide
agent anyoagent { label 'built-in' }. Manage Jenkins → Nodes lo muestra en un vistazo. - El job
desplieguefalla conHost key verification failedo se queda sin respuesta: falta la clave de host de esa VM en elknown_hostsdel usuariojenkinsdeagent01, oagent01no tiene la ruta apre(ip route get 10.20.2.10enagent01tiene que salir por la 10.10.0.2). Es el paso 1 de la A6.8, y el jobver-ssh-predeservicio/prelo comprueba sin desplegar nada. - El smoke test falla con
la VM 10.20.1.10 no responde por SSH:web01-preestá apagada.test.shcomprueba que las tres VM depreresponden, aunqueweb01-preno corra nada. - Una prueba roja deja el pipeline en rojo y no en amarillo: falta el
|| truedetrás depytest, y elshcorta el pipeline con FAILURE antes de quejunitpueda marcar UNSTABLE. UNSTABLEdonde se esperabaFAILURE:junitmarca inestable, no fallo, cuando hay pruebas rojas, y elPackagese ejecuta igualmente. Para no empaquetar código con pruebas rojas,options { skipStagesAfterUnstable() }en el pipeline, owhen { expression { currentBuild.currentResult == 'SUCCESS' } }enPackage.
Los enlaces para ampliar y los apartados que van más allá de lo que se hace en clase están en Para ampliar.
UT7 · Monitorización del entorno
Última unidad del centro. En la UT6 quedó Jenkins construyendo y desplegando el servicio, pero nadie vigila todavía la plataforma que lo hace: la pila de Mantenimiento mira el servicio y sus máquinas, no jenkins01 ni lo que pasa dentro de Jenkins. Ahora toca cerrar el círculo: una plataforma que no se vigila no está desplegada, está abandonada. La pila de monitorización ya existe: Prometheus, Alertmanager y Grafana corren en la VM mon01 desde octubre, montados y asegurados en el módulo 5169. Esta unidad no levanta otra. Trabaja sobre esa misma pila y en el mismo repositorio monitoring, y le añade lo que es propio del despliegue: la elección justificada del gestor de ingesta, los targets generados con Ansible desde el inventario, las métricas del orquestador de integración continua, el panel de KPI de la plataforma con sus alertas y la seguridad de todo lo que se añade. Son dos sesiones, en el orden en que viajan los datos: la primera, el 12 de marzo, los recoge, y la segunda, el 17, los convierte en un panel y en alertas y cierra lo que se ha abierto para recogerlos. La práctica evaluable no tiene sesión propia: recoge lo que dejan las dos hojas y se entrega por Aules antes del examen de la segunda evaluación, el 24 de marzo de 2027, que incluye esta unidad. Las 12 horas de monitorización avanzada se hacen en la empresa. Los logs quedan para el módulo 5169.
Cómo se reparte la monitorización entre las dos asignaturas
El módulo 5169 ya ha explicado a fondo el instrumental: PromQL y las ventanas de rate el 29 de octubre; las reglas de grabación el 5 de noviembre y las reglas de alerta el 10; Alertmanager entero el 12; Grafana desde octubre; la seguridad de la pila entre el 26 de noviembre y el 3 de diciembre; y los indicadores SLI, SLO y presupuesto de error el 17 de diciembre.
Aquí todo eso es repaso: cada apartado abre con el enlace a la sesión donde se explicó y deja solo lo que su hoja de práctica necesita.
Lo propio de esta unidad, y lo que se evalúa en ella, es el despliegue: elegir el gestor de ingesta y justificarlo, sacar los targets del inventario de Ansible con file_sd, recoger las métricas del orquestador de integración continua, construir el panel y las alertas de la plataforma, y asegurar lo que se añade a la pila (el endpoint de métricas de Jenkins y los secretos del repositorio).
Sesión 39 · Ingesta de métricas
Jenkins ya despliega el servicio, pero la plataforma que lo despliega está fuera de la pila de mon01: si los pipelines empiezan a fallar, si jenkins01 se queda sin disco o si una máquina nueva no entra en la lista de Prometheus, no se entera nadie. Esta sesión mete la plataforma en esa misma pila, sin montar otra. La teoría sigue el orden en que se decide: primero qué datos se recogen (métricas, logs o trazas) y con qué herramienta, que es la elección que la hoja pide justificar; después cómo es la pila de mon01, qué se le añade y por qué la lista de máquinas vigiladas deja de escribirse a mano y pasa a salir del inventario de Ansible. Al final, Descubrimiento de targets recoge como material de consulta los tres ficheros que lo hacen. La hoja monta la ingesta de las cuatro máquinas de dev, de los contenedores de app01 y de Jenkins, la comprueba con una consulta por fuente y deja la elección por escrito. El formato de /metrics, los tipos de métrica y la cardinalidad son repaso del módulo 5169.
Monitorización y observabilidad
Para qué hace falta. Una plataforma que nadie vigila se entera de sus fallos por quien la usa: el pipeline lleva una semana fallando, el disco de jenkins01 se llenó el viernes o la API tarda dos segundos en responder, y nadie lo sabe hasta que alguien protesta. Monitorizar es lo contrario: recoger datos del sistema de forma continua para saber si funciona y avisar cuando deja de hacerlo. La palabra observabilidad, más frecuente en la empresa, va un paso más allá: poder preguntarle al sistema por qué va mal sin desplegar código nuevo para averiguarlo.
Los tres pilares. Mantenimiento estudió la observabilidad con los cuatro flujos que expone un contenedor. En la empresa se habla de tres tipos de datos, los llamados tres pilares, porque cada uno responde a una pregunta distinta:
- Métricas: números en el tiempo (CPU, memoria, peticiones por segundo, latencia). Ocupan poco (un par de bytes por muestra comprimida), se agregan bien y son la base de gráficos y alertas. Responden a "cuánto" y "cuándo".
- Logs: líneas de texto de lo que pasó, con marca de tiempo. Caras de guardar y buscar a gran volumen, pero son lo único que dice "qué" pasó en una petición concreta. Para diagnosticar.
- Trazas: recorrido de una petición por varios servicios, con el tiempo en cada uno. Para sistemas distribuidos donde una petición toca cinco microservicios y hay que saber cuál añadió los 800 ms.
Cómo se combinan. Una alerta de métricas dice que el p95 de latencia (el tiempo por debajo del cual queda el 95 % de las peticiones) ha subido de 200 ms a 2 s desde las 10:14; las trazas dicen que el tiempo se va en la base de datos; los logs de PostgreSQL enseñan la consulta que se quedó sin índice tras el último despliegue.
flowchart TB
M["<b>Métricas</b><br><small>cuánto y cuándo · baratas · se agregan</small>"]:::dato
T["<b>Trazas</b><br><small>por dónde se fue el tiempo</small>"]:::dato
L["<b>Logs</b><br><small>qué pasó en esa petición concreta</small>"]:::dato
P1["<b>El p95 sube a 2 s<br>desde las 10:14</b>"]:::riesgo
P2["<b>El tiempo se va<br>en la base de datos</b>"]:::pieza
P3(["<b>La consulta se quedó sin índice<br>tras el último despliegue</b>"]):::ok
M --> P1 --> T
T --> P2 --> L
L --> P3
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxCada pilar responde a una pregunta distinta y ninguno sirve solo. La alerta avisa, la traza localiza y el log explica.
Por qué la unidad se queda con las métricas. Son el pilar más barato y el que sostiene las alertas: un número cada 15 s ocupa poco, se agrega por máquina o por servicio y se compara con un umbral. Los logs ya los recoge Loki, en la misma pila. Las trazas exigen instrumentar cada servicio (con OpenTelemetry, el estándar abierto para hacerlo, y un almacén como Tempo o Jaeger) y compensan cuando una petición cruza muchos servicios, que no es el caso de la API del curso: quedan como mención.
El vocabulario de la cadena. Las dos sesiones recorren la cadena de las métricas de punta a punta, desde el programa que las publica hasta el aviso por correo, y cada eslabón tiene su nombre. Todos salieron ya en Mantenimiento; la tercera columna dice dónde aparece cada uno en esta unidad:
| Término | Qué es | En esta unidad |
|---|---|---|
| Exporter | Programa que publica las métricas de algo (el sistema, los contenedores, una base de datos) en una página /metrics, en el formato que lee Prometheus |
node_exporter en las cuatro VM, cAdvisor en app01 y el plugin de Jenkins, que hace de exporter del orquestador |
| Target | Cada dirección concreta de la que Prometheus lee (host:puerto/ruta) |
10.10.2.10:29100 o jenkins.lab:443/prometheus/; los de node_exporter salen del inventario de Ansible |
| Scrape | La lectura periódica de cada target | Cada 15 s, el scrape_interval de la pila |
| Serie temporal | Una métrica con un juego concreto de etiquetas, guardada como una sucesión de muestras | up{job="node",host="db01"}, que vale 1 mientras el node_exporter de db01 responde |
| Muestra (sample) | Un valor con su marca de tiempo dentro de una serie | Cada scrape añade una a cada serie del target |
| KPI | Indicador clave: la métrica o fórmula que resume si algo va bien | Los tres del panel KPI plataforma: hosts caídos, memoria de la API y ejecuciones fallidas de Jenkins |
| Umbral | Valor a partir del cual una métrica se considera anómala | El rojo de cada panel y el > 3 de JenkinsBuildsFailing |
| Alerta | Regla que se activa cuando un umbral se supera durante un tiempo | JenkinsDown y JenkinsBuildsFailing, que llegan a Mailpit |
Elegir el gestor de ingesta
Qué se decide. El gestor de ingesta es la herramienta que recoge los datos de todas las fuentes y los guarda para consultarlos: la puerta de entrada de la monitorización. Se elige antes de instalar nada, porque de él dependen el formato de los datos, quién se conecta a quién para llevarlos y qué se puede hacer después con ellos, y el CE 4i pide además que la elección quede justificada. No hay una herramienta mejor en abstracto: depende de qué hay que vigilar (contenedores, servidores físicos, un servicio de nube) y de quién lo mantiene. La tabla resume las cuatro opciones más habituales en las empresas.
| Prometheus + Grafana | Zabbix | Elastic (ELK) / OpenSearch | Servicios en nube (CloudWatch, Azure Monitor) | |
|---|---|---|---|---|
| Modelo | Pull: Prometheus lee a los exporters | Un agente propio en cada máquina, que envía o al que pregunta el servidor | Logs y métricas por Beats | Integrado en la plataforma |
| Punto fuerte | Estándar en contenedores y Kubernetes; PromQL | Todo en uno, plantillas para hardware | Logs | Lo básico, sin instalar nada |
| Punto débil | Retención larga requiere Thanos/Mimir | Menos natural con contenedores | Pesado | Coste y dependencia |
Para leerla: ELK son las iniciales de Elasticsearch, Logstash y Kibana, y OpenSearch es una bifurcación libre de Elasticsearch; Beats son los agentes ligeros con los que Elastic recoge y envía los datos; Thanos y Mimir guardan meses o años de métricas de Prometheus en un almacén de objetos, como se cuenta en Retención y almacenamiento.
El criterio del curso. El CE 4i pide recolectar datos de hosts, contenedores y orquestador, y el CE 4j, construir paneles con ellos. De ahí salen los dos criterios con los que se elige: recolectar de todo el entorno y visualizar. Prometheus + Grafana cumple los dos y es el estándar en contenedores: cualquier imagen seria (nginx, PostgreSQL, Traefik, Jenkins, el propio Docker) expone métricas en su formato o tiene un exporter mantenido, y Grafana es la forma habitual de dibujarlas. En el laboratorio hay además una razón práctica: la pila ya existe en mon01, y elegir otra herramienta obligaría a mantener dos. Zabbix sigue siendo razonable en un centro de datos clásico con switches, sistemas de alimentación ininterrumpida y servidores físicos, y conviene no descartarlo si la empresa ya lo tiene. Los servicios de nube son cómodos hasta que llega la factura, y atan la monitorización al proveedor.
Pull frente a push, y cuándo usar Pushgateway
Quién inicia la conversación. Es la diferencia de diseño que más pesa entre esas herramientas. En pull, el servidor va a buscar los datos: Prometheus, cada scrape_interval, hace un GET a /metrics de cada target y guarda lo que le devuelven, como se vio en scrape y remote_write. En push, cada máquina envía sus datos por su cuenta a un servidor que espera, que es como Promtail lleva los logs a Loki. Que Prometheus sea pull tiene consecuencias prácticas:
- Si un target no responde, Prometheus lo sabe en el acto (
up == 0). En un modelo push, un agente muerto deja de enviar y nadie se entera hasta que alguien mira. - Desde
mon01se puede pedir concurlel/metricsde un exporter y ver exactamente lo que Prometheus ve. - Qué se vigila está en un solo sitio (
prometheus.yml), no repartido en cien agentes, y el exporter no necesita credenciales para enviar ni saber dónde está el servidor.
Lo que cuesta. Prometheus tiene que llegar por red a cada target, lo que obliga a abrir puertos y a protegerlos, como hizo Mantenimiento con los exporters de app01 y db01. Esta unidad abre una puerta en jenkins01, las métricas de Jenkins, y la cierra el 17 de marzo. Y hay cosas que no se pueden leer: un trabajo de cron que dura 20 segundos no está vivo cuando Prometheus pasa a preguntar.
Pushgateway, solo para lotes cortos. Para ese caso existe Pushgateway: el trabajo empuja sus métricas (curl --data-binary @- http://pushgateway:9091/metrics/job/backup/instance/db01) y Prometheus lee del gateway como de un exporter más. Usarlo como buzón general es un error clásico, porque el gateway nunca olvida (la métrica de un host que ya no existe sigue ahí) y se pierde la detección de caída por up.

La pila del curso en mon01
Lo que ya existe. La pila no se vuelve a montar. El módulo 5169 la levantó en octubre en mon01 (10.10.0.20, en la VNet devmgmt), en /opt/monitoring, que es la copia de trabajo del repositorio monitoring, y la cerró a primeros de diciembre: Prometheus, Alertmanager y Mailpit escuchan solo en 127.0.0.1 de mon01, Grafana está detrás de un nginx en 10.10.0.20:443 y Loki pide certificado de cliente. En el mismo compose corre MinIO, con el estado de OpenTofu y las copias, y Mantenimiento la sigue usando hasta su examen del 23 de marzo. Por eso en esta unidad nunca se hace docker compose down: se añaden ficheros propios y, como mucho, se recrea un solo servicio.
Repaso
Cómo se montó la pila y qué hace cada contenedor está en la unidad de observabilidad de Mantenimiento, que explica también el formato de /metrics, los cuatro tipos de métrica y la cardinalidad; cómo se cerró, en la de seguridad de la monitorización. Lo que esos temas tienen de propio del despliegue está en Para ampliar: la pila en un solo compose, el formato de exposición, el modelo de datos y la cardinalidad y los exporters más habituales.
Cómo se llega a ella. Como Prometheus, Alertmanager y Mailpit solo escuchan en 127.0.0.1 de mon01, a ellos se llega por túnel SSH desde el puesto del aula, con el puesto de administración como salto. ssh -L 29090:127.0.0.1:29090 -L 29093:127.0.0.1:29093 -L 28025:127.0.0.1:28025 -J ops@<IP de aula de admin01> ops@10.10.0.20 deja Prometheus en http://localhost:29090, Alertmanager en el 29093 y Mailpit en el 28025 mientras esa sesión siga abierta; en el puesto, cada uno usa el mismo número que en mon01, el de la franja del curso. Grafana sí se publica, pero en la red de gestión, a la que el puesto del aula no llega, así que va por otro túnel al 443, ssh -L 28443:10.10.0.20:443 ops@<IP de aula de admin01>, con la línea 127.0.0.1 grafana.lab en el fichero hosts del puesto y la CA del curso importada en el navegador: queda en https://grafana.lab:28443. Desde una shell en mon01, curl http://localhost:29090/... llega directo, y amtool se usa con docker compose exec alertmanager. Las órdenes completas están en el laboratorio de Mantenimiento.
Qué se vigila y por dónde pasa cada scrape. Los hosts vigilados no comparten red con mon01, salvo jenkins01: app01 vive en devback (10.10.2.10) y db01 en devdata (10.10.3.10), cada uno con una sola tarjeta, así que su scrape sale de gestión y atraviesa el cortafuegos con reglas que ya están abiertas para ellos. Lo que ya se lee y lo que añade esta unidad:
- node_exporter (puerto 29100) viene en la plantilla 9000 desde la A1.3, que lo deja escuchando en ese puerto: todas las VM llevan el paquete
prometheus-node-exportery no se instala nada. Lo que cambia es de dónde sale la lista de targets, como se explica en Los targets, desde el inventario. - cAdvisor (
app01, 28081) y postgres_exporter (db01, 29187) ya los lee la pila de Mantenimiento con sus jobs. No se tocan. - Jenkins expone
/prometheus/con el plugin Prometheus metrics, que todavía no está en su imagen: se añade en esta unidad alplugins.txtde la imagen propia con su versión fijada (id:version, como el resto del fichero). Como Jenkins va detrás de su nginx, la ruta eshttps://jenkins.lab/prometheus/y el 8080 del contenedor no se publica. Qué publica y cómo se leen sus números se explica el 17 de marzo, en Métricas del orquestador.
flowchart TB
OPS["<b>Puesto del aula</b><br><small>túneles SSH por admin01</small>"]:::act
subgraph gestion["gestión · devmgmt 10.10.0.0/24"]
P["<b>Prometheus</b><br><small>mon01 · 127.0.0.1:29090</small>"]:::act
AM["<b>Alertmanager y Mailpit</b><br><small>127.0.0.1:29093 · :28025</small>"]:::act
G["<b>Grafana tras nginx</b><br><small>10.10.0.20:443</small>"]:::pieza
J["<b>jenkins01</b><br><small>node_exporter :29100 · /prometheus/ por https</small>"]:::dato
end
FW["<b>OPNsense</b><br><small>el .1 de cada subred</small>"]:::act
A["<b>app01 · back</b><br><small>node_exporter :29100 con TLS · cAdvisor :28081</small>"]:::dato
D["<b>db01 · data</b><br><small>node_exporter :29100 · postgres_exporter :29187</small>"]:::dato
P -- scrape --> J
P -- scrape --> FW
FW --> A
FW --> D
P -- alertas --> AM
G -- PromQL --> P
OPS -- túnel --> P
OPS -- túnel al 443 --> G
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5pxPrometheus va a buscar (pull): los scrapes salen de gestión hacia app01 y db01 atravesando el cortafuegos, y hacia jenkins01 sin pasar por él, porque está en la misma subred; por eso en jenkins01 el filtro va en el propio host. Desde el puesto solo se llega a la pila por túnel o por el 443 de Grafana.
Los targets, desde el inventario
El problema de la lista escrita a mano. Hasta hoy, los targets de node_exporter de dev están escritos a mano en los static_configs de prometheus.yml, y eso obliga a editarlo cada vez que nace o muere una máquina. La que alguien se olvida de añadir no la vigila nadie, y la que se destruye sin quitarla deja un HostDown sonando hasta que alguien la retira. Con file_sd_configs (descubrimiento de targets a partir de ficheros), Prometheus lee la lista de uno o varios ficheros YAML y vuelve a leerla en cuanto cambian, sin reiniciar ni recargar.
Por qué los escribe Ansible. Quien escribe esos ficheros es Ansible, desde su inventario, y así la lista de lo vigilado sale de la misma lista de máquinas que se administra, en lugar de mantenerse aparte y desincronizarse. En pre el inventario salía del estado de OpenTofu; en dev no hay de dónde sacarlo, porque sus máquinas se clonaron a mano entre octubre y febrero y el envs/dev de la UT5 no llegó a aplicarse. Por eso se escribe a mano una sola vez, dev.ini, y desde ese momento vigilar una máquina más es añadir una línea al inventario y volver a lanzar el playbook.
Dos ficheros y dos jobs. En el laboratorio son dos ficheros, targets/ut7-node.yml y targets/ut7-node-tls.yml, y dos jobs que los leen (un job es el bloque de prometheus.yml que agrupa los targets que se leen de la misma forma): node, por HTTP, y node-tls, para app01, el único cuyo exporter exige TLS y contraseña. No caben en uno porque en Prometheus el esquema (http o https), la CA y las credenciales son de cada job y no de cada target, como se vio en TLS y basic auth en los exporters. Los ficheros completos están en Descubrimiento de targets.
El único cambio en el compose. Para que Prometheus vea esos ficheros y las reglas propias de la unidad, su servicio del compose.yml gana dos volúmenes. Es el único cambio en el compose que piden las hojas (cargar el panel en Grafana también lo toca, pero queda para cuando sobra tiempo):
# /opt/monitoring/compose.yml, servicio prometheus: dos líneas más en volumes
volumes:
# ... los que ya tenía, sin tocarlos
- ./targets:/etc/prometheus/targets:ro
- ./rules:/etc/prometheus/rules:ro
Se montan los directorios y no cada fichero, por dos motivos: lo que se añada dentro (otro fichero de targets, otro de reglas) se ve sin tocar el compose, y Ansible no reescribe un fichero, sino que escribe uno nuevo y lo pone en lugar del viejo, así que un fichero montado suelto seguiría apuntando al antiguo. Un volumen nuevo no se aplica recargando: hay que recrear el contenedor, con docker compose up -d --no-deps prometheus, que recrea solo ese. Se lanza desde /opt/monitoring y sin -f, para que Compose junte el compose.yml con el compose.override.yml de Mantenimiento, que es el que monta tls/ y secrets/. El histórico sigue en su volumen y el resto de la pila, MinIO incluido, no se entera. Las reglas no se escriben hasta el 17 de marzo, pero su directorio se monta ya, para recrear Prometheus una sola vez en toda la unidad.
Descubrimiento de targets
Material de consulta
Esto no se explica en clase más allá de lo dicho en el apartado anterior: son los tres ficheros que la hoja A7.1 copia tal cual.
El inventario. El inventario de dev vive en el repositorio iac-lab del puesto de administración. Cada grupo es el papel de la máquina en la plataforma y acaba en la etiqueta rol, y la variable node_tls marca el único exporter cifrado. web01 no está porque la matriz de reglas no deja a mon01 llegar a front:
# iac-lab/ansible/dev.ini: las máquinas de dev que vigila Prometheus
[gestion]
mon01 ansible_host=10.10.0.20
[ci]
jenkins01 ansible_host=10.10.0.10
[servicio]
app01 ansible_host=10.10.2.10 node_tls=true
db01 ansible_host=10.10.3.10
[all:vars]
ansible_user=ops
El playbook. Solo se conecta a mon01: de las demás máquinas le basta lo que dice el inventario, sin entrar en ellas. Crea el directorio targets/ si no existe y escribe en él un fichero para los exporters por HTTP y otro para los cifrados:
# iac-lab/ansible/ut7-targets.yml: escribe los targets de node_exporter en mon01
- name: Targets de Prometheus desde el inventario
hosts: mon01
become: true
tasks:
- name: Directorio de targets en la copia de trabajo de monitoring
ansible.builtin.file: { path: /opt/monitoring/targets, state: directory, owner: ops, group: ops, mode: "0755" }
- name: Un fichero para los exporters por HTTP y otro para los cifrados
ansible.builtin.copy:
dest: "/opt/monitoring/targets/ut7-{{ item.fichero }}.yml"
owner: ops
group: ops
mode: "0644"
content: |
# Generado por ansible/ut7-targets.yml de iac-lab. No se edita a mano.
{% for h in groups['all'] if (hostvars[h].node_tls | default(false) | bool) == item.tls %}
- targets: ["{{ hostvars[h].ansible_host }}:29100"]
labels: { host: {{ h }}, env: dev, rol: {{ hostvars[h].group_names | first }} }
{% endfor %}
loop:
- { fichero: node, tls: false }
- { fichero: node-tls, tls: true }
Cómo se lee:
become: truele da permisos de administrador enmon01, para crear el directorio y fijar su propietario.- El
looprepite la tarea de copia dos veces, una por fichero, eitemes el elemento de cada vuelta: el nombre del fichero y si es el de los exporters cifrados. contentno es texto fijo, sino una plantilla Jinja2, el lenguaje de plantillas de Ansible. El{% for %}recorre todas las máquinas del inventario y se queda con las que tienen elnode_tlsque pide ese fichero:default(false)da por falso el que no está escrito, yboolconvierte en booleano el textotruedel INI.- Por cada máquina sale un grupo de targets con su dirección y el puerto 29100, y tres etiquetas:
host, con su nombre en el inventario;env, fijo adev; yrol, su primer grupo. - La primera línea del fichero avisa de que es generado: lo que se cambie a mano se pierde en la siguiente ejecución.
Los jobs. En prometheus.yml, los jobs de node_exporter de dev leen esos ficheros, y se añade el de Jenkins:
# prometheus.yml: jobs de esta unidad (sustituyen a los static_configs de dev de node_exporter)
- job_name: node
file_sd_configs:
- files: [/etc/prometheus/targets/ut7-node.yml]
refresh_interval: 1m
- job_name: node-tls
scheme: https
tls_config:
ca_file: /etc/prometheus/tls/ca.crt
basic_auth:
username: prometheus
password_file: /etc/prometheus/secrets/node_exporter.pass
file_sd_configs:
- files: [/etc/prometheus/targets/ut7-node-tls.yml]
refresh_interval: 1m
- job_name: jenkins
scheme: https # Jenkins solo se publica por su nginx, en el 443
metrics_path: /prometheus/
tls_config: { ca_file: /etc/prometheus/tls/ca.crt }
static_configs:
- targets: ["jenkins.lab:443"]
labels: { host: jenkins01, env: dev, service: jenkins }
El tls_config y el basic_auth de node-tls son los que dejó la A3.2 de Mantenimiento, con la contraseña en un fichero fuera del repositorio y la CA del curso montada en /etc/prometheus/tls/; aquí solo cambia de dónde sale el target. refresh_interval hace que, además de notar los cambios al momento, Prometheus relea los ficheros cada minuto. El job jenkins es distinto porque no lee una máquina sino un servicio, y por eso no sale del inventario: un solo target fijo, el nombre público de Jenkins con el 443, porque solo se publica por su nginx; la ruta del plugin en metrics_path; y la misma CA, porque el certificado de jenkins.lab lo firmó ella y el nombre del target es el que lleva el certificado.
Las etiquetas que pone el fichero de targets (host, env, rol) acaban en todas las series de esos hosts y viajan en sus alertas: sirven para filtrar en las consultas, y Alertmanager las usa para inhibir y silenciar. env="dev", por ejemplo, separa lo de esta unidad de los targets de pre, que siguen en el job node hasta que Mantenimiento los retira, el 18 de marzo.
Prometheus también sabe descubrir contenedores preguntando al socket de Docker (docker_sd_configs); en el laboratorio se usa file_sd, y la alternativa está en Para ampliar.
A7.1 Ingesta (sesión 39)
Objetivo Que la plataforma entera, y no solo el servicio, quede vigilada por la pila de mon01: las cuatro máquinas de dev, con sus targets generados por Ansible desde el inventario en lugar de escritos a mano, los contenedores de app01 y el propio Jenkins. Al terminar tienes todos los targets de dev en UP, una consulta con datos por cada fuente y la elección del gestor de ingesta justificada por escrito. Es la parte de la práctica evaluable que corresponde al CE 4i, y son los datos sobre los que la A7.2, el 17 de marzo, construye el panel y las alertas.
Antes de empezar
- Encendidas
mon01(10.10.0.20),jenkins01(10.10.0.10),app01(10.10.2.10),db01(10.10.3.10) y el puesto de administración (10.10.0.50), con Jenkins arrancado. node_exporter ya corre en todas: viene en la plantilla. Tambiéngitea01, donde subes los cambios, yagent01, por si el paso 5 necesita lanzar el pipeline. - Entra en el puesto de administración con
ssh -A, que le presta tu clave: el playbook del paso 2 entra con ella enmon01, como en la A5.5. - La pila de Mantenimiento en marcha en
/opt/monitoringdemon01, copia de trabajo del repositoriomonitoring. No la pares en ningún momento: en ella viven también MinIO y lo que Mantenimiento necesita hasta su examen, el 23 de marzo. - El túnel a Prometheus, Alertmanager y Mailpit abierto desde el puesto del aula toda la sesión, con la orden de La pila del curso en mon01.
jenkins.laben el DNS de OPNsense desde la A6.1, porque el contenedor de Prometheus no lee el/etc/hostsdemon01. Si desde él no resuelve a10.10.0.10, dalo de alta como en la A6.1.- Explicado en clase: Elegir el gestor de ingesta y La pila del curso en mon01, con Los targets, desde el inventario. Para copiar durante la práctica: los tres bloques de Descubrimiento de targets y las consultas de Consultas del laboratorio.
Pasos
Vas a meter en la pila lo que le falta de la plataforma (el node_exporter de jenkins01 y las métricas del propio Jenkins) y a cambiar cómo se escribe la lista de máquinas, en un orden pensado para no esperar: empiezas por la imagen de Jenkins, que tarda en construirse, y mientras tanto generas los targets en el puesto de administración, preparas mon01 para leerlos y cambias los jobs. Cada paso deja listo lo que necesita el siguiente: el playbook crea targets/ antes de que se monte, el montaje existe antes de que los jobs lo lean, y solo con todo en UP tiene sentido consultar los datos. Al final pones por escrito la decisión con la que empieza la teoría.
-
Lanza primero lo que más tarda: Jenkins con el plugin. Añade el plugin Prometheus metrics al
plugins.txtdejenkins-config, enjenkins01, con su versión fijada como el resto del fichero, súbelo y reconstruye la imagen; cuando termine, Jenkins tiene que arrancar con ella. Comoplugins.txtcambia, Docker no puede reutilizar la capa de los plugins y los descarga todos otra vez, así que sigue con el paso 2 mientras tanto. Hasta que Jenkins arranque con el plugin,/prometheus/no existe y el jobjenkinsno puede estar en UP.Pista: el identificador del plugin es
prometheus; la versión, la de ese día en plugins.jenkins.io. -
Genera la lista de targets desde el inventario. En el repositorio
iac-labdel puesto de administración, añadeansible/dev.iniyansible/ut7-targets.ymlde Descubrimiento de targets, súbelos y lanza el playbook, que escribe enmon01targets/ut7-node.ymlytargets/ut7-node-tls.yml. Ábrelos antes de seguir: cada máquina tiene que estar en el fichero que le toca según sunode_tls, y con sus tres etiquetas, porque eso es exactamente lo que va a leer Prometheus. -
Prepara la pila de
mon01para los ficheros de la unidad. Crea en/opt/monitoringlos directoriosrules/,grafana/ut7/ydocs/, montatargets/yrules/en el servicioprometheuscomo en Los targets, desde el inventario y recrea solo ese contenedor, con la orden de ese mismo apartado.rules/se monta ya, aunque esté vacío hasta el 17 de marzo, para recrear Prometheus una sola vez en toda la unidad. Comprueba que el resto de la pila sigue en marcha y que, dentro del contenedor, Prometheus ve los dos ficheros de targets.Pista: lanza la orden desde
/opt/monitoringy sin-f: con-f compose.yml, Compose deja fuera elcompose.override.ymlde Mantenimiento, que es el que monta la CA y la contraseña denode-tls. -
Pasa los jobs de node_exporter a los ficheros y añade Jenkins. Cambia en
prometheus.ymllosstatic_configsde dev de node_exporter por losfile_sd_configsde Descubrimiento de targets y añade el jobjenkins; valida conpromtooly recarga sin reiniciar, porque un cambio de configuración, al contrario que un volumen, sí se aplica recargando. Al minuto, los targets de dev denode,node-tls,cadvisoryjenkinstienen que estar en UP; los deenv="pre"pueden salir en DOWN (pre se destruyó el 11 de marzo) y no cuentan.Pista: de
node-tls, el job de la A3.2 de Mantenimiento, solo cambia de dónde sale el target: suscheme, sutls_configy subasic_authse quedan. Sinodetiene un grupo conenv: pre, déjalo: lo retira Mantenimiento el 18 de marzo. -
Comprueba que llegan datos de las tres fuentes. Un target en UP solo dice que Prometheus puede leer su página; que los datos sirvan se comprueba consultándolos. En Graph, lanza las consultas de CPU usada por host, memoria del contenedor de la API y ejecuciones correctas de Jenkins de Consultas del laboratorio, una por fuente (node_exporter, cAdvisor y el plugin), y captura el resultado de cada una.
Pista: las series de ejecuciones no existen hasta que termina la primera desde que Jenkins arrancó con el plugin: si sale vacía, lanza el pipeline de
serviciosinRUN_DEPLOYy espera a que acabe. -
Justifica la elección y guarda el trabajo. Escribe
docs/ut7.md, un fichero nuevo demonitoringque es solo de esta unidad: de cinco a diez líneas con los dos criterios del CE 4i de Elegir el gestor de ingesta, por qué Prometheus los cumple aquí y cuándo elegirías Zabbix o un servicio de nube. Es la justificación que pide el primer criterio de la práctica evaluable. Haz commit en/opt/monitoringdecompose.yml,prometheus.yml,targets/ydocs/ut7.md, y súbelo.Pista: esa copia de trabajo es también la de Mantenimiento: añade al commit solo esos ficheros, nunca todo lo que aparezca cambiado.
Comprobación En http://localhost:29090/targets, los jobs node, node-tls, cadvisor y jenkins sin ninguna fila de dev en DOWN, y la fila de app01 en node-tls con un endpoint que empieza por https://. En Graph, up{rol="ci"} devuelve una serie, la de jenkins01, y las tres consultas del paso 5 devuelven datos. Los ficheros de targets/ empiezan por la línea que dice que los genera Ansible.
Para practicar Guarda en A7.1 de entregas-5166 la captura de la página Targets con los jobs de dev en UP, las de las tres consultas y el enlace al commit de monitoring con targets/, prometheus.yml y docs/ut7.md: lo pide la práctica evaluable.
Si te sobra tiempo Lanza dos veces en Jenkins un job que falle a propósito y mira subir increase(default_jenkins_builds_failed_build_count_total[1h]), el núcleo de la consulta del panel de la A7.2: la primera ejecución fallida crea la serie y la segunda es la que se ve subir, por lo que explica Cómo se leen los contadores y la duración. Abre Status → TSDB Status y anota qué métrica tiene más series y por qué; lo que significa ese número está en el modelo de datos y la cardinalidad.
Sesión 40 · Visualización, alertas y seguridad
Con la A7.1, Prometheus guarda cada 15 s los datos de las tres fuentes de la plataforma, pero un dato guardado solo sirve si alguien lo mira, y a las tres de la madrugada no mira nadie. Esta sesión hace dos cosas con ellos: los resume en un panel que se lee de un vistazo y los convierte en alertas que avisan solas. Y como para recogerlos la unidad ha abierto dos puertas nuevas en jenkins01, las cierra. El instrumental (PromQL, reglas, Alertmanager y Grafana) es el que el módulo 5169 explicó a fondo entre octubre y diciembre: el repaso recoge solo lo que la hoja A7.2 necesita, con el enlace al apartado donde está entero, se lee antes de la sesión y no ocupa minutos de clase; le siguen, como material de consulta, las consultas, las reglas y el panel que copia la hoja. La explicación son veinte minutos y va a lo que aquel módulo no toca. Diez, a qué publica el orquestador de integración continua y qué dicen esos números sobre la salud de la CI. Los otros diez, a la seguridad de lo nuevo: el endpoint de métricas de Jenkins, el exporter de jenkins01 y los secretos del repositorio. La hoja sigue el mismo camino: el panel, las reglas, una alerta provocada hasta el correo, el cierre y la comprobación desde fuera.
Repaso: PromQL, reglas, Alertmanager y Grafana
Repaso
PromQL se explicó a fondo en Mantenimiento el 29 de octubre: selectores, rate, increase, cómo se elige la ventana y los operadores con etiquetas. Las reglas de grabación se trabajaron el 5 de noviembre, las reglas de alerta el 10, con sus estados, etiquetas y anotaciones, y Alertmanager el 12, con el árbol de rutas, la agrupación, la inhibición y los silencios. Grafana se usa desde octubre, y sus roles y el acceso detrás de nginx se vieron al asegurar la pila, a primeros de diciembre. La chuleta de comandos de 5169 tiene las consultas sueltas para copiar. Este apartado se lee antes de la sesión y no ocupa minutos de clase.
Lo que la hoja usa de todo aquello. La A7.2 escribe tres consultas de panel y dos reglas, y hace llegar una alerta hasta el correo. Para eso basta con tener frescas cuatro ideas, y conviene repasarlas antes de abrir Grafana:
| Lo que se usa hoy | Qué conviene recordar | Dónde aparece |
|---|---|---|
rate(x[5m]) e increase(x[1h]) sobre contadores |
La ventana tiene que contener al menos cuatro muestras: con scrape de 15 s, 5 m es lo habitual. irate sirve para mirar picos, no para alertar |
Panel de ejecuciones fallidas y alerta JenkinsBuildsFailing |
Comparaciones con y sin bool |
up == 0 filtra y devuelve solo las series que valen cero; up == bool 0 devuelve 1 o 0 en todas, que es lo que permite sumarlas: sum(up == bool 0). count(up == bool 0) contaría todas las series, caídas o no |
Panel de hosts caídos, alerta JenkinsDown |
| Una consulta vacía no es un cero | Si la serie todavía no existe, la consulta no devuelve nada y Grafana pinta «No data»; or vector(0) pone un 0 en su lugar, como se vio en Mantenimiento |
Panel de ejecuciones fallidas |
| Las etiquetas de una alerta | Son lo único que mira Alertmanager para decidir a quién avisar; en la pila del curso son cinco (severity, team, service, origen, env) |
Reglas de esta unidad |
Conviene probar cada consulta en la pestaña Graph de Prometheus antes de llevarla a un panel: lo que no devuelve nada ahí tampoco lo hará en Grafana.
El camino de una alerta de la unidad. Las alertas de esta unidad no tocan nada de Mantenimiento: sus reglas van en un fichero propio y las entrega el Alertmanager de la pila con su árbol de rutas, que decide solo por las etiquetas. Una warning va al receptor mail, que entrega en Mailpit, aunque sea del equipo dev: la ruta de warning va antes que la de dev y no deja seguir buscando. amtool config routes test dice a qué receptor iría un conjunto de etiquetas sin provocar nada. Entre el fallo y el correo pasan el for de la regla, la siguiente evaluación y los 30 s de group_wait, así que una alerta nunca llega al instante; la notificación de resolución sale con el siguiente group_interval, que en ese árbol es de 5 minutos.
Lo que se ajusta en cada panel. De la interfaz de Grafana, la hoja pide tres cosas. La unidad de cada panel (percent, bytes(IEC), seconds) hace que Grafana escale los ejes y escriba 5,68 GiB en lugar de 6.1e+09. Los umbrales de color dicen lo mismo que dirá la alerta: el panel de ejecuciones fallidas se pone rojo desde 4, que es cuando salta JenkinsBuildsFailing (más de 3 en una hora). La leyenda se escribe como {{host}} y no como la serie entera, para que cada línea diga de qué máquina es.
Consultas, reglas y panel de la unidad
Material de consulta
Esto no se explica en clase: son las consultas que usan las hojas A7.1 y A7.2 y el fichero de reglas que copia la A7.2, con lo que hace falta para guardar el panel en Git.
Consultas del laboratorio
Una consulta por pregunta, todas sobre las series de dev. Las de máquina y de contenedor usan las métricas que la pila recoge desde octubre; las de Jenkins, las del plugin, que se explican en Métricas del orquestador.
| Qué | Consulta |
|---|---|
| CPU usada (%) por host | 100 - avg by (host) (rate(node_cpu_seconds_total{mode="idle",env="dev"}[5m])) * 100 |
| Memoria disponible (%) | node_memory_MemAvailable_bytes{env="dev"} / node_memory_MemTotal_bytes{env="dev"} * 100 |
| Disco libre (%) | node_filesystem_avail_bytes{mountpoint="/",env="dev"} / node_filesystem_size_bytes{mountpoint="/",env="dev"} * 100 |
| Hosts caídos | sum(up{job=~"node.*",env="dev"} == bool 0) |
| CPU del contenedor de la API | rate(container_cpu_usage_seconds_total{service="app"}[5m]) |
| Memoria del contenedor de la API | container_memory_working_set_bytes{service="app"} |
| Ejecuciones correctas de Jenkins | default_jenkins_builds_success_build_count_total |
| Ejecuciones fallidas de Jenkins en la última hora | sum(increase(default_jenkins_builds_failed_build_count_total[1h])) or vector(0) |
| Disco que se llena en 4 h | predict_linear(node_filesystem_avail_bytes{mountpoint="/",env="dev"}[6h], 4*3600) < 0 |
Las de máquina. node_cpu_seconds_total cuenta los segundos que cada núcleo pasa en cada modo; su rate en el modo idle es la fracción del tiempo que está parado, así que 100 menos su media por host es la CPU usada. Las de memoria y disco dividen lo disponible entre el total, y predict_linear prolonga la tendencia de las últimas seis horas: la condición < 0 dice si a ese ritmo el disco se llena antes de cuatro horas. Todas filtran por env="dev", la etiqueta que pone el fichero de targets, para no mezclar el grupo de pre que sigue escrito en el job node.
Las de contenedor. Filtran por service="app" y no por el nombre del contenedor, que es servicio-app-1 y cambia si se recrea con otro proyecto. El job cadvisor de la pila copia en el scrape la etiqueta de compose (container_label_com_docker_compose_service) a service y descarta las demás container_label_*, como se explica en Etiquetas y cardinalidad: un filtro por la etiqueta larga devuelve vacío. rate(container_cpu_usage_seconds_total[5m]) devuelve núcleos usados (0,5 = medio núcleo). Para la memoria se usa el working set, la memoria que el kernel no puede recuperar, y no container_memory_usage_bytes, que incluye caché de ficheros que el kernel suelta en cuanto le hace falta: el working set es la mejor medida de cuánto le queda al contenedor antes de su límite (Memory usage frente a working set).
Las de Jenkins. Los contadores del plugin acaban en _total, y la serie de fallos no existe hasta el primer fallo desde que arrancó Jenkins, como se explica en Cómo se leen los contadores y la duración. Por eso la del panel de fallos termina en or vector(0): sin fallos, en lugar de «No data», el panel enseña un 0 en verde, que es la respuesta correcta. La regla de Reglas de esta unidad no lo necesita, porque una consulta vacía es una alerta que no salta.
Los tres KPI del panel. Salen de esta tabla, uno por cada fuente que vigila la unidad: hosts caídos, memoria del contenedor de la API y ejecuciones fallidas de Jenkins. Son KPI porque cada uno resume en un número cómo está su fuente y, si se sale de lo normal, pide hacer algo. La CPU por host es el primer panel que se añade cuando sobra tiempo.
Reglas de esta unidad
Las reglas de Mantenimiento, entre ellas HostDown, viven en su repositorio alerting y no se tocan. Las de esta unidad van en su propio fichero, rules/ut7-plataforma.yml, que Prometheus carga con una entrada más en rule_files de prometheus.yml (rules/ut7-*.yml). Se escribe con un patrón y no con el nombre del fichero para que cualquier fichero de reglas que añada la unidad entre en la siguiente recarga sin volver a tocar prometheus.yml. Son dos, y las dos sobre el orquestador, que es lo único que la pila no vigilaba:
# rules/ut7-plataforma.yml
groups:
- name: ut7-plataforma
rules:
- alert: JenkinsDown
expr: up{job="jenkins"} == 0
for: 1m
labels: { severity: warning, team: ops, service: jenkins, origen: prometheus, env: dev }
annotations:
summary: "Prometheus no puede leer las métricas de Jenkins"
description: "{{ $labels.instance }} lleva un minuto sin responder: Jenkins parado o su nginx caído."
- alert: JenkinsBuildsFailing
expr: sum(increase(default_jenkins_builds_failed_build_count_total[1h])) > 3
for: 0m
labels: { severity: warning, team: dev, service: jenkins, origen: prometheus, env: dev }
annotations:
summary: "Más de 3 ejecuciones fallidas de Jenkins en la última hora"
JenkinsDownsalta cuando Prometheus no puede leer/prometheus/: Jenkins parado, su nginx caído o el endpoint cerrado por error. Elfor: 1mevita que un reinicio de diez segundos despierte a nadie, y es del equipoopsporque el problema está en la máquina, no en el código.JenkinsBuildsFailingsuma los fallos de todos los jobs en la última hora. Llevafor: 0mporque la ventana de una hora ya hace de filtro: un fallo suelto no la dispara. Es del equipodevporque lo que falla, casi siempre, es el código o sus pruebas.- Las cinco etiquetas son las de la tabla de etiquetas y anotaciones de Mantenimiento;
service: jenkinses un valor nuevo de esa tabla. La descripción deJenkinsDownusa{{ $labels.instance }}, que en este job esjenkins.lab:443.
Antes de recargar conviene validar con promtool check config, que revisa también los ficheros de rule_files. Una recarga con un error no tumba Prometheus, pero lo deja con la configuración anterior sin que se note en las páginas de consulta: solo lo dicen su log y la métrica prometheus_config_last_reload_successful, que pasa a 0, como se vio en el fichero rules.yml de Mantenimiento.
El panel en Grafana
Por qué el panel va a Git. Todo lo que se hace clicando en Grafana vive en su base de datos, dentro de su volumen: si el volumen se pierde, o el panel hace falta en otra instancia, no queda nada de él. Por eso se exporta a JSON desde Export → Export as JSON, con el interruptor «Export the dashboard to use in another instance» activado: la fuente de datos queda como un hueco (${DS_PROMETHEUS}) que el importador de la otra instancia rellena con la suya, y el fichero sirve fuera de mon01. Se guarda en el repositorio, en grafana/ut7/.
Que Grafana lo cargue solo. El paso siguiente es el provisioning: Grafana lee al arrancar unos ficheros de proveedor que le dicen de qué directorio cargar dashboards. La pila mínima ya monta grafana/provisioning/, que es de donde Grafana saca su fuente de datos de Prometheus; falta el proveedor y el directorio de los JSON montado en el contenedor de Grafana.
# grafana/provisioning/dashboards/ut7.yml
apiVersion: 1
providers:
- name: ut7
folder: UT7
type: file
allowUiUpdates: false
options:
path: /var/lib/grafana/dashboards/ut7
allowUiUpdates: false impide guardar desde la interfaz un panel que viene de Git: el cambio se hace en el JSON, que es la versión buena. Y el JSON exportado para otra instancia no sirve tal cual: el provisioning no pregunta por la fuente de datos, así que el hueco se queda sin rellenar y los paneles avisan de que no encuentran ${DS_PROMETHEUS}. Para cargarlo así, el hueco se cambia por el identificador (uid) de la fuente de Prometheus de mon01, que aparece en la dirección de su página en Connections → Data sources.
Lo que queda para cuando sobra tiempo. Montar el directorio obliga a recrear Grafana, así que en la hoja queda para cuando sobra tiempo, igual que una variable $host definida con label_values(node_uname_info{env="dev"}, host): un desplegable en la cabecera del dashboard con los hosts, que convierte un panel por host en uno solo para todos (las consultas pasan a ser ...{host=~"$host"}). El dashboard 1860 se importa por su identificador (Dashboards → New → Import) y sirve de cantera de consultas: tiene más de cuarenta paneles y nadie mira cuarenta paneles. Por qué las alertas de la unidad viven en Prometheus y no en el motor de alertas de Grafana está en Para ampliar.
Del indicador al compromiso. Un KPI dice cómo va algo; cuando además se acuerda un objetivo para él, aparecen tres siglas que se confunden a diario y que el módulo 5169 trabajó enteras el 17 de diciembre:
| Término | Qué es | En el entorno del curso |
|---|---|---|
| SLI (indicador de nivel de servicio) | La medición: una consulta que devuelve una fracción de éxito | avg_over_time(up{job="app"}[30d]), la fracción del tiempo en que la API ha respondido a Prometheus |
| SLO (objetivo de nivel de servicio) | El objetivo interno que se asume para ese SLI en una ventana | 99,5 % en 30 días |
| SLA (acuerdo de nivel de servicio) | El contrato con el cliente, con penalización si no se cumple | Siempre más laxo que el SLO interno: en el servicio del curso, el 99 % |
El presupuesto de error, con los minutos de caída que permite cada objetivo y las alertas por ritmo de consumo (burn rate), está en Para ampliar.
Métricas del orquestador: Jenkins en Prometheus
Por qué vigilar el orquestador. El criterio de evaluación 4i no habla solo de hosts y contenedores: pide recoger métricas del orquestador, y el orquestador es Jenkins. Es la parte más propia de esta asignatura, porque la otra vigila el servicio y aquí se vigila la máquina que lo despliega. Una integración continua se degrada mucho antes de caerse: los builds tardan cada vez más, la cola no se vacía entre ejecuciones, un agente se queda colgado y nadie lo nota hasta que alguien espera cuarenta minutos por un despliegue. Nada de eso aparece en node_exporter, que ve la máquina pero no lo que pasa dentro de Jenkins.
De dónde salen los números de Jenkins
El plugin, por dentro de Jenkins. Jenkins no publica métricas por sí mismo. El plugin Prometheus metrics que se instaló en la A7.1 corre dentro del controlador, así que ve todo lo que Jenkins sabe (la cola, los ejecutores, el historial de cada job), y cada dos minutos, su valor por defecto, recalcula las métricas y deja el resultado en https://jenkins.lab/prometheus/ para el siguiente scrape. Ese periodo explica que una ejecución recién terminada tarde hasta dos minutos en verse en Prometheus.
Dos familias de nombres. Lo que publica el plugin sale de dos sitios. Sus métricas propias llevan el prefijo default_, que es su espacio de nombres y se puede cambiar en su configuración: las de ejecuciones, default_jenkins_builds_..., llevan una serie por job, con el nombre del job en la etiqueta jenkins_job. Ojo con la palabra job: en Prometheus, job="jenkins" es el bloque de scrape, y el job de Jenkins, el pipeline, va en jenkins_job. Además, el plugin vuelve a publicar, sin prefijo, las del plugin Metrics, que se instala con él como dependencia: jenkins_queue_... para la cola, jenkins_executor_... para los ejecutores, jenkins_health_check_... para las comprobaciones internas y vm_... para la máquina virtual de Java del controlador. Los nombres cambian algo entre versiones de los dos plugins, así que lo primero es ver qué hay en el Jenkins propio. Esta consulta, en la pestaña Graph de Prometheus, devuelve una fila por cada métrica que publica el job, con cuántas series tiene:
De todas ellas, el curso usa estas:
| Métrica | Qué mide | Qué dice de la salud de la CI |
|---|---|---|
jenkins_queue_size_value |
Trabajos esperando en la cola | Si no vuelve a cero entre ejecuciones, faltan ejecutores o hay un job atascado |
jenkins_queue_buildable_value |
De la cola, los que ya podrían arrancar y solo esperan un ejecutor libre | Distingue esperar porque algo lo impide (otra ejecución del mismo pipeline en marcha, por el disableConcurrentBuilds del Jenkinsfile) de esperar por sitio; lo segundo se arregla con más ejecutores |
jenkins_executor_count_value y jenkins_executor_in_use_value |
Ejecutores de los nodos conectados (el controlador, que en el curso tiene 0, y los agentes), y cuántos están ocupados | Una ocupación sostenida por encima del 80 % anticipa la cola de la primera fila |
default_jenkins_builds_duration_milliseconds_summary |
Duración de las ejecuciones que guarda el historial, por job | Una duración que crece semana a semana es el síntoma más barato de un pipeline que se degrada |
default_jenkins_builds_success_build_count_total y default_jenkins_builds_failed_build_count_total |
Ejecuciones terminadas con éxito y con fallo, por job, desde que arrancó Jenkins | Con increase(...[1h]) sale cuántas han fallado en la última hora, el número que mira el equipo de desarrollo |
jenkins_health_check_score |
Fracción de las comprobaciones internas de Jenkins que pasan: espacio en disco y temporal del controlador, plugins que no han arrancado e hilos bloqueados entre sí | Por debajo de 1 hay algo roto en el propio Jenkins, no en los pipelines |
Cómo se leen los contadores y la duración
Los contadores de ejecuciones. Son contadores, pero con tres particularidades que explican casi todas las consultas de Jenkins que salen vacías:
- Empiezan en cero cada vez que arranca Jenkins, porque el plugin los lleva en memoria.
increase()yrate()lo tratan como el reinicio de cualquier contador (Tipos de métrica). - La serie de un resultado no existe hasta la primera ejecución con ese resultado. Hasta el primer fallo desde que arrancó Jenkins, la consulta de fallos no devuelve un 0, sino nada (Una consulta vacía no es un cero). Y ese primer fallo no lo cuenta
increase(), porque la serie nace valiendo ya 1 y no hay un valor anterior con el que compararlo. - El nombre acaba en
_total. El plugin los llama..._build_count, y la librería con la que publica añade_totala todo contador, que es la convención de Nombres y etiquetas de Mantenimiento.
La duración no es un contador. El summary de duración tampoco se comporta como uno corriente: el plugin lo vuelve a calcular cada vez con las ejecuciones que guarda el historial del job, que en el pipeline del servicio son las 20 últimas, por el buildDiscarder de su Jenkinsfile. Su _count no crece sin fin, así que aplicarle rate() no tiene sentido; en cambio, su _sum entre su _count da directamente la duración media de esas ejecuciones.
Las tres consultas que se llevan a un panel:
jenkins_queue_size_value
jenkins_executor_in_use_value / jenkins_executor_count_value
default_jenkins_builds_duration_milliseconds_summary_sum
/ default_jenkins_builds_duration_milliseconds_summary_count
La primera es la cola tal cual; la segunda, la ocupación de los ejecutores, entre 0 y 1; y la tercera, la duración media de las últimas ejecuciones de cada job, en milisegundos, que es la que hay que mirar semana a semana. La alerta JenkinsBuildsFailing de Reglas de esta unidad es la traducción a notificación de la fila de los contadores.
Qué se mira en producción
Un panel de integración continua en una empresa no enseña CPU: enseña cuánto se tarda desde que alguien sube un cambio hasta que está desplegado, qué parte de las ejecuciones falla y cuánto se tarda en recuperarse de un despliegue malo. Las métricas del plugin son la materia prima de esos tres números, y la cola y los ejecutores son lo que explica por qué el primero sube.
El endpoint también es una puerta
/prometheus/ publica nombres de jobs, de ramas y de agentes, que son información de la empresa. Por eso va detrás del nginx de Jenkins, sin publicar el 8080 del contenedor. La A7.1 lo deja abierto para que el scrape funcione a la primera, y la A7.2 lo cierra a todos menos a mon01 con el bloque de Seguridad de lo que añade la unidad.
Seguridad de lo que añade la unidad
Repaso
La seguridad de la pila se explicó y se evaluó en Mantenimiento, del 26 de noviembre al 3 de diciembre: exporters en la IP de su zona y cerrados con nftables en cada host y con OPNsense, TLS y basic auth en el node_exporter de app01, Grafana detrás de nginx con usuarios nominales, Prometheus y Alertmanager solo por túnel, y una política de protección con cinco reglas. Aquí no se repite: sigue en pie, y la hoja comprueba que los cambios de esta unidad no la han roto.
Dos puertas nuevas, y dónde se cierran. Manda la quinta regla de aquella política: cualquier puerto nuevo que se vigila entra con su protección. Esta unidad añade dos puertas, las dos en jenkins01: el endpoint /prometheus/ del plugin y el 29100 de su node_exporter, que hasta hoy no leía nadie. Las dos están en la subred de gestión, la misma que mon01, y ese tráfico no pasa por OPNsense, así que el filtro va en el propio host. El orden importa: primero las métricas del orquestador, que publican información de la empresa y que ninguna protección anterior cubre; después el exporter, que solo alcanza quien ya está en la subred de gestión, la zona más cerrada del laboratorio. En la A7.2 lo primero es obligatorio y lo segundo queda para cuando sobra tiempo.
Las métricas del orquestador. Se cierran en el nginx de Jenkins, que ya está delante, con un location propio que solo deja pasar a mon01:
# en el server de jenkins.lab del nginx.conf de jenkins-config
location /prometheus/ {
allow 10.10.0.20; # mon01
deny all;
proxy_pass http://jenkins:8080;
proxy_set_header Host $host;
proxy_set_header X-Forwarded-Proto https;
}
Tres decisiones del bloque:
- Un
locationnuevo, sin tocar el de/. Con prefijos, nginx elige ellocationmás largo que coincide con la ruta pedida, así que este se lleva solo las peticiones de métricas y el resto de Jenkins sigue igual. allowydeny, en ese orden. nginx los comprueba de arriba abajo y se queda con el primero que coincide:mon01pasa por la primera línea, y cualquier otro origen cae endeny all, que le devuelve un 403.proxy_passy las cabeceras, repetidos. Unlocationno hereda nada de otro: lo que el de/lleva dentro hay que volver a escribirlo en este, o nginx buscaría/prometheus/entre sus propios ficheros en lugar de pasárselo a Jenkins.
El 403 que devuelve a cualquier otro origen es la evidencia. En producción se añade una segunda capa: el plugin exige autenticación en el endpoint (Manage Jenkins → System → Prometheus), Prometheus se presenta con un usuario de Jenkins que solo tiene los permisos de lectura y de métricas, y su token va en un password_file, igual que la contraseña de node-tls.
El exporter de jenkins01. El 29100 escucha en todas las interfaces y cualquiera de la subred de gestión lo lee. Basta una regla en la tabla inet fw, la misma que ya usan app01 y mon01:
#!/usr/sbin/nft -f
# /etc/nftables.conf de jenkins01: solo mon01 lee el node_exporter
table inet fw
flush table inet fw
table inet fw {
chain input {
type filter hook input priority filter; policy accept;
tcp dport 29100 ip saddr != 10.10.0.20 log prefix "mon-denegado: " drop
}
}
Aquí la política es accept a propósito: en jenkins01 lo único que escucha como servicio del propio host, aparte de SSH, es node_exporter, y el 443 de Jenkins lo publica Docker por la cadena forward, que esta tabla no toca. Cerrar el host entero con política drop, como app01, es lo que se haría en producción, pero no cambia nada de lo que hay que proteger hoy. Las dos primeras líneas crean la tabla si no existe y la vacían, así que el fichero se puede recargar sin duplicar reglas. Sustituye al /etc/nftables.conf de Debian, que empieza por flush ruleset: cargado tal cual, borraría también las reglas de Docker y dejaría a Jenkins sin publicar.
Secretos y repositorio. Nada de lo que añade la unidad lleva un secreto dentro: la contraseña de node-tls está en secrets/node_exporter.pass de /opt/monitoring, un directorio que el .gitignore deja fuera del repositorio desde que se aseguró la pila, y el job la lee con password_file en /etc/prometheus/secrets/ del contenedor; la CA del curso es pública. Lo que se comprueba es que siga así en todo el historial, con gitleaks sobre una copia recién clonada de Gitea: es lo que se lleva cualquiera que descargue el repositorio, el historial publicado entero y nada de lo que la copia de trabajo de mon01 tenga sin subir o ignorado. Y que docs/ut7.md diga de dónde sale cada secreto, para que quien herede la pila no tenga que buscarlo. Un secreto que llegó al historial se cambia: borrarlo en un commit nuevo no lo saca de los anteriores, como se explica en Cuando gitleaks encuentra algo.
TLS y basic auth en Prometheus y en los exporters, y los permisos, la retención y las copias de los volúmenes de la pila, no cambian nada de lo que se hace en esta unidad y se desarrollan en Para ampliar: TLS y basic auth en Prometheus y los exporters y el repositorio de datos de la pila.
A7.2 Paneles, alertas y seguridad (sesión 40)
Objetivo Que los datos de la A7.1 sirvan sin que nadie tenga que estar mirándolos, y que lo que la unidad ha abierto para recogerlos quede cerrado. Al terminar tienes el panel KPI plataforma, que resume la plataforma en tres números (hosts, contenedor de la API y Jenkins), guardado en Git; las reglas de la unidad cargadas y JenkinsDown llegada a Mailpit en FIRING y en RESOLVED; las métricas de Jenkins solo para mon01, lo que dejó Mantenimiento todavía cerrado y el repositorio monitoring sin secretos y con la etiqueta de entrega puesta. Es lo que la práctica evaluable recoge de los CE 4j y 4k.
Antes de empezar
- Lo de la A7.1 en marcha: targets de dev en UP y su commit subido.
- Los dos túneles de La pila del curso en mon01 abiertos desde el puesto del aula: el de Prometheus, Alertmanager y Mailpit, y el de Grafana en
https://grafana.lab:28443, con un usuario de Grafana que pueda crear paneles (Editor). - Permiso para parar un par de minutos el nginx de Jenkins (avisa si compartes
jenkins01). - Leído antes de clase: el repaso. Explicado en clase: las métricas del orquestador y la seguridad de lo que añade la unidad. Para copiar durante la práctica: Consultas del laboratorio, Reglas de esta unidad, cómo se exporta el panel en El panel en Grafana y el bloque
locationdel apartado de seguridad.
Pasos
Vas a convertir los datos de la A7.1 en algo que se mira de un vistazo y en algo que avisa solo, y después a cerrar lo que la unidad ha abierto. El orden sigue al dato: primero el panel, que te dice si las consultas devuelven lo que esperas; después las reglas, que vigilan esas mismas series; y luego provocas una alerta de verdad para ver la cadena entera hasta el correo. Con la alerta probada cierras /prometheus/, y no antes: si el cierre deja fuera a Prometheus, la propia JenkinsDown te avisará. Al final dejas escritos los secretos, marcas la entrega y compruebas desde fuera que todo sigue cerrado.
-
Resume la plataforma en un panel y guárdalo en Git. Crea en Grafana, en una carpeta
UT7, el dashboardKPI plataformacon un panel por fuente y las consultas de Consultas del laboratorio: «Hosts caídos» (Stat; verde 0 y rojo desde 1), «Memoria del contenedor de la API» (Time series; bytes(IEC) y leyenda{{host}}) y «Ejecuciones fallidas de Jenkins (1 h)» (Stat; verde 0, naranja 1 y rojo desde 4). Los umbrales son los de las alertas, para que el panel y el correo digan lo mismo. Exporta su JSON y déjalo enmon01como/opt/monitoring/grafana/ut7/kpi-plataforma.json, porque lo que solo está en Grafana se pierde con su volumen.Pista: al exportar, activa «Export the dashboard to use in another instance». A
mon01se llega con salto por el puesto de administración, igual que con el túnel:scp -J. -
Carga las reglas de la unidad. Crea
/opt/monitoring/rules/ut7-plataforma.ymlcon el fichero de Reglas de esta unidad y añade"rules/ut7-*.yml"a la listarule_filesdeprometheus.ymlsin quitar lo que ya tiene: las reglas de Mantenimiento siguen enalerting, y las de esta unidad van aparte para que ninguna asignatura toque las de la otra. Valida conpromtooly recarga. En la página de alertas de Prometheus tienen que aparecer las dos, en verde.Pista: las dos reglas son
warning, que el árbol de rutas de Mantenimiento manda a Mailpit. Si el tuyo es distinto, Errores frecuentes dice cómo saber a dónde irán. -
Provoca
JenkinsDowny síguela hasta el correo. Para el nginx dejenkins-configenjenkins01y apunta la hora: para Prometheus es lo mismo que un Jenkins caído, porque deja de poder leer/prometheus/. Sigue la alerta en Prometheus (dependingafiring), en Alertmanager y en Mailpit hasta que llegue el correo FIRING, y compara su hora con la tuya: la diferencia son elforde la regla y los tiempos del árbol de rutas del repaso. Después vuelve a arrancar nginx y espera el RESOLVED. Captura los dos correos.Pista: el RESOLVED puede tardar hasta cinco minutos, el
group_intervaldel árbol. Mientras llega, sigue con el paso 4, que es en la misma máquina. -
Cierra
/prometheus/a todos menos amon01. Añade alnginx.confdejenkins-config, dentro delserverdejenkins.lab, el bloquelocationde Seguridad de lo que añade la unidad, aplícalo y sube el cambio. Mira enseguida el targetjenkins: tiene que seguir en UP, porquemon01es justo quien sí debe pasar; si cae, Errores frecuentes dice por qué.Pista: reinicia nginx en vez de recargarlo:
nginx.confestá montado como fichero suelto y, si el editor lo reescribe, el contenedor sigue viendo el antiguo hasta que vuelve a arrancar. -
Deja escrito de dónde sale cada secreto y marca la entrega. Añade a
docs/ut7.mdun apartado «Secretos» de dos o tres líneas que diga qué credencial usa lo de esta unidad, dónde está y por qué no llega al repositorio, con lo que explica Seguridad de lo que añade la unidad. Haz commit en/opt/monitoringdeprometheus.yml,rules/,grafana/ut7/ydocs/ut7.md, súbelo y ponle la etiquetaentrega-5166-ut7, que marca el estado exacto que corrige la práctica evaluable.Pista: la etiqueta no viaja con el
git pushdel commit: se sube aparte, por su nombre. -
Comprueba desde fuera que todo sigue cerrado. La evidencia de un cierre es lo que ve otra máquina, no la configuración. Desde el puesto de administración, guarda la salida de un
curla la puerta nueva (https://jenkins.lab/prometheus/) y otro a una de las que cerró Mantenimiento (el 29100 dedb01), y la de gitleaks sobre una copia demonitoringrecién clonada de Gitea, que es lo que se lleva cualquiera que la descargue. Si gitleaks encuentra algo, corrígelo y mueve la etiqueta como dice la práctica evaluable. Con todo cerrado, los targets de dev tienen que seguir en UP: un cierre que deja fuera a Prometheus no está terminado.Pista: ponle a
curlun tiempo máximo (-m 3): un puerto filtrado no contesta y la orden se quedaría esperando.
Comprobación El dashboard KPI plataforma muestra datos en los tres paneles y su JSON está en grafana/ut7/; http://localhost:29090/alerts lista las dos reglas de la unidad; en Mailpit hay un FIRING y un RESOLVED de JenkinsDown; desde el puesto de administración, 403 en /prometheus/ y tiempo agotado en el 29100 de db01, con todos los targets de dev en UP; gitleaks sin hallazgos y la etiqueta entrega-5166-ut7 en Gitea.
Para practicar Guarda en A7.2 de entregas-5166 las capturas del panel y de los dos correos, la salida del paso 6 y el enlace a la etiqueta entrega-5166-ut7, que ya lleva dentro kpi-plataforma.json y rules/ut7-plataforma.yml. Con la carpeta de la A7.1, es lo que pide la práctica evaluable.
Si te sobra tiempo Cierra el 29100 de jenkins01 al resto de la subred de gestión: escribe /etc/nftables.conf copiando el fichero de jenkins01 de Seguridad de lo que añade la unidad sin cambiar nada, valídalo con nft -c antes de cargarlo, deja habilitado el servicio nftables y comprueba desde el puesto de administración que el 29100 de jenkins01 agota el tiempo mientras su target sigue en UP. Añade al dashboard el panel de CPU por host de Consultas del laboratorio (percent; verde, naranja 70, rojo 85) con la variable $host de El panel en Grafana (Multi-value e Include All), y otro con la cola o la ocupación de los ejecutores de Métricas del orquestador. Importa el dashboard 1860 (fuente Prometheus), localiza su panel de CPU y mira con Edit la consulta que usa. Y haz que Grafana cargue el panel desde el repositorio, con el JSON preparado como dice El panel en Grafana: el proveedor de ese apartado en grafana/provisioning/dashboards/ut7.yml y ./grafana/ut7 montado en /var/lib/grafana/dashboards/ut7 del servicio grafana, recreando solo ese servicio.
Práctica evaluable
La práctica evaluable de la unidad no tiene sesión propia ni pide trabajo nuevo: recoge lo que dejan las hojas A7.1 y A7.2 y se entrega por Aules antes del examen del 24 de marzo. Se entrega el enlace a la etiqueta entrega-5166-ut7 del repositorio monitoring en Gitea, más las carpetas A7.1 y A7.2 de entregas-5166 con las evidencias de las dos hojas. La etiqueta existe porque el repositorio no se queda quieto: Mantenimiento sigue haciendo commits en él, como el del 18 de marzo que retira los targets de pre, y la etiqueta fija el estado exacto que se corrige. Si después de ponerla corriges algo, la mueves: git tag -f entrega-5166-ut7 && git push -f origin entrega-5166-ut7. El módulo 5169 corrige otra etiqueta del mismo repositorio (entrega-5169-ut8); aquí solo se mira lo que añade esta unidad.
Checklist de entrega:
-
docs/ut7.mdcon la justificación del gestor de ingesta (de la A7.1, paso 6). - Plugin de Jenkins con su versión fijada en el
plugins.txtdejenkins-config(de la A7.1, paso 1). - Targets de node_exporter generados con Ansible:
ansible/dev.iniyansible/ut7-targets.ymleniac-lab, ytargets/ut7-node.ymlytargets/ut7-node-tls.ymlenmonitoring(de la A7.1, pasos 2 y 6). - Captura de Targets con
node,node-tls,cadvisoryjenkinsde dev en UP, y las capturas de las tres consultas (de la A7.1, pasos 4 y 5). -
grafana/ut7/kpi-plataforma.jsoncon los tres paneles (de la A7.2, paso 1). -
rules/ut7-plataforma.ymlcargado y los correos FIRING y RESOLVED deJenkinsDown(de la A7.2, pasos 2 y 3). -
/prometheus/de Jenkins solo paramon01y el exporter dedb01todavía cerrado: la salida de los doscurlcon todos los targets en UP (de la A7.2, pasos 4 y 6). - Repositorio sin secretos: el apartado «Secretos» de
docs/ut7.md, gitleaks sin hallazgos y la etiquetaentrega-5166-ut7(de la A7.2, pasos 5 y 6).
| Criterio | RA4 | Peso |
|---|---|---|
| Gestor de ingesta justificado; datos de hosts, contenedores y orquestador con targets que salen del inventario (A7.1) | i | 30 % |
Panel de KPI de la plataforma y alertas que llegan por correo (A7.2, del panel a JenkinsDown) |
j | 40 % |
Métricas del orquestador solo para mon01, lo que dejó Mantenimiento comprobado y repositorio sin secretos (A7.2, del cierre de /prometheus/ a gitleaks) |
k | 30 % |
Errores frecuentes en el laboratorio
- Ansible no entra en
mon01(Permission denied (publickey)). La sesión en el puesto de administración se abrió sin-A, y las VM de dev no tienen autorizada ninguna clave de ese puesto: el playbook entra con la del puesto del aula, prestada. Se sale y se vuelve a entrar conssh -A. - Target en DOWN con "connection refused". El exporter no escucha en ese puerto o en esa interfaz: escucha en
127.0.0.1, o sigue en su puerto de fábrica porque a la líneaARGSde/etc/default/prometheus-node-exporterle falta el--web.listen-address=:29100que deja la plantilla.sudo ss -ltnp | grep node_exporteren el host dice dónde escucha. Si es "context deadline exceeded", no contesta nadie: el paquete se pierde por el camino, casi siempre en un cortafuegos (y en el paso 6 de la A7.2, eso es justo lo que se busca ver desde el puesto de administración, no desdemon01). - Target en DOWN por "server returned HTTP status 401". Hay basic auth en el exporter y no en el
scrape_config, o al revés. Lo mismo conx509: certificate signed by unknown authority: falta elca_file, o el certificado no es de la CA del curso. - Un target del job
nodeen DOWN con "server returned HTTP status 400". Ese exporter habla HTTPS: en Mantenimiento se cifró algo más que el deapp01. Se marca connode_tls=trueendev.iniy se vuelve a lanzar el playbook: pasa aut7-node-tls.ymly lo leenode-tls, siempre que su certificado lleve la IP entre sus nombres alternativos (SAN) y el usuario sea el mismoprometheus; si no, necesita un job cifrado propio. - El target de
jenkinsen DOWN con "no such host".jenkins.labno está en el DNS de OPNsense: el contenedor de Prometheus no lee el/etc/hostsdemon01. Se da de alta el nombre en OPNsense, no enmon01. - El target de
jenkinsen DOWN durante la A7.1 con un error HTTP. Jenkins todavía no ha arrancado con la imagen que trae el plugin, y/prometheus/no existe. Manage Jenkins → Plugins → Installed dice si el plugin está; si no está, falta reconstruir la imagen o recrear Jenkins con ella. - El target de
jenkinsen DOWN con "server returned HTTP status 403" después de la A7.2. Elallowdellocation /prometheus/no coincide con la dirección desde la que llega Prometheus.docker compose logs nginxenjenkins01enseña la IP que se ha denegado. - Jenkins deja de responder en el 443 al activar nftables en
jenkins01. Se cargó un fichero que empieza porflush ruleset, el de Debian por defecto, y se llevó las reglas de Docker. Se escribe el fichero de la unidad ysudo systemctl restart dockerregenera las suyas. docker compose logs prometheusdice que no encuentraca.crtonode_exporter.passdespués de recrearlo. La orden se lanzó con-f compose.yml, y con-fCompose no lee elcompose.override.ymlde Mantenimiento, que es el que montatls/ysecrets/. Se vuelve a lanzar desde/opt/monitoring, sin-f.- Prometheus sigue con la configuración anterior después de recargar, sin ningún error.
prometheus.ymlestá montado como fichero suelto: si el editor lo guarda escribiendo un fichero nuevo, el contenedor sigue viendo el antiguo, ypromtooldentro del contenedor revisa también el antiguo.docker compose exec prometheus cat /etc/prometheus/prometheus.ymllo confirma; se arregla recreando solo ese contenedor. - Las consultas de Jenkins salen vacías. Por orden: el nombre (los contadores del plugin acaban en
_total, y solo sus métricas propias llevandefault_;count by (__name__) ({job="jenkins"})dice cuáles hay); que no haya terminado ninguna ejecución con ese resultado desde que arrancó Jenkins; o que no hayan pasado los dos minutos que tarda el plugin en recalcular. - Prometheus no recarga las reglas.
rules/ut7-plataforma.ymltiene un error de sintaxis y Prometheus sigue con la configuración anterior sin que se note en las páginas de consulta.docker compose logs prometheus | taillo enseña,prometheus_config_last_reload_successfulvale 0, ypromtool check configantes de recargar lo habría evitado. - El panel cargado con provisioning avisa de que no encuentra
${DS_PROMETHEUS}. El JSON se exportó para otra instancia y el provisioning no rellena el hueco de la fuente de datos: se cambia por su uid, como dice El panel en Grafana. - Consulta vacía en Grafana pero funciona en Prometheus. Casi siempre es el rango de tiempo del dashboard o una variable
$hostsin valor. El inspector del panel (Query inspector) muestra la consulta exacta que se envía. rate()devuelve vacío. La ventana tiene menos de dos muestras ([15s]con scrape de 15 s), yrate()necesita al menos dos. El error contrario no deja rastro:rate()sobre un gauge sí devuelve un número, pero no significa nada; para gauges,deltaoderiv.- Alerta que no llega. Conviene recorrer el camino: en Prometheus, Alerts, ¿está en firing? En Alertmanager, ¿aparece? Si aparece pero no notifica, el árbol de rutas dice a qué receptor ha ido: en
mon01,docker compose exec alertmanager amtool config routes test --config.file=/etc/alertmanager/alertmanager.yml severity=warning team=ops service=jenkinslo contesta sin provocar nada, ydocker compose logs alertmanagerdice si el receptor la ha rechazado. El RESOLVED tarda más que el FIRING: sale con el siguientegroup_interval. - Grafana avisa de "origin not allowed" por el túnel del 28443. La URL pública de Grafana es
https://grafana.lab/y el navegador llega por otro puerto; afecta a las funciones en vivo, no a los paneles, y se puede ignorar. - La memoria de Prometheus crece sin parar. Cardinalidad. En Status → TSDB Status se ve qué etiqueta tiene miles de valores; se deja de exponer o se elimina con
metric_relabel_configs(action: labeldrop).
Los enlaces para ampliar y los apartados que van más allá de lo que se hace en clase están en Para ampliar.
Recursos
Presentación y evaluación
De qué va el módulo
La presentación del módulo, con los conceptos que vertebran el curso, está en la página de inicio.
El módulo compañero, 5169 (Mantenimiento del sistema de contenedores desplegado), se ocupa de lo que pasa después: vigilar el servicio (métricas, logs, alarmas y la seguridad de la monitorización, que aquí la UT7 solo repasa), medirlo y probarlo, actualizarlo, tratar sus vulnerabilidades y retirarlo, y en la empresa explotar sus registros y sus copias de seguridad. Los dos módulos comparten laboratorio y bastantes herramientas: lo que se monta aquí se sigue usando allí, y la pila de monitorización de mon01, que aquel monta desde octubre, es sobre la que trabaja la UT7 de aquí.
Resultados de aprendizaje
El currículo define cuatro resultados de aprendizaje. Las tablas siguientes los recogen en lenguaje llano e indican en qué unidad se trabaja cada criterio; el texto oficial está en el real decreto del curso de especialización.
RA1. Despliega la infraestructura virtual sobre la que van a correr los contenedores.
| CE | Qué se pide | Unidad |
|---|---|---|
| a | Instalar y configurar un hipervisor conociendo sus capacidades y limitaciones | UT1 |
| b | Crear nubes privadas virtuales (VPC) diferenciadas por entorno y aisladas entre sí | UT2 |
| c | Asignar direccionamiento IP y DNS y comunicar las zonas de cada entorno | UT2 |
| d | Desplegar capas de seguridad (DMZ externa, DMZ interna, zona interna) según la exposición, probarlas y separar clientes | UT3 |
RA2. Trabaja con una plataforma de nube pública desde la consola, la línea de comandos y el SDK.
| CE | Qué se pide | Unidad |
|---|---|---|
| a | Acceder a la consola de la plataforma | UT4 (empresa) |
| b | Configurar la interfaz de gestión | UT4 (empresa) |
| c | Instalar y configurar la CLI | UT4 (empresa) |
| d | Gestionar configuraciones y perfiles de la CLI | UT4 (empresa) |
| e | Instalar las librerías cliente con el gestor de dependencias del proyecto | UT4 (empresa) |
RA3. Despliega infraestructura como código.
| CE | Qué se pide | Unidad |
|---|---|---|
| a | Recoger los requisitos del servicio y trasladarlos a variables | UT5 |
| b | Escribir código de despliegue funcional, modular e idempotente | UT5 |
| c | Ejecutar el despliegue con pruebas del servicio y chequeo de configuración | UT5 |
| d | Verificar la seguridad del código: escaneo, corrección y ausencia de secretos | UT5 |
RA4. Configura un orquestador de integración continua y la monitorización del entorno.
| CE | Qué se pide | Unidad |
|---|---|---|
| a | Seleccionar el orquestador según el control de variables, limitaciones e integración | UT6 |
| b | Instalarlo con permisos, accesos y certificados | UT6 |
| c | Configurar plugins y complementos | UT6 |
| d | Crear el proyecto y las credenciales de acceso al repositorio | UT6 |
| e | Definir tareas parametrizadas: agente, condiciones de ejecución | UT6 |
| f | Construir el pipeline con etapas y scripts | UT6 |
| g | Probar el pipeline en todos sus caminos con gestión de errores | UT6 |
| h | Aplicar mínimo privilegio | UT6 |
| i | Seleccionar el gestor de ingesta y recolectar datos de hosts, contenedores y orquestador | UT7 |
| j | Construir paneles con KPI y alertas con envío | UT7 |
| k | Asegurar comunicaciones, accesos y repositorio de datos de la monitorización | UT7 (comprueba lo que dejó la UT3 de 5169) + empresa |
Los CE i, j y k se apoyan en lo que Mantenimiento ya ha trabajado, sobre todo en noviembre y diciembre: las alarmas de su UT2, la seguridad de la pila de monitorización de su UT3 y los indicadores de su UT4 (el reparto está en su página de evaluación). Aquí se evalúa lo propio del despliegue: la elección justificada del gestor de ingesta, los targets que salen del inventario de Ansible, las métricas del orquestador, el panel de KPI de la plataforma con sus alertas y la seguridad de lo que añade la UT7 (métricas del orquestador solo para mon01 y repositorio monitoring sin secretos). De lo que dejó Mantenimiento solo se comprueba que sigue activo.
Cómo se evalúa
La nota sale de tres cosas: las prácticas evaluables de cada unidad, dos exámenes teórico-prácticos en el laboratorio y la formación en empresa. El primer examen (11 de diciembre de 2026) cierra la UT3 y con ella la primera evaluación; el segundo (24 de marzo de 2027) cierra la UT7 y con ella la teoría del curso, antes de Pascua. Después de Pascua, las dos últimas sesiones en el centro (7 y 9 de abril) se dedican a un proyecto conjunto con el resto de asignaturas del curso, que se plantea aparte.
| Evaluación | Qué entra | Peso |
|---|---|---|
| Prácticas evaluables UT1, UT2 y UT3 | Informe o repositorio al cierre de cada unidad | 40 % de la 1ª evaluación |
| Examen 1ª evaluación (11 dic 2026) | UT1, UT2 y UT3, prueba práctica en el laboratorio | 60 % de la 1ª evaluación |
| Prácticas evaluables UT5, UT6 y UT7 | Repositorios, informe de pruebas del pipeline y panel exportado; la de la UT7 se entrega por Aules antes del examen | 40 % de la 2ª evaluación |
| Examen 2ª evaluación (24 mar 2027) | UT5, UT6 y UT7, prueba práctica en el laboratorio | 60 % de la 2ª evaluación |
| Formación en empresa | UT4, UT7b y UT8, con la ficha de evidencias firmada por el tutor | En el RA de cada unidad |
La nota final del módulo pondera los cuatro resultados de aprendizaje como fija la programación didáctica: 40 % el RA1, 4 % el RA2, 19 % el RA3 y 37 % el RA4. Cada RA toma la nota de las unidades donde se trabaja (las tablas de arriba): en las del centro, 60 % el examen y 40 % la práctica evaluable; en las de la empresa, la ficha de evidencias. Para aprobar hace falta un 5 en cada RA, y un RA suspendido se recupera solo, con los mismos instrumentos y pesos.
Cada práctica evaluable lleva su tabla de criterios y pesos al final de la unidad. Se entrega en la fecha de su sesión en el calendario, salvo la de la UT7, que no tiene sesión propia y se entrega antes del examen del 24 de marzo; una entrega fuera de plazo sin causa justificada se corrige sobre el 50 %.
Lo que no se admite
Informes sin evidencias (capturas o salidas de comandos con fecha), repositorios con secretos en el historial y código que no se puede ejecutar desde cero siguiendo el README. En las tres situaciones la práctica vuelve al alumno sin nota hasta que lo corrija.
Formación en empresa
Tres unidades se cursan en la empresa, del 19 de abril al 9 de junio de 2027, con el tutor de empresa y sin el profesor delante. Se califican con la ficha de evidencias que firma el tutor, y cada una tiene escrito qué se hace y qué se entrega:
| Unidad | Horas | Qué se hace | Qué se entrega |
|---|---|---|---|
| UT4 · Nube pública: consola, CLI y SDK | 12 | Las hojas A4.1 a A4.5 sobre la plataforma de nube de la empresa | Las evidencias de las cinco hojas y el documento de cierre, como pide su práctica evaluable |
| UT7b · Monitorización avanzada | 12 | El programa de En la empresa: monitorización avanzada | Las cinco evidencias que lista ese apartado |
| UT8 · Proyecto integrador y puesta en producción | 6 | Un despliegue real de la empresa, seguido de principio a fin y con la participación que permita el puesto | Memoria del despliegue con un apartado por capa (entorno de ejecución, red, seguridad, infraestructura como código, pipeline y monitorización) que diga qué usa la empresa y a qué equivale de lo visto en el curso |
Herramientas del módulo
| Capa | Herramienta | Alternativas que se mencionan |
|---|---|---|
| Hipervisor | Proxmox VE 9 (KVM + LXC) | VMware ESXi, Hyper-V, XCP-ng |
| Red virtual | Proxmox SDN, bridges Linux, dnsmasq | OpenStack Neutron |
| Cortafuegos | OPNsense | pfSense, nftables en Debian |
| Nube pública | La que decida la empresa | AWS, Azure, Google Cloud, Hetzner, OVH |
| IaC | OpenTofu (compatible con Terraform), Ansible | Pulumi, CloudFormation, Bicep |
| CI/CD | Jenkins LTS | GitLab CI, Gitea Actions, GitHub Actions |
| Registry y Git | Gitea, registry:2 | GitLab |
| Monitorización | Prometheus, Alertmanager, Grafana (la pila la monta 5169) | Zabbix, servicios de nube |
| Logs | Loki y Promtail (los monta y explota 5169) | ELK / OpenSearch, Fluent Bit |
| Análisis de seguridad | checkov, trivy, gitleaks | semgrep, Snyk |
Dueño de cada herramienta compartida
Varias herramientas salen en las dos asignaturas. Cada una se explica a fondo en una sola sesión, la que da esta tabla; en cualquier otra aparición, de una asignatura o de la otra, el apartado abre con un recuadro de repaso que enlaza a esa sesión y dedica sus minutos solo a lo nuevo.
| Herramienta | Se explica a fondo en | Se instala en |
|---|---|---|
| nmap y tcpdump | Sesión 10 de esta asignatura (6 nov) | El puesto de administración y la VM que indique cada hoja |
| nftables en el propio host | Sesión 17 de Mantenimiento (1 dic) | Cada host que se cierra |
| Trivy | Sesión 25 de Mantenimiento (21 ene) | El puesto de administración (A4.6 de Mantenimiento) |
| gitleaks y pre-commit | Sesión 28 de esta asignatura (27 ene) | El puesto de administración |
| Seguridad de la pila de monitorización | UT3 de Mantenimiento (26 nov a 3 dic) | mon01 |
| PromQL, reglas, Alertmanager, Grafana y KPI | UT1, UT2 y UT4 de Mantenimiento | mon01 |
Sobre el material
Este material lo ha escrito Víctor Sellés para la asignatura, con el apoyo de Claude (el asistente de IA de Anthropic) en la redacción, ampliación y revisión, a partir de apuntes propios y de la planificación del curso. La revisión final es del autor, igual que los errores que queden, que se corrigen durante el curso.
Metodología
Cada sesión de 110 minutos tiene una parte corta de explicación (entre 10 y 30 minutos, según la sesión) y una parte larga de laboratorio. El calendario dice, sesión a sesión, qué se explica y qué se practica, y de qué tipo es cada sesión: teoría y práctica, solo práctica, práctica evaluable, examen o proyecto. Cada unidad está ordenada por sesiones: un par de párrafos sobre lo que se busca y, después, sesión a sesión, los apartados de teoría que se explican ese día seguidos de la hoja de práctica, pensada para seguirla de arriba abajo en el laboratorio: objetivo, requisitos previos, pasos, comprobación y un último apartado, «Para practicar». Las hojas no se entregan: lo que se entrega es la práctica evaluable que cierra cada unidad. Lo que va más allá de lo que se hace en clase está en la página Para ampliar. Los apuntes cubren la explicación con más profundidad de la que da tiempo en clase, así que conviene leerlos antes de la sesión. En el laboratorio se trabaja por parejas sobre un hipervisor por persona; las prácticas evaluables son individuales salvo que se indique lo contrario.
Todo lo que se hace se documenta en el momento: una captura con la fecha, la salida de un comando, el fichero de configuración. Al final de cada unidad esa documentación es la práctica evaluable, así que el que lo va apuntando sobre la marcha tiene el trabajo casi hecho.
El laboratorio
Todo el módulo se hace sobre un laboratorio que se construye durante las primeras unidades y que después se reutiliza hasta el final. Esta página describe cómo queda cuando está completo, qué necesita cada puesto y cómo recuperarlo si algo se rompe.
Cómo queda al final del módulo
flowchart TB
subgraph host["Equipo del aula o portátil"]
subgraph pve["Proxmox VE en VM anidada"]
subgraph mgmt["Subred de gestión 10.10.0.0/24"]
fw["<b>OPNsense</b><br><small>.1 · el cortafuegos</small>"]:::act
adm["<b>admin01</b><br><small>.50 · puesto de administración</small>"]:::act
jenkins["<b>jenkins01 y agent01</b><br><small>.10 y .12</small>"]:::dato
mon["<b>mon01</b><br><small>.20 · monitorización y MinIO</small>"]:::dato
git["<b>gitea01</b><br><small>.11 · Gitea y registry</small>"]:::dato
end
subgraph front["front · DMZ externa 10.10.1.0/24"]
web["<b>web01</b><br><small>nginx</small>"]:::pieza
end
subgraph back["back · DMZ interna 10.10.2.0/24"]
app["<b>app01</b><br><small>API en Docker</small>"]:::pieza
end
subgraph data["data · zona interna 10.10.3.0/24"]
db["<b>db01</b><br><small>PostgreSQL</small>"]:::pieza
end
end
end
Internet(("<b>Aula / Internet</b>")):::infra -->|443| fw
Internet -->|SSH| adm
fw --> web
web -->|28080| app
app -->|5432| db
jenkins -.->|publica la imagen| git
mon -.->|scrape| app & db & jenkins
classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5pxEl laboratorio completo al terminar el módulo. En naranja por dónde se entra desde fuera: el servicio, por el cortafuegos, y la administración, por admin01. En azul lo que vigila, construye y guarda las imágenes.
Ese es el entorno dev, el único que llega al final. pre tiene la misma estructura en 10.20.0.0/16 y vive del 8 de enero al 11 de marzo (su ficha está en El entorno pre); pro solo existe como red, en 10.30.0.0/16, para las pruebas de aislamiento de la UT2.
Las dos asignaturas comparten este laboratorio
La asignatura hermana, Mantenimiento del sistema de contenedores, vigila, prueba, actualiza y retira el mismo servicio, y empieza a hacerlo el 1 de octubre, cuando aquí todavía se está instalando Proxmox. Sus tres primeras sesiones trabajan con Docker en el puesto del alumno, porque el hipervisor se está montando todavía y la plantilla de la que salen las VM no existe hasta el 14 de octubre. Para que eso cuadre, en la sesión 3 (14 de octubre), nada más tener la plantilla cloud-init, junto a web01 se clonan dos VM pensadas para la otra asignatura: app01, que aloja el servicio del curso en Docker Compose, y mon01, que aloja la pila de monitorización. Las dos van en vmbr0, la red del aula, con IP por DHCP y sin subredes ni cortafuegos, y se entregan con Docker Engine y el plugin compose instalados, con el usuario ops en el grupo docker y con la clave pública del puesto del alumno dentro, porque Mantenimiento entra en ellas desde su puesto al día siguiente. Los ficheros compose que corren encima los entrega la otra asignatura y se despliegan allí a partir de su sesión 4 (15 de octubre).
El 27 de noviembre, en la A3.3, esta asignatura traslada las dos VM a su sitio definitivo, ya detrás del cortafuegos: app01 a la subred back con la 10.10.2.10 y mon01 a la de gestión con la 10.10.0.20. Mantenimiento audita su pila el 26 de noviembre, con las VM todavía en el aula, y la protege desde el 1 de diciembre, ya en la VPC. En marzo, la UT7 de monitorización no levanta una segunda pila: trabaja sobre la de /opt/monitoring de mon01 y en el mismo repositorio monitoring, y solo le añade ficheros propios que Mantenimiento no toca (los targets que genera Ansible, sus reglas, el job de Jenkins y el panel de la plataforma). PromQL, las reglas, Alertmanager, Grafana y los indicadores se repasan en pocos minutos, porque la otra asignatura ya los ha dado a fondo.
Requisitos por puesto
Proxmox va dentro de una máquina virtual de VirtualBox o VMware Workstation en el equipo del aula (virtualización anidada). No es lo ideal en rendimiento, pero permite que cada uno tenga su hipervisor completo y lo pueda romper sin afectar a nadie.
| Recurso | Mínimo | Recomendado |
|---|---|---|
| CPU del equipo | 4 núcleos con VT-x/AMD-V | 8 núcleos |
| RAM del equipo | 16 GB | 32 GB |
| Disco libre | 80 GB en SSD | 150 GB en SSD |
| VM de Proxmox | 4 vCPU, 12 GB RAM, 60 GB | 6 vCPU, 16 GB RAM, 100 GB |
Disco. Además de los clones de la plantilla (20 GB cada uno, de los que se ocupan unos 3 al principio), hay dos discos que se añaden a mano durante el curso: el segundo disco de db01 para /data, de 5 GB, el 27 de noviembre, y el volumen minio_data de la pila de mon01, que crece con el estado de OpenTofu (unos pocos MB) y con las copias restic de pre (entre 1 y 3 GB desde febrero).
Con un miniPC o un portátil antiguo de 16 GB disponible, instalar Proxmox directamente sobre él (tipo 1 de verdad) es mucho mejor que la VM anidada. Es la opción preferible siempre que sea posible.
Presupuesto de memoria
Lo que se busca es que la VM de Proxmox no se quede sin memoria en ninguna sesión. La cuenta se hace con la memoria asignada a cada VM, que es la de la columna «RAM al clonar» de la tabla de máquinas, más 2 GB para el propio Proxmox. La cifra de referencia para las dos asignaturas es 16 GB para la VM de Proxmox, es decir, 14 GB para las VM, y no se alcanza dejándolo todo encendido: en los tramos más cargados hay algo que se apaga.
Cuatro bloques se repiten en la cuenta:
- La base, encendida todo el curso desde el 27 de noviembre: OPNsense (1 GB),
admin01(1 GB), que es el salto para entrar en todo lo demás, ymon01(3 GB), con MinIO dentro. Son 5 GB. - El servicio en dev:
web01(1 GB),app01(2 GB) ydb01(2 GB). Son 5 GB. - pre, del 8 de enero al 11 de marzo: tres VM de 1 GB y
router-pre(512 MB). Son 3,5 GB. - La integración continua, desde febrero:
jenkins01(2 GB),agent01(2 GB) ygitea01(1 GB). Son 5 GB.
| Tramo | Encendido | Suma | Qué se apaga para no pasar de 14 GB |
|---|---|---|---|
| 14 oct a 3 nov | web01, app01 y mon01; db01 desde el 30 oct; las VM de prueba de la UT1 |
8 GB y las pruebas | Cada VM de prueba al terminar su hoja; en la evaluable de la UT1, todo menos app01, mon01 y app-eval |
| 4 a 19 nov | Lo anterior, router-dev, admin01, router-pre, router-pro y las dos web01 de prueba de la A2.5 |
11,5 GB | Nada; la A2.5 apaga db01 hasta la evaluable para caber también en 12 GB |
| 20 nov a 7 ene | La base, el servicio en dev y router-pre; cli-a y cli-b del 2 al 9 dic |
11,5 GB | Nada |
| 8 ene a 2 feb | La base, el servicio en dev y pre | 13,5 GB | Nada |
| 3 feb a 11 mar | La base, el servicio en dev, pre y la integración continua | 18,5 GB | En las sesiones de Despliegue, dev y pre salvo lo que use la hoja: la A6.8 (26 feb) enciende router-pre, web01-pre, app01-pre y db01-pre, porque test.sh comprueba las tres VM del servicio, y se queda en 13,5 GB. En las de Mantenimiento, jenkins01, agent01 y web01-pre, que no corre nada, y pre entera los días que la hoja no la usa; cuando la hoja necesita Jenkins (A7.6, A8.1, A8.2 y A8.3), se enciende y a cambio se apagan web01 y db01 de dev; la A8.1 y la A8.2 necesitan además router-pre, app01-pre y db01-pre encendidas |
| 12 a 24 mar | La base, el servicio en dev y la integración continua | 15 GB | web01 en las sesiones de la UT7, porque mon01 no la vigila; agent01 en las de Mantenimiento |
Con una VM de Proxmox de 12 GB (10 para las VM) el curso se sigue con la misma regla, más estricta: se enciende solo lo que usa la hoja del día y se apaga al terminar. Hasta enero basta con lo que ya dicen las hojas y con router-pre apagado hasta el 8 de enero; desde enero, cada sesión enciende el servicio en dev o pre, no los dos, y las de Despliegue de febrero y marzo apagan también mon01 salvo en la A6.4, que traslada Gitea desde ella. Con 8 GB se llega hasta la UT5 de Despliegue y la UT2 de Mantenimiento, pero no caben a la vez Jenkins con su agente y la pila de monitorización.
MinIO no añade ninguna línea a la cuenta: se monta el 18 de diciembre, en el primer paso de la A5.2, como un contenedor más de la pila de mon01, y ocupa unos 300 MB de los 3 GB que esa máquina ya tiene. Si el profesor lo monta para toda el aula, no ocupa nada en el puesto. app01 y mon01 las usa Mantenimiento a diario: si una sesión de Despliegue las apaga, se vuelven a encender al terminarla.
Convenciones
Esta es la tabla única del laboratorio y manda sobre cualquier otra cosa escrita en las unidades: si una hoja de práctica dice algo distinto, vale lo de aquí. La asignatura de Mantenimiento usa estas mismas convenciones y solo añade las suyas.
Zonas, VNets y direccionamiento
Cada entorno tiene cuatro VNets del SDN, una por zona, y cada VNet lleva una sola subred. Dos subredes dentro de la misma VNet comparten bridge, o sea el mismo dominio de capa 2, así que no se pueden separar con un cortafuegos; por eso hay una VNet por zona y no una sola con varias subredes dentro.
| Zona | VNet (dev) | Subred | Quién es el .1 |
Qué vive ahí |
|---|---|---|---|---|
| gestión | devmgmt |
10.10.0.0/24 | el router del entorno | jenkins01, agent01, gitea01 con el registry, mon01 con MinIO y el puesto de administración |
| front (DMZ externa) | devfront |
10.10.1.0/24 | el router del entorno | web01, el nginx que publica el servicio |
| back (DMZ interna) | devback |
10.10.2.0/24 | el router del entorno | app01, la API en Docker |
| data (zona interna) | devdata |
10.10.3.0/24 | el router del entorno | db01, PostgreSQL |
pre y pro son iguales cambiando el prefijo: premgmt, prefront, preback, predata sobre 10.20.0.0/16, y promgmt, profront, proback, prodata sobre 10.30.0.0/16, con el mismo tercer octeto por zona (0 gestión, 1 front, 2 back, 3 data). Los servicios de plataforma (Jenkins, Gitea, el registry, la monitorización, MinIO) no se duplican: viven en devmgmt. Desde gestión se llega a pre por una pata que router-pre tiene en devmgmt (El entorno pre dice cómo); a pro no se llega, porque pro no tiene más que sus redes.
El ID de una VNet admite como máximo 8 caracteres y solo alfanuméricos. Es un límite de Proxmox, no una manía del curso: nombres como vdev-front no se pueden crear. El ID de zona tiene el mismo límite; la zona del laboratorio se llama lab, es de tipo Simple y usa el IPAM pve.
El router del entorno tiene una pata en cada VNet y es el .1 de las cuatro subredes. En dev lo es la VM router-dev (100), con dnsmasq, desde la sesión 9, y OPNsense (109) desde la sesión 14, que ocupa su sitio con esas mismas direcciones; router-dev se apaga ese día y se destruye al cerrar la evaluable de la UT3. En pre y pro son router-pre (200) y router-pro (300). Orden de interfaces en los routers Debian: ens18 exterior (vmbr0), ens19 gestión, ens20 front, ens21 back y ens22 data, y en router-pre, desde la A5.3, ens23, su pata en devmgmt. Las de OPNsense están en la A3.1.
Quién reparte direcciones cambia una sola vez en todo el curso. En la sesión 8 las subredes del SDN se crean con gateway y con rango DHCP del SDN (dnsmasq por zona, unidad dnsmasq@lab), porque es lo que se explica ese día. En la sesión 9, al entrar router-dev, se quita el gateway y el rango DHCP de cada subred del SDN y el router pasa a hacer DHCP, DNS y NAT. Dos .1 distintos en la misma red no funcionan, así que ese paso no es opcional.
| Rango dentro de cada subred | Uso |
|---|---|
.1 |
router y cortafuegos del entorno; también es el DNS y el servidor DHCP |
.2 a .9 |
reservado para servicios de red; solo se usa uno, la 10.10.0.2 de gestión, que es la pata de router-pre desde la A5.3 (antes, durante la A3.1, la dirección provisional de OPNsense) |
.10 a .99 |
servidores fijos |
.100 a .199 |
rango DHCP |
.200 a .254 |
libre, para pruebas de un rato |
Una tarjeta que no existe y una red que no es del laboratorio
No hay patas de gestión en web01, app01 ni db01: cada uno tiene una sola tarjeta, la de su zona, y la monitorización llega hasta ellos atravesando el cortafuegos, con las filas 11 a 13 de la matriz de reglas. La 10.10.0.11 es gitea01 y la 10.10.0.12 es agent01, no segundas tarjetas de app01 y de db01.
La red 10.10.10.0/24 no es del laboratorio: es la del bridge vmbr1 del nodo, donde el host tiene la 10.10.10.1. En vmbr1 no vive ninguna VM de servicio: solo las VLAN de prueba de la UT1 y los dos clientes de la A3.4, en las VLAN 101 y 102 (10.10.101.0/24 y 10.10.102.0/24).
Máquinas, IDs de VM y direcciones
Una fila por máquina, con la hoja que la crea y la que la retira; las que no tienen fecha de baja llegan al final del curso. qm clone no admite la memoria, así que toda hoja que clona la fija en la misma orden con qm set <ID> --memory <MB>: la plantilla trae 2 GB y casi ninguna máquina los necesita. Los nombres DNS de cada una están en Nombres DNS y acceso.
| Máquina | ID | Red e IP | RAM al clonar | Qué corre | Nace en | Muere en |
|---|---|---|---|---|---|---|
| OPNsense | 109 | vmbr0 (WAN) y las cuatro VNets de dev, con el .1 de cada una; desde la A3.4, también vmbr1 |
1 GB | Cortafuegos, NAT, DHCP, DNS y hora de dev | A3.1, 20 nov (se instala en casa) | |
router-dev |
100 | vmbr0 y las cuatro VNets de dev, con el .1 de cada una |
512 MB | DHCP, DNS y NAT de dev hasta que llega OPNsense | A2.3, 4 nov | Se apaga en la A3.1 (20 nov) y se destruye al cerrar la evaluable de la UT3 (9 dic) |
jenkins01 |
101 | devmgmt, 10.10.0.10 |
2 GB | Jenkins con nginx delante | A6.1, 3 feb | |
gitea01 |
102 | devmgmt, 10.10.0.11 |
1 GB | Gitea con nginx delante; el registry desde la A6.6 (19 feb) | A6.4, 12 feb | |
mon01 |
103 | vmbr0 por DHCP hasta el 27 nov; después devmgmt, 10.10.0.20, y la 10.10.0.30 de MinIO |
3 GB | La pila de Mantenimiento en /opt/monitoring; la Gitea provisional del 17 nov al 12 feb; MinIO desde la A5.2 (18 dic) |
A1.3, 14 oct | |
admin01, el puesto de administración |
105 | vmbr0 por DHCP y devmgmt, 10.10.0.50 |
1 GB | El salto SSH hacia todas las zonas, la CA del curso, tofu y ansible, y las copias de trabajo de iac-lab, operacion y entregas-5166 |
A2.4, 6 nov | |
agent01 |
106 | devmgmt, 10.10.0.12 |
2 GB | El agente permanente de Jenkins, por SSH, y el Docker de los agentes efímeros; ansible y la ruta a pre desde la A6.8 |
A6.3, 10 feb | |
web01 |
110 | vmbr0 hasta el 30 oct; después devfront, 10.10.1.10 |
1 GB | nginx con TLS delante de la API | A1.3, 14 oct | |
app01 |
120 | vmbr0 por DHCP hasta el 27 nov; después devback, 10.10.2.10 |
2 GB | El compose servicio en /opt/servicio |
A1.3, 14 oct | |
db01 |
130 | devdata, 10.10.3.10 |
2 GB | PostgreSQL en su disco /data y postgres_exporter, desde la A3.3 (27 nov) |
A2.2, 30 oct | |
router-pre |
200 | vmbr0 y las cuatro VNets de pre, con el .1 de cada una; desde la A5.3, también devmgmt con la 10.10.0.2 |
512 MB | DHCP, DNS y NAT de pre, y el paso de gestión a pre | A2.5, 11 nov | A8.3 de Mantenimiento, 11 mar |
web01-pre, app01-pre y db01-pre |
210, 220 y 230 | prefront, preback y predata, con la .10 de cada subred |
1 GB | Lo que dice la ficha de pre | A5.3, 8 ene, con OpenTofu | A8.3 de Mantenimiento, 11 mar |
router-pro |
300 | vmbr0 y las cuatro VNets de pro |
512 MB | Nada: pro solo existe como red | A2.5, 11 nov | Al cerrar la evaluable de la UT2 (18 nov), junto con la 210 de prueba |
| MinIO | contenedor en mon01 |
devmgmt, 10.10.0.30, una segunda dirección de mon01 |
unos 300 MB, dentro de los 3 GB de mon01 |
Almacén S3 con los buckets tfstate y backups; si lo monta el profesor para toda el aula, no ocupa memoria del puesto. El ID 104 queda reservado por si algún curso le da VM propia |
A5.2, 18 dic |
Reparto de los ID de VM. La plantilla cloud-init es la 9000 (Debian 13 genericcloud). Las VM se numeran <entorno><zona><host>: la centena es el entorno (1 dev, 2 pre, 3 pro) y la decena es la zona, con el mismo número que el tercer octeto de su subred (0 gestión, 1 front, 2 back, 3 data). Así 120 se lee "dev, back, primera máquina" y nunca choca con 220, que es la misma pieza en pre.
| Entorno | Gestión | front | back | data | Pruebas y VM efímeras |
|---|---|---|---|---|---|
| dev | 100 a 109 | 110 a 119 | 120 a 129 | 130 a 139 | 150 a 199 |
| pre | 200 a 209 | 210 a 219 | 220 a 229 | 230 a 239 | 250 a 299 |
| pro | 300 a 309 | 310 a 319 | 320 a 329 | 330 a 339 | 350 a 399 |
Los contenedores LXC comparten numeración con las VM, así que salen del rango de pruebas del entorno que toque.
VM de prueba. Salen de la franja de pruebas de su entorno y se destruyen como muy tarde al cerrar la evaluable de su unidad, para dejar libre el ID: la A5.1, por ejemplo, vuelve a usar la 150.
| VM | ID | RAM al clonar | Nace en | Muere en |
|---|---|---|---|---|
web02, el clon enlazado de «Si te sobra tiempo» |
150 | 1 GB | A1.3, 14 oct | Al cerrar la evaluable de la UT1 (23 oct) |
La copia restaurada de web01 |
151 | 1 GB | A1.4, 16 oct | Al cerrar la evaluable de la UT1 |
ct01, el contenedor LXC |
170 | 512 MB | A1.4, 16 oct | Al cerrar la evaluable de la UT1 |
vlan10a, vlan10b y vlan20a |
160 a 162 | 512 MB | A1.5, 21 oct | Al terminar la A1.5 o su «Si te sobra tiempo» |
app-eval |
libre entre 150 y 199 | 3 GB, con ballooning | Evaluable de la UT1, 23 oct | Al entregarla |
web01 de prueba de pre |
210 | 512 MB | A2.5, 11 nov | Al cerrar la evaluable de la UT2 (18 nov) |
web01 de prueba de pro |
310 | 512 MB | A2.5, 11 nov | Al final de la A2.5 |
| Las de los scripts de la A2.6 | 310, 320 y 330 | 512 MB | A2.6, 13 nov | En la propia A2.6, con destruye-entorno.sh pro |
cli-a y cli-b |
180 y 181 | 512 MB | A3.4, 2 dic | Al cerrar la evaluable de la UT3 (9 dic) |
prueba01 |
150 | 1 GB | A5.1, 16 dic | En la propia A5.1, con tofu destroy |
El entorno pre
pre es la copia de dev en la que se ensaya antes de producción. Lo crea esta asignatura con OpenTofu el 8 de enero, lo usan las dos asignaturas y lo da de baja Mantenimiento el 11 de marzo. Esta ficha manda sobre lo que digan de pre las unidades de las dos asignaturas.
| Máquina | ID | IP | Qué corre |
|---|---|---|---|
router-pre |
200 | el .1 de cada subred de pre y la 10.10.0.2 en devmgmt |
DHCP y DNS de pre.lab, NAT de salida a Internet y el paso de gestión a pre |
web01-pre |
210 | 10.20.1.10 | Nada: se queda como clon limpio de la plantilla, sin nginx ni certificado |
app01-pre |
220 | 10.20.2.10 | El compose del servicio en /opt/servicio, proyecto servicio, solo con el servicio app y con DB_HOST=10.20.3.10 |
db01-pre |
230 | 10.20.3.10 | PostgreSQL del paquete de Debian, con la base servicio y el usuario app, abierto solo a 10.20.2.0/24 |
Las tres VM llevan 1 GB y salen de la plantilla, así que traen node_exporter. Lo que corre en app01-pre y en db01-pre lo deja el playbook de la A5.5; si no cabe en esa hoja, la parte de db01-pre pasa a la A5.6.
Cómo llega gestión a pre. La A2.5 aísla los entornos con rutas blackhole, y así se quedan. El paso lo da una pata de router-pre en devmgmt, que monta el paso 1 de la A5.3:
- En el nodo,
qm set 200 --net5 virtio,bridge=devmgmt --ipconfig5 ip=10.10.0.2/24; dentro derouter-preesa tarjeta esens23. Como 10.10.0.0/24 queda conectada, gana al blackhole de 10.10.0.0/16 yrouter-precontesta a gestión. - En
router-pre, tres reglas nftables deforward: lo establecido y relacionado se acepta, lo que entra porens23se acepta y nada nuevo de pre sale haciaens23. - En
admin01, la líneaExecStart=/sbin/ip route replace 10.20.0.0/16 via 10.10.0.2 dev ens19añadida aruta-lab.service.agent01, en la A6.8, ymon01, en la A7.4 de Mantenimiento, reciben la misma ruta con una unidad igual,ruta-pre.service.
pre no alcanza gestión: solo responde. Lo que llega a pre se empuja desde gestión, los ficheros con Ansible y las imágenes con docker save app:<versión> | ssh ops@10.20.2.10 docker load, porque desde pre no se llega al registry. pre sale a Internet por el NAT de router-pre. En las hojas se escribe con IP: los nombres <host>.pre.lab solo los resuelve router-pre.
Quién lo usa y cuándo.
| Fecha | Hoja | Qué hace con pre |
|---|---|---|
| 8 ene | A5.3 de Despliegue | Abre el camino de gestión y crea las tres VM con OpenTofu, con prevent_destroy |
| 13 a 20 ene | A5.4 a A5.6 de Despliegue | Estado remoto, playbook y test.sh, siempre sobre pre |
| 11 feb | A7.4 de Mantenimiento | La primera vez en Mantenimiento: da de alta en Prometheus el job node con env="pre", hace la copia previa y actualiza la aplicación con docker save y docker load |
| 25 feb | A8.1 de Mantenimiento | Plan de baja e inventario, sin tocar nada |
| 26 feb | A6.8 de Despliegue | El último despliegue en pre, con la etapa Deploy del pipeline |
| 9 mar | A8.2 de Mantenimiento | Para el servicio, guarda el volcado de bloqueo y libera los contenedores, los volúmenes y las imágenes de app01-pre |
| 10 mar | Evaluable de la UT6 de Despliegue | No despliega: se entrega con las evidencias del 26 de febrero |
| 11 mar | A8.3 de Mantenimiento | tofu destroy de pre (antes retira el prevent_destroy de las VM de pre en una rama de iac-lab), router-pre con su pata en devmgmt, las VNets de pre, las rutas de pre en admin01, agent01 y mon01, la credencial ssh-pre y la carpeta pre de Jenkins |
La UT4 de Mantenimiento trabaja contra dev (https://api.dev.lab), no contra pre. Las copias de pre las hace admin01 en el repositorio restic único, con la etiqueta pre: ssh ops@10.20.3.10 'sudo -u postgres pg_dump -Fc servicio' | restic backup --stdin --stdin-filename servicio-pre.dump --tag pre. En pre no hay certificados. Al dar de baja pre no se tocan el repositorio servicio, su webhook ni el job Multibranch, porque el pipeline sigue construyendo; del registry se borran solo las etiquetas que se desplegaron en pre, en la A8.4 de Mantenimiento (16 mar).
Nombres DNS y acceso
Hay dos categorías de nombres y conviene no mezclarlas:
- Servicios de plataforma, que viven en gestión y no pertenecen a ningún entorno: dominio plano
.lab.jenkins.lab,gitea.lab,registry.lab,grafana.labyprometheus.lab, y el de la máquina que los aloja, también en plano:jenkins01.lab,mon01.lab. - Hosts de servicio, uno por entorno:
<host>.<entorno>.lab.web01.dev.lab,app01.dev.lab,db01.dev.laby el servicio publicado,api.dev.lab.
No existe ningún gitea01.dev.lab: meter un servicio de plataforma en un entorno lo mezcla con lo que se da de baja con ese entorno. MinIO no tiene nombre: se usa como http://10.10.0.30:29000.
| Nombre | Apunta a | Lo resuelve | Desde |
|---|---|---|---|
app01 y mon01 |
la IP del aula de cada una | /etc/hosts del puesto del alumno y de mon01 |
A1.4 de Mantenimiento (15 oct), hasta el 27 nov |
<host>.dev.lab y api.dev.lab |
la IP de cada máquina; api.dev.lab, la de web01 |
router-dev, y OPNsense desde la A3.1 |
A2.3 (4 nov) |
gitea.lab |
mon01; gitea01 (10.10.0.11) desde la A6.4 (12 feb) |
/etc/hosts del puesto, de mon01, de app01 y del puesto de administración hasta el 27 nov; después, OPNsense |
A2.6 de Mantenimiento (17 nov) |
mon01.lab, grafana.lab y prometheus.lab |
10.10.0.20 | OPNsense | A3.1 (20 nov) |
jenkins.lab y jenkins01.lab |
10.10.0.10 | OPNsense | A6.1 (3 feb) |
registry.lab |
10.10.0.11 | OPNsense | A6.4 (12 feb) |
api.dev.lab, en el puesto del alumno |
la IP WAN de OPNsense | /etc/hosts del puesto |
A3.2 (25 nov) |
jenkins.lab y grafana.lab, en el puesto del alumno |
127.0.0.1, por el túnel de cada uno | /etc/hosts del puesto |
con su túnel |
<host>.pre.lab |
la .10 de cada subred de pre |
solo router-pre |
A5.3 (8 ene); en las hojas se usa la IP |
El 27 de noviembre, al trasladar app01 y mon01, se borran las líneas del aula del /etc/hosts del puesto, de mon01 y de app01: desde ese día los nombres los da OPNsense. Las VM de las zonas y mon01 reciben el DNS del .1 de su zona por DHCP; jenkins01, gitea01 y agent01 lo llevan fijo en su qm set (--nameserver 10.10.0.1 --searchdomain lab), y admin01 lo recibe en la A3.1 con esa misma orden (qm set 105 --nameserver 10.10.0.1 --searchdomain lab y un reinicio). Con la hora pasa lo mismo: desde la A3.1, OPNsense la sirve a todas las zonas por la regla 0, y cada VM la toma del .1 de su zona con systemd-timesyncd, como web01 y db01 en esa hoja.
Cómo se entra. Hasta el 27 de noviembre, a app01 y mon01 se entra por SSH directamente a su IP del aula, con la clave del puesto que la A1.3 metió en la plantilla; a las que ya están en la VPC (web01 y db01, desde el 30 de octubre), desde el nodo: directamente el 30 de octubre, que el nodo es todavía el .1 de cada subred, y con salto por router-dev desde el 4 de noviembre (ssh -J ops@<IP de aula de router-dev> ops@10.10.1.10); desde el 6 de noviembre, desde admin01. Desde el 27 de noviembre todas quedan detrás de OPNsense y solo admin01 tiene un pie en el aula, así que se entra con salto por él:
Para no escribir el salto cada vez, este ~/.ssh/config en el puesto del alumno:
Host admin01
HostName 192.168.1.60 # la IP de aula de admin01, la que le da el DHCP del aula
User ops
Host web01
HostName 10.10.1.10
Host app01
HostName 10.10.2.10
Host db01
HostName 10.10.3.10
Host mon01
HostName 10.10.0.20
Host jenkins01
HostName 10.10.0.10
Host gitea01
HostName 10.10.0.11
Host agent01
HostName 10.10.0.12
Host web01 app01 db01 mon01 jenkins01 gitea01 agent01 10.20.*
User ops
ProxyJump admin01
Con él, ssh app01, scp fichero mon01: o ssh 10.20.2.10 pasan por admin01 sin más. ssh toma cada opción del primer bloque que la define: por eso los HostName van arriba, uno por máquina, y el usuario y el salto, una sola vez abajo. Si el DHCP del aula cambia la IP de admin01, solo se toca la primera línea.
Las consolas web se abren con un túnel a través de admin01, que en el puesto escucha en el 28443: un puerto de la franja del curso, para no chocar con lo que ya tenga abierto el equipo. Las de esta asignatura son dos: la de OPNsense, ssh -L 28443:10.10.0.1:443 admin01 y https://localhost:28443, y la de Jenkins, ssh -L 28443:10.10.0.10:443 admin01 con la línea 127.0.0.1 jenkins.lab en el fichero hosts del puesto y https://jenkins.lab:28443. Las de la pila de monitorización (Prometheus, Alertmanager, Mailpit y Grafana) están en el laboratorio de Mantenimiento, en Cómo se llega a la pila desde el 3 de diciembre. La de Grafana usa también el 28443 del puesto, así que de esos tres túneles solo puede estar abierto uno a la vez.
Puertos
La franja del curso. Los puertos del servicio y de la monitorización van todos en la franja del 20000 al 29999, con una regla: el puerto de fábrica de cada programa más 20000 (Prometheus, del 9090 al 29090; la API, del 8080 al 28080). Los de fábrica son también los de muchas herramientas que pueden estar en marcha en el puesto del alumno, como el 80 de XAMPP o IIS, el 3000 de los servidores de desarrollo de Node, el 8080 de Tomcat o el 9090 de Cockpit, y un docker compose up que pide un puerto ocupado falla. La franja queda por encima de todos ellos y por debajo de los que el sistema operativo reparte a las conexiones salientes (desde el 32768 en Linux y desde el 49152 en Windows y macOS) y del rango de NodePort de Kubernetes (del 30000 al 32767). Cada servicio escucha en su número dentro del contenedor y se publica en el mismo, así que tiene uno solo en todas partes: en el compose.yml, en el navegador, en Prometheus y en el cortafuegos. La regla se ajusta cuando dos servicios de la misma máquina caerían en el mismo número: cAdvisor va en el 28081 porque el 28080 es de la API en app01, Gitea en el 23001 porque el 23000 es de Grafana en mon01, y whoami en el 28090 porque el 20080 es del nginx del compose del servicio.
Lo que se queda fuera. Los puertos que espera cualquier cliente (22, 53, 80, 443 y el 5432 de PostgreSQL), los de productos que no forman parte del servicio (el 8006 de Proxmox, el 2376 de Docker con TLS y el 5000 del registry, que va escrito en el nombre de cada imagen) y los que solo existen dentro de una red de Docker y nunca se publican, como el 8080 de Jenkins o el 1025, el SMTP de Mailpit.
| Puerto | Servicio | Dónde |
|---|---|---|
| 22 | SSH | todas las VM, usuario ops; desde el 27 nov, con salto por admin01 |
| 80 | HTTP, solo redirección a 443 | web01 |
| 443 | HTTPS, con nginx delante | api.dev.lab en web01, publicado en la WAN de OPNsense; jenkins.lab en jenkins01, gitea.lab en gitea01 desde el 12 feb y grafana.lab en mon01 desde el 3 dic, los tres en gestión; la consola de OPNsense, solo desde MGMT |
| 2376 | Docker de agent01 con TLS, para los agentes efímeros | agent01 |
| 5000 | registry de imágenes con TLS y htpasswd |
gitea01 desde el 19 feb, registry.lab:5000 |
| 5432 | PostgreSQL | db01, abierto solo a back; db01-pre, solo a 10.20.2.0/24 |
| 8006 | interfaz web de Proxmox | el nodo, en la red del aula |
| 8080 | Jenkins por HTTP, puerto interno | dentro del compose de jenkins01, nunca publicado |
| 20080 | nginx del compose del servicio | el puesto del alumno hasta el 13 oct y app01 hasta el 27 nov; desde entonces el proxy es el nginx de web01 |
| 23000 | Grafana | mon01; desde el 3 dic, solo por detrás de su nginx |
| 23001 | Gitea | mon01, publicado, del 17 nov (A2.6 de Mantenimiento) al 12 feb (A6.4); en gitea01, solo por detrás de su nginx |
| 23100 | Loki, con certificado de cliente desde el 3 dic | mon01 |
| 25000 | receptor de incidencias de Alertmanager | mon01, solo en 127.0.0.1 |
| 28025 | Mailpit, buzón de pruebas de Alertmanager (su web; el SMTP sigue en el 1025, dentro del compose) | mon01, solo en 127.0.0.1 desde el 3 dic |
| 28080 | la API del curso | app01 y app01-pre |
| 28081 | cAdvisor | app01 |
| 28090 | whoami, el contenedor de pruebas de cabeceras |
app01, desde la A3.3 |
| 28443 | túnel a las consolas web por HTTPS (OPNsense, Jenkins y Grafana) | el puesto del alumno |
| 29000 y 29001 | API S3 y consola de MinIO | 10.10.0.30, en mon01 |
| 29080 | Promtail | app01 |
| 29090 | Prometheus | mon01, solo en 127.0.0.1 desde el 3 dic |
| 29093 | Alertmanager | mon01, solo en 127.0.0.1 desde el 3 dic |
| 29100 | node_exporter | todas las VM que salen de la plantilla, que lo deja en este puerto; en app01, con TLS y usuario desde el 1 dic |
| 29102 | /metrics de la aplicación |
app01 |
| 29187 | postgres_exporter | en el compose del servicio hasta el 27 nov; en db01 desde la A3.3 |
Jenkins deja escrito su nombre en tres sitios y los tres dicen lo mismo: nombre público jenkins.lab, puerto público 443 (https://jenkins.lab, con nginx delante terminando TLS) y puerto interno 8080 dentro de la red del compose. En el servidor, el 8443 solo aparece en la variante con keystore Java, que no es la instalación del curso y está recogida en Para ampliar; en el puesto del alumno, el túnel usa el 28443. Los agentes que llaman al controlador lo hacen por WebSocket a través del mismo 443, así que el puerto 50000 no se abre.
El registry se escribe siempre entero, con puerto: registry.lab:5000. Ni registry.dev.lab ni registry.lab a secas.
Matriz de reglas de OPNsense
Una sola matriz para las dos asignaturas. Las pestañas son las interfaces de OPNsense (WAN, MGMT, DMZEXT, DMZINT, INT, CLI_A y CLI_B) y el grupo ZONAS, que las reúne todas menos WAN. Los alias son los de la A3.2 (srv_web, srv_app, srv_db, net_mgmt, p_web, p_app...) más los que añade la hoja de cada fila. Los números se reparten así: del 1 al 10, esta asignatura; del 11 al 20, la UT3 de Mantenimiento; del 21 en adelante, las unidades posteriores, que hoy no añaden ninguna. La denegación por defecto es siempre la 99. El número va al principio de la descripción de cada regla en OPNsense, para que el log y la matriz se crucen sin buscar.
| # | Pestaña | Origen | Destino | Puertos | Acción | Log | Para qué | Nace en |
|---|---|---|---|---|---|---|---|---|
| 0 | ZONAS | la red de la zona | This Firewall | p_infra (53 TCP y UDP, 123 UDP) e ICMP echo |
Pass | no | DNS, hora y ping al propio cortafuegos | A3.1 (20 nov) |
| 1 | WAN | any | srv_web |
p_web (80, 443) |
Pass | no | Publicación de api.dev.lab, con su port forward |
A3.2 (25 nov) |
| 2 | MGMT | net_mgmt |
any | p_web (80, 443) |
Pass | no | Consola del cortafuegos y salida a Internet de gestión, la única permanente | A3.2 (25 nov) |
| 3 | DMZEXT | srv_web |
srv_app |
p_app (28080, 28090) |
Pass | no | El proxy reenvía a la API y a whoami |
A3.3 (27 nov) |
| 4 | DMZINT | srv_app |
srv_db |
5432 | Pass | sí | La API consulta PostgreSQL | A3.3 (27 nov) |
| 5 | MGMT | net_mgmt |
any | 22 | Pass | sí | Administración por SSH | A3.2 (25 nov) |
| 6 | DMZINT | srv_app |
srv_gitea |
23001; 443 desde la A6.4 | Pass | no | git pull y git push de servicio desde app01. srv_gitea es la 10.10.0.20 hasta el 12 feb y la 10.10.0.11 desde la A6.4 |
A3.3 (27 nov) |
| 7 | CLI_A | net_cli_a |
srv_web |
443 | Pass | no | Cliente A al proxy compartido | A3.4 (2 dic) |
| 8 | CLI_A | net_cli_a |
any | any | Block | sí | Cliente A: el resto, denegado | A3.4 (2 dic) |
| 9 | CLI_B | net_cli_b |
srv_web |
443 | Pass | no | Cliente B al proxy compartido | A3.4 (2 dic) |
| 10 | CLI_B | net_cli_b |
any | any | Block | sí | Cliente B: el resto, denegado | A3.4 (2 dic) |
| 11 | MGMT | srv_mon |
srv_app |
p_mon_app (29100, 28081, 29102, 29080) |
Pass | sí | Scrape de mon01 a app01 | A3.1 de Mantenimiento (26 nov) |
| 12 | MGMT | srv_mon |
srv_db |
p_mon_db (29100, 29187) |
Pass | sí | Scrape de mon01 a db01 | A3.1 de Mantenimiento (26 nov) |
| 13 | DMZINT | srv_app |
srv_mon |
23100 | Pass | sí | Promtail de app01 hacia Loki | A3.1 de Mantenimiento (26 nov) |
| T | la de la zona | la máquina | any | p_web |
Pass | sí | TEMPORAL alta <fecha> baja <fecha> <motivo>: la salida de una zona de servicio para instalar algo |
La hoja que la necesita, que la borra en el mismo paso |
| 99 | todas | any | any | any | Block | sí | Denegación por defecto | A3.1 (20 nov) |
Desde el 20 de noviembre las zonas de servicio no salen a Internet (hasta ese día router-dev da salida a las cuatro zonas de dev): cuando una hoja tiene que instalar algo en ellas, abre la fila T en la pestaña de esa zona, instala y la borra en el mismo paso, y mientras existe la anota en la matriz. Gestión sale siempre, por la fila 2. La regla anti-lockout de MGMT la pone OPNsense sola y no lleva número. Ninguna fila deja a mon01 llegar a los puertos de scrape de front (la fila 2 solo le abre el 80 y el 443), y por eso la UT7 no vigila web01. pre no pasa por OPNsense: gestión llega a pre por la pata de router-pre en devmgmt, y pre sale a Internet por el NAT de router-pre.
La aplicación del curso
Las dos asignaturas trabajan sobre el mismo servicio, y esto es lo que cualquier hoja de cualquiera de las dos puede dar por hecho de él:
| Pieza | Valor |
|---|---|
| Lenguaje y servidor | Python con Flask, servido con gunicorn con un solo worker, hasta que se explique el modo multiproceso |
| Rutas | GET /health, GET /items, POST /items, GET /items/<id> y POST /login |
| Autenticación | POST /login con el usuario de prueba test devuelve un token Bearer |
| Errores | JSON {"error": "..."} con 400, 401, 404 o 422 |
| Puertos | la API en el 28080 y sus métricas en /metrics del 29102, los de la franja del curso; hasta el 27 nov, el nginx del compose en el 20080 |
| Repositorio | servicio: el código de la API en api/, con su api/Dockerfile, y compose.yml en la raíz |
| Compose | proyecto servicio en /opt/servicio, en todos los entornos. Servicios nginx, app y db hasta el 27 nov; desde la A3.3, solo app |
| Contenedores | servicio-app-1, servicio-db-1 y servicio-nginx-1 |
| Base de datos | base servicio y usuario de la aplicación app; el superusuario sigue siendo postgres. La API crea su esquema al arrancar si no existe |
| Imagen | app:<versión>, construida en app01 desde api/Dockerfile, hasta el 19 feb; desde la A6.6, registry.lab:5000/app:<versión> y registry.lab:5000/app:<commit corto>, que publica el pipeline |
| Etiquetas | el scrape de Prometheus deja host y service; Promtail deja host, service, container y level, este en minúsculas (info, warning, error) |
Las recetas que paran, arrancan o reinician una pieza usan siempre el compose y el nombre del servicio, nunca el del contenedor escrito a mano: docker compose -f /opt/servicio/compose.yml stop app. Las que provocan un fallo en app01 se lanzan desde el puesto, con ssh ops@<app01> docker compose -f /opt/servicio/compose.yml <acción> <servicio>. Los selectores de LogQL usan service y level: {service="app", level="error"}.
El paso a db01. Hasta el 27 de noviembre, la base y el proxy son los servicios db y nginx del compose de app01. La A3.3 instala PostgreSQL en db01 con la base servicio y el usuario app, pone DB_HOST=10.10.3.10 en el .env de /opt/servicio y quita db, nginx y postgres_exporter del compose. Los datos de prueba de octubre y noviembre no se trasladan: son de prueba, y la API crea el esquema vacío. Desde ese día PostgreSQL de dev se maneja con systemctl en db01, postgres_exporter corre como paquete en db01 y el proxy es el nginx de web01.
Nombres compartidos
Cada artefacto que usan las dos asignaturas tiene un solo nombre. Un nombre distinto no da error: da un 404, un «no existe» o una consulta vacía que se lee como cero.
| Artefacto | Nombre |
|---|---|
| Plantilla cloud-init | 9000, Debian 13 genericcloud, con qemu-guest-agent y prometheus-node-exporter dentro, este ya en el 29100, y dos claves públicas, la del puesto del alumno y la del nodo |
| Usuario en las VM | ops, con clave SSH ed25519 y sin contraseña |
| Zona del SDN | lab, tipo Simple, IPAM pve |
| Imagen del servicio | app:<versión> local hasta el 19 feb; desde entonces, registry.lab:5000/app:<versión> y registry.lab:5000/app:<commit corto> |
| Proyecto compose | servicio, en /opt/servicio, en dev y en pre |
| Base y usuario | base servicio, usuario app |
| Repositorios | propietario ops: ops/servicio, ops/monitoring, ops/alerting, ops/operacion, ops/incidencias, ops/iac-lab, ops/jenkins-config y ops/entregas-5166 |
| CA del curso | Lab 5166 CA, en ~/ca/ de admin01, creada con openssl ca en la A3.2 (25 nov); no hay otra |
| Usuario de Proxmox para OpenTofu | terraform@pve con el token tofu; nace en la A5.1 con PVEVMAdmin en /vms, PVEDatastoreUser en /storage/local-lvm y PVESDNUser en /sdn/zones/lab |
| Usuario de prácticas de la A2.6 | cli@pve, que la propia A2.6 borra al terminar |
| Credenciales de Jenkins | git-ro (token de Gitea de solo lectura), registry-cred (usuario jenkins del registry), ssh-pre (clave SSH de ops para pre, solo en la carpeta pre) y telegram-token. Jenkins no guarda ningún token de Proxmox |
| Etiqueta de equipo en las alertas | team |
| Tabla nftables en los hosts | inet fw |
| Credencial de MinIO para las copias | restic |
| Repositorio restic | uno solo, s3:http://10.10.0.30:29000/backups, con la contraseña en /etc/restic/pass; las copias de pre llevan --tag pre |
| Volumen de Gitea en mon01 | monitoring_gitea_data |
| Alarmas de la UT2 de Mantenimiento | la lista cerrada de su A2.4, que incluye HostDown; ninguna unidad cita otras |
| Retención de Prometheus | 45 días |
Repositorios
Todos los repositorios del curso viven en la Gitea del laboratorio, bajo el propietario ops. Hasta el 12 de febrero esa Gitea es un contenedor de mon01 y la URL es http://gitea.lab:23001/ops/<repositorio>.git; la A6.4 la traslada a gitea01, y cada copia de trabajo cambia de remoto una sola vez, con git remote set-url origin https://gitea.lab/ops/<repositorio>.git.
| Repositorio | Qué guarda | Nace en | Copia de trabajo | Remoto desde |
|---|---|---|---|---|
servicio |
La API en api/ con su Dockerfile, el compose.yml, las pruebas y el Jenkinsfile |
A1.1 de Mantenimiento (1 oct), con el código que entrega el profesor | app01, en /opt/servicio (en el puesto del alumno hasta el 15 oct) |
A2.6 de Mantenimiento (17 nov) |
monitoring |
La pila de mon01; desde la UT7 de esta asignatura, también sus ficheros ut7-* |
A1.1 de Mantenimiento (1 oct) | mon01, en /opt/monitoring (en el puesto del alumno hasta el 15 oct) |
A2.6 de Mantenimiento |
alerting |
Reglas, Alertmanager y el receptor de incidencias | A2.1 de Mantenimiento (29 oct) | mon01, en /opt/alerting |
A2.6 de Mantenimiento |
incidencias |
Solo las issues que abre el receptor de alertas | A2.6 de Mantenimiento (17 nov), directamente en Gitea | ninguna | desde que nace |
entregas-5166 |
El trabajo de las hojas de esta asignatura, una carpeta por hoja | A2.1 de Despliegue (28 oct), en local | admin01 desde la A2.4 (6 nov) | 17 nov, en cuanto existe la Gitea de mon01 |
operacion |
Fichas de métricas, catálogo de alarmas, runbooks y revisiones | A4.1 de Mantenimiento (15 dic) | admin01 | la propia A4.1 |
iac-lab |
OpenTofu y Ansible de pre | A5.1 de Despliegue (16 dic), con git init |
admin01 | la propia A5.1 |
jenkins-config |
La instalación de Jenkins (compose, JCasC, plugins, nginx) y el compose del registry | A6.2 de Despliegue (5 feb) | jenkins01, en ~/jenkins-config |
la propia A6.2 |
Desde el 27 de noviembre app01 llega a Gitea por la fila 6 de la matriz de reglas. Las dos asignaturas entregan cada una su etiqueta de git del mismo monitoring: entrega-5169-ut8 y entrega-5166-ut7.
Ninguno puede contener un secreto: .env y secrets/ van en .gitignore desde el primer commit, y desde la A5.8 (27 ene) gitleaks corre como hook de pre-commit en iac-lab.
Cómo se monta MinIO
Lo monta cada alumno en el paso 1 de la A5.2 (18 de diciembre), salvo que el profesor lo monte para toda el aula: entonces basta con apuntar el endpoint, la clave y el secreto que dé, y comprobar con mc ls que se ven tfstate y backups. Va como un contenedor más de la pila de mon01 y no como VM propia porque la máquina ya tiene Docker, está encendida desde octubre y así el presupuesto de memoria no sube. Fuera de un laboratorio no se juntaría el almacén de copias con la máquina que vigila: si se pierde mon01, se pierden a la vez la monitorización y las copias. En una empresa es un servicio aparte, con versionado y Object Lock, que es lo que comprueba la UT6 de Mantenimiento.
La segunda dirección. La 10.10.0.30 se añade a la tarjeta de gestión de mon01 (en las VM del curso, ens18) con una unidad de systemd, igual que la ruta del puesto de administración en la A2.4, para no depender de los ficheros de red que escribe cloud-init. El Before=docker.service asegura que la dirección existe antes de que arranque el contenedor; sin él, Docker falla con cannot assign requested address.
sudo tee /etc/systemd/system/ip-minio.service > /dev/null <<'EOF'
[Unit]
Description=Segunda dirección de mon01 para MinIO
After=network-online.target
Wants=network-online.target
Before=docker.service
[Service]
Type=oneshot
RemainAfterExit=yes
ExecStart=/sbin/ip addr replace 10.10.0.30/24 dev ens18
[Install]
WantedBy=multi-user.target
EOF
sudo systemctl enable --now ip-minio.service
El servicio. Va en el compose.yml de /opt/monitoring, con minio_data: declarado en volumes:. El puerto se publica solo en la dirección nueva, para que la pila de monitorización siga en la 10.10.0.20. La contraseña de admin va en el .env junto al compose.yml, en 600 y en el .gitignore del repositorio monitoring. La ruta interna es /almacen para no confundirla con el /data de db01. Los puertos son los de fábrica de MinIO, el 9000 de la API S3 y el 9001 de la consola, llevados a la franja del curso con --address y --console-address.
minio:
image: quay.io/minio/minio:latest
command: server /almacen --address ":29000" --console-address ":29001"
restart: unless-stopped
environment:
MINIO_ROOT_USER: admin
MINIO_ROOT_PASSWORD: ${MINIO_ROOT_PASSWORD:?ponla en el .env}
ports:
- "10.10.0.30:29000:29000"
- "10.10.0.30:29001:29001"
volumes:
- minio_data:/almacen
Buckets y credenciales. mc, el cliente de MinIO, se usa como contenedor de un solo uso. Los secretos de tofu y restic van al gestor de contraseñas del puesto de administración: el de tofu lo pide la A5.4 y el de restic, la A7.4 de Mantenimiento.
cd /opt/monitoring && docker compose up -d minio
set -a; . ./.env; set +a # trae MINIO_ROOT_PASSWORD a esta terminal
M="docker run --rm --network host -e MC_HOST_lab=http://admin:$MINIO_ROOT_PASSWORD@10.10.0.30:29000 quay.io/minio/mc"
$M mb lab/tfstate # el estado de OpenTofu
$M mb lab/backups # las copias restic de Mantenimiento
$M admin user add lab tofu 'CambiaEsteSecreto1'
$M admin user add lab restic 'CambiaEsteSecreto2'
$M admin policy attach lab readwrite --user tofu
$M admin policy attach lab readwrite --user restic
$M ls lab # tfstate y backups
Desde el puesto de administración, curl -s -o /dev/null -w '%{http_code}\n' http://10.10.0.30:29000/minio/health/live tiene que responder 200.
Cuando algo se rompe
Se va a romper. Es parte del módulo. El orden de recuperación, de menos a más drástico:
- Snapshot de la VM afectada. Antes de cada práctica evaluable conviene hacer un snapshot de las VM que se vayan a tocar. Volver atrás cuesta segundos.
- Recrear la VM desde la plantilla. Con cloud-init es un minuto; las de pre, con un
tofu apply. - Snapshot de la VM de Proxmox en VirtualBox/VMware. Conviene hacerlo al terminar la UT1 (hipervisor limpio y configurado) y al terminar la UT3 (red y firewall montados). Son los dos puntos a los que más veces hay que volver.
- Reinstalar Proxmox. Dos horas con la ISO y las notas de la UT1 a mano. Por eso las notas.
Conviene guardar fuera del equipo del aula una copia de: la clave SSH, los ficheros de configuración del firewall (OPNsense exporta un XML), los repositorios, las plantillas cloud-init y la carpeta ~/ca/ de admin01, sin la que no se puede emitir ni revocar ningún certificado. Con eso se reconstruye todo lo demás.
Repaso previo
Si alguno de estos puntos no está fresco, conviene dedicarle una tarde antes de la UT1:
- Terminal de Linux: rutas, permisos,
systemctl,journalctl, edición connanoovim,sshcon claves. La guía de Linux Journey es corta y suficiente. - Redes: qué es una máscara, cómo se calcula el rango de una subred, qué hace una puerta de enlace, qué es NAT. Cualquier calculadora de subredes (ipcalc) sirve para practicar.
- Docker:
docker run,docker compose up, volúmenes, redes,docker logs. La documentación oficial tiene un tutorial de una hora. - Git: clonar, commit, push, ramas, resolver un conflicto. Pro Git en español, capítulos 2 y 3.
Chuleta de comandos
Lo que se teclea una y otra vez en el laboratorio, agrupado por herramienta. No sustituye a la documentación; es para no tener que buscarla cada vez. Cada comando aparece explicado con calma en su unidad.
Proxmox VE
# Estado general
pvesh get /nodes/pve/status
pveversion -v
qm list # VM
pct list # contenedores LXC
pvesm status # almacenes
# Plantilla cloud-init (UT1)
# Los dos agentes van dentro de la imagen: las VM sin salida a Internet no pueden instalarlos al arrancar
apt install -y libguestfs-tools
export LIBGUESTFS_BACKEND=direct
virt-customize -a /root/debian-13-genericcloud-amd64.qcow2 --install qemu-guest-agent,prometheus-node-exporter \
--write '/etc/default/prometheus-node-exporter:ARGS="--web.listen-address=:29100"' # node_exporter, en el 29100
qm create 9000 --name debian-tpl --memory 2048 --cores 2 --cpu x86-64-v2-AES \
--net0 virtio,bridge=vmbr0 --scsihw virtio-scsi-single --ostype l26
qm set 9000 --scsi0 local-lvm:0,import-from=/root/debian-13-genericcloud-amd64.qcow2,discard=on,ssd=1
qm set 9000 --ide2 local-lvm:cloudinit --boot order=scsi0 --agent enabled=1 --serial0 socket --vga serial0
cat /root/puesto.pub /root/.ssh/id_ed25519.pub > /root/claves.pub # la clave del puesto y la del nodo
qm set 9000 --ciuser ops --sshkeys /root/claves.pub --ipconfig0 ip=dhcp
qm disk resize 9000 scsi0 20G
qm template 9000
# Clonar con su memoria en la misma orden, arrancar, parar, destruir
qm clone 9000 150 --name prueba --full && qm set 150 --memory 512
qm set 150 --net0 virtio,bridge=devfront --ipconfig0 ip=dhcp
qm start 150 && qm stop 150 && qm destroy 150 --purge
# Cambiar de red conservando la MAC, que es la clave de la reserva DHCP
qm config 120 | grep net0
qm set 120 --net0 virtio=<MAC>,bridge=devback
# Snapshots y backup
qm snapshot 110 antes-nginx
qm rollback 110 antes-nginx
qm listsnapshot 110
vzdump 110 --storage local --mode snapshot --compress zstd
# Agente QEMU (necesita qemu-guest-agent dentro de la VM)
qm guest cmd 110 network-get-interfaces
# LXC (UT1): en vmbr0, porque en vmbr1 no hay DHCP ni salida a Internet
pct create 170 local:vztmpl/debian-12-standard_12.7-1_amd64.tar.zst \
--hostname ct01 --memory 512 --cores 1 --rootfs local-lvm:4 \
--net0 name=eth0,bridge=vmbr0,ip=dhcp --unprivileged 1 --features nesting=1
pct start 170 && pct enter 170
# Usuario y token de OpenTofu (UT5), con los permisos justos
pveum user add terraform@pve --comment "OpenTofu del laboratorio"
pveum acl modify /vms --users terraform@pve --roles PVEVMAdmin
pveum acl modify /storage/local-lvm --users terraform@pve --roles PVEDatastoreUser
pveum acl modify /sdn/zones/lab --users terraform@pve --roles PVESDNUser
pveum user token add terraform@pve tofu --privsep 0
# SDN
pvesh get /cluster/sdn/zones
pvesh get /cluster/sdn/vnets
pvesh set /cluster/sdn # equivale al botón Apply
Red y diagnóstico
ip -br a                                # interfaces e IP, resumen
ip r                                    # tabla de rutas
ss -tlnp                                # puertos TCP en escucha y proceso
ping -c 3 10.10.2.10
traceroute -n 10.10.3.10
dig web01.dev.lab @10.10.0.1 +short
nc -zv -w 3 10.10.3.10 5432             # ¿responde el puerto? timeout: filtrado; refused: cerrado
nmap -sn 10.20.0.0/24                   # descubrimiento de hosts
nmap -sS -p- -T4 10.10.2.10             # todos los puertos TCP (root)
nmap -sT -Pn -p 22,80,443,28080 host    # sin ping previo
tcpdump -i ens22 -n host 10.10.3.10 and port 5432
tcpdump -i any -n -w captura.pcap port 28080
curl -kv https://api.dev.lab/health
curl -sf -o /dev/null -w '%{http_code}\n' http://localhost:28080/health   # dentro de app01
ssh -J ops@<IP de aula de admin01> ops@10.10.2.10   # desde el 27 nov; con el ~/.ssh/config del laboratorio, ssh app01

# dnsmasq
journalctl -u dnsmasq -f
cat /var/lib/misc/dnsmasq.leases

# nftables
nft list ruleset
nft -f /etc/nftables.conf
nft add rule inet fw forward iifname "dmzext" oifname "dmzint" tcp dport 28080 accept
OpenTofu / Terraform
tofu init                               # descargar providers, preparar backend
tofu fmt -recursive && tofu validate
tofu plan -out plan.tfplan
tofu apply plan.tfplan
tofu apply -auto-approve                # solo dentro de test.sh (A5.6)
tofu destroy
tofu output -json
tofu state list
tofu state show 'proxmox_virtual_environment_vm.vm["web01"]'
tofu state rm 'module.vm.proxmox_virtual_environment_vm.vm'
tofu import 'proxmox_virtual_environment_vm.vm["db01"]' pve/230
cd envs/pre && tofu init && tofu plan   # un directorio por entorno, sin workspaces (UT5)
tofu plan -detailed-exitcode            # 0 sin cambios, 2 con cambios, 1 error
export TF_VAR_pve_token="terraform@pve!tofu=xxxxxxxx-..."
export TF_LOG=DEBUG                     # cuando el provider hace cosas raras
Ansible
ansible -i inventory.ini all -m ping
ansible -i inventory.ini app -m setup -a 'filter=ansible_memtotal_mb'
ansible -i inventory.ini all -b -m apt -a 'name=htop state=present'
ansible-playbook -i inventory.ini site.yml
ansible-playbook -i inventory.ini site.yml --check --diff
ansible-playbook -i inventory.ini site.yml --limit app
ansible-playbook -i inventory.ini site.yml -e app_image=registry.lab:5000/app:abc1234   # otra versión, como el job despliegue (A6.8)
ansible-inventory -i inventory.ini --graph
ansible-lint site.yml
ansible-vault encrypt group_vars/all/vault.yml
ansible-vault edit group_vars/all/vault.yml
ansible-galaxy collection install community.docker
Seguridad del código
checkov -d . --quiet
checkov -d . --skip-check CKV_TF_1 --soft-fail
trivy config .
trivy fs --scanners secret,misconfig .
gitleaks detect --source . --verbose
gitleaks protect --staged                # como hook de pre-commit
ssh ops@app01 docker save app:1.4.2 > app.tar && trivy image --input app.tar   # la imagen local, antes del registry
sops --encrypt --age $(cat ~/.age/key.pub) secrets.yaml > secrets.enc.yaml
sops --decrypt secrets.enc.yaml
Docker y registry
# El servicio: siempre por su compose y el nombre del servicio, nunca por el del contenedor
docker compose -f /opt/servicio/compose.yml ps
docker compose -f /opt/servicio/compose.yml restart app
docker compose -f /opt/servicio/compose.yml logs -f app
docker compose down -v                   # cuidado: borra volúmenes
docker build -t app:1.4.2 api            # en app01, en /opt/servicio, hasta el 19 feb
docker build -t registry.lab:5000/app:$(git rev-parse --short HEAD) api
docker push registry.lab:5000/app:abc1234
ssh ops@10.10.2.10 docker save app:1.4.2 | ssh ops@10.20.2.10 sudo docker load   # de app01 de dev a pre, lanzado en admin01: pre no llega al registry
docker stats --no-stream
docker system df && docker system prune -f
# Registry con TLS y htpasswd (UT6): en gitea01, /opt/registry, con el compose.yml de la sesión 35
docker run --rm --entrypoint htpasswd httpd:2 -Bbn jenkins 'S3creto' > auth/htpasswd
docker compose up -d
curl --cacert ca.crt -u jenkins https://registry.lab:5000/v2/_catalog
# Confiar en la CA del curso
sudo cp ca.crt /usr/local/share/ca-certificates/lab-ca.crt && sudo update-ca-certificates
sudo mkdir -p /etc/docker/certs.d/registry.lab:5000 && sudo cp ca.crt /etc/docker/certs.d/registry.lab:5000/
Certificados
# La CA del curso, una sola vez (UT3): en ~/ca/ de admin01, con el ca.cnf de la sesión 15
openssl req -x509 -newkey ec -pkeyopt ec_paramgen_curve:prime256v1 -nodes \
  -keyout ca.key -out ca.crt -days 3650 -subj "/CN=Lab 5166 CA" \
  -addext "keyUsage=critical,keyCertSign,cRLSign"
# Certificado de servidor con SAN (con -extensions client_cert, uno de cliente)
openssl req -new -newkey ec -pkeyopt ec_paramgen_curve:prime256v1 -nodes \
  -keyout jenkins.key -out jenkins.csr -subj "/CN=jenkins.lab" -addext "subjectAltName=DNS:jenkins.lab"
openssl ca -config ~/ca/ca.cnf -extensions server_cert -in jenkins.csr -out jenkins.crt
# Comprobar
cat ~/ca/index.txt                        # una línea por certificado, con V si es válido
openssl x509 -in jenkins.crt -noout -ext subjectAltName
openssl s_client -connect jenkins.lab:443 -servername jenkins.lab </dev/null | openssl x509 -noout -dates -subject
Jenkins
docker compose exec jenkins cat /var/jenkins_home/secrets/initialAdminPassword   # solo sin JCasC
# CLI, desde una máquina que resuelva jenkins.lab y confíe en la CA del curso
curl -sO https://jenkins.lab/jnlpJars/jenkins-cli.jar
java -jar jenkins-cli.jar -s https://jenkins.lab -auth admin:TOKEN list-jobs
java -jar jenkins-cli.jar -s https://jenkins.lab -auth admin:TOKEN build servicio/ci/main -p ENV=pre -p RUN_DEPLOY=true
# Validar un Jenkinsfile sin ejecutarlo
curl -sk -u admin:TOKEN -X POST -F "jenkinsfile=<Jenkinsfile" https://jenkins.lab/pipeline-model-converter/validate
# Copia de seguridad, en jenkins01: el volumen lleva delante el nombre del proyecto compose
docker run --rm -v jenkins-config_jenkins_home:/data -v $PWD:/backup alpine tar czf /backup/jenkins_home-$(date +%F).tgz -C /data .
Prometheus, Alertmanager y Grafana
# Desde el 3 dic, Prometheus y Alertmanager solo escuchan en 127.0.0.1 de mon01: se usan desde una
# shell en mon01 o por el túnel que da el laboratorio de Mantenimiento, y amtool, con docker compose exec
cd /opt/monitoring                        # en mon01: promtool y amtool van dentro de sus contenedores
docker compose exec prometheus promtool check config /etc/prometheus/prometheus.yml   # revisa también rule_files
docker compose exec prometheus promtool query instant http://localhost:29090 'up'
docker compose exec alertmanager amtool check-config /etc/alertmanager/alertmanager.yml
docker compose exec alertmanager amtool --alertmanager.url=http://localhost:29093 alert
docker compose exec alertmanager amtool --alertmanager.url=http://localhost:29093 silence add alertname=HostDown --duration=2h --comment "mantenimiento"
curl -s http://10.10.3.10:29100/metrics | grep -E '^node_(memory_MemAvailable|filesystem_avail)'   # desde mon01; el de app01 va con TLS
curl -s -X POST http://localhost:29090/-/reload   # en mon01
ansible-playbook -i ansible/dev.ini ansible/ut7-targets.yml   # en admin01, en iac-lab: regenera targets/ut7-*.yml (A7.1)
# Exportar un dashboard de Grafana por API, por el túnel de Grafana (sale con el uid de la fuente
# de datos de esta instancia, no con el hueco ${DS_PROMETHEUS} del export de la interfaz que pide la A7.2)
curl -s --cacert ca.crt -H "Authorization: Bearer $GRAFANA_TOKEN" https://grafana.lab:28443/api/dashboards/uid/<uid> | jq .dashboard > grafana/ut7/kpi-plataforma.json
Consultas PromQL que se usan constantemente:
up == 0
100 - avg by(host)(rate(node_cpu_seconds_total{mode="idle",env="dev"}[5m])) * 100
node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes * 100
node_filesystem_avail_bytes{mountpoint="/"} / node_filesystem_size_bytes{mountpoint="/"} * 100
rate(container_cpu_usage_seconds_total{service="app"}[5m])
container_memory_working_set_bytes{service="app"}
increase(default_jenkins_builds_failed_build_count_total[1h])
histogram_quantile(0.95, sum by(le)(rate(app_http_request_duration_seconds_bucket[5m])))
Git
git init -b main && git add . && git commit -m "Primer despliegue"
git remote add origin http://gitea.lab:23001/ops/iac-lab.git && git push -u origin main   # hasta el 12 feb
git remote set-url origin https://gitea.lab/ops/iac-lab.git                               # desde la A6.4 (12 feb)
git switch -c feature/ansible-docker
git log --oneline --graph --all
git diff main..feature/ansible-docker
# Quitar un fichero del historial (secreto subido por error): antes se rota el secreto
git filter-repo --path terraform.tfvars --invert-paths
Glosario
Términos que aparecen en el módulo, explicados en una o dos frases y con la unidad donde se tratan a fondo. Si un término no está, el buscador de la barra de arriba lo localiza: casi seguro que aparece en alguna unidad.
ACK · Bandera del segmento TCP con la que el receptor confirma lo que ha recibido. En un escaneo, un SYN al que contesta un SYN/ACK indica un puerto abierto. UT3.
ACL (Access Control List) · Lista que dice quién puede hacer qué sobre un recurso: un fichero, un bucket o el tráfico de una red. UT1, UT2, UT5.
ACME · Protocolo con el que un servidor pide y renueva sus certificados sin intervención humana; es el que usa Let's Encrypt. UT3.
ADC (Application Default Credentials) · Credenciales por defecto que buscan las librerías de Google Cloud. Las deja gcloud auth application-default login y son distintas del login de gcloud. UT4.
AES (Advanced Encryption Standard) · Algoritmo estándar de cifrado simétrico (la misma clave cifra y descifra). Es el que usan por debajo el cifrado de discos, las conexiones TLS y los secretos de las herramientas del curso. UT1, UT5.
Agente (CI) · Máquina o contenedor donde el orquestador ejecuta de verdad las tareas. El controlador solo coordina. En Jenkins se eligen por etiqueta; en GitLab se llaman runners. UT6.
Agente QEMU (qemu-guest-agent) · Servicio dentro de la VM por el que Proxmox le pregunta la IP, la apaga limpiamente y congela su sistema de ficheros durante un snapshot o una copia. En el curso va dentro de la plantilla 9000. UT1.
Alertmanager · Componente de Prometheus que recibe las alertas disparadas, las agrupa, las silencia si toca y las envía por correo, Telegram, Slack o webhook. UT7.
Alias (OPNsense) · Nombre que se da en el cortafuegos a una IP, una red o una lista de puertos para escribir las reglas con él (srv_web, net_mgmt, p_web). Si la dirección cambia, se cambia el alias y no cada regla. UT3.
Ansible · Herramienta de gestión de configuración: ejecuta por SSH tareas idempotentes descritas en YAML (playbooks) sobre un inventario de máquinas. No necesita agente en el destino. UT5.
ARC · Caché de lectura de ZFS en la RAM del host. Hay que sumarla al presupuesto de memoria cuando el almacenamiento es ZFS. UT1.
ARP · Protocolo con el que una máquina averigua la MAC que corresponde a una IP de su misma red. Si dos máquinas de la zona tienen la misma .1, el ARP de esa dirección cambia de MAC y el ping falla a ratos; se mira con ip neigh. UT2, UT3.
Artefacto · Resultado de una etapa del pipeline que se guarda: un paquete, una imagen, un informe de pruebas. UT6.
AVX y SSE4.2 · Juegos de instrucciones de la CPU que el invitado solo ve si el tipo de CPU de la VM los expone. El tipo x86-64-v2-AES del laboratorio llega hasta SSE4.2 y AES-NI (cifrado por hardware), sin AVX. UT1.
AWS · Amazon Web Services, la nube pública de Amazon. Es el proveedor que se desarrolla en la UT4, con Azure y Google Cloud como correspondencia. UT4.
Backend (Terraform) · Dónde se guarda el estado. Local por defecto; remoto (S3/MinIO, HTTP de GitLab, Consul) cuando trabaja más de una persona. UT5.
Ballooning · Mecanismo por el que el hipervisor recupera memoria que la VM tiene asignada pero no usa. Funciona con un driver dentro del invitado. UT1.
Basic auth · Autenticación HTTP con usuario y contraseña en una cabecera. En los exporters oficiales se activa con --web.config.file y la contraseña va en bcrypt. UT7.
Bond · Varias tarjetas de red físicas agrupadas en una sola interfaz (bond0) para tener redundancia o sumar ancho de banda. Es bond0 lo que se pone como puerto del bridge. UT1.
Bridge (Linux) · Switch virtual dentro del host. Las VM se conectan a él como si fuera un switch físico; la tarjeta física del host puede ser un puerto más del bridge. En Proxmox, vmbr0. UT1.
CA · Autoridad de certificación: quien firma los certificados y en quien confían los clientes. En el laboratorio hay una sola, la CA del curso (Lab 5166 CA), creada con openssl ca en la A3.2 y en ~/ca/ del puesto de administración. UT3, UT6.
cAdvisor · Exporter de Google que expone métricas de uso de recursos por contenedor. UT7.
Cardinalidad · Número de series temporales distintas que genera una métrica según sus etiquetas. Una etiqueta con muchos valores posibles (IP de cliente, id de usuario) multiplica las series y tumba Prometheus. UT7.
CD · Entrega continua (continuous delivery): el artefacto que pasa el pipeline queda listo para desplegar y una persona decide cuándo. Si el despliegue también es automático se habla de despliegue continuo. UT6.
checkov · Analizador estático de código de infraestructura (Terraform, Ansible, Dockerfile, Kubernetes) con cientos de reglas de seguridad. UT5.
CI · Integración continua (continuous integration): cada cambio que llega al repositorio se construye y se prueba de forma automática. En la UT5 es el sitio donde corren tofu validate, los escáneres y tofu plan -detailed-exitcode. UT5, UT6.
CIDR · Notación de red con prefijo: 10.10.1.0/24 son las 256 direcciones de 10.10.1.0 a 10.10.1.255. UT2.
CLI (nube) · Programa de línea de comandos del proveedor (aws, az, gcloud) que llama a la misma API que la consola web. Guarda su configuración en el directorio personal y las variables de entorno la sobrescriben. UT4.
Clon enlazado / completo · Un clon enlazado comparte el disco base con la plantilla y solo guarda diferencias (rápido, para pruebas); el completo copia el disco entero (independiente, para producción). UT1.
cloud-init · Estándar para configurar una VM en su primer arranque: usuario, claves SSH, nombre, red, paquetes. Proxmox le pasa los datos por un disco virtual. UT1.
CN · Common Name: el campo del certificado que antes llevaba el nombre del servidor (-subj "/CN=api.dev.lab"). Los navegadores y clientes actuales lo ignoran y miran el SAN. UT3, UT6.
conntrack · Tabla del kernel donde un cortafuegos con estado registra cada conexión abierta, para dejar pasar las respuestas sin reglas explícitas. UT3.
Credencial (Jenkins) · Secreto guardado cifrado en el orquestador y referenciado por su ID en el pipeline. Nunca se escribe en el Jenkinsfile. UT6.
CSR · Petición de firma de certificado: la clave pública y los nombres que se envían a la CA para que los firme. UT3.
CSRF (Cross-Site Request Forgery) · Ataque en el que una web ajena hace que el navegador de un usuario con la sesión abierta envíe una petición sin que él lo sepa. Jenkins se protege con un token por petición, el crumb. UT6.
DMZ · Zona desmilitarizada: subred entre Internet y la red interna donde van los servicios que deben verse desde fuera. Se habla de DMZ externa (proxy, web) y DMZ interna (aplicación). UT3.
DMZEXT, DMZINT e INT · Nombres de las interfaces de OPNsense para front (DMZ externa), back (DMZ interna) y data (zona interna). Cada una es una pestaña de reglas en Firewall → Rules. UT3.
DNAT · Traducción de la dirección de destino: el cortafuegos cambia la IP de destino de un paquete que entra para llevarlo a la máquina interna que corresponde. Es lo que hace un port forward. UT3.
dnsmasq · Servidor ligero de DHCP y DNS en un solo binario. El que se usa como router de entorno. UT2.
DORA · Discover, Offer, Request, Ack: las cuatro fases con las que un cliente obtiene su dirección por DHCP. En el journal de dnsmasq se ve una línea por fase. UT2.
EC2 · Servicio de máquinas virtuales de AWS; cada VM es una instancia. Equivale a Virtual Machines en Azure y a Compute Engine en Google Cloud. UT4.
ECS y AKS · Servicios de contenedores gestionados: ECS en AWS, AKS (Kubernetes gestionado) en Azure. En el módulo solo se citan como correspondencia; no se despliega nada en ellos. UT4.
ELK · Elasticsearch, Logstash y Kibana: la pila clásica para centralizar logs, indexarlos y buscarlos. En el curso se usa Loki, más ligera. UT7.
Estado (Terraform) · Fichero que relaciona cada recurso del código con el recurso real que existe en el proveedor. Sin él, Terraform no sabe qué ha creado. UT5.
EVPN · Tipo de zona del SDN de Proxmox: VXLAN más BGP para anunciar MAC e IP entre nodos, con enrutado distribuido. Solo tiene sentido en un clúster. UT2.
Exporter · Programa que expone métricas de algo (el sistema, una BD, un servicio) en el formato de texto que Prometheus sabe leer. UT7.
file_sd · Descubrimiento de targets en el que Prometheus vigila ficheros JSON o YAML y recarga la lista de máquinas cuando cambian, sin reiniciar. Los escribe Ansible desde el inventario o el pipeline desde los outputs de OpenTofu. UT7.
Formación en empresa (FE) · Periodo del curso que se hace en una empresa con un tutor. En este módulo cubre la UT4, la UT7b y la UT8.
GCP · Google Cloud Platform, la nube pública de Google. En la UT4 aparece como correspondencia del proveedor principal. UT4.
gitleaks · Busca secretos (tokens, claves, contraseñas) en un repositorio, incluido su historial. UT5.
Grafana · Interfaz web que dibuja en paneles las consultas a Prometheus y a otras fuentes. En el curso está en mon01 detrás de un nginx en el 443. UT7.
GUID · Identificador de 32 caracteres hexadecimales separados por guiones. En Azure identifica la suscripción y el tenant. UT4.
HCL · Lenguaje de configuración de Terraform y OpenTofu. Bloques, atributos, expresiones. UT5.
Hipervisor · Software que crea y ejecuta máquinas virtuales repartiendo el hardware entre ellas. Tipo 1 va sobre el metal (Proxmox, ESXi); tipo 2 sobre un sistema operativo (VirtualBox). UT1.
IaC · Infraestructura como código: describir máquinas, redes y reglas en ficheros versionados que una herramienta aplica. UT5.
IAM · El sistema que dice qué identidad puede hacer qué sobre qué recurso. En AWS son users, roles y policies; en Azure, Entra ID más RBAC; en Google Cloud, bindings entre principales y roles. UT4.
ICMP · Protocolo de mensajes de control de IP: el echo de ping y los avisos de destino inalcanzable. Que un ping no responda no demuestra casi nada, porque muchos cortafuegos lo filtran. UT2, UT3.
Idempotencia · Propiedad de una operación que, aplicada dos veces, deja el mismo resultado que aplicada una. Base del IaC. La A2.6 ya exige que los scripts de creación y destrucción se puedan ejecutar dos veces sin error ni duplicados. UT2, UT5.
IDS (Intrusion Detection System) · Sistema que vigila el tráfico o la actividad de una máquina y avisa cuando reconoce un ataque. Solo avisa; el que además corta es el IPS. Ampliación de la UT3.
IOMMU (VT-d / AMD-Vi) · Extensión del hardware que permite ceder un dispositivo PCI entero a una VM (passthrough). UT1.
IOPS · Operaciones de entrada y salida por segundo que aguanta un disco. Es la cifra que se mide con fio y la que se hunde cuando varias VM comparten disco. UT1.
IPAM · Gestión de direcciones IP: registro de qué IP está asignada a qué máquina. El SDN de Proxmox lo integra. UT2.
IPS (Intrusion Prevention System) · Un IDS que además corta el tráfico que reconoce como ataque. Ampliación de la UT3.
JCasC · Jenkins Configuration as Code: plugin que permite definir toda la configuración de Jenkins en un YAML versionado. UT6.
Jenkinsfile · Fichero en el repositorio del proyecto que define el pipeline en sintaxis declarativa de Jenkins. UT6.
JMESPath · Lenguaje de consulta sobre JSON que usan los --query de las CLI de AWS y de Azure para quedarse con unos pocos campos y sacarlos en tabla. UT4.
JUnit · Formato XML estándar de resultados de pruebas. pytest lo genera y Jenkins lo lee para marcar las pruebas que fallan. UT6.
KPI · Indicador clave: la métrica o fórmula que resume si un servicio va bien (disponibilidad, latencia p95, errores por minuto). UT7.
KVM · Módulo del kernel Linux que convierte al kernel en hipervisor usando VT-x/AMD-V. QEMU le pone los dispositivos virtuales. UT1.
LDAP (Lightweight Directory Access Protocol) · Protocolo para consultar un directorio de usuarios y grupos, que es lo que permite que varias aplicaciones de una empresa usen las mismas cuentas. UT1.
LTS (Long Term Support) · Línea de versiones con soporte largo: recibe parches de seguridad durante más tiempo y cambia de funciones con menos frecuencia. El curso usa la LTS de Jenkins. UT6.
LVM-thin · Almacenamiento con aprovisionamiento ligero: un disco de 50 GB ocupa solo lo escrito. Permite snapshots. Riesgo: prometer más de lo que hay. UT1.
LXC · Contenedores de sistema: comparten kernel con el host pero se comportan como una máquina completa. Más ligeros que una VM, menos aislados. UT1.
MAC · Dirección física de una interfaz de red. Proxmox asigna una a cada NIC de la VM; el traslado de la A3.3 la conserva para que la VM no cambie de IP ni de nombre de interfaz. UT2, UT3.
Mailpit · Servidor de correo de pruebas con interfaz web: acepta cualquier mensaje y lo enseña sin entregarlo a nadie. En el curso recibe las notificaciones de Alertmanager. UT7.
MFA · Segundo factor además de la contraseña: código de una app, llave física o passkey. Obligatorio en todo usuario de la nube de la empresa. UT4.
MGMT · La zona de gestión del laboratorio, 10.10.0.0/24: desde ella se administran las demás zonas por SSH y en ella viven las máquinas de control. Ninguna otra zona entra en ella salvo por las filas documentadas de la matriz de reglas: app01 hacia la Gitea provisional (fila 6) y hacia Loki (fila 13). UT2, UT3.
Mínimo privilegio · Dar a cada usuario, servicio o token solo los permisos que necesita para su tarea y nada más. UT6.
Módulo (Terraform) · Directorio con recursos reutilizables que se invoca con parámetros. UT5.
MTU · Tamaño máximo del paquete que admite una interfaz, 1500 bytes en Ethernet. Toda encapsulación (VXLAN, WireGuard) resta cabecera y obliga a bajarla en las VM, normalmente a 1450; olvidarlo se manifiesta como transferencias grandes que se cuelgan sin dar error. UT2.
NAT · Traducción de direcciones: el router o el cortafuegos cambia la IP de origen (SNAT, masquerade) o la de destino (DNAT, port forward) de los paquetes que pasan por él. En el laboratorio da salida a Internet a las zonas y publica api.dev.lab. UT2, UT3.
NFS · Protocolo para compartir directorios por red. En Proxmox es un tipo de almacén compartido entre nodos para ISOs y copias. UT1.
nftables · Cortafuegos del kernel Linux, sucesor de iptables. Tablas, cadenas con hooks y reglas. UT3.
NIC · Tarjeta de red, física o virtual. Cada interfaz que se añade a una VM es una NIC más, conectada a un bridge o a una VNet. UT1, UT2.
node_exporter · Exporter de métricas del sistema operativo: CPU, memoria, disco, red. En el curso escucha en el 29100. Viene instalado en la plantilla 9000 como paquete prometheus-node-exporter desde la A1.3, ya en ese puerto, así que lo lleva toda VM clonada. UT1, UT7.
NTP · Protocolo de sincronización de la hora (123 UDP). Desde la A3.1 el cortafuegos es el servidor de hora de todas las zonas. UT3.
OpenTofu · Fork libre de Terraform mantenido por la Linux Foundation desde el cambio de licencia de HashiCorp. Comandos y sintaxis intercambiables. UT5.
OPNsense · Distribución de cortafuegos basada en FreeBSD con interfaz web. Se usa como firewall entre zonas. UT3.
Orquestador (CI) · Servidor que recibe los cambios del repositorio, ejecuta el pipeline en agentes y guarda los resultados. Jenkins, GitLab CI, GitHub Actions. UT6.
OU (unidad organizativa) · Carpeta de cuentas de AWS Organizations a la que se aplican políticas en bloque. UT4.
Paravirtualización / virtio · Drivers en la VM que saben que están virtualizados y hablan directamente con el hipervisor en lugar de emular hardware real. Mucho más rápidos. UT1.
PBS (Proxmox Backup Server) · Servidor de copias de Proxmox que guarda cada trozo de disco una sola vez y solo lee lo cambiado desde la copia anterior. En el laboratorio no se monta. UT1.
pct · Comando de Proxmox para crear y gestionar contenedores LXC desde la terminal; el equivalente de qm para las VM. UT2.
Perfil (CLI) · Conjunto con nombre de cuenta, región y credenciales que usa la CLI. Lo habitual es uno por entorno; se elige con una opción del comando o con una variable de entorno, que manda sobre el fichero. UT4.
Pipeline · Cadena de etapas por la que pasa cada cambio: checkout, build, test, package, deploy. UT6.
Plan (Terraform) · Lista de lo que la herramienta crearía, cambiaría o destruiría para que el estado real coincida con el código. Se lee siempre antes de aplicar. UT5.
Plantilla (Proxmox) · VM marcada como base de clonado. No se puede arrancar, solo clonar. UT1.
Port forward · Regla NAT que redirige un puerto de la IP pública del firewall a una máquina interna. UT3.
Prometheus · Servidor de monitorización que lee cada pocos segundos las métricas de los exporters (modelo pull), las guarda en su base de series temporales y evalúa las reglas de alerta. En el curso corre en mon01 desde octubre. UT7.
PromQL · Lenguaje de consulta de Prometheus. UT7.
Provider (Terraform) · Plugin que sabe hablar con un proveedor concreto (Proxmox, AWS, DNS...). UT5.
Provisioning (Grafana) · Fuentes de datos y dashboards definidos en ficheros que Grafana lee al arrancar, en lugar de configurarlos a clics. Es lo que permite versionarlos en Git. UT7.
Proxy inverso · Servidor que recibe las peticiones de los clientes y las reenvía a los servidores internos. Termina TLS y oculta la topología. nginx, Traefik, Caddy. UT3.
Pull / push (monitorización) · En pull, el servidor de métricas lee de cada objetivo (Prometheus). En push, cada máquina envía sus datos (Zabbix agent, Pushgateway). UT7.
Pushgateway · Buzón intermedio al que un trabajo corto (un cron, una copia) empuja sus métricas para que Prometheus las lea después. Solo para lotes que no están vivos cuando Prometheus pasa a leer. UT7.
pvesh · Cliente de línea de comandos de la API de Proxmox que se ejecuta en el propio nodo. Recorre la API como un sistema de ficheros: get lee, create es POST, set es PUT y delete es DELETE. UT2.
qcow2 y raw · Formatos de disco de VM. raw es una imagen byte a byte, la más rápida y la que usan LVM-thin y ZFS; qcow2 es un fichero con metadatos que crece bajo demanda y admite snapshots internos, y es el formato en que se distribuyen las imágenes cloud. UT1.
QEMU · Emulador de máquinas que, junto con KVM, ejecuta las VM en Proxmox. UT1.
RBAC (Role-Based Access Control) · Control de acceso por roles: los permisos se dan a un rol y a cada persona se le asignan roles, no permisos sueltos. UT4.
Realm (Proxmox) · Origen de los usuarios: pam (usuarios Linux del host), pve (usuarios propios), LDAP, AD. UT1.
Región (nube) · Conjunto de centros de datos de una zona geográfica, con catálogo de servicios y precios propios. Casi todos los recursos son regionales: mirar en la región equivocada es no ver nada. UT4.
Registry · Almacén de imágenes de contenedor. Docker Hub es uno público; en el laboratorio del curso se monta uno local. UT6.
Regla de grabación · Consulta PromQL que Prometheus ejecuta sola y cuyo resultado guarda como una serie nueva, para no repetir un cálculo caro en cada panel. Se nombra nivel:métrica:operación. UT7.
REST · Estilo de API que se llama por HTTP, con rutas como las de una web, y responde en JSON. La consola web de Proxmox y las CLI de la nube usan una API así por debajo. UT1, UT2, UT4.
RFC · Documento que fija un estándar de Internet. La RFC 1918 reserva los rangos privados (10.0.0.0/8, 172.16.0.0/12, 192.168.0.0/16) de los que sale el direccionamiento del laboratorio. UT2.
RST · Bandera TCP de reinicio. Es lo que responde un puerto cerrado y lo que devuelve una regla Reject, frente al silencio de un Drop. UT3.
Runner · Nombre del agente en GitLab CI, Gitea Actions y GitHub Actions. UT6.
Ruta blackhole · Ruta que descarta en silencio todo el tráfico hacia un bloque de direcciones. En el laboratorio impide que un entorno alcance a los otros (router-dev descarta 10.20.0.0/16 y 10.30.0.0/16). UT2.
S3 · Protocolo de almacenamiento de objetos de Amazon (buckets y objetos por HTTP) que MinIO también habla. El backend s3 guarda contra él el estado de OpenTofu, y restic las copias. UT4, UT5.
SaaS · Software como servicio (software as a service): la herramienta la aloja y la mantiene el proveedor y se usa por Internet, sin servidor propio. GitHub Actions o GitLab.com frente a un Jenkins autoalojado. UT6.
SAN · Subject Alternative Name: campo del certificado con los nombres y las IP para los que vale. Sin él los navegadores y los clientes modernos lo rechazan aunque la firma sea correcta. UT3, UT6.
Scrape · Lectura periódica que Prometheus hace de cada exporter. UT7.
SCSI, SATA e IDE · Buses de disco que Proxmox puede emular en una VM. El que se usa es VirtIO SCSI, paravirtualizado; un disco en IDE o SATA rinde muy por debajo. UT1.
SDK · Librería que hace desde un lenguaje de programación las mismas llamadas a la API que la CLI (boto3, azure-mgmt-*, google-cloud-*). Toma las credenciales de la cadena por defecto, nunca escritas en el código. UT4.
SDN (Proxmox) · Redes definidas por software: zonas, VNets y subredes que Proxmox gestiona desde el Datacenter. UT2.
Serie temporal · Una métrica con una combinación concreta de etiquetas y sus valores en el tiempo. UT7.
SLA · Acuerdo de nivel de servicio: el contrato con el cliente, con penalización si no se cumple. Siempre más laxo que el SLO interno. UT7.
SLI · Indicador de nivel de servicio: la medición concreta, normalmente una fracción de peticiones o de sondas correctas. UT7.
SLO · Objetivo de nivel de servicio: el valor que se asume para un SLI en una ventana de tiempo (99,5 % en 30 días). Lo que sobra hasta el 100 % es el presupuesto de error. UT7.
Snapshot · Foto del disco (y opcionalmente la memoria) de una VM en un instante. Permite volver atrás. No es una copia de seguridad. UT1.
SNAT · Traducción de la dirección de origen: el router cambia la IP de origen de los paquetes que salen para que las respuestas vuelvan a él. El masquerade es el SNAT que usa la IP de la interfaz de salida. UT2, UT3.
sops · Herramienta para cifrar ficheros de secretos (YAML, JSON, env) y guardarlos en el repositorio. UT5.
SSD (Solid State Drive) · Disco de estado sólido, sin partes móviles. Da muchas más operaciones por segundo que un disco mecánico, y por eso las medidas de disco de la UT1 dependen tanto del que tenga el puesto. UT1.
SSO (inicio de sesión único) · Entrar en la nube con la identidad corporativa y recibir credenciales temporales, en lugar de tener claves de larga duración. En AWS lo configura aws configure sso. UT4.
Stateful (cortafuegos) · Cortafuegos que recuerda las conexiones abiertas y deja pasar las respuestas sin regla adicional. UT3.
Subred pública / privada · Pública si tiene ruta directa a Internet; privada si solo sale por NAT o no sale. UT2.
SYN · Bandera del primer segmento TCP de una conexión. Un escaneo -sS envía solo ese SYN, y una inundación de SYN busca llenar la tabla de estados del cortafuegos. UT3.
TCG · Emulación pura de QEMU, sin ayuda de KVM: es a lo que cae una VM cuando falta la virtualización por hardware, de diez a veinte veces más lenta. UT1.
Terraform · Herramienta de aprovisionamiento declarativo de HashiCorp. Ver OpenTofu. UT5.
TLS · Protocolo de cifrado de las conexiones (el de https). Cada servidor presenta un certificado con su SAN, firmado por una CA en la que confía el cliente. UT3, UT6.
TOTP · Código de un solo uso basado en la hora que genera la app de autenticación del móvil; es el segundo factor más habitual. UT4.
Trivy · Escáner de vulnerabilidades y configuraciones inseguras: imágenes, ficheros de IaC, repositorios. UT5.
TSDB · Base de datos de series temporales: el almacén donde Prometheus guarda cada muestra con su marca de tiempo. Escribe bloques de dos horas y después los compacta. UT7.
Túnel SSH · Conexión SSH que lleva un puerto de una máquina remota hasta el puesto (ssh -L). En el curso es la forma de llegar a Prometheus, Alertmanager y Mailpit, que desde diciembre solo escuchan en 127.0.0.1 de mon01. UT7.
Umbral · Valor a partir del cual una métrica se considera anómala y dispara una alerta. UT7.
VE (Proxmox VE) · Virtual Environment, el nombre completo del producto: la distribución basada en Debian que trae el hipervisor, el SDN y la consola web del laboratorio. UT1.
virt-customize · Herramienta de libguestfs que instala paquetes dentro de una imagen de disco sin arrancarla. Con ella se meten el agente QEMU y node_exporter en la imagen de la plantilla. UT1.
Virtualización anidada · Ejecutar un hipervisor dentro de una VM. Lo que se hace en el laboratorio del curso para tener Proxmox en VirtualBox. UT1.
VLAN (802.1Q) · Etiqueta en las tramas Ethernet que separa redes lógicas sobre el mismo cable o bridge. UT1, UT2, UT3.
VM exit · Salida del modo invitado: cada vez que la VM hace algo que el hipervisor tiene que atender (un acceso a un dispositivo emulado, una interrupción), la CPU devuelve el control al host. Cuesta del orden de un microsegundo, y reducir su número es lo que hace rápido a virtio. UT1.
VNet (Proxmox SDN) · Red virtual dentro de una zona del SDN. Aparece como un bridge más al crear VM. UT2.
VPC · Nube privada virtual: red aislada definida por software dentro de una infraestructura compartida, con sus subredes, rutas y reglas. UT2.
VPN · Red privada virtual: túnel cifrado que une una máquina o una oficina con una red remota. En la nube es una de las formas de restringir el acceso de administración. UT2, UT3.
VXLAN · Encapsulación que transporta redes de capa 2 sobre IP; permite extender una red virtual entre varios nodos. UT2.
vzdump · Herramienta de copia de seguridad integrada en Proxmox: copia completa de una VM o de un contenedor, con su configuración, a otro almacén. Se restaura con qmrestore. UT1.
WAN · La interfaz exterior del cortafuegos, la que da a la red del aula y a Internet. En OPNsense es vtnet0, en vmbr0. UT3.
Webhook · Petición HTTP que un sistema (Gitea, GitLab) envía a otro (Jenkins) cuando pasa algo, por ejemplo un push. UT6.
ZFS · Sistema de ficheros y gestor de volúmenes con snapshots instantáneos, compresión, sumas de verificación de cada bloque y RAID por software. A cambio usa RAM para su caché (ARC). UT1.
Zona de disponibilidad (AZ) · Centro de datos independiente dentro de una región de nube. Una VPC abarca varias. UT2, UT4.
Zona (SDN de Proxmox) · Tipo de red virtual: simple, vlan, vxlan, evpn. UT2.
Para ampliar
Esta página recoge, unidad por unidad, lo que no cabe en las sesiones: los apartados que van más allá de lo que se hace en clase (no se explican ni los necesita ninguna hoja de práctica obligatoria, aunque alguno lo usa un paso de «Si te sobra tiempo», y son lo que aparece en el día a día de una empresa) y los enlaces para seguir por cuenta propia. Cada unidad enlaza desde su sitio el apartado de aquí que amplía lo que explica. Las unidades quedan así con lo que se da en cada sesión, y esto está aquí para ir más lejos y para situar lo que suene durante la formación en empresa. La única excepción es la UT7, cuya sección incluye además el programa y las evidencias de sus 12 horas en la empresa, porque esa parte no se da en el centro.
UT1 · Virtualización e hipervisores
Material que va más allá de lo que se hace en clase en la UT1: el clúster de Proxmox con migración en vivo, que no se monta en el laboratorio, el interior de KVM y QEMU, las copias con Proxmox Backup Server, los modos de bond, la fusión de páginas iguales entre VM y los enlaces de referencia de la unidad.
Clúster y migración en vivo
No se monta en el laboratorio (haría falta un segundo nodo con la misma red y, para que tenga sentido, almacenamiento compartido), pero es lo primero que aparece en una empresa y explica varias decisiones de diseño de esta unidad.
Varios nodos Proxmox se unen en un clúster (pvecm create, pvecm add) que comparte /etc/pve a través de corosync, un protocolo de mensajería con quórum: para que el clúster tome decisiones necesita mayoría de nodos (por eso los clústeres son de tres o cinco, no de dos; con dos, si cae uno el otro se queda sin quórum y no deja ni arrancar VM). Desde una sola consola web se administran todos los nodos.
La migración en vivo (qm migrate 101 pve2 --online) mueve una VM encendida de un nodo a otro sin que los usuarios lo noten: QEMU copia la RAM al destino mientras la VM sigue trabajando, va recopiando las páginas que se ensucian, y cuando queda poco por copiar pausa la VM unas decenas de milisegundos, transfiere el resto y el estado de la CPU, y la reanuda en el destino. Con almacenamiento compartido (NFS, Ceph, iSCSI) el disco no se mueve; con almacenamiento local Proxmox también puede copiarlo (--with-local-disks), pero tardará lo que tarde el disco. Aquí es donde el tipo de CPU importa: si la VM es host y los dos nodos tienen CPU distintas, la migración se rechaza o el invitado se rompe al llegar. Y sobre el clúster se monta la alta disponibilidad (HA): si un nodo muere, sus VM marcadas como HA se arrancan automáticamente en otro, cosa que también exige almacenamiento compartido y, en Proxmox, fencing por watchdog para asegurarse de que el nodo caído no siga escribiendo.
Toda la configuración del clúster vive en /etc/pve, que no es un directorio normal sino un sistema de ficheros en memoria (pmxcfs) replicado entre nodos y respaldado por una base de datos SQLite; por eso /etc/pve/qemu-server/101.conf aparece en todos los nodos de un clúster aunque la VM solo exista en uno.
Además de los puertos de uso diario (8006 para la web y la API, 22 para SSH y 5900 a 5999 para las consolas VNC), un Proxmox usa 3128 (proxy SPICE, un protocolo de consola remota), 5405 a 5412 UDP (corosync, la mensajería del clúster; solo en clúster) y 60000 a 60050 (migraciones).
Dentro de KVM y QEMU
Detalle de Cómo funciona KVM/QEMU por debajo, en la sesión 4. Nada de esto cambia una decisión de configuración, pero explica de dónde sale el coste de cada salida de la VM.
El modo invitado de la CPU. Se dice a menudo que el hipervisor corre en "ring -1": la CPU tiene un modo adicional (VMX root en Intel) en el que corre el kernel del host con KVM, y un modo invitado (VMX non-root) en el que corre la VM con sus propios anillos 0 a 3. El kernel del invitado cree que está en ring 0 y ejecuta instrucciones privilegiadas con normalidad; cuando hace algo que el hipervisor necesita controlar (tocar una tabla de páginas, acceder a un puerto de E/S, ejecutar cpuid, recibir una interrupción) la CPU sale del modo invitado, KVM atiende la petición y vuelve a entrar.
La memoria. La traducción de las direcciones del invitado a direcciones físicas se hace con tablas de páginas anidadas (EPT en Intel, NPT o RVI en AMD): la unidad de gestión de memoria de la CPU resuelve los dos niveles en hardware, sin intervención del hipervisor. Sin ellas, cada vez que el invitado tocara sus tablas de páginas habría una salida más.
La conversación entre QEMU y el kernel. QEMU abre /dev/kvm, crea la VM y sus vCPU mediante ioctl() (la llamada con la que un proceso da órdenes a un driver del kernel) y lanza un hilo por vCPU que se pasa la vida dentro de una llamada KVM_RUN. Mientras la VM ejecuta código corriente, ese hilo está bloqueado dentro del kernel y el proceso QEMU no consume nada. Cuando se produce una salida que KVM no resuelve solo, la llamada retorna, QEMU emula el dispositivo que corresponda y vuelve a entrar.
Hasta dónde llega la emulación. QEMU imita una tarjeta Intel e1000 con tal fidelidad que el driver original de Windows XP la reconoce y funciona sin instalar nada. Es un buen ejemplo de lo que se gana y de lo que se paga: compatibilidad con sistemas que nunca oyeron hablar de virtio, a cambio de que cada acceso del driver a un registro de esa tarjeta ficticia sea una salida de la VM y una vuelta a espacio de usuario.
Proxmox Backup Server
Detalle de Backups con vzdump y Proxmox Backup Server, en la sesión 4. En el laboratorio del curso no se monta.
El problema de vzdump a ficheros es que cada backup es completo: 20 VM de 20 GB con backup diario y retención de 14 días son 5,6 TB. Proxmox Backup Server (PBS) es un producto aparte, también libre, que resuelve eso: parte los discos en trozos de 4 MB, guarda cada trozo una sola vez (deduplicación entre backups y entre VM), aprovecha el mapa de bloques modificados que QEMU mantiene desde el último backup (dirty bitmap) para leer solo lo cambiado, y añade verificación de integridad, cifrado en el cliente, retención con reglas (keep-daily, keep-weekly...) y sincronización a un segundo PBS remoto.
flowchart LR
    VM["<b>VM 110</b>"]:::pieza
    VZ["<b>vzdump</b><br><small>modo snapshot</small>"]:::act
    FIC["<b>Fichero .vma.zst</b><br><small>copia completa, cada vez entera</small>"]:::dato
    COSTE["<b>20 VM × 20 GB × 14 días</b><br><small>≈ 5,6 TB</small>"]:::riesgo
    PBS["<b>Proxmox Backup Server</b><br><small>trozos de 4 MB</small>"]:::act
    DEDUP["<b>Cada trozo se guarda una vez</b><br><small>y solo se lee lo cambiado desde el último backup</small>"]:::ok
    VM --> VZ --> FIC --> COSTE
    VM --> PBS --> DEDUP
    classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
    classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
    classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
    classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
    classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
    classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5px
Los dos caminos hacen copias válidas. El de abajo es el que permite retención larga sin quedarse sin disco.
Bond: modos y configuración
Detalle de Modalidades de red, en la sesión 5. La VM de Proxmox del laboratorio tiene una sola tarjeta, así que en el curso no se monta un bond.
Varias tarjetas físicas agrupadas para redundancia o ancho de banda. Modos que se ven en producción: active-backup (no requiere nada en el switch; una tarjeta activa y otra en espera), 802.3ad o LACP (requiere configurar el agregado en el switch; reparte tráfico y suma ancho de banda entre conexiones distintas, nunca dentro de una misma) y balance-xor. El bond se crea como interfaz bond0 y es bond0, no las tarjetas, lo que se pone como puerto del bridge.
auto bond0
iface bond0 inet manual
    bond-slaves eno1 eno2
    bond-miimon 100
    bond-mode 802.3ad
    bond-xmit-hash-policy layer3+4

auto vmbr0
iface vmbr0 inet static
    address 192.168.1.50/24
    gateway 192.168.1.1
    bridge-ports bond0
    bridge-stp off
    bridge-fd 0
Fusión de páginas iguales
Detalle de Capacidades y limitaciones, en la sesión 5. En el laboratorio no se toca.
El kernel del host puede buscar páginas de memoria idénticas entre VM (mismo sistema operativo, mismas bibliotecas) y dejar una sola copia compartida; en Linux se llama KSM (fusión de páginas iguales del kernel). Ahorra memoria, pero consume CPU en el host y puede filtrar información entre VM por canales laterales, así que en entornos con clientes distintos sobre el mismo host se desactiva.
Enlaces
- Proxmox VE Administration Guide: la referencia completa; los capítulos de Qemu/KVM Virtual Machines, Network Configuration y Storage cubren toda esta unidad con más detalle.
- Wiki de Proxmox: Cloud-Init Support: cómo integra Proxmox el datasource NoCloud, opciones de
qm sety ejemplos de snippets concicustom. - Wiki de Proxmox: Package Repositories: los repositorios enterprise, no-subscription y test, y el formato en cada versión.
- Wiki de Proxmox: Nested Virtualization: activar la anidada en el host exterior y requisitos de la VM.
- Documentación de cloud-init: referencia de módulos, el datasource NoCloud, las etapas de arranque y la guía de depuración.
- Imágenes cloud de Debian: variantes
generic,genericcloudynocloudy qué incluye cada una. - Documentación de KVM en el kernel: la API de
/dev/kvmque usa QEMU; para entender qué es un VM exit de verdad. - Documentación de QEMU: dispositivos emulados, formato qcow2 y
qemu-img. - Especificación virtio (OASIS): cómo funcionan las virtqueues; con leer la introducción se entiende por qué virtio gana a la emulación.
- Proxmox Backup Server: documentación: deduplicación, backups incrementales y retención, para cuando el laboratorio se convierta en algo que hay que proteger.
- man 1 fio y stress-ng: los parámetros de las herramientas de medida que se usan en la práctica.
UT2 · Nubes privadas virtuales (VPC)
Apartados y enlaces que van más allá de lo que se hace en clase en la unidad de nubes privadas virtuales, UT2: las zonas de disponibilidad y la comparación completa entre VLAN y VXLAN.
Zonas de disponibilidad
En nube, una región (eu-west-1, westeurope) tiene dos o tres zonas de disponibilidad: centros de datos físicamente separados, con alimentación y red independientes, unidos por fibra de baja latencia. La VPC abarca toda la región, pero cada subred vive en una zona concreta. Una aplicación que quiera sobrevivir a la caída de un edificio tiene que tener instancias en al menos dos subredes de zonas distintas, y un balanceador delante que reparta. Los proveedores lo cobran: el tráfico entre zonas se factura y los servicios gestionados "multi-AZ" cuestan más.
En el aula la zona de disponibilidad es el nodo Proxmox: si un nodo se apaga, caen sus VM y no las del otro. Quien tenga acceso a dos nodos en clúster lo simula con una zona VXLAN (para que la VNet exista en ambos) y una VM de cada capa en cada nodo. Quien tenga un solo nodo lo simula lógicamente: dos subredes por capa (front-a en 10.10.1.0/24, front-b en 10.10.11.0/24), una VM de la aplicación en cada una, y demuestra que apagar web01 en front-a no tira el servicio porque web02 en front-b sigue respondiendo. No es lo mismo (comparten el hardware), pero el diseño de red y el despliegue de la aplicación son exactamente los que se harían en nube, y eso es lo que se evalúa.
VLAN frente a VXLAN
Comparación completa de los dos tipos de zona que se usan fuera del laboratorio; en la sesión 8, VLAN 802.1Q frente a VXLAN se queda con la consecuencia práctica, la MTU.
Una VLAN añade 4 bytes a la trama Ethernet con un identificador de 12 bits: 4094 redes posibles. Es un estándar de capa 2 que entienden todos los switches gestionables, es barato de procesar y se depura con tcpdump -e viendo el tag. Su limitación es que la VLAN tiene que existir en cada switch por el que pasa el tráfico, así que depende de que el equipo de redes la configure, y no cruza un router (por definición de capa 2).
VXLAN (RFC 7348) mete la trama Ethernet completa dentro de un paquete UDP/IP con un identificador de 24 bits (16 millones de redes). Como es IP, atraviesa routers y no necesita que el switch sepa nada: solo que los nodos Proxmox se alcancen entre sí por el puerto 4789. El precio son 50 bytes de cabecera extra, lo que obliga a bajar la MTU (el tamaño máximo de paquete que admite una interfaz) de las VM a 1450 si la red física va a 1500, o subir la física a 1550 o más, que es lo correcto si se puede.
flowchart TB
    subgraph V1["VLAN 802.1Q · capa 2"]
        direction LR
        T1["<b>Trama Ethernet</b>"]:::dato
        TAG["<b>+ 4 bytes de tag</b><br><small>12 bits · 4094 redes</small>"]:::pieza
        SW["<b>Cada switch del camino</b><br><small>tiene que conocer la VLAN · no cruza un router</small>"]:::infra
        T1 --> TAG --> SW
    end
    subgraph V2["VXLAN · capa 2 dentro de capa 3"]
        direction LR
        T2["<b>Trama Ethernet entera</b>"]:::dato
        ENC["<b>dentro de UDP/IP</b><br><small>24 bits · 16 millones de redes · puerto 4789</small>"]:::pieza
        IP["<b>Atraviesa routers</b><br><small>al switch no hay que decirle nada</small>"]:::ok
        MTU["<b>50 bytes de cabecera</b><br><small>MTU de la VM a 1450</small>"]:::riesgo
        T2 --> ENC --> IP
        ENC --> MTU
    end
    V1 ~~~ V2
    classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
    classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
    classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
    classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
    classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
    classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5px
La VLAN es más barata de procesar pero depende del equipo de redes. VXLAN no depende de nadie y se paga en cabecera.
Enlaces
- Proxmox VE Administration Guide, capítulo SDN: la referencia de zonas, VNets, subnets, IPAM y DHCP integrado; conviene leer la parte de "Simple zone" y "DHCP" antes de la sesión 8.
- Proxmox VE API Viewer: todas las rutas de la API con sus parámetros; es lo que
pvesh usagemuestra, pero navegable. - Proxmox wiki: Proxmox VE API: autenticación con tickets y con tokens, y ejemplos con curl.
- RFC 1918, Address Allocation for Private Internets: cuatro páginas; explica por qué existen los rangos privados y qué obligaciones tiene quien los usa.
- RFC 4632, CIDR: la especificación del direccionamiento sin clases, por si interesa entender de dónde sale la notación /n.
- RFC 7348, VXLAN: el formato de encapsulación y el porqué de los 50 bytes de cabecera.
- Página de manual de dnsmasq: larga pero es la fuente; los apartados que interesan son
dhcp-range,dhcp-host,expand-hostsylocal. - nftables wiki: Performing Network Address Translation: masquerade, SNAT y DNAT con ejemplos que se usan tal cual en la UT3.
- cloud-init, Network configuration: cómo cloud-init traduce el
--ipconfig0de Proxmox a la configuración de red de la VM. - tcpdump(8) en man7.org y pcap-filter(7): la sintaxis de los filtros (
port,host,net,and,not).
UT3 · Seguridad por capas: DMZ externa, DMZ interna y zona interna
Apartados que en clase solo se mencionan y la lista de enlaces de la UT3, la unidad del cortafuegos por zonas, el proxy inverso y la separación de clientes: las dos capas de inspección que hay por encima del cortafuegos, qué ataque frena cada zona, el interior de la tabla de estados, el cortafuegos entero escrito en nftables y Caddy como proxy alternativo a nginx.
IDS/IPS y WAF, dos capas más
El cortafuegos decide por puertos y direcciones. No sabe si lo que entra por el 443 es una petición legítima o un intento de explotación. Para eso hay dos capas adicionales que en el módulo solo se mencionan: OPNsense integra Suricata como IDS/IPS (Services → Intrusion Detection), que inspecciona el contenido de los paquetes contra reglas de firmas (ET Open, gratuitas) y puede alertar o bloquear. En la interfaz WAN de un laboratorio con tráfico cifrado ve poco; tiene más sentido en la DMZ externa, después del proxy, donde el tráfico ya va en claro. Y en el propio proxy inverso se puede añadir un WAF (Web Application Firewall) como ModSecurity o su reimplementación en Go, Coraza, con el conjunto de reglas OWASP CRS (Core Rule Set, la lista de patrones de ataque que mantiene la fundación OWASP), que bloquea patrones de inyección SQL, XSS (inyección de scripts en páginas web) y similares antes de que lleguen a la aplicación. Ambos generan falsos positivos; conviene no ponerlos en modo bloqueo el primer día.
Qué frena cada capa
Ampliación de Defensa en profundidad y zonas, en la sesión 14.
Para que el modelo no se quede en una tabla bonita, conviene saber qué ataque concreto para cada zona. Un escaneo de puertos desde Internet contra la IP pública solo ve el 443 del proxy; los puertos 28080 de la aplicación y 5432 de PostgreSQL ni siquiera aparecen como cerrados, aparecen como filtrados, que es distinto y se explica con nmap en las pruebas de seguridad de la sesión 18. Si un atacante explota una vulnerabilidad del proxy y consigue ejecutar código en él, se encuentra en la DMZ externa: puede llegar al 28080 de app01 porque es lo que el proxy necesita, pero no puede abrir una sesión a la base de datos, ni hacer SSH a nada, ni salir a Internet a descargarse herramientas si la regla de salida de la DMZ externa está cerrada. Si además compromete la aplicación (inyección SQL, deserialización, dependencia vulnerable), llega a la base de datos, pero con el usuario de aplicación, que no puede hacer COPY ... TO PROGRAM (una orden de PostgreSQL que ejecuta programas en el servidor) ni leer otras bases. Para llegar a la zona de gestión no hay ningún camino permitido desde ninguna zona de servicio, así que tendría que atacar el propio cortafuegos. Cada uno de esos saltos deja intentos denegados en el log, que es justo lo que un sistema de detección busca.
La tabla de estados por dentro
Ampliación de Cortafuegos con estado, en la sesión 14.
La tabla de estados tiene tamaño finito. En Debian sysctl net.netfilter.nf_conntrack_max suele valer 65536 o más según la RAM; en OPNsense el límite está en Firewall → Settings → Advanced (Firewall Maximum States). Un ataque de inundación de SYN busca precisamente llenarla; cuando se llena, el cortafuegos descarta conexiones nuevas legítimas y en el log aparece nf_conntrack: table full, dropping packet. Los tiempos de expiración también se configuran: una conexión TCP establecida sin tráfico vive por defecto 5 días en conntrack de Linux, y por eso una sesión SSH aguanta horas abierta sin que el cortafuegos la olvide.
nftables: el fichero de reglas completo
El curso monta el cortafuegos con OPNsense; esto es la alternativa entera con un router Debian, para quien la prefiera o quiera entender el motor que hay debajo del firewall de Proxmox y de Docker. La unidad la presenta y dice cuándo se elige en Alternativa: nftables en una VM Linux, y el "Antes de empezar" de la A3.1 enlaza aquí.
Tablas, cadenas, hooks y prioridades
Un ruleset de nftables se organiza en tablas, que son contenedores con una familia de direcciones: ip (IPv4), ip6, inet (las dos a la vez, la más habitual), arp, bridge y netdev. Dentro de una tabla hay cadenas, y las cadenas contienen reglas. Hay dos tipos de cadena: las base, que se enganchan a un hook del kernel y por las que pasa el tráfico automáticamente, y las regulares, a las que solo se llega con jump o goto desde otra cadena.
Los hooks son los puntos del recorrido de un paquete por la pila de red donde netfilter puede intervenir:
flowchart TB
    IN["<b>Paquete entra</b>"]:::dato
    PRE["<b>prerouting</b>"]:::pieza
    DEC{"<b>¿Para esta máquina?</b>"}:::act
    INP["<b>input</b>"]:::pieza
    PROC["<b>Proceso local</b>"]:::dato
    FWD["<b>forward</b>"]:::pieza
    OUT["<b>output</b>"]:::pieza
    POST["<b>postrouting</b>"]:::pieza
    SAL["<b>Paquete sale</b>"]:::dato
    IN --> PRE --> DEC
    DEC -->|sí| INP --> PROC --> OUT --> POST
    DEC -->|no| FWD --> POST
    POST --> SAL
    classDef act fill:#ea580c22,stroke:#ea580c,stroke-width:1.5px
    classDef pieza fill:#64748b22,stroke:#64748b,stroke-width:1.5px
    classDef dato fill:#2563eb22,stroke:#2563eb,stroke-width:1.5px
    classDef infra fill:#a1a1aa14,stroke:#a1a1aa,stroke-width:1.5px
    classDef ok fill:#16a34a22,stroke:#16a34a,stroke-width:1.5px
    classDef riesgo fill:#dc262622,stroke:#dc2626,stroke-width:1.5px
Saber por qué hook pasa un paquete es lo que decide en qué cadena va la regla. El tráfico que atraviesa la máquina nunca toca input.
Para un router entre zonas casi todo ocurre en forward: el tráfico que va de una zona a otra no es para el cortafuegos, así que nunca pasa por input ni output. input protege a la propia máquina (quién puede hacerle SSH o abrir su web) y prerouting/postrouting son donde se hace el NAT (DNAT en prerouting, antes de decidir la ruta; SNAT en postrouting, después).
La prioridad ordena las cadenas base que comparten hook: se evalúan de menor a mayor número. Hay nombres predefinidos: raw (-300), mangle (-150), dstnat (-100), filter (0), security (50), srcnat (100). Lo importante es que el DNAT (-100) va antes que el filtro (0) en prerouting, y por eso en la cadena forward se filtra con la dirección de destino ya traducida, igual que en pf. La política de una cadena base (policy drop o policy accept) es lo que ocurre si ninguna regla coincide; en forward e input se pone en drop.
El fichero completo y persistente
Este es el fichero /etc/nftables.conf para el laboratorio, con nombres de interfaz ya renombrados con systemd-networkd o udev (los dos mecanismos de Debian para dar nombre fijo a una interfaz) para que se llamen como las zonas (si no, se usan ens18, ens19… o mejor, se definen variables). Tiene tres partes: las variables con redes y servidores, la tabla fw con las cadenas input (quién llega al propio router) y forward (qué cruza entre zonas), y la tabla nat. Conviene fijarse en que las dos cadenas de filtro empiezan igual, con established,related e invalid, y terminan con un log seguido de drop; entre medias solo están los saltos permitidos, uno por línea:
#!/usr/sbin/nft -f
flush ruleset

define net_dmzext = 10.10.1.0/24
define net_dmzint = 10.10.2.0/24
define net_int    = 10.10.3.0/24
define net_mgmt   = 10.10.0.0/24
define srv_web    = 10.10.1.10
define srv_app    = 10.10.2.10
define srv_db     = 10.10.3.10

table inet fw {

    chain input {
        type filter hook input priority filter; policy drop;
        ct state established,related accept
        ct state invalid drop
        iifname "lo" accept
        icmp type { echo-request, destination-unreachable, time-exceeded } accept
        iifname "mgmt" ip saddr $net_mgmt tcp dport { 22, 443 } accept
        log prefix "FW-INPUT-DROP " drop
    }

    chain forward {
        type filter hook forward priority filter; policy drop;
        ct state established,related accept
        ct state invalid drop

        # Publicación: Internet -> proxy (destino ya traducido por el DNAT)
        iifname "wan" oifname "dmzext" ip daddr $srv_web tcp dport { 80, 443 } accept

        # Capas: proxy -> app -> db
        iifname "dmzext" oifname "dmzint" ip saddr $srv_web ip daddr $srv_app tcp dport 28080 accept
        iifname "dmzint" oifname "int"    ip saddr $srv_app ip daddr $srv_db  tcp dport 5432 accept

        # Gestión llega a todo por SSH
        iifname "mgmt" ip saddr $net_mgmt tcp dport 22 accept

        # Diagnóstico: ping desde gestión
        iifname "mgmt" icmp type echo-request accept

        log prefix "FW-FWD-DROP " drop
    }

    chain output {
        type filter hook output priority filter; policy accept;
    }
}

table ip nat {
    chain prerouting {
        type nat hook prerouting priority dstnat; policy accept;
        iifname "wan" tcp dport { 80, 443 } dnat to $srv_web
    }
    chain postrouting {
        type nat hook postrouting priority srcnat; policy accept;
        oifname "wan" ip saddr $net_dmzext masquerade
    }
}
El masquerade solo cubre la DMZ externa: la DMZ interna y la zona interna no tienen salida a Internet. Si app01 necesita instalar paquetes, se abre una regla temporal y fechada hacia 80/443, igual que la fila temporal de la matriz de OPNsense del curso, y se quita en cuanto termina la instalación.
Para probarlo sin cargarlo, nft -c -f /etc/nftables.conf valida la sintaxis. Se carga con nft -f /etc/nftables.conf y se persiste activando el servicio: systemctl enable --now nftables, que en Debian lee exactamente ese fichero en cada arranque. Antes de todo hay que activar el reenvío en el kernel, net.ipv4.ip_forward=1 en /etc/sysctl.d/99-router.conf, porque sin eso el router descarta todo lo que no es para él aunque nftables lo permita. nft list ruleset muestra lo cargado, y nft list ruleset -a añade los handles de cada regla para poder borrar una concreta. Los logs salen por el kernel, journalctl -k -f | grep FW-, o a un fichero propio si se configura rsyslog (el servicio de logs de Debian) con un filtro por prefijo.
Orden de las reglas y bloqueo remoto
Si el router Debian se administra por SSH desde MGMT y se carga un ruleset con policy drop en input
sin la regla que permite ese SSH, se pierde el acceso en el acto (la sesión en curso sobrevive gracias a
established, pero la siguiente no entra). Conviene dejar preparado un at now + 5 min (una orden
programada que se ejecuta pasado ese tiempo) que restaure el fichero anterior, o trabajar desde la
consola de Proxmox.
Caddy: el mismo proxy en cuatro líneas
Ampliación de El proxy inverso, en la sesión 16.
Las alternativas habituales en empresas son Traefik y Caddy. Traefik descubre los backends solo: se conecta al socket de Docker o a la API de Kubernetes y crea las rutas a partir de etiquetas de los contenedores, y no compensa editar nginx a mano cada vez que un pipeline despliega contenedores. Caddy destaca porque obtiene y renueva certificados de Let's Encrypt automáticamente sin configurar nada, y su fichero de configuración para lo mismo que el nginx de la unidad son cuatro líneas:
Para aprender, nginx es el mejor de los tres porque obliga a entender cada cabecera; para producción con contenedores, Traefik; y para un servicio pequeño sin pensar en certificados, Caddy.
Enlaces
- Documentación de OPNsense: Firewall: reglas, orden de evaluación, quick, flotantes y grupos, con capturas de cada campo.
- Documentación de OPNsense: Aliases: tipos de alias, incluidas las tablas URL y los aliases GeoIP.
- Documentación de OPNsense: NAT: port forward, outbound, one-to-one y NPT, con el detalle de la regla de filtro asociada.
- Documentación de OPNsense: Intrusion Prevention System: Suricata integrado, conjuntos de reglas y modo IPS.
- Wiki de nftables: la referencia del proyecto; lo primero que conviene leer es "Quick reference" y "Netfilter hooks".
- nft(8) en man7.org: sintaxis completa, familias, tipos de cadena y expresiones de conntrack.
- Nmap Reference Guide: Port Scanning Basics: la definición exacta de open, closed, filtered y los estados combinados.
- nginx: módulo ngx_http_proxy_module: todas las directivas proxy_*, incluidas las de cabeceras y buffers.
- Documentación de Traefik: descubrimiento de servicios por etiquetas Docker; se cita como alternativa a nginx en la UT3 y la UT6.
- Let's Encrypt: cómo funciona: retos HTTP-01 y DNS-01, límites de emisión y clientes ACME.
- step-ca de Smallstep: CA interna con ACME para automatizar certificados en zonas que no ven Internet.
- Proxmox VE: Network Configuration: bridges VLAN aware, tags por VM y trunks.
UT4 · Nube pública: consola, CLI y SDK
Material que va más allá de lo que se hace en la empresa en la unidad UT4: el modelo de responsabilidad compartida, que explica qué deja de ser responsabilidad propia al pasar de Proxmox a la nube, el nivel gratuito de las cuentas nuevas, la cadena de credenciales completa de los tres proveedores, los perfiles que asumen un rol y los enlaces de ampliación.
El modelo de responsabilidad compartida
Los tres grandes lo llaman modelo de responsabilidad compartida y lo resumen igual: el proveedor es responsable de la seguridad de la nube (centros de datos, hardware, hipervisor, red física, los servicios gestionados por dentro) y el cliente es responsable de la seguridad en la nube (sistema operativo de sus VM, parches, configuración de red, cortafuegos, identidades, cifrado de sus datos, y sobre todo qué expone a Internet).
En Proxmox todo quedaba del lado del administrador: si el hipervisor se quedaba sin parchear, el problema era suyo. En la nube el hipervisor deja de serlo, pero el grupo de seguridad con 0.0.0.0/0 al puerto 22 sigue siéndolo, y también lo es la clave de acceso que alguien subió a un repositorio público. La línea se desplaza según el servicio: en una VM (EC2, Azure VM, Compute Engine) se administra el sistema operativo; en un contenedor gestionado sin servidor (Fargate, Container Apps, Cloud Run) solo se administra la imagen y su configuración; en una base de datos gestionada ni siquiera se ve el sistema operativo. Cuanto más gestionado, menos responsabilidad operativa y menos control.
El nivel gratuito de las cuentas nuevas
Lo que sigue amplía Free tier, presupuestos y alertas y vale para una cuenta personal recién abierta, no para la cuenta de pago de la empresa, que es la que se usa durante la formación y en la que todo cuesta desde el primer minuto. Azure da un crédito inicial durante el primer mes y un año de ciertos servicios en cantidades limitadas. Google Cloud da un crédito durante 90 días y un nivel "siempre gratis" (una e2-micro en regiones de Estados Unidos, 5 GB de Cloud Storage). AWS cambió en 2025 a un modelo de créditos para cuentas nuevas que caducan a los seis meses, más un conjunto de servicios siempre gratis (1 millón de invocaciones de Lambda al mes, 25 GB de DynamoDB). Las condiciones cambian de un año para otro, así que la única fuente fiable es la página de precios del proveedor el día en que se abre la cuenta.
La cadena de credenciales, escalón a escalón
En la unidad, La cadena de credenciales por defecto basta con saber que en el portátil la cadena se resuelve con la sesión de la CLI. Cada SDK tiene su propia lista completa, y el orden importa cuando el mismo script se ejecuta en sitios distintos.
En AWS, boto3 prueba en este orden: parámetros escritos en el código, variables de entorno, ~/.aws/credentials y ~/.aws/config (incluidos SSO y role_arn), credenciales de contenedor (las que inyecta ECS) y, por último, el servicio de metadatos de la instancia, en la dirección 169.254.169.254.
En Azure, DefaultAzureCredential prueba variables de entorno (las de un service principal), workload identity (la identidad de un pod de Kubernetes), managed identity (la identidad de la propia VM o del servicio) y, después, las credenciales de las herramientas de desarrollo: az login, Azure Developer CLI y PowerShell.
En Google Cloud, las Application Default Credentials miran GOOGLE_APPLICATION_CREDENTIALS (la ruta a un fichero JSON), luego ~/.config/gcloud/application_default_credentials.json y luego el servidor de metadatos.
Conocer el orden es lo que permite escribir un script sin ninguna credencial dentro que funcione igual en el portátil, en una VM de la nube y en un pipeline, y es también lo que explica que una variable de entorno olvidada mande sobre el perfil que se creía estar usando.
Asumir un rol desde otro perfil
Amplía Perfiles y ficheros de configuración: además de los perfiles empresa-dev y empresa-pre que se crean con SSO en la A4.4, ~/.aws/config admite un tercer tipo de perfil.
[profile empresa-admin]
role_arn = arn:aws:iam::123456789012:role/Admin
source_profile = empresa-dev
El tercer perfil muestra otro mecanismo: role_arn con source_profile hace que la CLI asuma un rol automáticamente usando las credenciales de otro perfil. Es la forma habitual de saltar entre cuentas.
Enlaces
- https://aws.amazon.com/compliance/shared-responsibility-model/: el modelo de responsabilidad compartida explicado por AWS, con el diagrama que todo el mundo copia.
- https://docs.aws.amazon.com/cli/latest/userguide/cli-configure-files.html: formato de
~/.aws/configy~/.aws/credentials, perfiles,sso-sessionyrole_arn. - https://docs.aws.amazon.com/cli/latest/userguide/cli-usage-output-format.html: formatos de salida y
--querycon JMESPath, con ejemplos que vale la pena copiar. - https://jmespath.org/tutorial.html: el tutorial oficial de JMESPath, que sirve igual para
aws --queryyaz --query. - https://docs.aws.amazon.com/IAM/latest/UserGuide/reference_policies_elements.html: referencia de los elementos de una política IAM (Effect, Action, Resource, Condition).
- https://boto3.amazonaws.com/v1/documentation/api/latest/guide/credentials.html: la cadena de credenciales de boto3, en el orden exacto en que se evalúa.
- https://learn.microsoft.com/cli/azure/azure-cli-configuration:
az config, ficheros de~/.azurey variables de entorno de la Azure CLI. - https://learn.microsoft.com/azure/role-based-access-control/overview: cómo funcionan las asignaciones de rol, los ámbitos y la herencia en Azure RBAC.
- https://learn.microsoft.com/python/api/overview/azure/identity-readme:
DefaultAzureCredentialy el orden en que prueba cada fuente. - https://cloud.google.com/sdk/gcloud/reference/config/configurations: referencia de las configurations de
gcloud. - https://cloud.google.com/docs/authentication/application-default-credentials: cómo buscan credenciales las librerías de Google (ADC) y por qué hay dos logins.
- https://github.com/gitleaks/gitleaks: instalación y uso de gitleaks, incluido el hook de pre-commit.
UT5 · Infraestructura como código
Cómo se llegó a la bifurcación de Terraform, detalles del estado, del inventario, de las pruebas y de los secretos que la unidad solo menciona, y enlaces de referencia de la UT5: documentación de OpenTofu, del provider de Proxmox, de Ansible y de los escáneres. Todo lo que se explica en clase y lo que necesitan las hojas de práctica sigue en la unidad; aquí solo está lo que va más allá.
Del cambio de licencia de Terraform a OpenTofu
Terraform nació en 2014 con licencia MPL 2.0, libre. En agosto de 2023 HashiCorp cambió la licencia de todos sus productos a la Business Source License 1.1, que prohíbe usar el código para ofrecer un producto que compita con HashiCorp. Para un usuario final no cambiaba nada, pero para las empresas que habían construido productos sobre Terraform (Spacelift, env0, Scalr, Gruntwork y otras) era un problema serio. En semanas publicaron el manifiesto OpenTF, bifurcaron la última versión con licencia MPL y en septiembre de 2023 el proyecto entró en la Linux Foundation con el nombre OpenTofu.
La 1.6 salió en enero de 2024 y desde entonces OpenTofu evoluciona por su cuenta: cifrado del estado, evaluación temprana de variables en backend y en el source de los módulos, for_each en providers y la opción -exclude en plan y apply. En 2025 IBM completó la compra de HashiCorp, lo que no cambió la licencia de Terraform. Para lo que se hace en clase la consecuencia sigue siendo la misma: el lenguaje, los providers y los ficheros son los mismos en las dos herramientas.
El estado cifrado y otros backends
Ampliación de Backend remoto: s3 contra MinIO, en la sesión 24.
use_lockfile = true implementa el bloqueo con un fichero .tflock junto al estado mediante escrituras condicionales de S3, sin necesidad de DynamoDB (la tabla de AWS que Terraform usaba para el bloqueo). Gitea ofrece además un backend http con bloqueo en su registro de paquetes: es la salida cuando no hay almacén S3 a mano, pero el laboratorio del curso usa el backend s3 contra MinIO, que es el que se encuentra en producción.
OpenTofu añade algo que Terraform no tiene: cifrado del estado en cliente, con un bloque encryption dentro de terraform {} y una clave derivada de una passphrase o de un servicio de gestión de claves. Con eso, lo que llega a MinIO ya va cifrado. Documentado en https://opentofu.org/docs/language/state/encryption/.
Importar con el bloque import
Ampliación de Manipular el estado, en la sesión 24.
Además de la orden tofu import, existe el bloque import { to = ..., id = ... } con la opción -generate-config-out=, que escribe el HCL automáticamente.
Inventario en YAML
Ampliación de Inventario, en la sesión 25.
El mismo inventario en YAML, que es el que ansible-lint (el revisor de estilo de Ansible, que se usa en la A5.5) prefiere:
all:
  vars:
    ansible_user: ops
  children:
    web: { hosts: { web01: { ansible_host: 10.20.1.10 } } }
    app: { hosts: { app01: { ansible_host: 10.20.2.10 } } }
    db:  { hosts: { db01:  { ansible_host: 10.20.3.10 } } }
ansible-inventory -i inventory.yml --graph dibuja los grupos y sirve para comprobar que la agrupación es la correcta.
tofu test y Molecule
Ampliación de Pruebas del despliegue, en la sesión 26.
tofu test ejecuta ficheros tests/*.tftest.hcl con bloques run que hacen un plan o un apply del módulo con variables de prueba y comprueban asserts:
mock_provider "proxmox" {}   # un provider simulado: la prueba no habla con Proxmox

run "memoria_minima" {
  command = plan
  variables { name = "t", vmid = 150, cores = 1, memory = 2048, disk = 20, bridge = "prefront", ip = "10.20.1.200/24" }
  assert {
    condition     = proxmox_virtual_environment_vm.this.memory[0].dedicated == 2048
    error_message = "La memoria no se ha propagado al recurso"
  }
}
Con command = plan no crea nada y sirve para probar módulos en CI sin Proxmox. Molecule hace lo mismo para roles de Ansible: levanta un contenedor o una VM, aplica el rol dos veces y ejecuta verificaciones. En la práctica evaluable no se piden.
sops, age y Vault en la práctica
Ampliación de Gestión de secretos, en la sesión 28.
- sops con age (age es un cifrador de ficheros con par de claves, como SSH; sops es el editor que lo aplica campo a campo): cifra ficheros YAML o JSON campo a campo, de modo que las claves siguen legibles y solo los valores van cifrados. El fichero cifrado se sube a Git y se descifra con la clave privada de cada persona autorizada.
age-keygen -o ~/.config/sops/age/keys.txt, un.sops.yamlen el repositorio con las claves públicas del equipo,sops -e secrets.yaml > secrets.enc.yamlysops -dpara leer. Terraform lo lee con el providercarlpett/sops(data "sops_file"), Ansible con la coleccióncommunity.sops. Es la opción habitual en equipos pequeños: el secreto viaja versionado con el código y no hace falta ningún servidor, a cambio de mantener a mano las claves públicas del equipo. - HashiCorp Vault (u OpenBao, su bifurcación libre por la misma razón que OpenTofu): un servidor de secretos con autenticación, políticas, rotación y auditoría. Terraform los lee con el provider
vaulty Ansible concommunity.hashi_vault. Es lo habitual en empresas grandes; montarlo bien es un proyecto en sí.
Enlaces
- https://opentofu.org/docs/language/ : referencia del lenguaje HCL (bloques, tipos, funciones, expresiones). Es la que hay que tener abierta mientras se escribe.
- https://opentofu.org/docs/cli/commands/state/ : todos los subcomandos de
tofu state, con los avisos sobre cuándo no usarlos. - https://opentofu.org/manifesto/ : el manifiesto OpenTF, para entender por qué existe el fork y qué se comprometieron a mantener.
- https://registry.opentofu.org/providers/bpg/proxmox/latest/docs : documentación del provider bpg/proxmox, recurso por recurso y por versión. La única fuente fiable para la sintaxis del bloque VM.
- https://pve.proxmox.com/wiki/User_Management : usuarios, roles, tokens y ACL de Proxmox; lo necesario para dar al token
terraform@pve!tofulos permisos justos. - https://docs.ansible.com/ansible/latest/playbook_guide/index.html : guía de playbooks, incluidas variables, precedencia, handlers y roles.
- https://docs.ansible.com/ansible/latest/collections/community/docker/docker_compose_v2_module.html : parámetros del módulo que despliega el compose del servicio.
- https://ansible.readthedocs.io/projects/lint/ : reglas de ansible-lint y perfiles; explica cada regla y cómo suprimirla.
- https://www.checkov.io/ y https://trivy.dev/ : documentación de los dos escáneres, con el catálogo de reglas y la sintaxis de supresión.
- https://github.com/gitleaks/gitleaks y https://github.com/getsops/sops : detección de secretos y cifrado de ficheros con age; los README son suficientes para empezar.
- https://cloudinit.readthedocs.io/ : lo que hace cloud-init en el primer arranque, para entender qué configura el bloque
initializationy qué hacer cuando no aplica.
UT6 · Orquestador de integración continua
Apartados que van más allá de lo que se hace en clase y enlaces para ampliar de la UT6: el mismo pipeline traducido a GitLab CI, las equivalencias de sintaxis entre los cuatro orquestadores, la variante en la que Jenkins sirve HTTPS por su cuenta, la operación de Jenkins en una empresa y la directiva matrix.
El mismo pipeline en GitLab CI
Para comprobar que lo aprendido se traslada, este es el equivalente del Jenkinsfile en .gitlab-ci.yml. Las diferencias de modelo: no hay agent, hay tags que eligen runner e image que elige contenedor; no hay parameters, hay variables que se rellenan al lanzar a mano o que se fijan con rules; el when es rules; el stash no hace falta porque cada job clona el repositorio; y los informes JUnit se publican con artifacts:reports.
# .gitlab-ci.yml
stages: [test, package, deploy]

variables:
  REGISTRY: registry.lab:5000
  IMAGE: $CI_REGISTRY_IMAGE       # o $REGISTRY/app si el registry no es el de GitLab
  DEPLOY_ENV:
    value: "pre"
    options: ["pre"]
    description: "Entorno de despliegue"

default:
  tags: [docker]                  # runner con ejecutor docker
  interruptible: true

test:
  stage: test
  image: python:3.12
  script:
    - pip install -r requirements.txt
    - pytest --junitxml=report.xml
  artifacts:
    when: always
    reports:
      junit: report.xml

package:
  stage: package
  image: docker:27
  services: [docker:27-dind]
  rules:
    - if: $CI_COMMIT_BRANCH == "main"
  script:
    - echo "$REGISTRY_PASSWORD" | docker login -u "$REGISTRY_USER" --password-stdin $REGISTRY
    - docker build -t $REGISTRY/app:$CI_COMMIT_SHORT_SHA -t $REGISTRY/app:latest api
    - docker push --all-tags $REGISTRY/app

deploy:
  stage: deploy
  tags: [deploy]                  # runner con ejecutor shell en la máquina de despliegue
  rules:
    - if: $CI_COMMIT_BRANCH == "main"
      when: manual                # equivale a RUN_DEPLOY: alguien pulsa
  environment:
    name: $DEPLOY_ENV
  resource_group: $DEPLOY_ENV     # equivale a disableConcurrentBuilds por entorno
  timeout: 30m
  script:
    - docker save $REGISTRY/app:$CI_COMMIT_SHORT_SHA | ssh ops@10.20.2.10 sudo docker load
    - ansible-playbook -i ansible/inventory.ini ansible/site.yml
    - SOLO_PRUEBAS=1 ./test.sh $DEPLOY_ENV
REGISTRY_USER, REGISTRY_PASSWORD y la clave SSH de despliegue no van en el fichero: se crean en Settings → CI/CD → Variables marcadas como Masked (se ocultan en el log) y Protected (solo se inyectan en ramas y etiquetas protegidas, así una rama de un desarrollador no puede leer la clave que entra en pre). Es el equivalente de las credenciales por carpeta de Jenkins. El after_script con limpieza y la notificación por fallo se hacen con integraciones del proyecto (Settings → Integrations) en vez de con un post.
Equivalencias entre los cuatro orquestadores
Detalle de sintaxis y de funcionamiento interno de los cuatro orquestadores que se comparan en Elegir el orquestador. No hace falta para elegir uno, pero sirve para reconocer un repositorio ajeno o para traducir un pipeline de una herramienta a otra.
| Jenkins | GitLab CI | GitHub Actions | Gitea Actions | |
|---|---|---|---|---|
| Definición | Jenkinsfile (Groovy declarativo o scripted) |
.gitlab-ci.yml |
Workflows YAML en .github/workflows/ |
Workflows YAML compatibles con Actions |
| Modelo de ejecución | Controlador + agentes (SSH, inbound, Docker, Kubernetes) | Runners registrados por proyecto, grupo o instancia; ejecutor shell, docker o kubernetes | Runners hospedados por GitHub o propios | Runners propios, ejecutor docker o host |
| Secretos | Credenciales cifradas en jenkins_home, con ámbito global o por carpeta |
Variables de proyecto/grupo, con protected y masked | Secrets de repositorio, entorno y organización | Secrets de repositorio y organización |
Jenkins con keystore Java
En el curso, nginx termina TLS y Jenkins habla HTTP por la red interna del compose. La alternativa es que Jenkins sirva HTTPS él mismo cargando un keystore Java, un fichero que guarda el certificado y la clave en el formato que entiende Java. Se usa cuando no hay ningún proxy delante, por ejemplo en un servidor único que no publica nada más, o cuando la política de la empresa exige TLS hasta el propio proceso Java. A cambio, cada renovación del certificado obliga a rehacer el keystore y a reiniciar Jenkins, y la contraseña del keystore hay que guardarla en algún sitio.
# compose.yml
services:
  jenkins:
    image: jenkins/jenkins:lts-jdk21
    ports: ["8443:8443"]
    volumes:
      - jenkins_home:/var/jenkins_home
      - ./certs:/certs:ro
    environment:
      JENKINS_OPTS: "--httpPort=-1 --httpsPort=8443 --httpsKeyStore=/certs/jenkins.jks --httpsKeyStorePassword=changeit"
volumes:
  jenkins_home:
El keystore se construye a partir del certificado y la clave que emite la CA interna:
# Certificado + clave -> PKCS12 -> JKS
openssl pkcs12 -export -in jenkins.crt -inkey jenkins.key -certfile ca.crt \
  -name jenkins -out jenkins.p12 -passout pass:changeit
keytool -importkeystore -srckeystore jenkins.p12 -srcstoretype PKCS12 \
  -srcstorepass changeit -destkeystore jenkins.jks -deststorepass changeit
--httpPort=-1 apaga el HTTP en claro. La contraseña del keystore va en claro en el compose; en el laboratorio es aceptable, en producción se pasa con un fichero .env fuera del repositorio o se termina TLS en el proxy inverso, que es lo que hace la instalación del curso.
Operar Jenkins: directorio, actualizaciones y copias
Ampliación de Usuarios y permisos y de Hardening del controlador, en la sesión 31: lo que en una empresa rodea a un Jenkins como el del curso y que en el laboratorio no se monta.
- Autenticación contra LDAP/AD (el directorio de usuarios de la empresa) o GitLab cuando exista (plugins
ldapygitlab-oauth); usuarios locales solo en el laboratorio. Cuando alguien deja la empresa, su cuenta se desactiva en un sitio, no en quince. - Actualizaciones: el controlador con la LTS (una versión cada doce semanas con parches entre medias) y los plugins revisados al menos una vez al mes. El panel de plugins marca en rojo los que tienen avisos de seguridad publicados en jenkins.io/security.
- Backup de
jenkins_home(configuración, jobs, credenciales cifradas). Con JCasC, la configuración ya está en Git; lo que queda por salvar es el historial de ejecuciones y, sobre todo,secrets/master.keyysecrets/hudson.util.Secret, sin los cuales las credenciales cifradas del backup no sirven. Untardel volumen con el contenedor parado, o el pluginthinBackup, cada noche.
La directiva matrix
Ampliación de Más directivas que hacen falta, en la sesión 35.
matrix genera una etapa por cada combinación de ejes; es útil para probar contra varias versiones:
stage('Test matrix') {
    matrix {
        axes {
            axis { name 'PY'; values '3.11', '3.12', '3.13' }
        }
        agent { docker { image "python:${PY}"; label 'docker' } }
        stages {
            stage('pytest') { steps { unstash 'src'; sh 'pytest' } }
        }
    }
}
Enlaces
- Pipeline Syntax (jenkins.io): la referencia del declarativo;
when,parallel,matrix,postyoptionscon todos sus valores. - Using Docker with Pipeline: la diferencia entre
agent { docker },docker.buildydocker.withRegistry, con ejemplos. - Installing Jenkins with Docker: la instalación oficial en contenedor y las opciones de
JENKINS_OPTS. - Configuration as Code plugin: documentación y una carpeta
demos/con YAML de ejemplo para casi cada plugin. - Securing Jenkins: CSRF, aislamiento del controlador, Agent → Controller security y cómo se publican los avisos.
- Using credentials: tipos, ámbitos y
withCredentials, incluido el aviso sobre interpolación de Groovy. - Using Jenkins agents: SSH, inbound y el porqué de las etiquetas.
- GitLab CI/CD YAML reference: para traducir cualquier construcción del
Jenkinsfilea.gitlab-ci.yml. - Deploy a registry server (Distribution): TLS, autenticación y almacenamiento del registry.
- Verify repository client with certificates (Docker): el directorio
certs.dy cómo Docker decide en quién confía. - Continuous Integration, Martin Fowler: el texto de referencia sobre qué es CI y por qué; corto y sin herramientas.
UT7 · Monitorización del entorno
Dos cosas distintas de la UT7. La primera es el programa de sus 12 horas en la formación en empresa (la UT7b del calendario), con las cinco evidencias que se entregan: está aquí porque no se da en el centro, pero no es opcional. La segunda, como en el resto de unidades, son los apartados que no se explican en clase ni necesita ninguna hoja obligatoria: la retención y el almacenamiento a largo plazo de Prometheus, el presupuesto de error con sus números, la pila montada desde cero en un solo compose, el formato de exposición de las métricas, el modelo de datos y la cardinalidad, los exporters más habituales, el descubrimiento de contenedores, la elección entre Grafana Alerting y las reglas de Prometheus, TLS y basic auth en la pila, la protección de sus datos y los enlaces para ampliar.
En la empresa: monitorización avanzada
Este es el programa de la UT7b: las 12 horas de esta unidad que se hacen en la formación en empresa, después de las dos sesiones del centro. Sirven para ver la pila en un entorno que no cabe en tres VM y completan los criterios de evaluación 4i, 4j y 4k. Lo que se espera hacer, o al menos observar con quien lo hace:
- Alertas con enrutado y silencios reales: árbol de rutas por equipo y severidad, guardias (PagerDuty, Opsgenie o turnos en Telegram), inhibiciones entre capas (si cae el switch, no avisan los 40 hosts detrás), silencios ligados a ventanas de mantenimiento y revisión de las alertas que nadie atiende (una alerta un mes en firing sin que nadie la mire, sobra).
- KPI de negocio: métricas que no son de infraestructura (pedidos por minuto, tiempo de cola, usuarios activos) expuestas por la aplicación o leídas de la base de datos, en un dashboard para gente no técnica.
- SLI/SLO y error budget: al menos un SLO acordado con la empresa, el SLI en PromQL que lo mide, un panel con el presupuesto restante y una alerta de burn rate (el método está en Error budget y burn rate, más abajo).
- Seguridad de la pila: cómo se autentica Grafana (LDAP, OAuth), quién ve qué (carpetas y permisos por equipo), cómo llegan las credenciales a los exporters, qué retención hay y si existe Thanos, Mimir o un servicio gestionado detrás.
Las cinco evidencias de la UT7b, que van a la memoria de la formación en empresa (una página por punto, con capturas anonimizadas si hace falta):
- Esquema de la pila de monitorización de la empresa: qué recoge, dónde se guarda y cuánto tiempo (CE 4i).
- Extracto del árbol de rutas de Alertmanager (o equivalente) comentado: quién recibe qué (CE 4j).
- Un dashboard de KPI de negocio, con la consulta de al menos un panel explicada (CE 4j).
- Un SLO escrito (SLI, objetivo, ventana), con el cálculo del error budget y la alerta asociada (CE 4j).
- Lista de medidas de seguridad de la pila y una propuesta de mejora justificada (CE 4k).
Retención y almacenamiento
Conviene saber cuánto disco y memoria va a pedir la pila y qué pasa cuando los 45 días de retención del laboratorio se quedan cortos; aquí va el cálculo aproximado y las herramientas del largo plazo.
La TSDB de Prometheus escribe bloques de 2 h que luego compacta en bloques mayores (hasta un 10 % de la retención). La compresión (delta de deltas para timestamps, XOR para valores) deja cada muestra en 1 a 2 bytes. Cálculo aproximado de disco: series activas × muestras por segundo por serie × bytes por muestra × segundos de retención. Para las 7 000 series del laboratorio a 15 s y 45 días: 7 000 / 15 × 1,5 × 3 888 000 ≈ 2,7 GB, más la WAL (write-ahead log, el diario donde apunta las muestras antes de formar bloque: las últimas 2 a 3 h sin compactar) y la memoria del head, que suele limitar antes que el disco.
Dos límites que conviene tener claros. Prometheus es un servidor único: no se agrupa ni replica; la alta disponibilidad se hace con dos Prometheus idénticos leyendo los mismos targets y Alertmanager deduplicando. Y la retención de años o las consultas globales sobre varios Prometheus no son su problema: para eso existen Thanos y Grafana Mimir, que reciben los bloques o las muestras por remote write (Prometheus las reenvía a otro servidor según las escribe) y las guardan en almacenamiento de objetos (S3, MinIO). Aparecen en cualquier empresa mediana; en el curso quedan en mención.
Error budget y burn rate
Cuando un SLO se escribe como un porcentaje, lo que sobra hasta el 100 % es el presupuesto de error: el tiempo que el servicio puede estar mal sin incumplir el compromiso. Con un SLO del 99,5 % en 30 días queda un 0,5 %, que son 216 minutos, 3 h 36 min al mes (30 × 24 × 60 × 0,005).
| Objetivo en 30 días | Presupuesto de error | Qué permite de verdad |
|---|---|---|
| 99 % | 7 h 12 min | Una ventana de mantenimiento larga al mes y algún susto |
| 99,5 % | 3 h 36 min | El objetivo razonable para un servicio interno sin guardias |
| 99,9 % | 43 min | Un reinicio planificado y poco más; obliga a despliegues sin corte |
| 99,99 % | 4 min 19 s | No da ni para reiniciar una máquina virtual; exige redundancia real |
El presupuesto es una herramienta de decisión, no un castigo. Si a mitad de mes se ha gastado el 90 %, se congelan los despliegues arriesgados y el esfuerzo se va a estabilizar; si sobra presupuesto, se asume más riesgo y se aprovecha para migrar, actualizar o probar. Esa conversación es la que evita las dos posturas estériles: la de quien no quiere desplegar nunca y la de quien despliega el viernes a las siete.
En el laboratorio el SLI de disponibilidad es el de la unidad, la fracción del tiempo en que la API ha respondido a Prometheus en la ventana entera:
En la empresa lo habitual es medirlo desde fuera, que es como lo vive quien paga, con una sonda de blackbox_exporter (ver Exporters más habituales); la consulta es la misma cambiando up{job="app"} por probe_success de la sonda.
El burn rate es la velocidad a la que se gasta ese presupuesto: un burn rate de 1 lo agota justo al acabar la ventana, y uno de 14,4 lo agota en dos días. Las alertas por burn rate combinan dos ventanas, una larga para reconocer el incidente y una corta para dejar de avisar en cuanto se recupera, y comparan la tasa de error con el presupuesto multiplicado por ese factor:
(1 - avg_over_time(up{job="app"}[1h]))   > 14.4 * 0.005
and
(1 - avg_over_time(up{job="app"}[5m]))   > 14.4 * 0.005
Esto es lo que sustituye en la empresa a las alertas de "CPU por encima del 85 %": no avisan de que una máquina está ocupada, sino de que el servicio se está gastando el mes. El método completo, con la tabla de ventanas y factores recomendados, está en Alerting on SLOs del SRE Workbook, enlazado en los Enlaces de esta misma unidad. En el módulo 5169 se trabaja entero, con números y con la alerta montada, en la UT4, sesión 21.
La pila en un solo compose
Así se despliega la pila entera desde cero con Docker Compose en una sola VM: cuatro contenedores (Prometheus, Alertmanager, Grafana y un correo de pruebas) más un exporter en cada máquina vigilada. En el curso no se monta así, porque la pila de mon01 la levantó y la cerró el módulo 5169 y la UT7 trabaja sobre ella; esto es la referencia para montarla en otro sitio.
En el compose conviene fijarse en los volúmenes con nombre (los datos sobreviven a un docker compose down), en la configuración montada en solo lectura, en los flags de retención y en que nada se publica fuera de 127.0.0.1: a Grafana se llega por un nginx con TLS y al resto por túnel.
# compose.yml (una VM de monitorización)
services:
  prometheus:
    image: prom/prometheus:v3.5.0
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml:ro
      - ./alerts.yml:/etc/prometheus/alerts.yml:ro
      - ./targets:/etc/prometheus/targets:ro
      - ./tls:/etc/prometheus/tls:ro
      - prom_data:/prometheus
    command:
      - --config.file=/etc/prometheus/prometheus.yml
      - --storage.tsdb.retention.time=45d
      - --storage.tsdb.retention.size=8GB
      - --web.enable-lifecycle
      - --web.listen-address=:29090
    ports: ["127.0.0.1:29090:29090"]
    restart: unless-stopped
  alertmanager:
    image: prom/alertmanager:v0.28.1
    volumes:
      - ./alertmanager.yml:/etc/alertmanager/alertmanager.yml:ro
      - am_data:/alertmanager
    command:
      - --config.file=/etc/alertmanager/alertmanager.yml
      - --storage.path=/alertmanager
      - --web.listen-address=:29093
    ports: ["127.0.0.1:29093:29093"]
    restart: unless-stopped
  grafana:
    image: grafana/grafana:12.1.0
    environment:
      GF_SECURITY_ADMIN_PASSWORD__FILE: /run/secrets/grafana_admin
      GF_USERS_ALLOW_SIGN_UP: "false"
      GF_SERVER_HTTP_PORT: "23000"
    volumes:
      - graf_data:/var/lib/grafana
      - ./grafana/provisioning:/etc/grafana/provisioning:ro
      - ./grafana/dashboards:/var/lib/grafana/dashboards:ro
      - ./secrets/grafana_admin:/run/secrets/grafana_admin:ro
    ports: ["127.0.0.1:23000:23000"]   # delante va un nginx con TLS en el 443
    restart: unless-stopped
  mailpit:
    image: axllent/mailpit:v1.22.3
    environment:
      MP_UI_BIND_ADDR: "0.0.0.0:28025"
    ports: ["127.0.0.1:28025:28025"]   # interfaz web; SMTP en 1025 solo dentro de la red de compose
    restart: unless-stopped
volumes: { prom_data: {}, am_data: {}, graf_data: {} }
Las versiones se fijan siempre (nada de latest en una pila que tiene que ser reproducible). Los puertos son los de la franja del curso, y cada servicio escucha dentro de su contenedor en el mismo número con el que se publica: lo fija --web.listen-address en Prometheus y en Alertmanager, GF_SERVER_HTTP_PORT en Grafana y MP_UI_BIND_ADDR en Mailpit. Si solo se cambia el ports:, el contenedor sigue escuchando en su puerto de fábrica y la conexión se corta. El command de Alertmanager repite además las dos opciones que su imagen trae de serie, porque al escribirlo se sustituyen. --web.enable-lifecycle permite recargar la configuración con curl -X POST http://localhost:29090/-/reload sin reiniciar el contenedor. La retención por tiempo y por tamaño se combinan: lo primero que se cumpla borra bloques antiguos.
En cada máquina a vigilar:
- node_exporter (puerto 29100 en el curso): CPU, memoria, disco, red, carga, systemd del host. Se instala con el paquete
prometheus-node-exporterde Debian, que ya trae su unidad de systemd y su usuario de servicio y lee sus opciones de la líneaARGSde/etc/default/prometheus-node-exporter, donde va--web.listen-address=:29100(en el curso viene así en la plantilla 9000), o con el binario oficial si hace falta una versión más nueva que la del repositorio; también existe como contenedor con--pid=hosty los volúmenes/proc,/sysy/montados en solo lectura. Conviene dejarlo fuera de Docker: un exporter que depende de Docker no puede avisar de que Docker se ha caído. - cAdvisor: CPU, memoria, red y disco por contenedor, leyendo los cgroups (el mecanismo del kernel con el que Docker limita y contabiliza los recursos de cada contenedor). Va como contenedor (
gcr.io/cadvisor/cadvisor) con/var/run/docker.sock,/sysy/var/lib/dockermontados, y con--port=28081en sucommandpara que escuche dentro del contenedor en el mismo puerto con el que se publica en la IP de la zona: el 28081 y no el 28080, que enapp01es el de la API del curso. Es glotón: con muchos contenedores conviene arrancarlo con--docker_only=true --housekeeping_interval=30s.
# prometheus.yml
global:
  scrape_interval: 15s
  evaluation_interval: 15s
rule_files: ["alerts.yml"]
alerting:
  alertmanagers:
    - static_configs: [{ targets: ["alertmanager:29093"] }]
scrape_configs:
  - job_name: prometheus
    static_configs: [{ targets: ["localhost:29090"] }]
  - job_name: node
    static_configs:
      - targets: ["10.10.3.10:29100", "10.10.0.10:29100", "10.10.0.20:29100"]
  - job_name: cadvisor
    static_configs: [{ targets: ["10.10.2.10:28081"] }]
  - job_name: jenkins
    scheme: https                      # Jenkins solo se publica por su nginx, en el 443
    metrics_path: /prometheus/
    tls_config: { ca_file: /etc/prometheus/tls/ca.crt }
    static_configs: [{ targets: ["jenkins.lab:443"] }]
Con scrape_interval: 15s y un entorno de cuatro hosts (unas 1 000 series por node_exporter, otras 2 000 de cAdvisor con veinte contenedores, 300 de Jenkins) el entorno queda en torno a 7 000 series activas y 470 muestras por segundo: unos 60 MB al día en disco, algo menos de 3 GB en los 45 días de retención. Se comprueba con du -sh sobre prom_data al cabo de una semana.
El formato de exposición
Para entender lo que Prometheus guarda hay que ver primero lo que lee: cada exporter publica una página de texto que se puede abrir con el navegador, y conviene saber leerla porque es lo primero que se mira cuando un panel sale vacío.
Un /metrics es texto plano, una métrica por línea, con dos líneas de comentario opcionales (HELP y TYPE) que la documentan. Esto es un extracto real de lo que devuelve un node_exporter, por ejemplo el de db01 con curl -s http://10.10.3.10:29100/metrics desde mon01 (node_exporter expone entre 500 y 1500 líneas según el hardware):
# HELP node_cpu_seconds_total Seconds the CPUs spent in each mode.
# TYPE node_cpu_seconds_total counter
node_cpu_seconds_total{cpu="0",mode="idle"} 118372.63
node_cpu_seconds_total{cpu="0",mode="iowait"} 41.2
node_cpu_seconds_total{cpu="0",mode="system"} 1204.77
node_cpu_seconds_total{cpu="0",mode="user"} 3521.12
node_cpu_seconds_total{cpu="1",mode="idle"} 118401.02
# HELP node_memory_MemAvailable_bytes Memory information field MemAvailable_bytes.
# TYPE node_memory_MemAvailable_bytes gauge
node_memory_MemAvailable_bytes 6.1478912e+09
# HELP node_filesystem_avail_bytes Filesystem space available to non-root users in bytes.
# TYPE node_filesystem_avail_bytes gauge
node_filesystem_avail_bytes{device="/dev/sda1",fstype="ext4",mountpoint="/"} 2.4512e+10
# HELP http_request_duration_seconds Duración de las peticiones (ejemplo de una app instrumentada)
# TYPE http_request_duration_seconds histogram
http_request_duration_seconds_bucket{handler="/api",le="0.1"} 240
http_request_duration_seconds_bucket{handler="/api",le="0.5"} 310
http_request_duration_seconds_bucket{handler="/api",le="1"} 318
http_request_duration_seconds_bucket{handler="/api",le="+Inf"} 320
http_request_duration_seconds_sum{handler="/api"} 41.2
http_request_duration_seconds_count{handler="/api"} 320
Los cuatro tipos:
- Counter: solo sube (o se pone a cero cuando el proceso reinicia). Segundos de CPU, bytes enviados, peticiones servidas, builds fallidas. El valor bruto no dice nada; lo que interesa es su velocidad, y para eso está
rate(). - Gauge: sube y baja. Memoria disponible, temperatura, número de contenedores en ejecución. Se lee tal cual.
- Histogram: cuenta observaciones en cubos (
_bucketcon etiquetale, "less or equal") acumulativos, más_sumy_count. En el ejemplo, 240 peticiones tardaron 0,1 s o menos, 310 tardaron 0,5 s o menos (incluye las 240 anteriores) y hubo 320 en total. Con esto se calculan percentiles en el servidor conhistogram_quantile, y se pueden sumar histogramas de varias instancias. - Summary: el cliente calcula los percentiles y los expone ya hechos (
{quantile="0.95"}). Es más preciso pero no se puede agregar entre instancias: la media de dos p95 no es el p95 global. En la práctica se prefiere histogram.
Prometheus 3 acepta también OpenMetrics, una versión estandarizada de este mismo texto, pero lo que se ve en los exporters es esto.
Modelo de datos y cardinalidad
Este apartado explica de qué depende que Prometheus vaya ligero o se muera por falta de memoria, y la respuesta no es "cuántos datos guarda" sino "cuántas series distintas". Entender la diferencia evita el error más caro de esta tecnología.
Una serie temporal es la combinación única de nombre de métrica y conjunto de pares etiqueta=valor. node_cpu_seconds_total en un host de 4 núcleos con 8 modos de CPU son 32 series, no una. Prometheus añade automáticamente job (el nombre del bloque de scrape) e instance (host:puerto) a todo lo que lee, y guarda cada serie como una secuencia de (timestamp, valor) comprimida en su TSDB (la base de datos de series temporales que lleva integrada).
El coste de Prometheus está en el número de series, no en el de muestras: cada serie activa consume memoria en el "head block" (unos pocos KB) y entrada de índice; cada muestra nueva de una serie existente cuesta un par de bytes. Por eso una etiqueta con muchos valores distintos es venenosa: a ese número de valores distintos se le llama cardinalidad. Ejemplo real: un desarrollador con buena intención añade user_id a http_requests_total. Con 50 000 usuarios, 20 rutas y 5 códigos de estado son 5 millones de series potenciales en lugar de 100; la memoria se dispara, las consultas que tardaban 50 ms tardan 30 s y el proceso muere por OOM (el kernel lo mata al quedarse sin memoria). Lo mismo con IPs de cliente, sesiones, IDs de contenedor efímeros o marcas de tiempo en una etiqueta. La regla: una etiqueta debe tener pocos valores posibles (método HTTP, código de estado, host, servicio). Lo que identifica a un usuario va al log, no a la métrica. Para vigilarlo, prometheus_tsdb_head_series da las series activas y Status → TSDB Status en la interfaz enseña las diez métricas y etiquetas con más cardinalidad.
Exporters más habituales
En el laboratorio se leen cuatro fuentes, pero en la empresa cada servicio tiene su exporter y la pregunta es siempre la misma: qué puerto abre, qué mide y qué necesita. Esta tabla es la chuleta de los más habituales, con el puerto de fábrica de cada uno y, en los que monta el laboratorio, el de la franja del curso; el párrafo de después explica el único que mide desde fuera.
| Exporter | Puerto | Para qué | Comentario |
|---|---|---|---|
| node_exporter | 9100 de fábrica; 29100 en el curso | Sistema operativo del host | El primero que se instala en cualquier máquina Linux |
| cAdvisor | 8080 de fábrica; 28081 en el curso, dentro y fuera del contenedor | Contenedores por cgroup | Mantenido por Google; en Kubernetes va dentro del kubelet |
| blackbox_exporter | 9115 de fábrica | Sondas desde fuera: HTTP, TCP, ICMP, DNS | Prometheus le pasa la URL como parámetro; mide lo que ve el usuario (código, latencia, caducidad del certificado TLS) |
| postgres_exporter | 9187 de fábrica; 29187 en el curso | Conexiones, transacciones, tamaño, réplica de PostgreSQL | Necesita un usuario de solo lectura en la BD, con pg_monitor |
| nginx-prometheus-exporter | 9113 de fábrica | Conexiones activas y peticiones de nginx | Lee stub_status; para métricas por ruta hace falta un módulo de terceros o Traefik |
| Plugin Prometheus de Jenkins | 443 (https://jenkins.lab/prometheus/) |
Builds, duración, cola, ejecutores | Prefijo default_ en sus métricas propias (las de cola y ejecutores van sin él); se puede exigir autenticación en el endpoint |
Blackbox cambia el punto de vista: los demás miden desde dentro ("el proceso usa 300 MB"); blackbox mide desde fuera ("la URL responde 200 en 120 ms y el certificado caduca en 41 días"), que es lo que le importa al que paga. Un job de blackbox contra la aplicación es el SLI de disponibilidad más honesto que se puede tener, y probe_ssl_earliest_cert_expiry - time() < 14*86400 es una alerta que ha salvado más de un fin de semana. En el laboratorio del curso no se instala.
Descubrimiento con docker_sd_configs
Además de file_sd, Prometheus sabe descubrir contenedores. Con docker_sd_configs habla con el socket de Docker (o con un tcp:// protegido con TLS) y descubre los contenedores en marcha, exponiendo sus etiquetas como __meta_docker_container_label_*. Con relabel_configs se decide qué contenedores se leen (por ejemplo, los que tienen la etiqueta prometheus.scrape=true) y en qué puerto. Es la antesala de kubernetes_sd_configs, que funciona igual. En el laboratorio se usa file_sd, generado con Ansible desde el inventario.
Grafana Alerting o reglas de Prometheus
Grafana 12 trae su propio motor de alertas, equivalente a Alertmanager y configurable desde la interfaz. En la UT7 las reglas viven en Prometheus porque se evalúan junto a los datos, siguen funcionando si Grafana se cae, se validan con promtool y van en Git; Grafana Alerting encaja cuando la alerta cruza varias fuentes de datos o cuando quien la mantiene no toca YAML. Conviene elegir una de las dos para cada tipo de alerta: duplicarlas acaba en dos notificaciones y nadie sabe cuál es la buena.
TLS y basic auth en Prometheus y los exporters
Desde la versión 2.24 el servidor de Prometheus (y todos los exporters oficiales, que comparten el mismo toolkit) aceptan un --web.config.file con TLS y usuarios de basic auth. Las contraseñas van en bcrypt (htpasswd -nBC 10 admin genera el hash).
# web.yml (para Prometheus y para node_exporter)
tls_server_config:
  cert_file: /etc/prometheus/tls/mon01.crt
  key_file: /etc/prometheus/tls/mon01.key
basic_auth_users:
  scraper: "$2y$10$Q8v7...hash bcrypt..."
Si se pone basic auth en los exporters, Prometheus tiene que presentarla al leer: en cada scrape_config, scheme: https, tls_config: { ca_file: /etc/prometheus/tls/ca.crt } y basic_auth: { username: scraper, password_file: /etc/prometheus/secrets/scraper.pass }. La CA es la del curso, la de la A3.2, y el certificado del servidor lleva el nombre mon01 en el SAN (el campo del certificado donde van los nombres de host que cubre). Alertmanager y Grafana también hablan con Prometheus: si Prometheus pide contraseña, hay que darles las mismas credenciales. En el laboratorio del curso, el módulo 5169 cifra así el node_exporter de app01 en su A3.2, y el job node-tls de la UT7 lo lee con esas credenciales.
El repositorio de datos de la pila
Los volúmenes prom_data y graf_data son el repositorio de datos, y quien llega a ellos tiene el histórico entero sin pasar por ninguna contraseña. Permisos restringidos en el host (usuario nobody para Prometheus, 472 para Grafana), retención definida (45 días en el curso) y copia de seguridad: los dashboards como JSON en Git, que es lo que hace la A7.2 con el panel de la plataforma, y, si el histórico importa, snapshots de la TSDB con curl -XPOST http://localhost:29090/api/v1/admin/tsdb/snapshot copiados fuera de la máquina.
Dos cosas que se olvidan. La primera, que el snapshot necesita --web.enable-admin-api, y esa misma API permite borrar series enteras con una petición HTTP: se activa el rato que dura la copia y se vuelve a quitar, nunca se deja puesta "por comodidad". La segunda, que la base de datos de Grafana dentro de graf_data guarda los usuarios, los tokens de servicio y las credenciales de las fuentes de datos cifradas con la clave secreta de la instancia: una copia de ese volumen vale tanto como la contraseña de administración si la clave viaja al lado. Las copias se guardan con las mismas restricciones de acceso que el original, y quien pueda restaurarlas debe estar en la misma lista corta que quien puede entrar en mon01.
Enlaces
- Prometheus: Overview: la documentación oficial, empezando por la arquitectura y el modelo de datos. Todo lo de esta unidad está ahí con más detalle.
- Querying basics (PromQL) y Functions: la referencia de selectores, operadores y funciones; conviene tenerla abierta mientras se hace la A7.1.
- Configuration (prometheus.yml): todas las opciones de scrape, descubrimiento (
file_sd_configs,docker_sd_configs) y relabeling. - Alerting rules y Alertmanager configuration: plantillas de anotaciones, rutas, inhibiciones y todos los receptores.
- Securing Prometheus: TLS and basic auth y web configuration: el
web.config.fileque usa el node_exporter deapp01desde la A3.2 de Mantenimiento. - Prometheus storage: cómo funciona la TSDB, retención, snapshots y remote write.
- Grafana documentation: Provisioning: fuentes de datos y dashboards desde ficheros, la base para versionarlos en Git.
- Grafana Alerting: para comparar con las reglas de Prometheus.
- Node Exporter Full (dashboard 1860): el dashboard que la A7.2 deja para cuando sobra tiempo, y una buena cantera de consultas.
- Google SRE Workbook: Alerting on SLOs: el método de burn rate y error budget que aparece en la empresa.
- cAdvisor y node_exporter: el README de cada uno tiene la lista de métricas y los flags de arranque (los colectores de node_exporter se activan y desactivan uno a uno).
Bibliografía y enlaces
Los enlaces concretos de cada unidad están en la página Para ampliar, junto con los apartados que van más allá de lo que se hace en clase. Aquí está lo transversal: documentación de referencia, libros que merecen la pena y algunos sitios donde practicar. Todo en línea y gratuito salvo los libros.
Documentación oficial
La primera fuente siempre. Cuando un comando de los apuntes no funcione en una versión concreta, la respuesta está aquí.
| Herramienta | Enlace | Qué mirar |
|---|---|---|
| Proxmox VE | pve.proxmox.com/pve-docs | Manual del administrador completo; capítulos de red, almacenamiento, cloud-init y SDN |
| Proxmox wiki | pve.proxmox.com/wiki | Guías prácticas y casos concretos |
| cloud-init | cloudinit.readthedocs.io | Datasource NoCloud, módulos, depuración |
| OPNsense | docs.opnsense.org | Interfaces, reglas, NAT, IDS |
| nftables | wiki.nftables.org | Guía rápida y ejemplos de configuración |
| nmap | nmap.org/book | El libro de referencia, gratis en línea |
| OpenTofu | opentofu.org/docs | Lenguaje, CLI, estado, backends |
| Terraform | developer.hashicorp.com/terraform | Casi todo aplica a OpenTofu |
| Provider bpg/proxmox | registry.terraform.io/providers/bpg/proxmox | Recursos VM, contenedor, SDN, ficheros |
| Ansible | docs.ansible.com | Guía del usuario, índice de módulos, buenas prácticas |
| Jenkins | jenkins.io/doc | Pipeline syntax, gestión de agentes, seguridad |
| GitLab CI | docs.gitlab.com/ee/ci | Referencia de .gitlab-ci.yml |
| Gitea | docs.gitea.com | Actions, registry de paquetes, webhooks |
| Prometheus | prometheus.io/docs | Conceptos, PromQL, alertas, Alertmanager |
| Grafana | grafana.com/docs/grafana | Dashboards, provisioning, alerting |
| AWS | docs.aws.amazon.com | Guías de VPC, IAM, CLI |
| Azure | learn.microsoft.com/azure | Virtual Network, Entra ID, CLI |
| Google Cloud | cloud.google.com/docs | VPC, IAM, gcloud |
Libros
- Sobre Proxmox no hay libro que supere al manual oficial; no merece la pena gastar dinero ahí.
- Kief Morris, Infrastructure as Code (O'Reilly, 2ª ed.). El libro que explica por qué se hace IaC y cómo organizar el código. No es un manual de Terraform, es mejor que eso.
- Yevgeniy Brikman, Terraform: Up & Running (O'Reilly, 3ª ed.). Práctico y con opiniones. Todo aplica a OpenTofu.
- Jeff Geerling, Ansible for DevOps. Se compra en Leanpub a precio libre. Ejemplos reales y bien explicados.
- Betsy Beyer y otros, Site Reliability Engineering (Google). Gratis en sre.google/books. Los capítulos de monitorización y alertas son la base de la UT7.
- Brendan Burns y otros, Kubernetes: Up & Running. No se trata en este módulo, pero es el paso siguiente en el mundo laboral.
Para practicar fuera del aula
- KillerCoda tiene escenarios interactivos de Linux, Docker y CI en el navegador.
- Play with Docker para probar cosas rápidas sin instalar nada.
- OverTheWire: Bandit si la terminal de Linux no está fina.
- Subnetting practice para calcular subredes hasta hacerlo de cabeza.
- Awesome Selfhosted para elegir servicios que desplegar en el laboratorio propio como proyecto.
Comunidades y noticias
- Foro de Proxmox en inglés; el hilo casi siempre existe ya.
- r/homelab y r/selfhosted para ver montajes reales y sus problemas.
- Blog de Jeff Geerling sobre Ansible, hardware y homelab.
- Blog de Grafana Labs y blog de Prometheus para las novedades de cada versión.
- CNCF Landscape para situar en su categoría cualquier herramienta que suene.
Normativa
- Real decreto del curso de especialización que define los resultados de aprendizaje: se busca en el BOE por el nombre del curso. El resumen de RA y CE en lenguaje llano está en la página del módulo.
- Calendario escolar de la Comunitat Valenciana: ceice.gva.es.
Créditos de las imágenes
| Fichero | Autor y licencia | Origen |
|---|---|---|
| hipervisor-tipos.png | Scsami, CC0 | Wikimedia Commons |
| proxmox-cluster-summary.png | Proxmox Server Solutions GmbH, dominio público | Wikimedia Commons |
| cloud-init-logo.svg | Dominio público | Wikimedia Commons |
| vpc-esquema.svg | Sam Johnston, CC BY-SA 3.0 | Wikimedia Commons |
| dmz-un-firewall.svg, dmz-dos-firewalls.svg | Pbroks13, dominio público | Wikimedia Commons |
| opnsense-dashboard.png | Hagennos, CC BY-SA 4.0 | Wikimedia Commons |
| reverse-proxy.svg | H2g2bob, CC0 | Wikimedia Commons |
| jenkins-pipeline.png | Mark Waite, CC BY-SA 4.0 | Wikimedia Commons |
| jenkins-logo.png | Proyecto Jenkins, CC BY-SA 3.0 | jenkins.io |
| prometheus-arquitectura.svg | Proyecto Prometheus, Apache 2.0 | github.com/prometheus/prometheus |
| grafana-dashboard.png | Joel Kennedy, dominio público | Wikimedia Commons |
| Logos de Terraform, Ansible, Prometheus y Grafana | Marcas de sus titulares, uso nominativo | Wikimedia Commons |